
C++ std::atomic:原子读写、RMW 与能力边界
04 std::atomic 到底保证了什么
很多人下意识会把 std::atomic<int> 当成“线程安全的 int”。
这种理解其实只对了一半:atomic<int> 确实能让多个线程并发读写一个整数而不出乱子,但如果把“线程安全”脑补成“怎么用都不会出错”,那多半要栽跟头。std::atomic 保护的只是它自己这个对象上的单次原子操作(比如单次的读、写、或者读-改-写),保证这些操作在物理上不可插队、不被撕裂。但它管不了跨变量的业务逻辑——哪怕你把结构体里的十个字段全都换成 atomic,它们之间的一致性也不会自动产生。
这一章要做的事情就是把 std::atomic 的能力边界理清楚:它到底保证了什么,怎么保证的,以及在哪里它帮不了你。
从计数器开始:fetch_add 为什么不丢更新
第一章讲过,两个线程同时对一个普通 int 做 ++counter,最终结果会比预期小。根本原因是 ++counter 在汇编层面被拆成了三步:从内存读值到寄存器、寄存器加 1、把新值写回内存。两个线程的三步操作交错执行,就会出现经典的丢失更新。
用 std::atomic 重写之后,情况就不一样了:
#include <atomic>
#include <iostream>
#include <thread>

std::atomic<int> counter{0};

void Worker() {
    for (int i = 0; i < 100000; ++i) {
        counter.fetch_add(1);
    }
}

int main() {
    std::thread t1(Worker);
    std::thread t2(Worker);

    t1.join();
    t2.join();

    std::cout << counter.load() << "\n";  // 稳定输出 200000
}
fetch_add(1) 做的事情和 ++counter 一样——读旧值、加 1、写新值——但它把这三步捏成了一个不可分割的整体。在硬件层面,x86 上它对应的是一条 lock xadd 指令。lock 前缀会锁住这个内存地址对应的缓存行,在指令执行完毕之前,其他核心对同一地址的任何访问都会被阻塞。读、改、写三步在一条指令内完成,中间没有缝隙可以让别的线程插进来。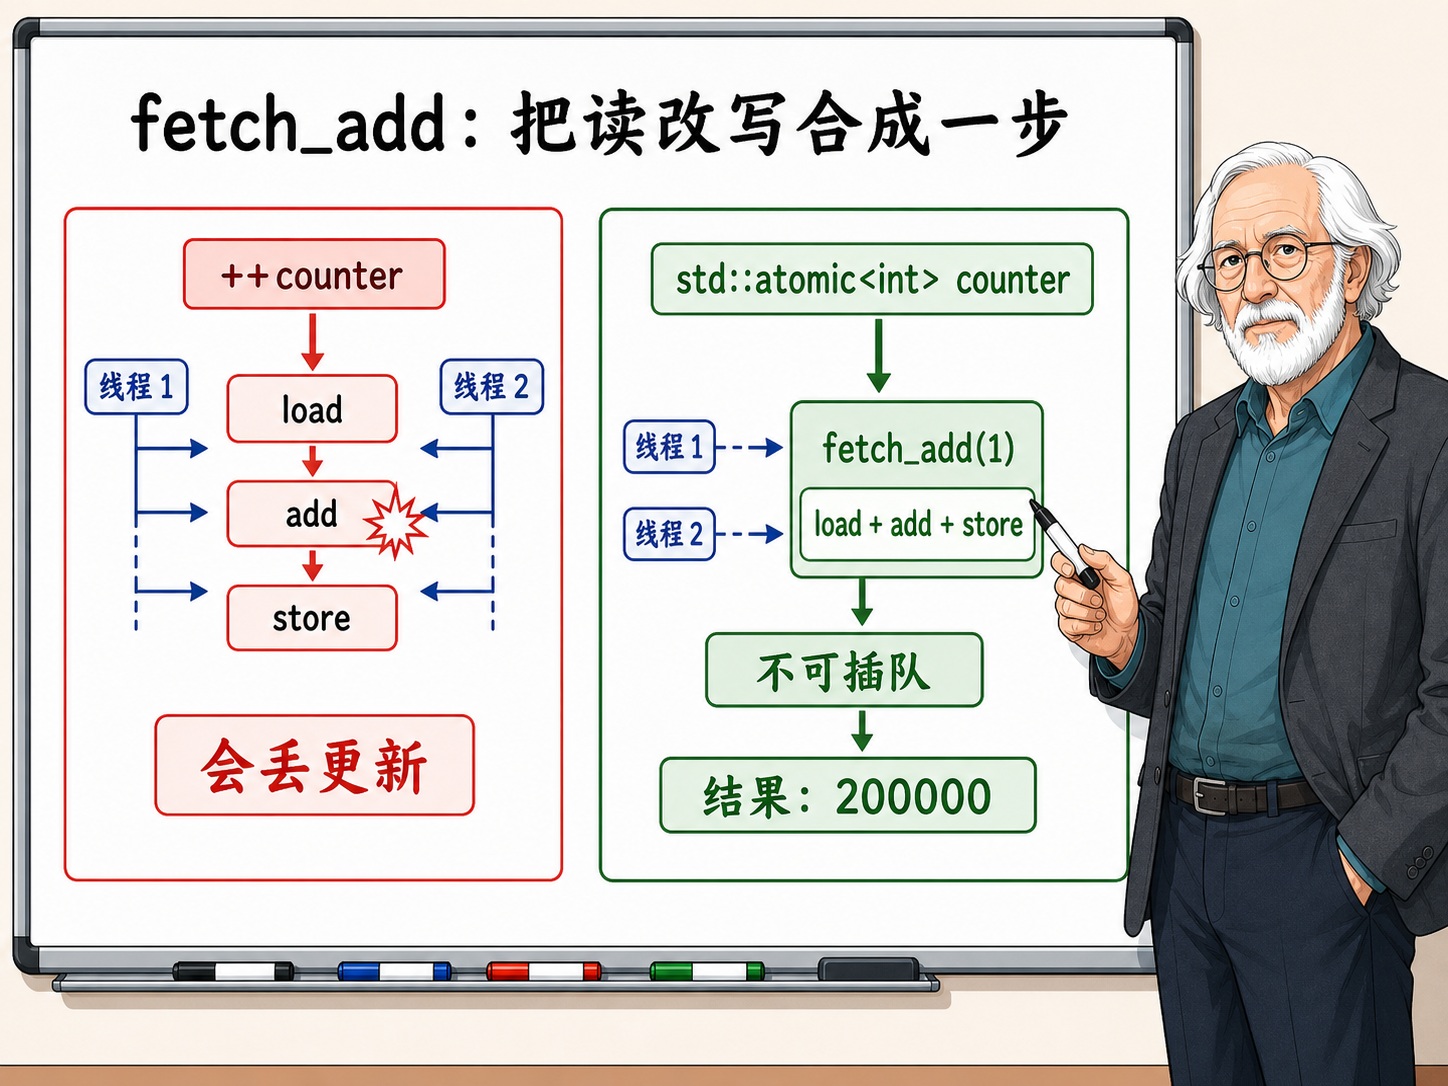
这就是原子读改写(Atomic Read-Modify-Write)操作的核心:不是说操作变快了,而是说操作变得不可打断了。两个线程同时对同一个 atomic<int> 执行 fetch_add,硬件会强制让它们排队。先执行的那个读到旧值、写回新值;后执行的那个读到的就是更新后的值,再往上加。不管怎么并发,最终结果都是正确的 200000。
fetch_add 还有一个特性:它会返回加之前的旧值。这个返回值在很多场景下非常有用,比如分配全局唯一 ID:
#include <atomic>
#include <cstdint>

std::atomic<std::uint64_t> next_id{1};

std::uint64_t AllocateId() {
    return next_id.fetch_add(1);
}
每个线程调用 AllocateId(),都会拿到一个不重复的 ID。第一个调用者拿到 1,第二个拿到 2,以此类推。不需要锁,不需要额外的同步结构,一条原子指令就搞定了。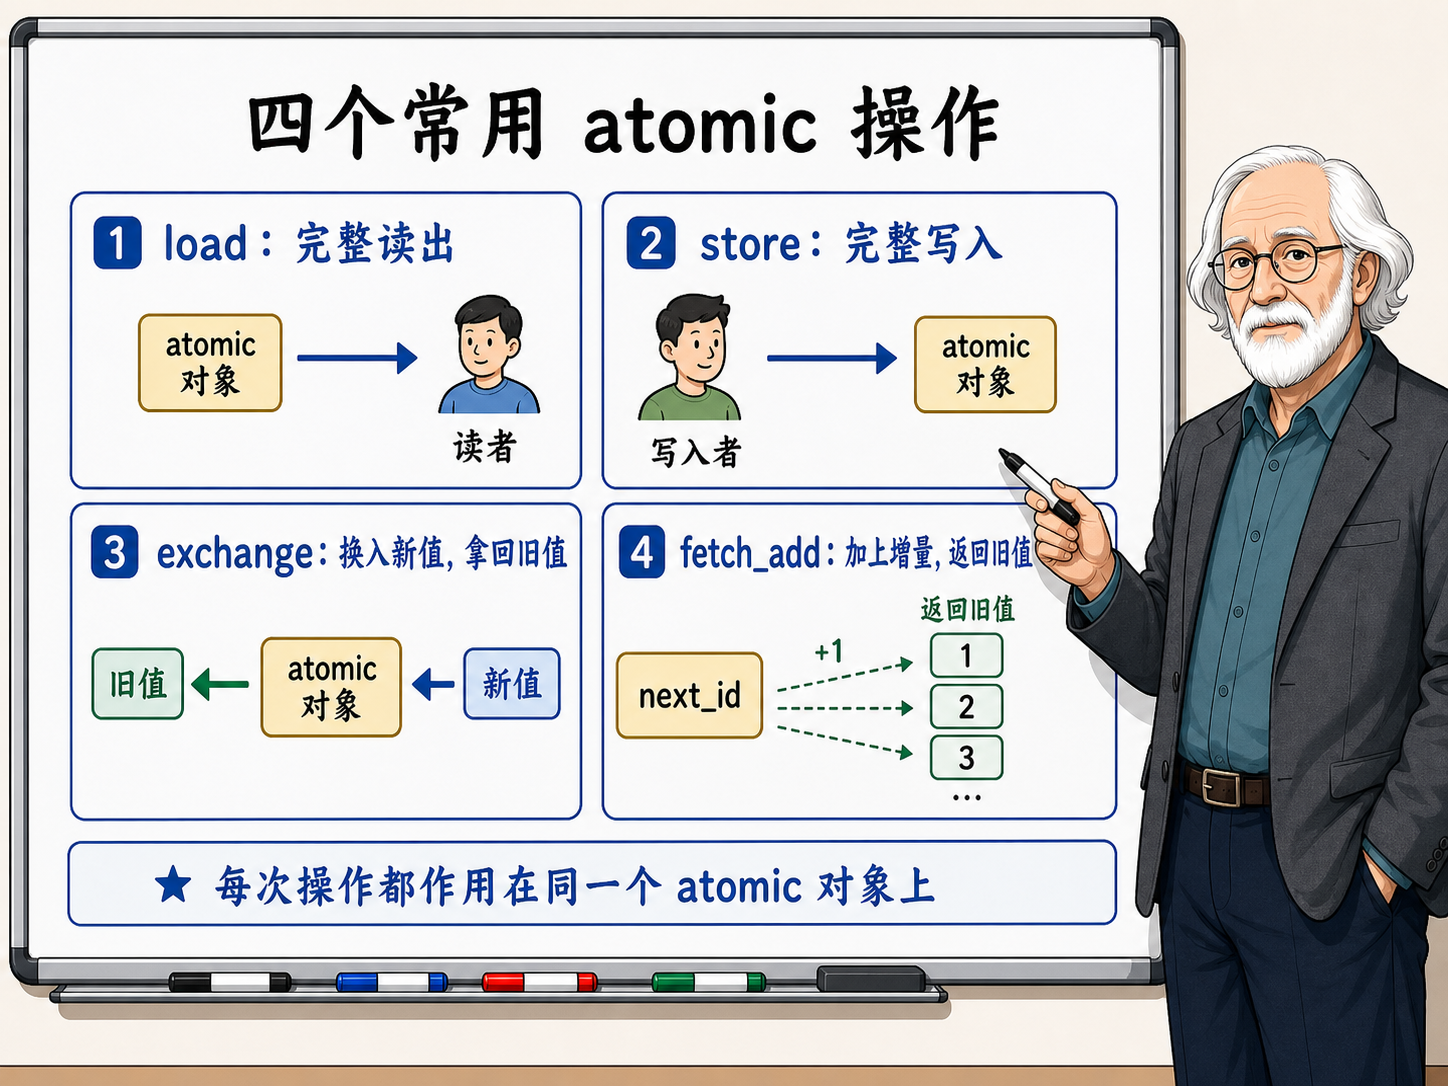
load 和 store:最基础的原子读写
fetch_add 是读改写操作,它把读和写绑在一起。但很多时候我们只需要单纯地读或者单纯地写,这就是 load() 和 store() 的用处。
load() 做一次原子读取,保证读到的值一定是某次完整写入的结果,不会读到半新半旧的撕裂数据:
int value = counter.load();
store() 做一次原子写入,保证写入动作对其他核心来说是一个完整的、不可分割的事件:
counter.store(42);
一个最典型的 load/store 使用场景是停止标志:
#include <atomic>

std::atomic<bool> stop_requested{false};

void Worker() {
    while (!stop_requested.load()) {
        DoOneRound();
    }
}

void RequestStop() {
    stop_requested.store(true);
}
主线程调用 RequestStop() 写入 true,工作线程在循环里用 load() 去读。因为 stop_requested 是 atomic<bool>,这个并发读写不构成数据竞争,完全合法。工作线程最终一定能看到 true,然后退出循环。
上一章讲过,用 volatile bool 也能让编译器保留读取动作,表面上"修好了"问题。但 volatile 的并发读写在 C++ 标准里仍然是未定义行为,atomic 才是正道。
这里有个细节值得说一下:load() 和 store() 不写内存序参数的时候,默认都是 memory_order_seq_cst——最强的顺序一致性。对于一个单纯的停止标志来说,这其实有点"杀鸡用牛刀"。如果工作线程退出时不需要依赖主线程在设置标志之前写入的其他数据,用 relaxed 就够了:
while (!stop_requested.load(std::memory_order_relaxed)) {
    DoOneRound();
}
relaxed 保留了原子性,去掉了跨变量的内存序约束,开销更小。不过内存序的选择是下一章的主题,这里先记住:不写参数就是最强保证,不会错,只是可能多花了点性能成本。
exchange:原子地换一个值进去
exchange() 的语义是:把一个新值原子地写进去,同时把旧值返回来。读和写绑在一条指令里,中间不会被打断。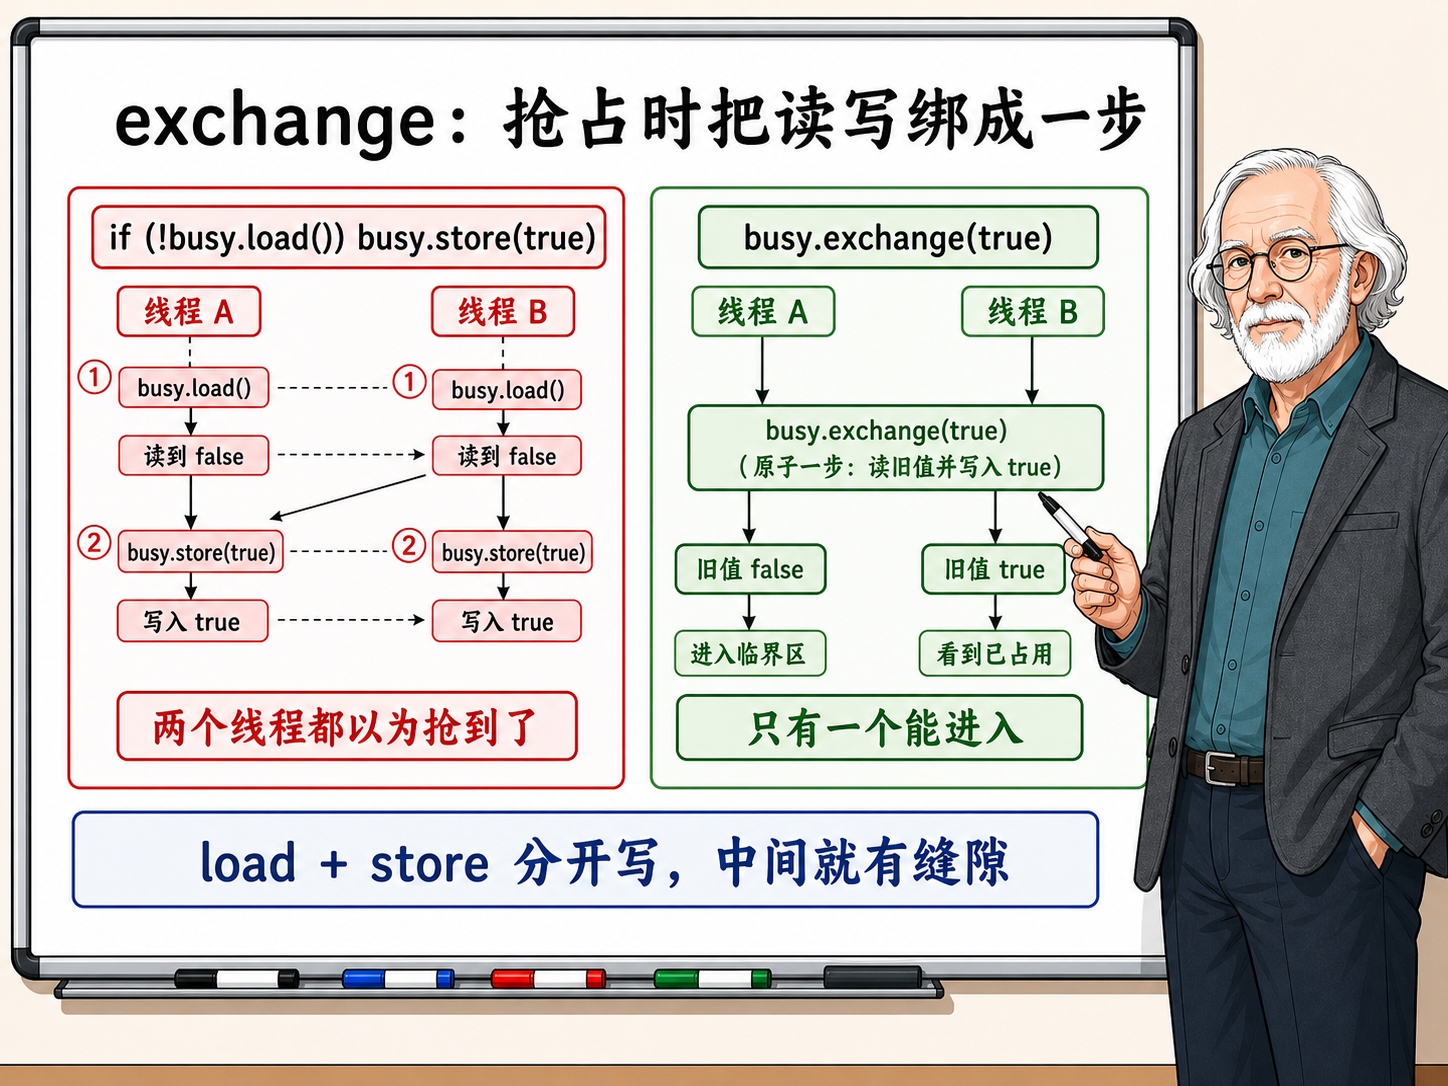
一个经典的用途是实现简单的互斥抢占:
#include <atomic>

std::atomic<bool> busy{false};

bool TryEnter() {
    bool was_busy = busy.exchange(true);
    return !was_busy;
}

void Leave() {
    busy.store(false);
}
TryEnter() 的逻辑是:不管 busy 当前是什么值,先把它设成 true,然后看旧值。如果旧值是 false,说明之前没人占用,我抢到了;如果旧值是 true,说明别人已经在里面了,我没抢到。
为什么不能用 if (!busy.load()) { busy.store(true); } 来代替?因为 load 和 store 是两步操作,中间有缝隙。线程 A 刚读到 false 还没来得及写 true,线程 B 也读到了 false,两个线程都以为自己抢到了。exchange 把读和写合成一步,堵死了这个缝隙。
atomic_flag 和自旋锁
std::atomic_flag 是 C++ 标准库里最精简的原子类型。它只有两个操作:test_and_set() 和 clear()。标准保证它在所有平台上都是无锁的——这个保证连 atomic<bool> 都不一定能给。
test_and_set() 的行为和 exchange(true) 类似:原子地把标志设为 true,返回旧值。用它可以搭一个最基本的自旋锁:
#include <atomic>

class SpinLock {
 public:
    void Lock() {
        while (flag_.test_and_set(std::memory_order_acquire)) {
            // 自旋等待
        }
    }

    void Unlock() {
        flag_.clear(std::memory_order_release);
    }

 private:
    std::atomic_flag flag_ = ATOMIC_FLAG_INIT;
};
Lock() 里的循环不断尝试把 flag_ 设为 true。如果旧值是 false,说明锁没被占,test_and_set 返回 false,循环退出,加锁成功。如果旧值是 true,说明别的线程正持有锁,当前线程就一直在循环里空转,直到对方调用 Unlock() 把 flag_ 清掉。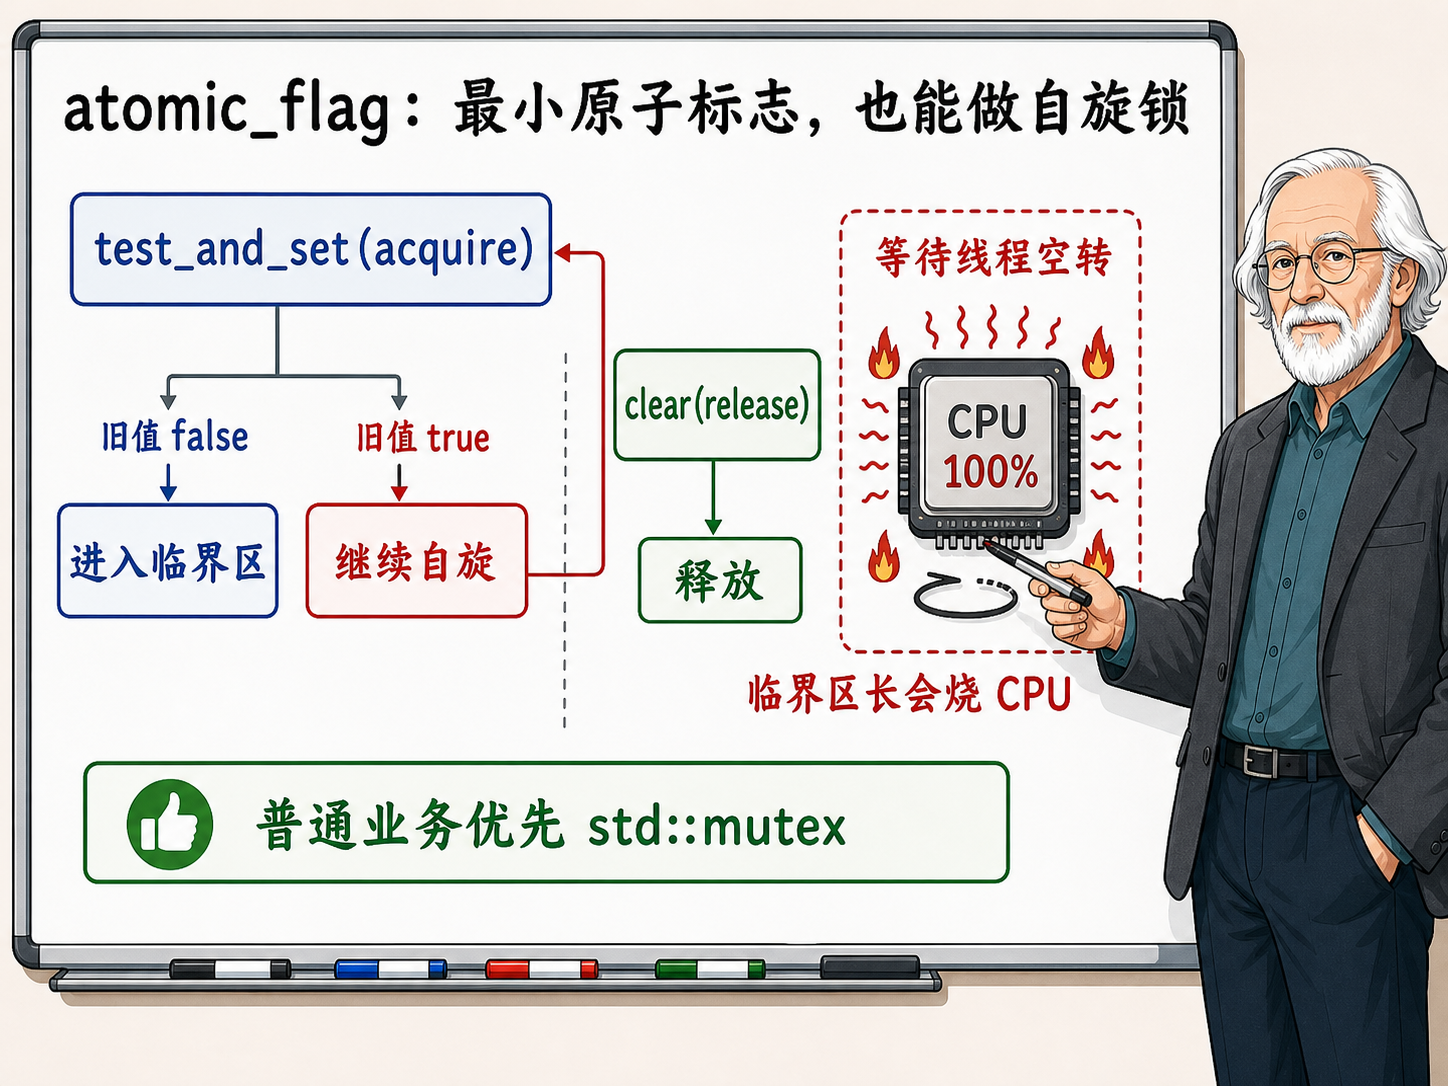
这里用了 acquire 和 release 内存序。acquire 保证加锁之后的代码不会被重排到加锁之前;release 保证解锁之前的代码不会被重排到解锁之后。这样临界区内的数据修改对下一个拿到锁的线程一定可见。内存序的细节后面几章会展开,这里只需要知道这对搭配是标准的锁同步模式。
自旋锁在实际业务代码里要慎用。它的问题很明显:等锁的线程在全速空转,吃满一个核心的 CPU 时间。如果持锁的线程因为操作系统调度被挂起了,等锁的线程就会白白烧 CPU 直到对方被重新调度回来。在单核环境下更要命——等锁的线程一直占着 CPU,持锁的线程根本没机会运行,形成类似死锁的局面。
另外,多个核心同时自旋同一个 atomic_flag,会在缓存一致性协议层面引起大量的缓存行来回弹跳。每个核心每次 test_and_set 都要对这个缓存行拿到独占权,其他核心的缓存行副本全部失效,下一轮自旋又要从远端重新拉取。竞争越激烈,缓存总线上的流量越大,整个系统的吞吐都会被拖慢。
所以自旋锁的适用场景很窄:临界区极短(几条指令级别)、确定不会被调度打断、核心数可控。操作系统内核里用得比较多,普通应用层代码还是老老实实用 std::mutex。现代操作系统的 mutex 实现在低竞争时走用户态快速路径,高竞争时挂起线程让出 CPU,综合表现比自旋锁稳得多。
is_lock_free:atomic 不一定真的无锁
很多人有个默认假设:用了 std::atomic,底层就一定是一条硬件原子指令,没有锁。这个假设在大多数常见类型上是对的,但不是永远对的。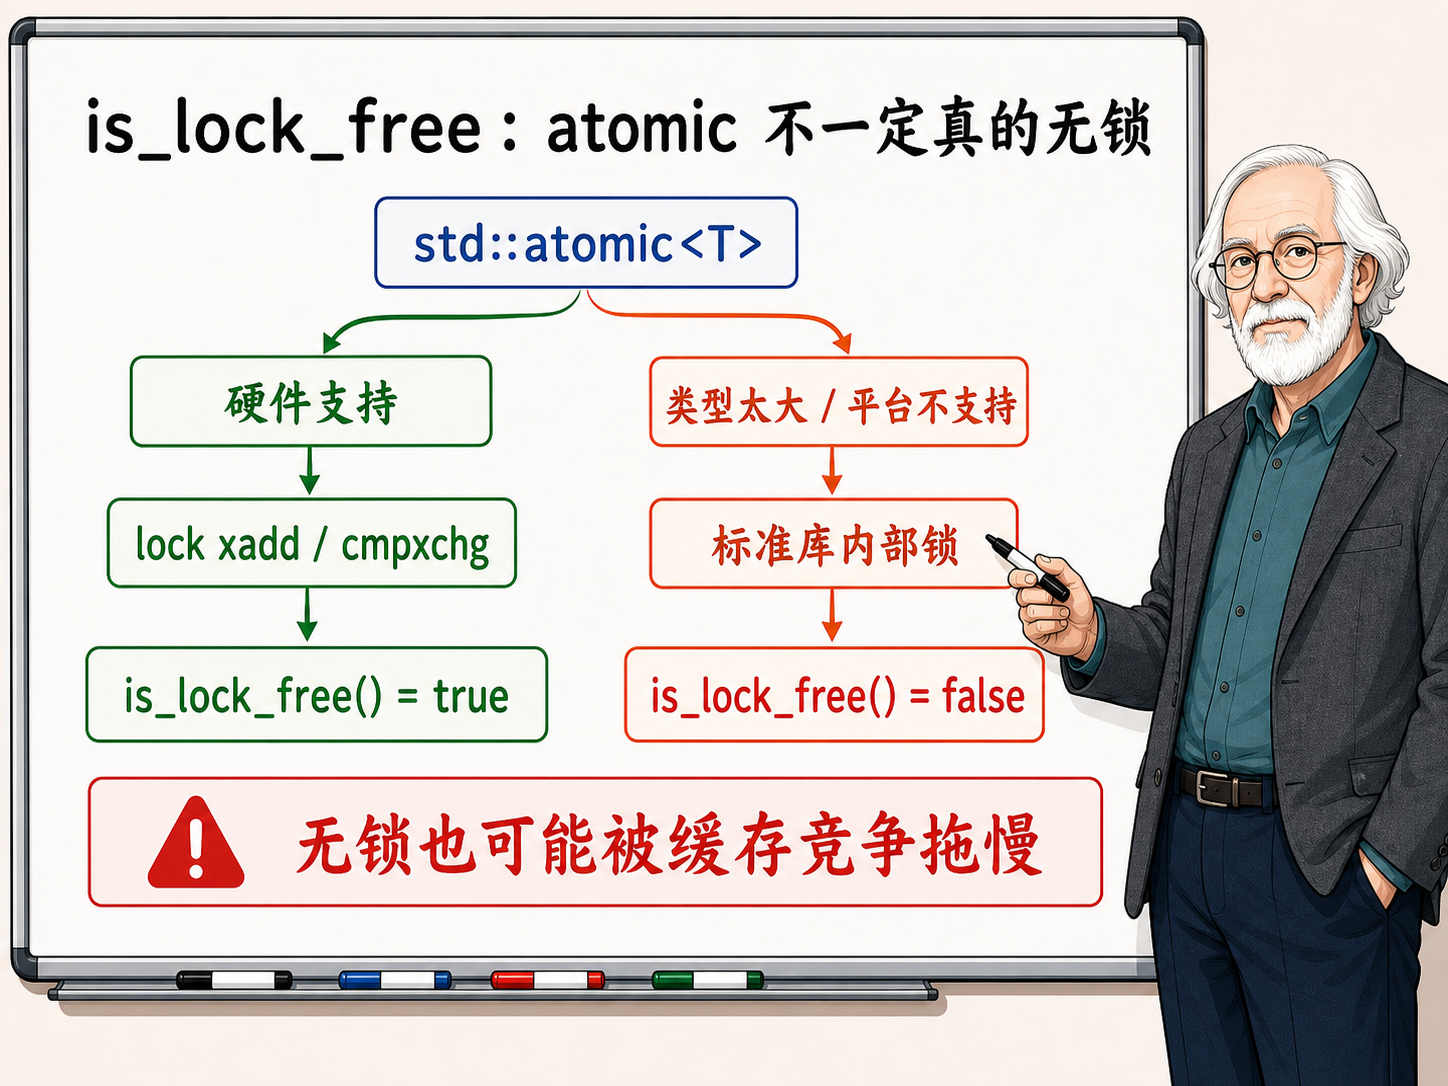
C++ 标准允许 std::atomic<T> 在硬件不支持的情况下,用内部的锁来模拟原子操作。只要对外的行为符合原子语义就行,标准不管你底层是怎么实现的。
#include <atomic>
#include <iostream>

struct BigStruct {
    long a, b, c, d;
};

int main() {
    std::atomic<BigStruct> big{};
    std::cout << std::boolalpha;
    std::cout << "BigStruct is lock free: " << big.is_lock_free() << "\n";
    std::cout << "int is lock free: "
              << std::atomic<int>{}.is_lock_free() << "\n";
}
is_lock_free() 返回 true 表示这个类型在当前平台上用的是纯硬件原子指令,没有内部锁。返回 false 就意味着标准库在底层用了锁——通常是一个哈希锁池,根据原子变量的地址映射到池中的某把互斥锁。
什么时候会退化成有锁?主要看类型的大小。x86-64 上,8 字节以内且自然对齐的类型,CPU 能用单条 lock cmpxchg 或者 lock xadd 搞定,是无锁的。16 字节的类型(比如两个指针拼在一起)在支持 cmpxchg16b 指令的 CPU 上也能无锁。再大就不行了——CPU 没有一条指令能原子地操作 32 字节的数据,标准库只能加锁。
C++17 引入了 is_always_lock_free 编译期常量,可以在编译阶段就知道某个类型在当前平台上是不是永远无锁:
static_assert(std::atomic<int>::is_always_lock_free,
              "int should be lock free on this platform");
还有一点需要注意:无锁不等于更快。无锁操作避免了操作系统层面的线程挂起和唤醒开销,但在高竞争场景下,多个核心同时用 lock 前缀指令争抢同一个缓存行,缓存一致性协议的开销也不小。在极端竞争下,无锁代码的性能可能还不如一把设计良好的 mutex——mutex 会让等待的线程挂起,减少了对缓存总线的争抢。
为什么 atomic 对象不能拷贝
你可能试过这么写:
std::atomic<int> a{1};
std::atomic<int> b = a;  // 编译失败
编译器会报错,因为 std::atomic 删除了拷贝构造函数和拷贝赋值运算符。
为什么要这么设计?因为"把一个原子变量的值拷贝到另一个原子变量"这件事,在硬件上做不到一步完成。你需要先从 a 读出值(一次原子操作),再把值写进 b(另一次原子操作)。这是两步,中间有缝隙。如果语言允许 b = a 这种写法,看起来像是一个原子操作,实际上不是,非常容易误导人。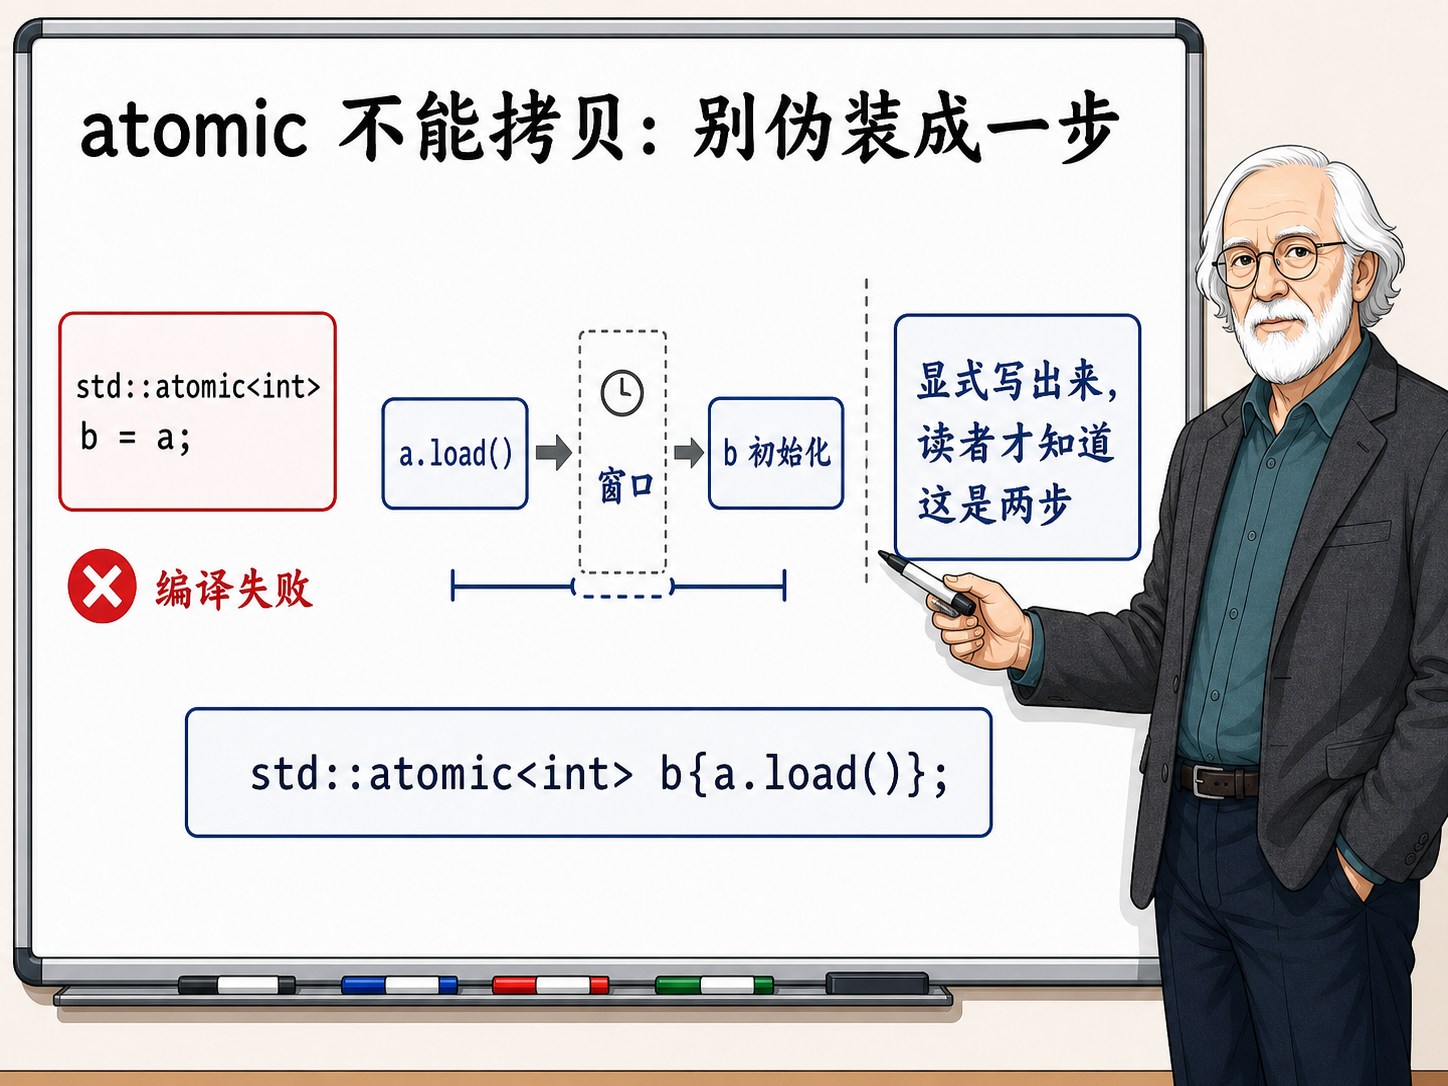
如果确实需要用 a 的当前值来初始化 b,就得显式地把两步写出来:
std::atomic<int> b{a.load()};
这样代码里一眼就能看出来:这是先读 a,再用读到的值初始化 b,是两个独立的操作。在 load() 和初始化之间,a 的值可能已经被别的线程改了。显式写出来,读代码的人就知道这里存在这个时间窗口。
atomic 只保护单个对象,保护不了业务不变量
这是 std::atomic 最容易让人栽跟头的地方:你把多个字段都声明成 atomic,每个字段的读写确实都是原子的、没有数据竞争的,但字段之间的一致性没有任何保障。
看一个账户结构体的例子:
#include <atomic>

struct Account {
    std::atomic<int> balance{0};
    std::atomic<int> version{0};
};

void UpdateAccount(Account& acc, int new_balance, int new_version) {
    acc.balance.store(new_balance);
    // ← 就在这两行之间,另一个线程可以读到账户
    acc.version.store(new_version);
}
balance.store() 和 version.store() 各自都是原子操作,单独看没有任何问题。但它们是两条独立的指令,中间有缝隙。在这个缝隙里,另一个线程调用 load() 读账户,会看到新的余额配上旧的版本号——一个"更新了一半"的断裂状态。
你用不用 seq_cst 都没用。seq_cst 保证的是每次原子操作本身的可见性和全局顺序,它不会把两次独立的 store 合并成一个不可分割的事务。
再看一个更常见的错误——用 atomic 做取款:
std::atomic<int> balance{100};

bool Withdraw(int amount) {
    if (balance.load() >= amount) {
        balance.store(balance.load() - amount);
        return true;
    }
    return false;
}
每次 load 和 store 都是原子的,但"检查余额"和"扣款"是两步操作。两个线程同时调用 Withdraw(80),都读到余额 100,都判断够用,都算出 20,都写回 20。取了两次 80 块钱,余额只扣了一次。
这种跨多步操作的一致性问题,atomic 单独解决不了。要么用 std::mutex 把多步操作锁在一起:
#include <mutex>

int balance = 100;
std::mutex mtx;

bool Withdraw(int amount) {
    std::lock_guard<std::mutex> lock(mtx);
    if (balance >= amount) {
        balance -= amount;
        return true;
    }
    return false;
}
要么用 CAS(Compare-And-Swap)把"读、判断、写"合成一步:
bool Withdraw(int amount) {
    int current = balance.load();
    while (current >= amount) {
        if (balance.compare_exchange_weak(current, current - amount)) {
            return true;
        }
        // CAS 失败时 current 会被自动刷新为最新值
    }
    return false;
}
compare_exchange_weak 的语义是:如果 balance 的当前值等于 current,就把它改成 current - amount,返回 true;如果不等于(说明中间被别的线程改过了),就把 current 更新成 balance 的最新值,返回 false,循环重来。这样就把竞争窗口堵住了。CAS 的详细用法留到第 10 章展开。
核心结论是这个:std::atomic 保护单个对象上的单次操作。如果你的业务逻辑跨越了多个变量、或者需要"先检查再操作"这种多步组合,atomic 帮不了你。要么用 mutex 划定完整的临界区,要么用 CAS 等无锁算法把多步合成一步。
指针类型的 atomic 有个步长陷阱
std::atomic 可以特化为指针类型 std::atomic<T*>。指针版本同样支持 fetch_add 和 fetch_sub,但它走的是 C++ 的指针算术规则,不是字节偏移。
struct Task {
    int id;
    char payload[60];
};

Task task_array[10];
std::atomic<Task*> task_ptr{&task_array[0]};

void Advance() {
    task_ptr.fetch_add(1);
}
这里 fetch_add(1) 传入的增量是 1,但指针内部的地址增量不是 1 字节,而是 1 * sizeof(Task)。如果 sizeof(Task) 是 64 字节,那指针会往前跳 64 字节,刚好指向数组里的下一个元素。这和普通指针 ptr + 1 的行为完全一致。
写无锁队列或内存池的时候,有人会想当然地以为 fetch_add(1) 是往前移一个字节,结果直接把指针跳到了不该去的位置,造成内存越界。在 code review 里看到指针类型的 atomic 做算术操作,要特别留意步长。
C++20 的两个重要补充
C++20 给 std::atomic 加了两个很实用的东西,值得简单提一下。
atomic_ref:临时给普通变量加原子保护
有些场景下,变量在大部分时间是串行访问的,只在特定的并发窗口才需要原子保护。把它声明成 atomic 意味着所有地方都要走原子操作的路径,串行部分的性能白白浪费了。
std::atomic_ref 解决的就是这个问题:它可以在需要的时候把一个普通变量临时包装成原子引用,用完就扔:
#include <atomic>

void ConcurrentAccumulate(int& global_sum, int value) {
    std::atomic_ref<int> ref(global_sum);
    ref.fetch_add(value, std::memory_order_relaxed);
}
global_sum 本身就是一个普通 int。在并发累加的时候,通过 atomic_ref 对它做原子操作;在串行计算的时候,直接用普通读写,编译器该怎么优化就怎么优化。
使用 atomic_ref 有一个硬性要求:被引用的变量必须满足对齐约束(可以通过 std::atomic_ref<T>::required_alignment 查询)。对齐不满足的话就是未定义行为。另外,在 atomic_ref 存在的整个期间,必须保证所有对该变量的访问都通过 atomic_ref 来做,不能一边用 atomic_ref 一边直接读写原始变量。
wait/notify:不用 mutex 也能等待
C++11 时代,如果你想让一个线程高效地等待某个原子标志的变化,要么忙等(浪费 CPU),要么得搬出 condition_variable(还得配一把 mutex,代码比较繁琐)。
C++20 直接在 std::atomic 上加了 wait() 和 notify_one()/notify_all():
#include <atomic>
#include <thread>

std::atomic<bool> data_ready{false};

void Worker() {
    data_ready.wait(false);  // 挂起,直到值不再是 false
    DoWork();
}

void Publisher() {
    PrepareData();
    data_ready.store(true);
    data_ready.notify_one();  // 唤醒等待的线程
}
wait(false) 的意思是:如果当前值等于 false,就挂起当前线程;等到值被改成别的东西并且被 notify 唤醒后,线程才恢复执行。底层在 Linux 上走的是 futex 系统调用,效率很高,不需要额外的互斥锁。
这对于轻量级的线程间通知来说非常方便——以前需要 mutex + condition_variable + bool 三件套才能做的事情,现在一个 atomic<bool> 就搞定了。
原子性和内存序是两层不同的问题
到这里,std::atomic 在单个对象上的保证已经说清楚了:读写不撕裂,读改写不被插入,多个线程对同一个 atomic 变量的修改会形成一条确定的修改顺序,不丢更新。这些都属于第一层问题——原子性。
但并发代码的正确性不只靠原子性。还有第二层问题:线程 A 写了一批普通数据,然后翻了一个原子标志位;线程 B 看到标志位变了,去读那批数据——线程 B 能不能保证看到线程 A 写入的数据?普通数据的修改有没有可能被 CPU 重排到标志位之后才对其他核心可见?
这就是内存序(Memory Ordering)要解决的问题。std::atomic 的每个操作都可以指定内存序参数——seq_cst、acquire、release、relaxed 等等——它们控制的就是原子操作前后普通数据的可见性和重排约束。
这两层问题是独立的。原子性管的是"这一次读写本身是完整的",内存序管的是"这次读写和其他数据之间的顺序关系"。光有原子性,没有正确的内存序,你可能成功地传递了标志位,但工作线程读到的数据还是旧的。
下一章进入 C++ 内存模型,看它到底在约束什么,以及为什么我们需要在语言层面对硬件的乱序行为划出一道明确的边界。
阅读导航



