
C++ vector 原理:连续数组、扩容与 reserve
02 vector 为什么是一段会长大的连续数组
一段代码,看起来没什么问题:
std::vector<int> v{1, 2, 3, 4, 5};
int* p = &v[2];          // 指向元素 3
v.push_back(6);
v.push_back(7);
v.push_back(8);
std::cout << *p << '\n'; // 还一定是 3 吗?
如果你跑过类似的代码,你可能已经见过两种情况:有时 *p 正常输出 3,有时输出的是一个莫名其妙的数字,甚至直接崩溃。指针 p 没有变过,它始终指向当初那块内存地址,问题出在 push_back 的过程中,vector 悄悄换了地盘。
vector 把元素放在一段连续内存里,这段内存的大小是有限的。当元素数量超过内存容量时,vector 会申请一块更大的新内存,把旧元素搬过去,再释放旧内存。这个过程中,p 指向的旧内存已经不属于 vector 了,程序继续通过 p 访问那块地址就是在读一堆不确定的内容,更正式的说法是,p 变成了一个失效的指针。理解 vector 的全部关键,就藏在它管理这段连续内存的方式里。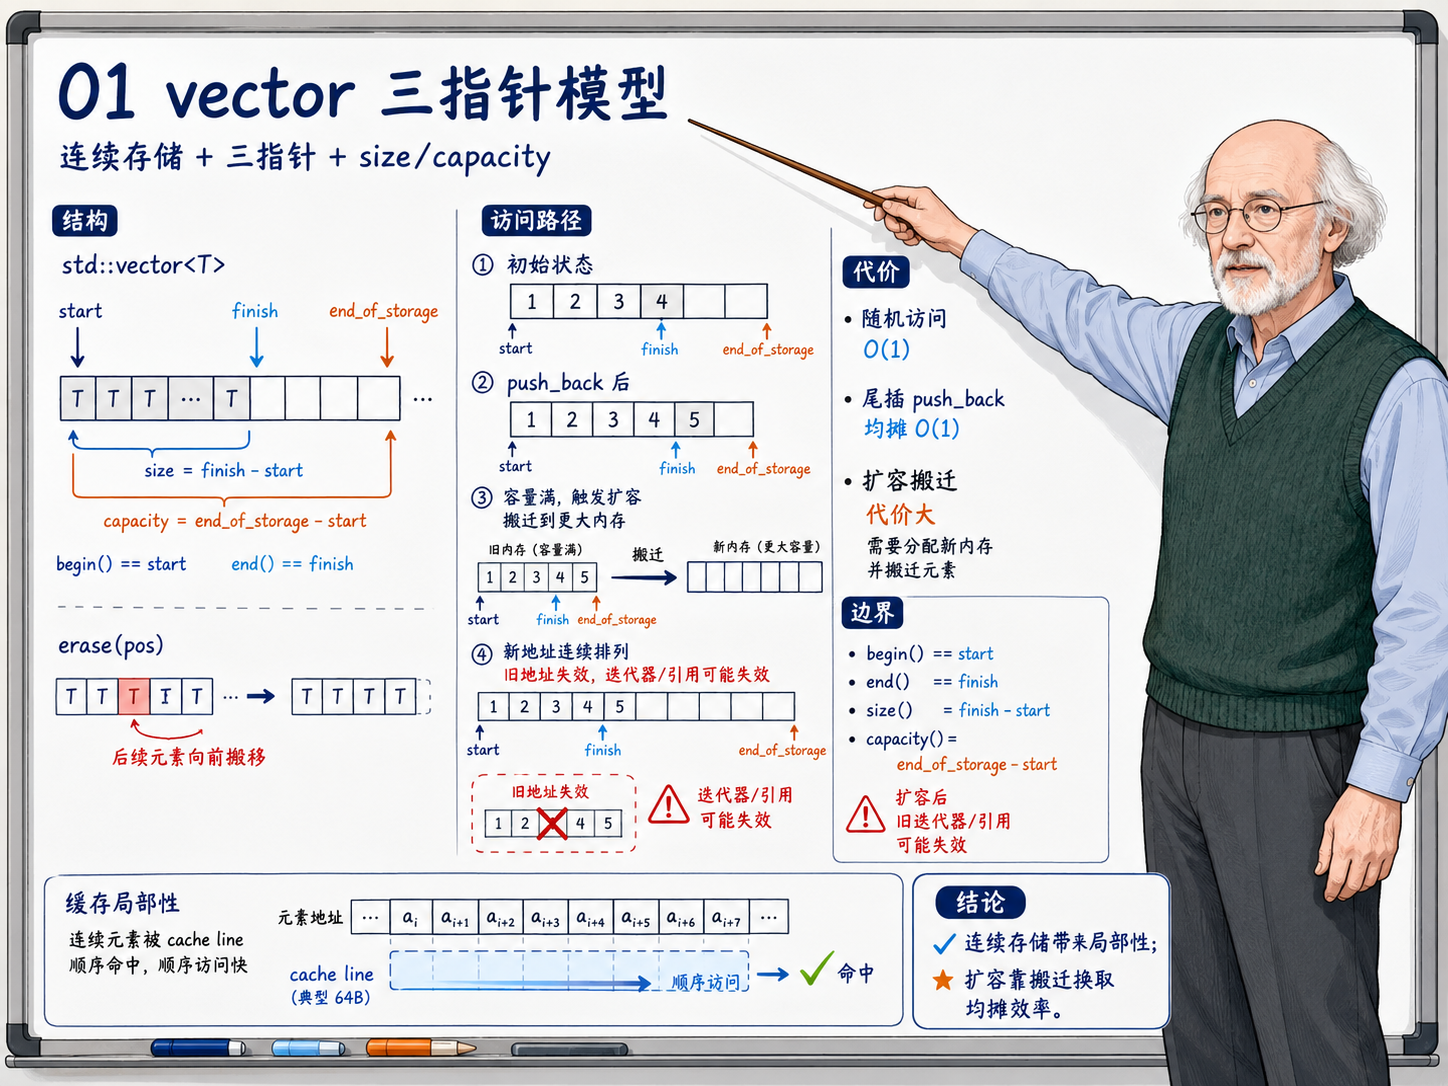
三个指针管一个数组
一个 vector 对象本身通常很小,在很多实现里就是三个指针的大小,也就是 24 字节(64 位系统上)。这三个指针各自标记一段连续内存区域的不同边界:
- 第一个指针指向数组的起始位置,整段内存的首地址。
- 第二个指针指向最后一个有效元素的下一个位置,这个位置之前的所有元素都是已经构造的、可以安全访问的元素。这个指针与起始指针之间的元素数量就是
size()。 - 第三个指针指向整段内存的末尾,这是当前分配空间的终点,从这个位置开始不能再存放新元素,除非扩容。这个指针与起始指针之间的元素数量就是
capacity()。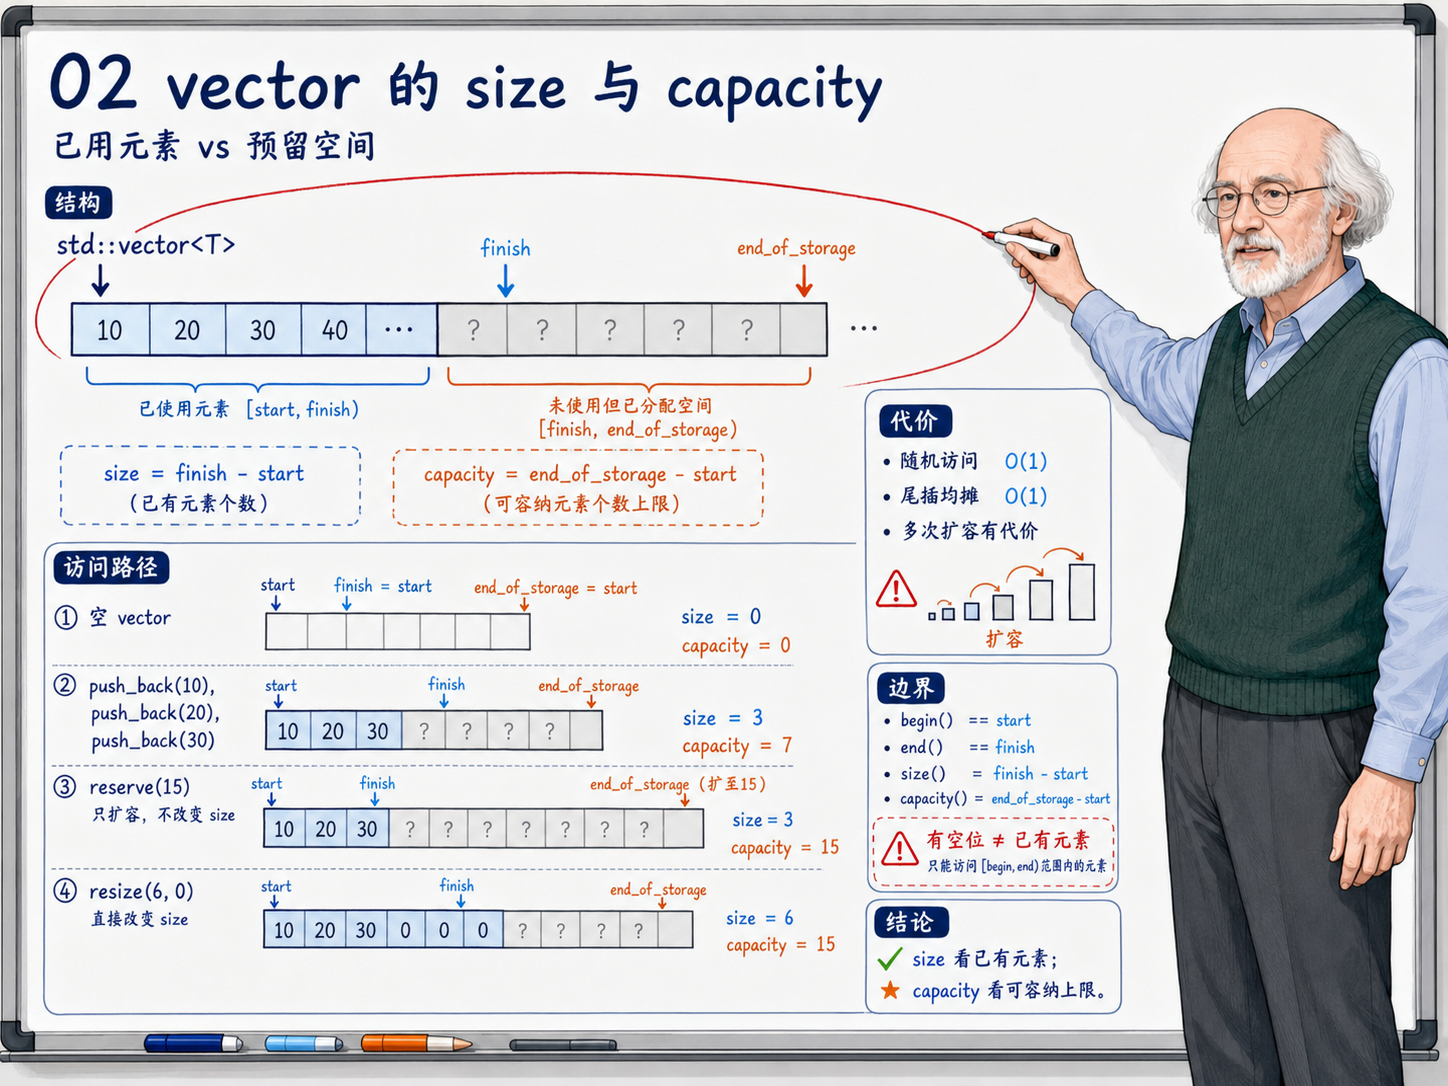
size()和capacity()是两个经常被混淆的概念。size()回答"目前有多少个元素",capacity()回答"目前最多能装多少个元素而不需要重新分配内存"。对于一个刚创建的空vector,size()为 0 是确定的,capacity()为多少则由实现决定,可以是 0,也可以是一个小正数。
当你调用 v.push_back(x) 时,vector 先检查 size() < capacity():
- 如果还有剩余空间,它直接在
size()位置构造新元素(对于支持移动的类型使用移动构造,否则拷贝构造),然后把 size 指针后移一个位置。整个过程只碰了数组末尾的一个位置,时间复杂度 O(1),而且不会影响任何已有元素的地址。 - 如果
size() == capacity(),也就是空间满了,那就需要扩容:分配一块更大的新内存,把旧元素逐个移动(或拷贝)到新内存,在新内存的 size 位置构造新元素,销毁旧内存中的旧元素,释放旧内存,最后把三个指针都指向新内存。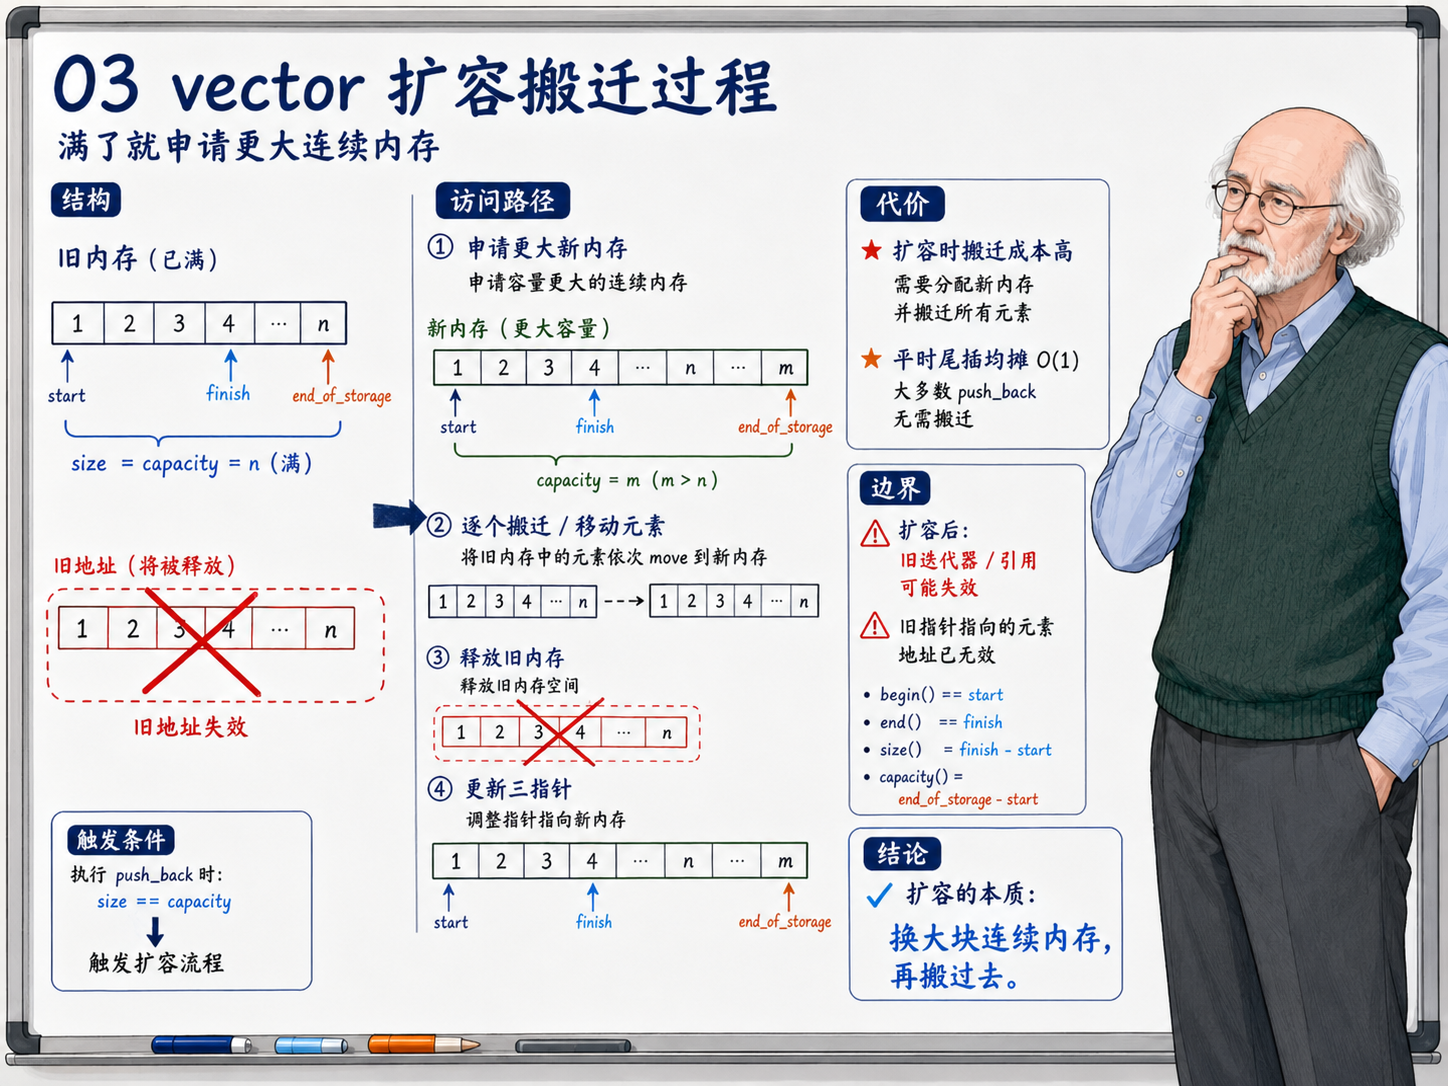
扩容的代价不仅仅是分配和释放内存,更重要的是所有指向旧内存中元素的指针、引用和迭代器都失效了,它们仍然持有旧地址,但那个地址上的对象已经被销毁,内存已经被归还。在这之后继续使用它们,属于未定义行为。
扩容因子的工程直觉
vector 的扩容策略并不是标准规定的,各实现可以自行决定。常见实现采用几何增长:当容量不足时,新容量通常是旧容量乘以一个约在 1.5 到 2 之间的因子。GCC 的 libstdc使用 2 倍增长,Clang 的 libc 使用约 1.5 倍增长,MSVC 的 STL 也使用约 1.5 倍。
几何增长的关键价值在于分摊复杂度。如果你每次 push_back 都只多分配一个位置,那么插入 n 个元素需要 O(n²) 次元素移动。但如果你按倍数扩容,比如每次翻倍,插入 n 个元素只需要移动约 2n 次元素,平摊到每次 push_back 上就是 O(1)。这个分析叫分摊分析(amortized analysis),它说明扩容虽然偶尔很贵,但从长期平均来看,每次 push_back 的代价是常数级别。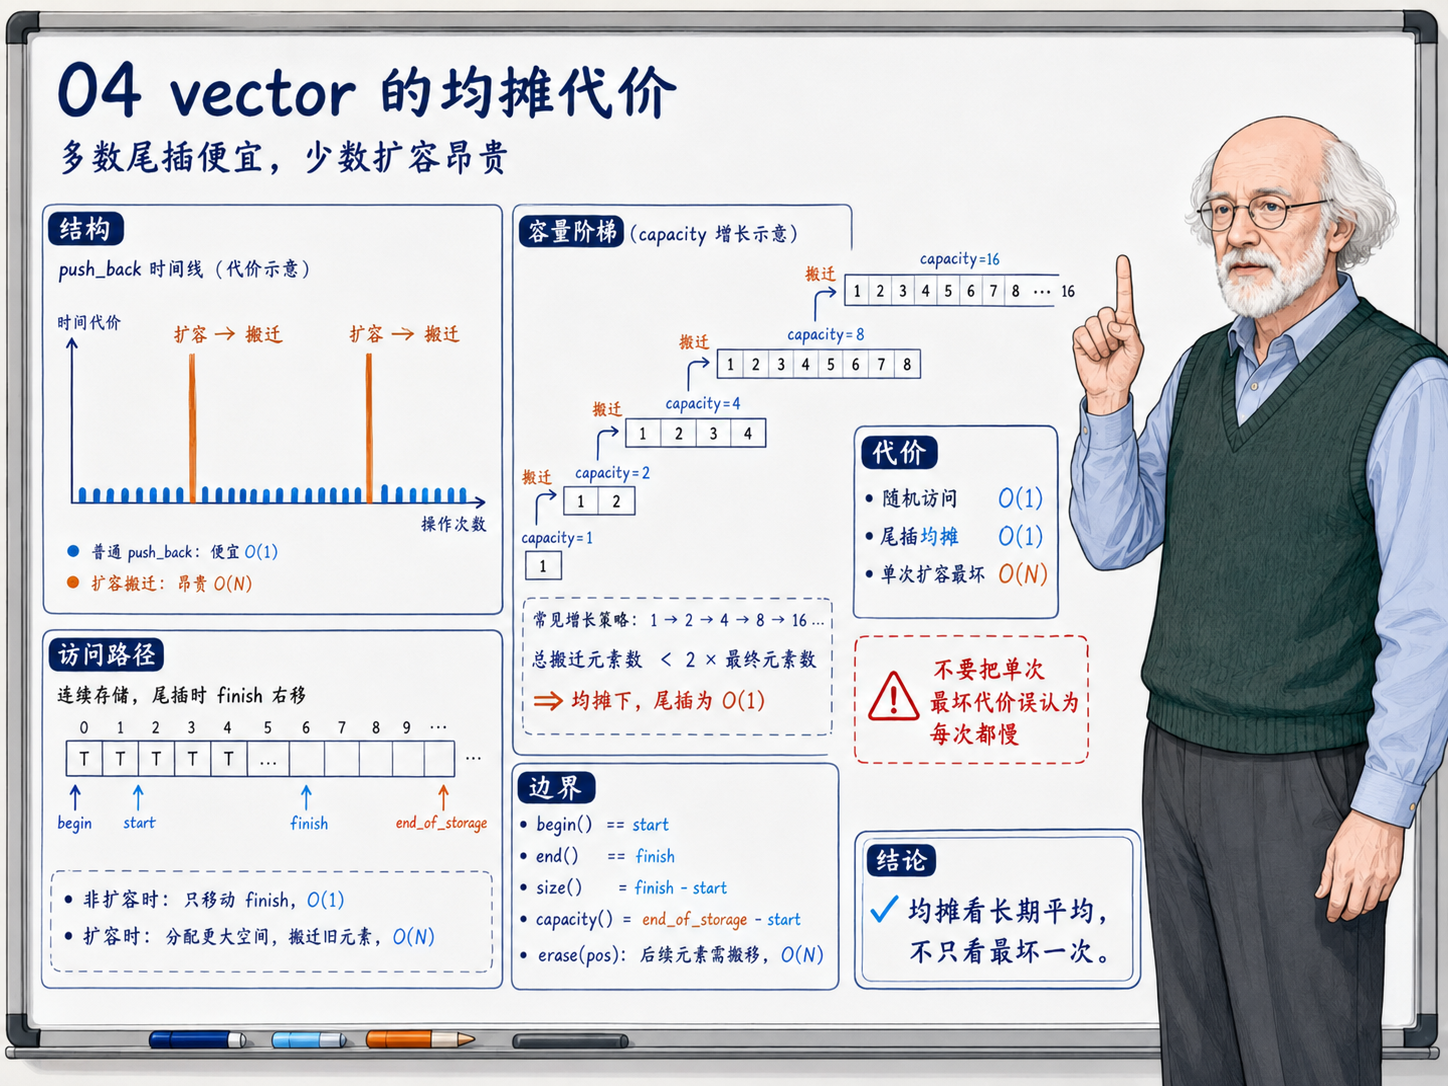
扩容因子的大小在时间和空间之间做取舍。2 倍增长在平均情况下移动次数最少,但可能造成较大的内存浪费,在一个 capacity 为 1000 的 vector 扩容为 2000 后,你只 push_back 了一个元素,剩下 999 个位置都空着。1.5 倍增长浪费更少,但扩容次数更多,移动总次数略高。这些都是工程权衡,不是对错问题,不过你不需要关心具体实现用了多少,除非你在极度内存受限的嵌入式环境中。
reserve 和 resize:两件完全不同的事
理解了 size 和 capacity 的分离,reserve 和 resize 的区别就变得清晰了。
reserve(n) 只做一件事:确保 capacity() >= n。如果当前容量已经够大,它什么都不做。如果不够,它分配新内存、移动元素、更新指针,但不创建任何新元素。调用 reserve 后,size() 不变,元素数量不变,但 capacity() 至少为 n。这意味着你可以安全地 push_back 最多 n - size() 个元素而不触发再次扩容。
reserve 最适合的场景是:你预先知道大概要放多少元素,但需要逐步构造它们,比如从文件读取未知格式的行,每次解析一条记录后 push_back。提前 reserve 可以消除反复扩容的移动开销,同时保留按需构造的灵活性。
resize(n) 做的是另一件事:它改变 size()。resize(n) 之后,vector 中恰好有 n 个元素:
- 如果 n 大于当前
size(),多出的位置会被填充为默认值(或你提供的填充值),这些元素是真真切切创建出来的,不是"预留空间"。 - 如果 n 小于当前
size(),尾部的多余元素会被销毁,size()减小。
一个重要但容易忽略的细节:resize(n)可能会触发扩容(如果 n 超过了capacity()),但reserve(n)不会创建元素。另外,reserve不能用来减少容量,如果当前capacity()是 1000,reserve(500)不会把容量缩回到 500。如果你真的需要释放多余空间,可以考虑shrink_to_fit()(但它只是一个建议,实现有权忽略),或者用 swap 技巧:std::vector<T>(v).swap(v),这个临时vector只拷贝了有效元素,没有多余容量。
#include <iostream>
#include <vector>

int main() {
    std::vector<int> v;
    std::cout << "初始 size:" << v.size() << " capacity:" << v.capacity() << '\n';

    v.reserve(8);
    std::cout << "reserve(8)后 size:" << v.size() << " capacity:" << v.capacity() << '\n';
    // size 仍是 0,但 capacity 至少为 8

    v.resize(5, 42);
    std::cout << "resize(5,42)后 size:" << v.size() << " capacity:" << v.capacity() << '\n';
    // 真的创建了 5 个元素,值都是 42

    for (int i = 0; i < 5; ++i)
        v.push_back(i);
    std::cout << "push_back 5次后 size:" << v.size() << " capacity:" << v.capacity() << '\n';
    // 这 5 次 push_back 都没有触发扩容,因为之前 reserve(8) 留了空间
}
这段代码里 capacity 的具体数字取决于实现。在某个实现下,没 reserve(8) 时 push_back 可能从 0→1→2→4→8 触发多次扩容;提前 reserve(8) 之后,前 8 个元素的 push_back 都在已经分配好的内存里进行,没有任何移动,这就是 reserve 的价值:付费一次,后续免单。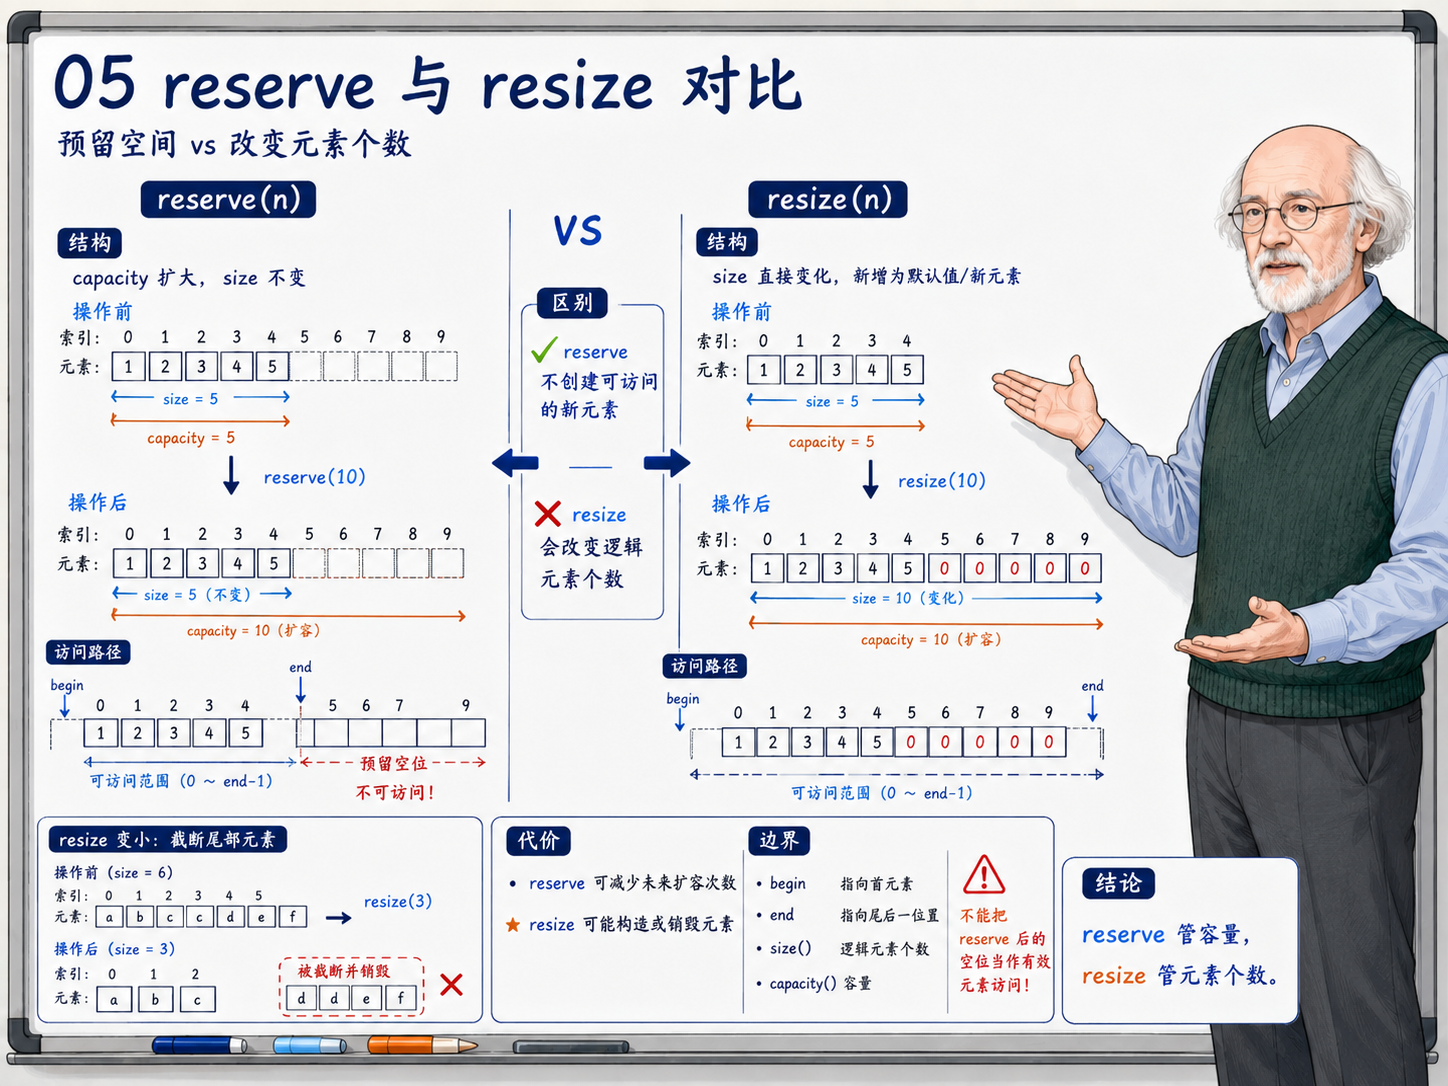
emplace_back:原地构造一个元素
push_back 和 emplace_back 都是在尾部添加一个元素,区别在于参数传递路径。
push_back(x) 接受一个已经构造好的对象(或能转换为 T 的对象),然后调用 T 的拷贝或移动构造函数把它放进 vector 末尾的新位置。这意味着如果你写 v.push_back(T(arg1, arg2)),程序会先在栈上构造一个临时 T 对象,再把它移动(或拷贝)进 vector,最后销毁临时对象。两步构造,一次移动,一步销毁。
emplace_back(arg1, arg2) 接受构造 T 所需的参数,直接在 vector 末尾的内存位置上原地构造 T,跳过临时对象的创建和销毁。对于构造开销大的对象(如 std::string、包含大量成员的结构体),emplace_back 可以省掉一次移动或拷贝。但对于简单类型(如 int、指针),两者的性能差异可以忽略,选择哪个更多是表达意图的问题。
一个常见的误解是"emplace_back 永远比 push_back 快",这并不成立。首先,如果 push_back 接收到的是一个右值引用(push_back(std::move(x)) 或 push_back(T(arg1, arg2))),它调用的就是移动构造,成本通常已经很低。其次,在一些实现中,emplace_back 的完美转发和可变参数模板展开会增加编译开销,运行时差距可以忽略。选择 emplace_back 的理由很具体:我想直接在容器里构造这个元素,减少临时对象的中间步骤。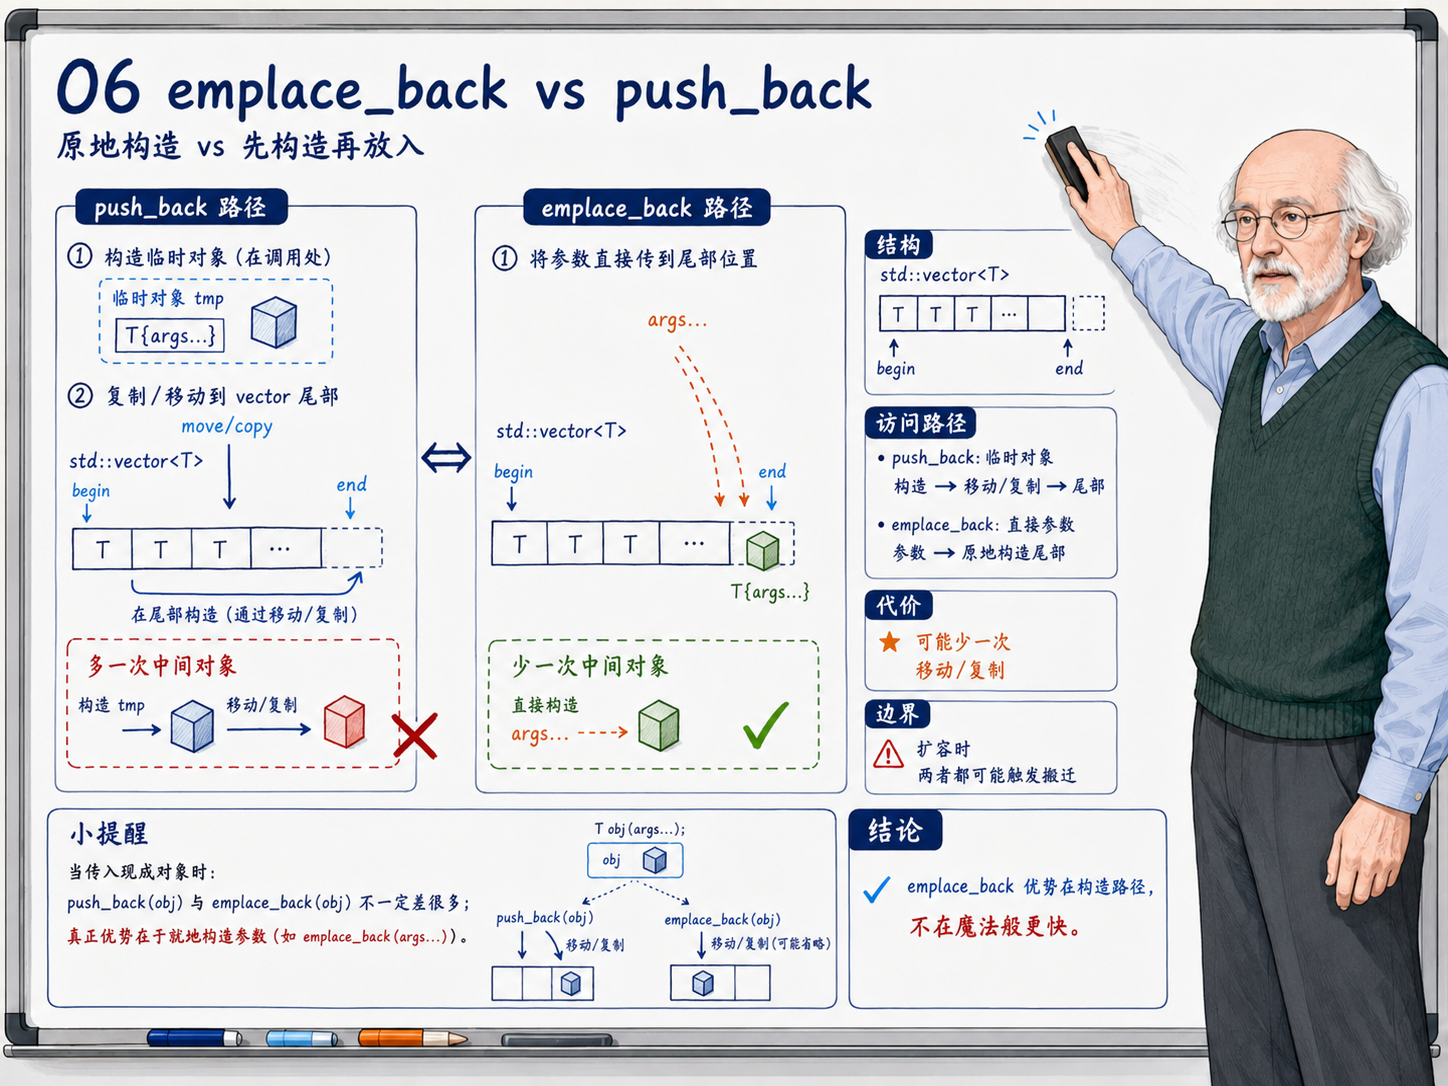
为什么 vector 通常是默认选择
就算你对其他容器还不太熟悉,一条可靠的工程基线是:不确定该用什么容器时,先写 vector。这背后有几个相互支撑的理由。
首先是缓存。现代 CPU 的缓存行通常是 64 字节,当你的代码访问某个元素时,CPU 会把包含该地址的一整块连续内存(一个缓存行)拉进缓存。对于 vector,当前元素和它邻近的元素大概率在同一个缓存行里,甚至是接下来的好几个缓存行都被预取器提前加载了。因此遍历 vector 时,大部分访问都命中 L1 或 L2 缓存,延迟是几个时钟周期的量级。而 list 的节点分散在堆上各处,每次访问下一个节点都是一次随机的内存跳转,L1 缓存的命中率惨淡,时常要等几百个时钟周期从主存取数据。
其次是简单。vector 的连续内存布局意味着它可以无缝对接 C 接口,v.data() 就是指向数组的指针,直接传给任何接受 T* 和长度的函数。vector 的复制语义也很直观:v2 = v1 之后,v2 拥有一份完全独立的拷贝,修改 v2 不影响 v1。
再次是遍历效率。因为元素连续排列,标准的 for (auto& x : v) 本质上就是一段连续的指针扫描,编译器可以把它优化成紧凑的循环,甚至用 SIMD 指令向量化处理。而在链表上遍历,编译器很难预判下一个节点的地址,向量化几乎不可能。
vector 不是完美的。如果在中间频繁插入或删除,搬动后续元素的代价会积累;如果需要保证指向某个元素的迭代器在容器生长期间始终有效,vector 无法给出这个承诺;如果元素的构造和拷贝成本极高,扩容时的批量移动会很疼。但这些场景在大多数日常 C++ 代码中出现的频率比你想象的低得多,而遍历、随机访问、缓存友好的连续扫描这些操作几乎在任何程序里都会出现。
当 vector 确实不合适时,线索通常很明显:你需要 push_front 却不想自己搬元素(deque),你需要稳定的节点位置(list),你需要按键查找和有序遍历(map)。这些场景的入口都是清晰的,而在入口出现之前,vector 就是最接近"不会做错"的选择。
还有一个容易被忽略的维度是异常安全。vector 扩容时会把旧元素搬到新内存中,如果元素类型的移动构造可能抛异常,实现必须在性能和强异常保证之间做权衡。对于大多数可高效移动且移动不抛异常的类型,扩容可以很顺畅;对于移动可能抛异常但拷贝可用的类型,实现可能选择拷贝来保留更强的异常保证;对于既难移动又难拷贝的类型,vector 的扩容成本就会非常真实。这也是现代 C++ 鼓励为资源管理类型提供 noexcept 移动构造的原因之一:它不只让单个对象移动更安全,也让 vector 这样的容器在扩容时能采用更高效的路径。
reserve 的价值在这里再次出现。提前 reserve 不只是减少分配次数,也减少了那些潜在的移动、拷贝和异常处理路径。比如你从网络包中解析出一批记录,包头已经告诉你记录数量,这时先 records.reserve(count) 是一种很明确的工程表达:我知道这次批量装载的规模,我愿意一次性付出分配成本,避免后续每次增长都触发结构变化。这个调用不会让代码更复杂,却能让性能曲线更可预测。
vector 的另一个工程优势是内存占用透明。一个 vector<T> 的控制块通常只包含少量指针,元素本体集中放在一段连续内存里;如果你存的是一百万个 int,额外开销主要来自那段数组的预留容量。list 或 map 这类节点容器则完全不同,每个元素都伴随指针、节点头、分配器元数据和对齐开销。理论复杂度表不会告诉你这些细节,但真实系统的内存压力会把它们全部算账。很多时候,vector 快的原因并不神秘:它的 O(1) 下标访问直接,元素之外的额外结构也很少。
不过,vector 的连续性也带来一个限制:大容量增长需要找到一整块足够大的连续虚拟地址区间。现代 64 位进程通常不太担心虚拟地址空间,但在内存碎片严重、嵌入式平台、长期运行服务或自定义分配器场景中,"一次性申请一大块连续空间"仍然可能成为问题。相比之下,deque 的分段设计和节点容器的逐节点分配对连续大块内存的依赖更低。这个差异不会出现在普通小程序里,却会在高负载服务和内存受限环境里变成实际约束。
因此,vector 的默认地位来自一组现实优势:连续内存、低额外开销、缓存友好、接口简单、容易和 C 接口互操作、适合编译器优化。只要你的需求没有明确反对这些优势,先选 vector 通常是合理的;一旦需求明确要求头部高效插入、稳定迭代器、按键有序查找或避免大块连续分配,再换到其他容器才有充分理由。
再看生命周期问题。vector 的 clear() 会销毁所有已构造元素,并把 size() 变成 0,但它通常不会释放已经分配的容量;这意味着下一轮重新 push_back 时可以复用原有空间。对于循环处理批次数据的程序,这个行为很有用:每一批数据处理完 clear(),下一批继续往同一块容量里写,减少反复分配。相反,如果你真的想归还内存,只调用 clear() 不够,需要考虑 shrink_to_fit() 或用一个新的临时 vector 交换。这里没有绝对正确,关键是你要知道自己想要的是"清空元素"还是"释放容量"。
另一个常见误区是把 capacity() 当作元素数量。capacity() 只是已经申请但尚未全部使用的空间,只有 [0, size()) 范围内的元素是真正构造好的对象。你不能因为 capacity() 是 100,就访问 v[50],除非 size() 也大于 50。reserve(100) 之后直接写 v[0] = x 是错误的,因为第 0 个元素还没有被构造;正确做法是 push_back、emplace_back 或 resize 后再访问。这个区别看起来细,却是理解 C++ 容器和对象生命周期的入口。
在性能敏感代码里,vector 还经常和分配器一起出现。默认分配器已经足够好,但如果你的程序在一个固定内存池里工作,或者需要把大量短生命周期的数组放进 arena,std::pmr::vector 可以让分配策略从容器逻辑中分离出来。容器仍然负责连续存储、扩容、元素构造和析构,内存来源则交给 polymorphic memory resource。这样做的意义不是炫技,而是把"数据结构"和"内存供应"拆成两个可控层次。
最后要强调一点:vector 的强大来自它的简单模型。三根指针,一段连续内存,一组已构造元素,一段尚未使用的容量。你越清楚这四件事,就越能解释它的所有行为:为什么下标快,为什么扩容会让迭代器失效,为什么 reserve 不改变 size,为什么 resize 会构造元素,为什么 data() 能交给 C 接口。掌握 vector 的价值不在于背会 API,而在于把这段连续内存的状态变化看清楚。
这个模型也能帮助你审查接口。一个函数如果接受 std::vector<T> 值传递,调用时会复制整段有效元素,除非编译器通过移动或返回值优化消掉成本;一个函数如果接受 const std::vector<T>&,它承诺只读一段动态数组;一个函数如果接受 std::span<const T>,它只要求调用方提供一段连续元素,来源可以是 vector、array、C 数组甚至内存映射区域。把 vector 放进接口时,要想清楚你到底需要的是"拥有一段可增长数组",还是只需要"观察一段连续元素"。前者用 vector 合理,后者用范围视图更轻。
vector 还经常出现在对象所有权设计里。vector<T> 表示容器直接拥有一批 T 对象,扩容时可能移动这些对象;vector<std::unique_ptr<T>> 表示容器拥有一批指针,真正的对象在堆上,扩容时移动的是 unique_ptr,对象地址不变;vector<T*> 则通常只表示观察或索引,生命周期由别处管理。三种写法在语法上都能 push_back,但工程含义完全不同。写 vector 时要同时回答两个问题:数组拥有谁,数组增长时谁会被移动。
调试 vector 问题时,最有用的观察点也来自这套模型。打印 size()、capacity()、data() 地址,基本可以判断一次操作是否触发了扩容;在可疑代码前后保存 &v[0] 或 v.data(),可以快速确认旧指针是否还指向同一段内存;打开 AddressSanitizer 后,扩容后的悬空访问通常会被更早暴露。相比凭感觉猜"是不是 vector 出问题了",把三根指针和元素生命周期拆开检查,定位效率高得多。
还有一个实践细节值得养成习惯:把会改变容量的阶段和会保存元素位置的阶段分开。比如先读入全部数据、reserve 或构造好 vector,再把指针、引用、span、迭代器交给后续处理;不要一边把 data() 传给下游,一边继续向同一个 vector 追加元素。连续内存给了你非常高的访问效率,但这个效率建立在数组边界稳定的前提上。边界还在变化时,外部位置就不应该被长期保存。
如果你需要同时满足"可增长"和"外部位置稳定",通常说明一个 vector<T> 承担了两类互相冲突的职责。可以用 vector<std::unique_ptr<T>> 稳定对象地址,也可以用 deque<T> 降低两端增长时的搬动风险,还可以用业务 ID 替代裸指针,让外部每次按 ID 重新定位。具体选哪条路取决于访问模式,但不要用侥幸心理依赖"这次 push_back 可能不会扩容"。只要标准不保证,热路径和长期维护代码里就不该把它当保证。
测试 vector 代码时,建议刻意制造扩容场景。很多 bug 在小数据下不会出现,因为容量刚好够用;测试里先 shrink_to_fit() 再追加,或者从空 vector 逐步插入,能更容易触发重新分配。对于依赖 reserve 的代码,还要测"预估不足"的路径,确认容量超过预估后程序仍然不会使用旧指针。能通过扩容测试的代码,才真正理解了 vector 的动态数组本质。
写性能代码时,vector 还有一个很朴素的优势:它容易被工具观察。缓存未命中、分配次数、元素地址变化、循环向量化情况,都能通过 profiler、sanitizer 或简单日志看到。相比节点结构里分散的小对象,连续数组的状态更集中,也更容易建立因果关系。默认从 vector 开始,不只是为了运行快,也为了让早期代码更容易测量和修正。
这份可观察性会直接影响维护成本。
也会影响后续调优的可信度。
连续不是顺序的唯一形态
vector 用连续内存解决了"位置"问题:每个元素都有固定的空间偏移,访问就是把指针往前移一块。但 C++ 标准库还提供了其他顺序存储的选择。string 把连续字符序列包装成文本语义,array 把连续存存放进编译期固定的大小,deque 用分段连续来换取两端高效增长,它们不违反"顺序容器按位置组织元素"的约束,只是在"连续"和"大小确定"这两个维度上划出了不同的边界。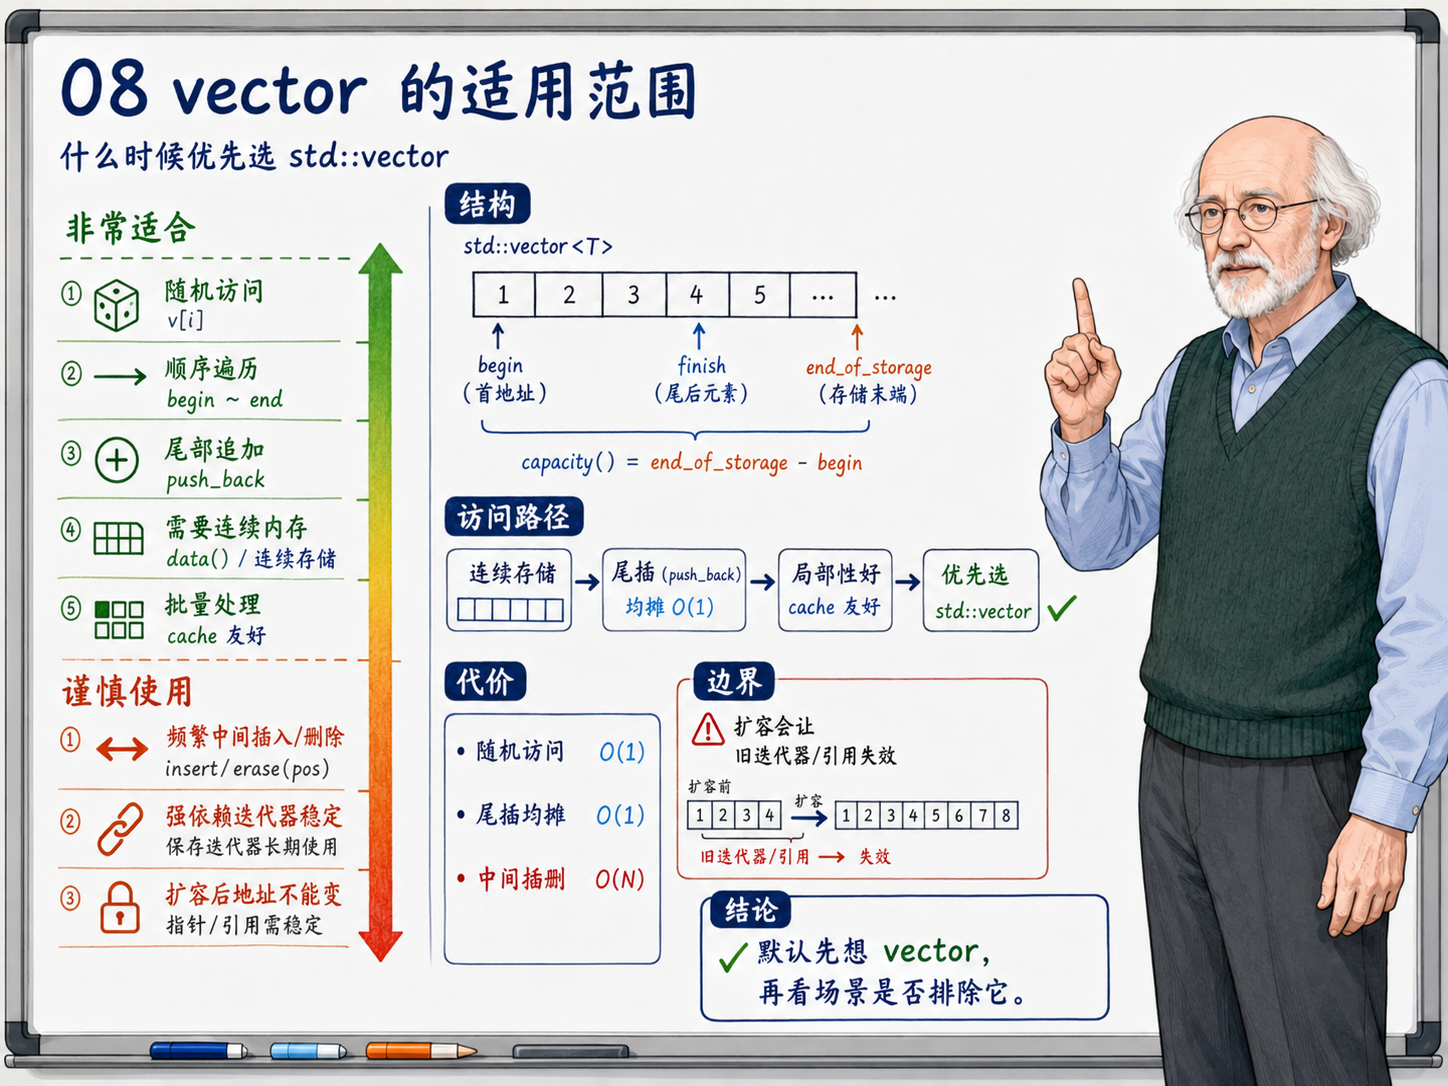
阅读导航



