
C++ 名字、地址、指针与引用:借用和拥有的区别
02 名字、地址、指针和引用不是一回事
int value = 42;
int* p = &value;
int& r = value;
短短三行代码,展示了 C++ 内存模型中最基础的实体映射关系。第一行声明将一个标识符与一块分配在特定作用域内的内存空间进行绑定;第二行在内存中实例化了一个独立的新实体,专门用于存储第一块内存的坐标;第三行没有创建新实体,而是直接为原有内存空间注册了一个并行的别名。
在很多内存泄漏、越界覆写、悬空访问以及难以复现的数据错乱问题中,根源往往在于开发者未能清晰界定“具备内存访问能力”与“掌握内存所有权”之间的边界。许多习惯了带有垃圾回收机制(GC)的语言的工程师,容易将变量名等同于对象本身。这种思维惯性在 C++严苛的规则下极易引发错误。理解 C++ 的资源模型,需要明确区分名字(name)、对象(object)、地址(address)、指针值(pointer value)以及引用绑定(reference binding),将它们作为独立且正交的维度进行拆解。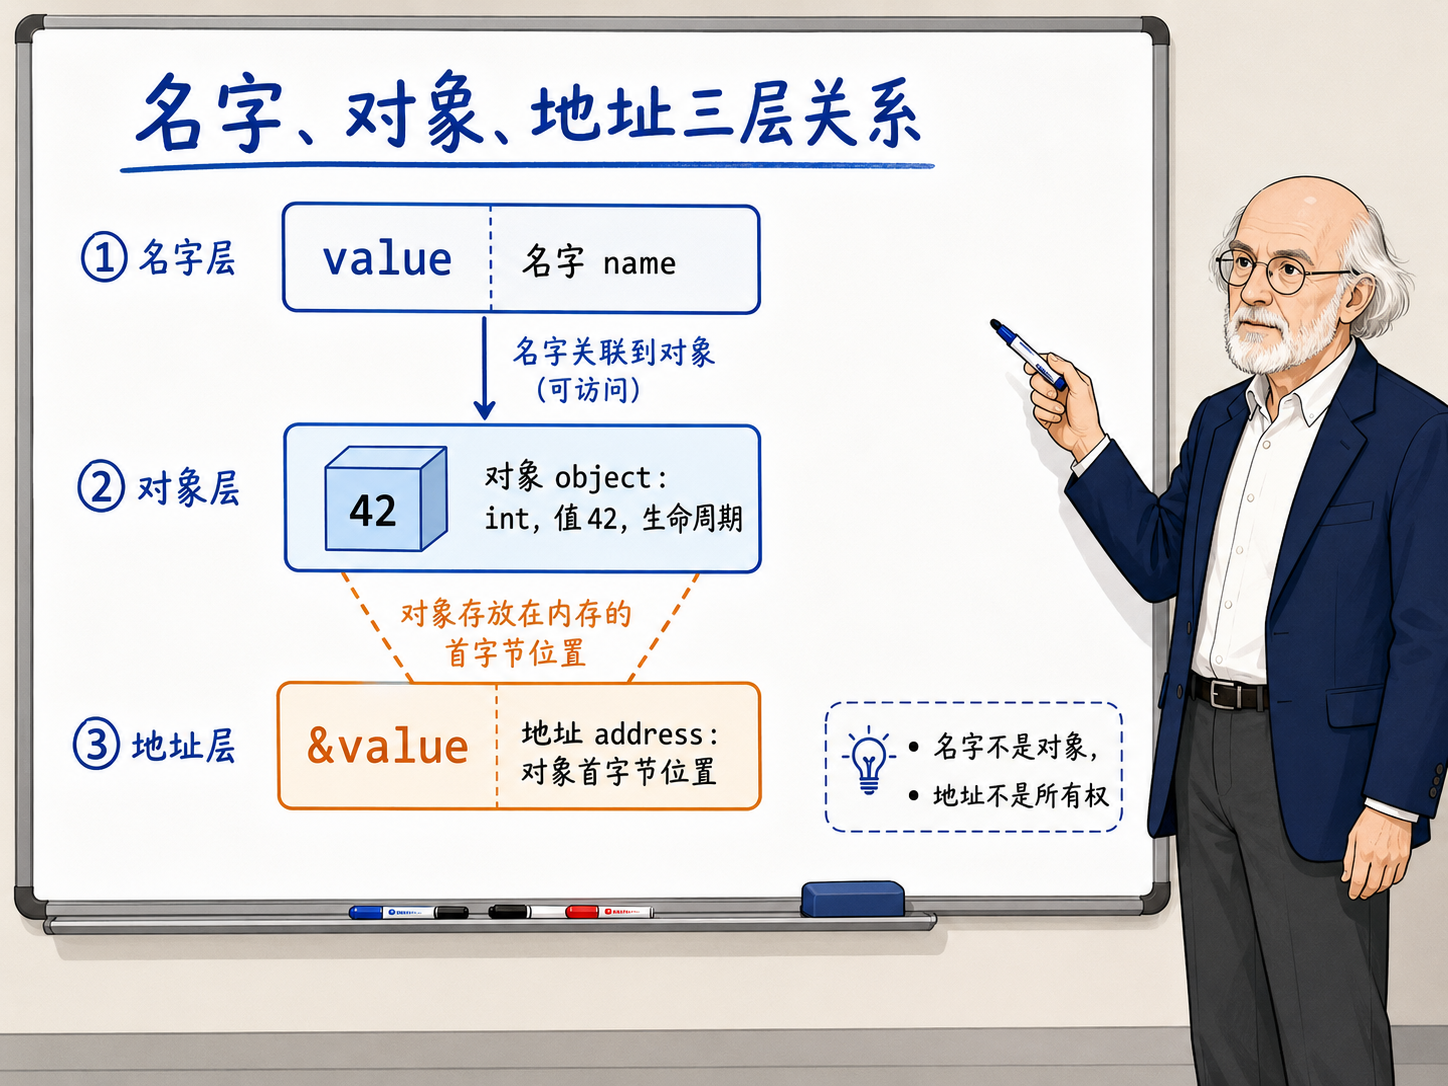
一、 名字是入口,对象是实体,地址是位置
在 C++的语境中,名字和对象属于两个完全不同的层面。对象(Object)是物理层面的实体,根据 C++ 标准,对象是具有特定生命周期、占据确定大小的存储空间、容纳特定类型值并受制于严格别名规则(Strict Aliasing)的内存区域。而名字(Name,或称标识符 Identifier),仅仅是源代码在编译阶段为了追踪和操作对象而引入的词汇锚点。
书写 int value = 42; 时,编译器在目标作用域(例如当前函数的栈帧)内划拨出一块精确占据 4 字节的连续内存区域,这片区域就是对象实体。这块内存本身有着严格的对齐要求,并在分配后被初始化为 42。随后,编译器通过符号表将 value 这个名字映射到该内存区域的基准偏移量上。必须认识到,名字是专门服务于人类开发者和编译期静态分析的工具。在经历编译、链接并最终转化为机器指令后,名字的概念通常会被彻底抹除。运行期的程序不知 value 为何物,它只认得具体的内存位置和数据本身。
更为关键的是,对象与名字之间并非一一对应的强制绑定关系。在 C++ 程序中,存在大量拥有完整生命周期却毫无名字的对象。例如,通过 new int(10) 动态分配的堆对象、在表达式 std::string("hello") + " world" 求值期间产生的临时对象,甚至数组中的各个元素,它们真实占据物理内存空间,参与复杂的计算流程,却自始至终没有属于自己的名字。反过来,同一个名字在不同的控制流阶段或不同的作用域中,也可能指代截然不同的对象实体。名字还会发生作用域遮蔽(Shadowing)现象,内层作用域的同名变量会暂时屏蔽外层变量,此时外层对象在内存中依然存活,只是当前通过这个名字无法直接触达。
从底层内存布局来看,名字的缺失并不会影响对象的实质存在。以大型数组或容器为例,内存中可能整齐排列着数以万计的对象实体,它们不仅没有属于自己的标识符,而且仅仅依靠一个公共的起始基址加上各自的内存偏移量来进行定位。同样地,在执行诸如链式调用或复杂算术表达式时,编译器会在后台默默分配大量的临时对象作为计算的中转站,这些无名对象在完成自身使命后便迅速消亡。在这个过程中,物理内存经历了频繁的分配与写入,而源代码层面的“名字”却从头到尾未曾参与。
作用域遮蔽现象更是将名字与对象的松耦合体现得淋漓尽致。当内层控制块声明了一个与外部同名的变量时,编译器只是在当前作用域的符号表中做了一次临时的路由重定向。外层的那个对象依然稳固地停留在它的内存坐标上,生命周期也并未中断,仅仅是通向它的“门牌号”被暂时挪用给了新来的对象。当内层作用域结束,路由重新恢复,外层对象便再次回到开发者的视野中。这足以证明,名字仅仅是附着在对象表面的临时标签,而非对象本身的固有属性。
对象的地址(Address),则是该对象实体在程序内存空间中的绝对坐标。通过一元操作符 &(取地址符)作用于对象名字(如 &value),可以提取出这个坐标值。地址是客观且明确的,无论对象是否具备名字,只要对象存在于内存中,它就必然拥有一个唯一的地址。对于占用多个字节的对象(如 int 占用 4 字节),地址标识的是该对象生命周期内首个字节的精确位置。名字仅仅是开发者推开对象所在房间的一扇门,而地址则是指向这间房间的绝对经纬度。即使某扇门被封死(名字离开作用域),只要程序在其他地方依然保留着这个经纬度,系统从底层机制上依然具备向那块物理空间发起访问的可能。
进一步剖析,地址作为对象的绝对经纬度,本身只是一串没有任何业务语义的数字坐标。它仅仅回答了“对象存放的起始位置在哪里”,却无法解答“对象占据多大空间”以及“如何解读里面的位模式”。单纯的硬件地址只起到了定位存储区块的作用,这也就是为什么在 C++ 中,如果只有裸地址(如隐式转换为 void*),程序将寸步难行。真正让地址具有操作意义的,是后续在这个坐标之上附加的类型信息系统,定位只是操作的第一步。
二、 指针变量也是对象,它存的是别人的地址
理解指针体系的一个常见障碍,是开发者极易将“指针自身”与“指针所指向的目标内存”混为一谈。在 C++ 的类型系统中,指针变量(Pointer Variable)本身就是一个具备完整对象属性的独立实体。
当声明 int* p = &value; 执行完毕后,内存中实际确立了两个互不隶属的独立对象。一个是占用 4 字节、值为 42 的整型对象 value;另一个是类型为 int* 的指针对象 p。在 64 位架构下,这个指针对象 p 独立占据 8 字节的物理存储空间。它不仅有自己的生命周期,还拥有专属的内存地址,对其施加取地址操作 &p,将合法地得到一个类型为 int**(指向指针的指针)的新数值。在这个 8 字节的空间内,存储的并非整数 42,而是一长串十六进制数值,这串数值精确等于目标对象 value 的地址坐标。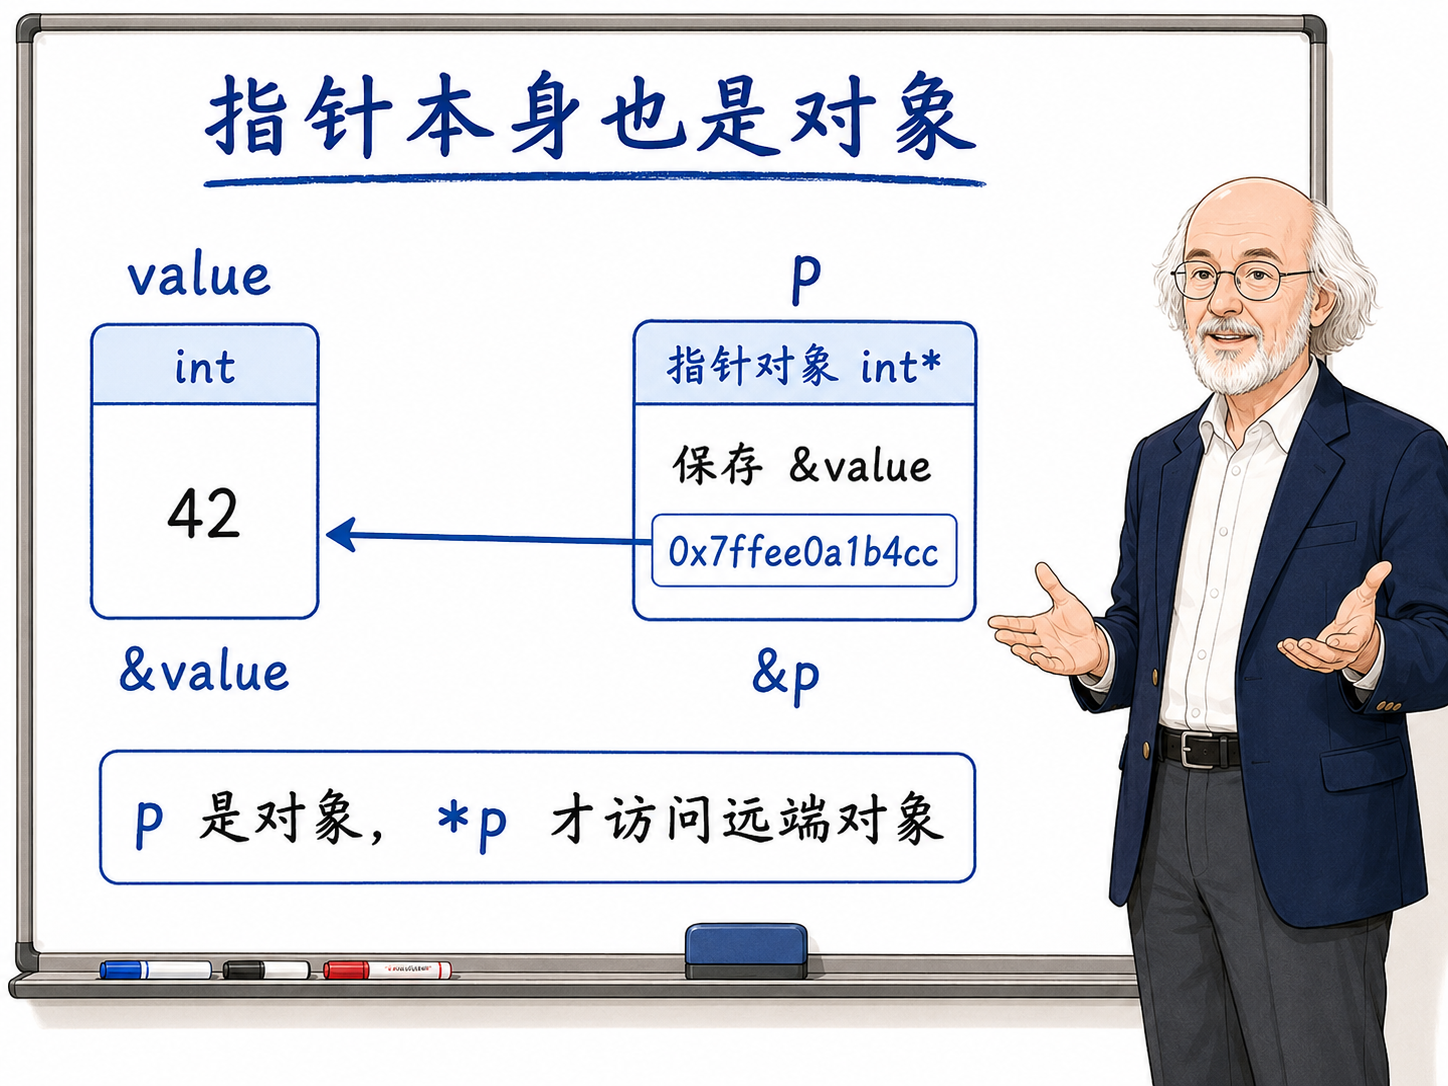
确认指针作为独立对象存在,是理解其所有操作机制的前提。正因为指针是一个实实在在的对象,它承袭了对象的一切核心特质:它具备自身的生命周期,可以在栈上被随时创建和销毁;它支持自由的拷贝构造与赋值语义。最重要的是,指针对象的生命周期与其所记录的目标对象的生命周期不存在任何必然的耦合关系。
int target_a = 42;
int target_b = 99;
int* p = &target_a; // p 存储 target_a 的坐标
p = &target_b;      // p 内部的坐标值被改写为 target_b 的坐标
这段代码展示了指针的重定向(Rebinding)。执行 p = &target_b; 时,target_a 和 target_b 这两个目标对象内部的数据没有发生任何变化。真正发生状态变更的是指针对象 p 自身所在的 8 字节内存区域。它内部的坐标值被擦除,并重新写入了 target_b 的地址。这种能够在运行时自由变更指向状态的灵活性,构成了处理复杂动态数据结构的基础。无论是遍历连续内存块的数组游标,还是编织错综复杂的链表前驱后继网络,指针对象的独立性与可变性都发挥着重要作用。
指针对象与目标对象在物理内存上的绝对分离,是导致复杂系统状态不同步的潜伏点。由于指针本身就是一个独立的实体,它可能安静地栖息在当前调用栈中,而它内部所记录的地址却指向一个遥远堆区的对象。代码更新指针内部的坐标,只会改变指针自己的内容,远端目标并不会随之移动或改写;反过来,如果远端目标先被其他模块销毁,留在当前指针里的旧坐标也不会自动清空。这种空间与生命周期的双重割裂,要求开发者在编写涉及指针的逻辑时,必须同时在脑海中维护两条独立的存活时间线。
指针类型不仅仅决定了指针占用的空间,更决定了解引用(Dereference)时的解释方式。int* 和 double* 在内存中同样占据 8 字节,但当程序执行 *p 时,编译器会根据指针的静态类型,决定是从该地址读取 4 字节当作整数解析,还是读取 8 字节当作浮点数解析。
因此,指针类型不仅仅是简单的语法糖,它是编译器在面对冰冷硬件地址时不可或缺的“翻译手册”。物理地址只告诉运行时系统应当从哪一个字节开始读取,而指针的静态类型则严格规定了读取的步长跨度,以及如何将提取到的比特流还原为有意义的应用程序数据。如果强行用错误的指针类型去解引用一块内存,虽然坐标精准无误,但由于翻译规则错位,最终提取出的数据可能与原本的业务逻辑南辕北辙。
指针作为独立实体的特性,在 const 修饰符的应用中体现得非常直接。const int*(底层 const,指向 const 对象的指针)限制了通过该指针修改远端目标数据的权限,但指针自身依然可以重新指向其他地址。而 int* const(顶层 const,const 指针)则锁死了指针对象自身存储的坐标值,使其无法再指向其他地址,但如果目标对象不是 const,依然可以通过解引用修改目标数据。这种修饰符作用域的严格区分,正是因为指针和其指向的目标分属两块独立的物理内存。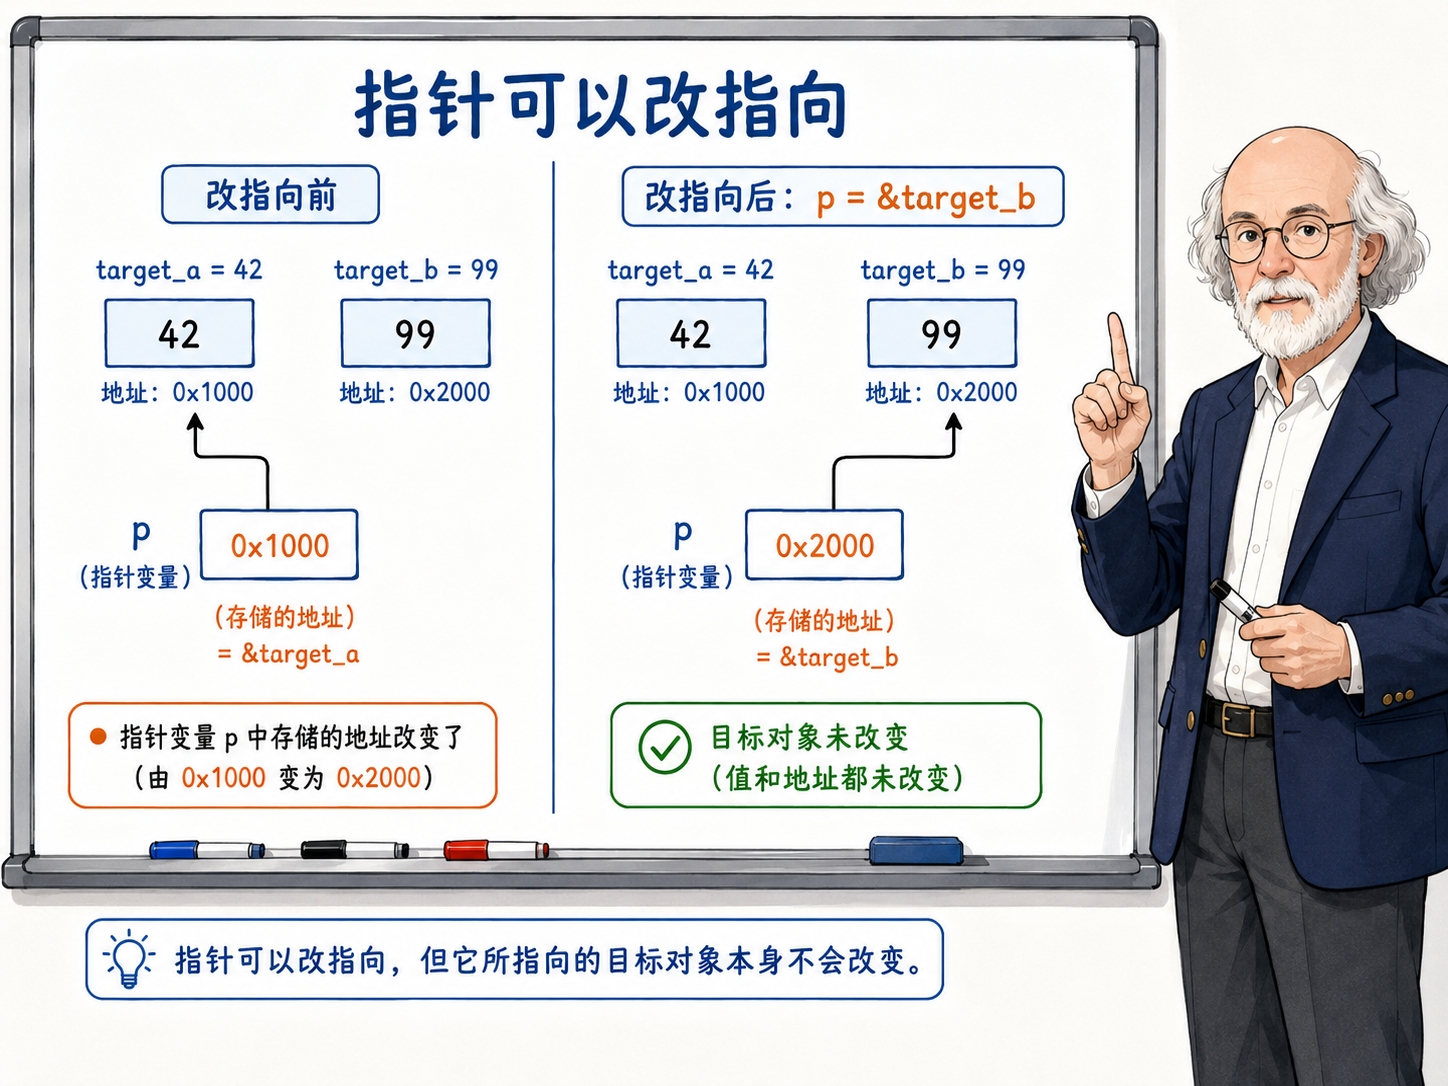
这种灵活性要求开发者在代码的每一处读写点明确当前的意图:当前的赋值操作,究竟是在改写指针对象自身的坐标值,还是在通过解引用(即 *p)去改写远端目标对象内部的数据?在多级指针或结构体嵌套的场景中,混淆这两个操作层级是诱发内存逻辑错误的常见原因。每次书写解引用操作,都意味着程序将跨越当前的地址坐标,去探访并操作远端的那块内存实体。
为了在错综复杂的代码网络中保持头脑清醒,严谨的 C++ 开发者会时刻区分针对指针的三级操作视角:p = &x 是对指针变量自身的就地改写,更新的是它的内部导航仪;*p = 10 则是一次跨越空间的远程投射,顺着导航仪上的坐标去修改远端的实体;而 &p 是退后一步,对指针对象本身再次进行取址操作,从而生成一个指向指针的二级凭证。特别是在需要通过函数调用去改变外部指针自身指向的场景下,初学者常犯的错误是将 p 的值传进去,而正确的做法必须是交出 &p,因为只有交出指针容器本身的地址,接收方才能精准地修改这个容器内部存放的坐标。
三、 引用是对象的绑定别名,不是可重新指向的把手
如果将指针看作存放目标地址的独立变量,那么引用(Reference)机制更像是直接贴在目标对象上的另一块识别标签。早期 C 语言中由于没有引用,实现运算符重载会迫使代码布满繁琐的取地址和解引用符号。C++ 引入引用,很大程度上是为了提供一种无需显式间接访问就能借用对象的语法机制。
书写 int& r = value; 时,C++ 编译器并未在语义层面开辟类似于指针那样的 8 字节独立存储区域。语言标准中有着明确的界定:引用本身不是对象(A reference is not an object)。引用仅仅是为某个既有实体对象建立的别名(Alias)。一旦引用变量在声明初始化阶段完成了与目标对象的绑定(Binding),它在语义上就彻底依附于目标对象。在底层机器码实现中,编译器通常还是会分配空间利用指针机制来传递引用,但在 C++ 语法和类型系统的表层,这种间接性被完全隐藏,引用对外表现为目标对象本身的完全替代标识。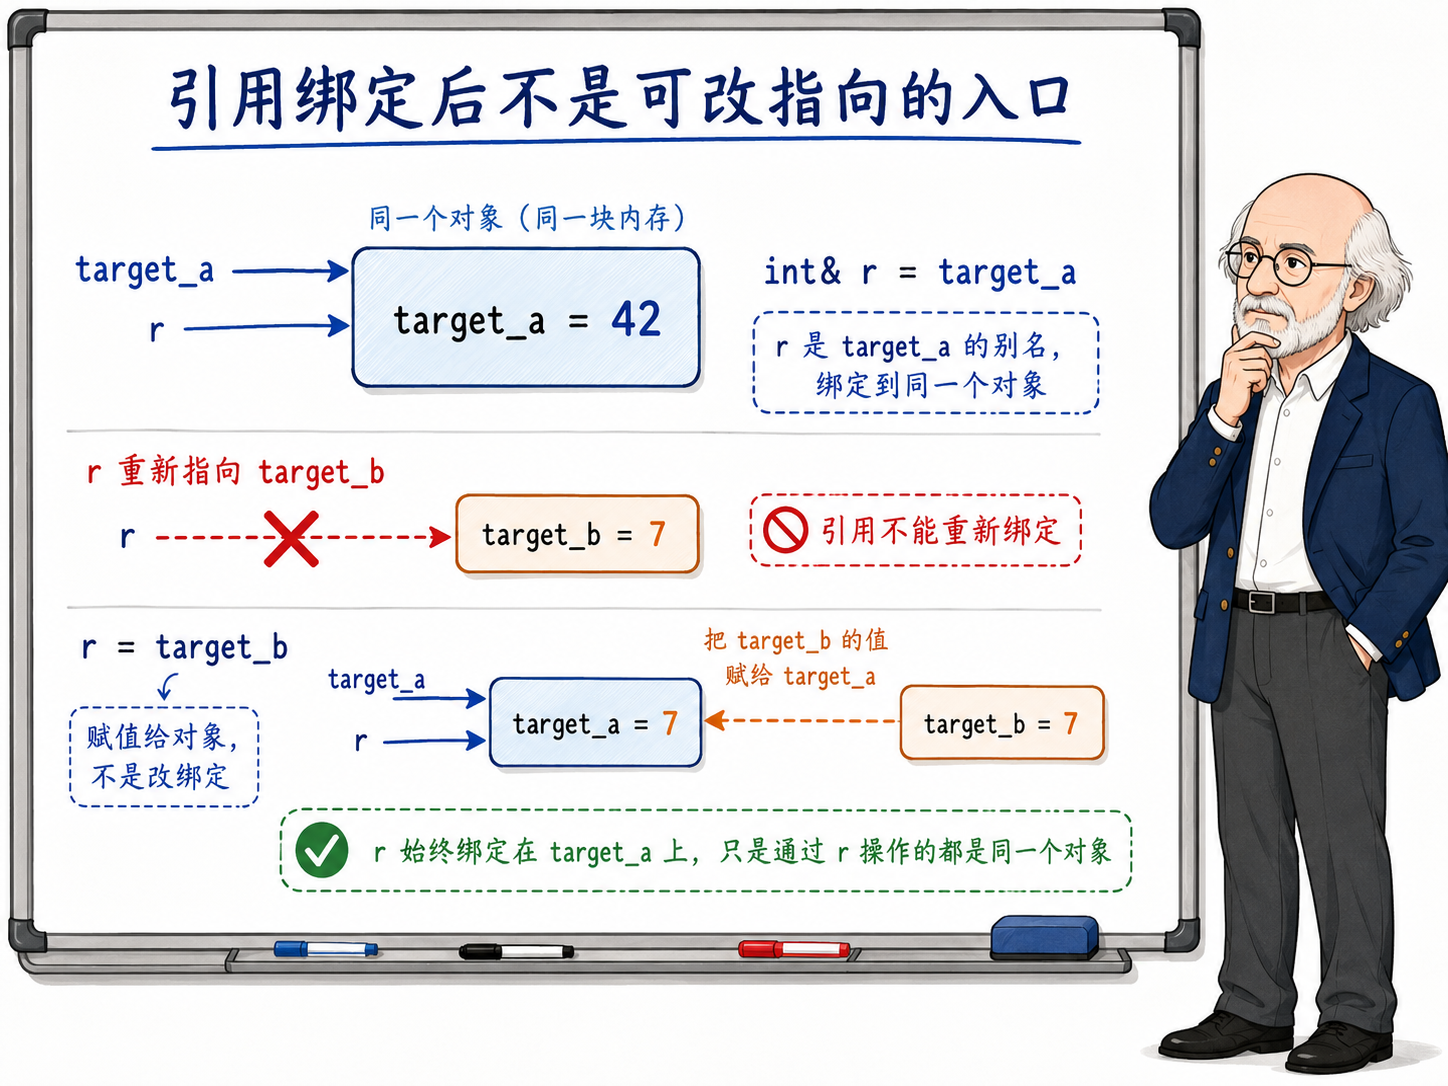
这种绑定关系的牢固程度超越了指针的任何修饰符。在 C++ 中,不存在“引用的重新指向”这一概念。
int target_a = 42;
int target_b = 99;
int& r = target_a; // r 终生绑定 target_a
r = target_b;      // 这不是重新绑定,而是数据覆盖
对于习惯了部分动态类型语言的开发者而言,r = target_b; 是一处容易踩坑的地方。这行代码的执行动作,并非将 r 的绑定目标从 target_a 切换至 target_b,而是提取 target_b 的数据值(99),直接覆盖进 target_a 的物理内存中。因为在绑定之后,r 与 target_a 是绝对等效的,对 r 施加的任何赋值、自增或函数调用,最终都毫无保留地作用于 target_a 的内存区块。
正因为引用缺乏独立的实体资格,C++ 语法禁止了“引用数组”、“指向引用的指针”以及“引用的引用”这类构造。一个不存在独立物理地址的逻辑别名,无法作为元素存入数组,因为数组要求元素具有确定且相同的大小,并通过固定的步长进行内存偏移计算。对引用进行取地址操作(&r),获取到的永远是其绑定的目标对象(target_a)的物理地址,试图对引用本身取地址是徒劳的。
在工程实践中,引用的借用语义被细分为非 const 引用(T&)与 const 引用(const T&)。非 const 引用传递的是一种明确的修改意图:调用方主动将目标对象的修改权限下放给接收方。如果函数接口声明为 void process(std::string& s),这不仅意味着函数需要读取 s,更表明函数体内部将会且被允许对 s 的状态进行更改,并且这种更改应当被外层调用方感知。
const 引用(const T&)则建立了一种安全的只读契约。它不仅保证了远端对象的不可变性,更具备一项重要的类型特性:const 引用能够合法地绑定到纯粹的右值(Rvalue,如无名字面量或函数的临时返回结果)上,并能将该临时对象的生命周期延长,直到引用自身的生命周期结束。
void analyze(const std::string& data);
analyze("literal_string_converted_to_temporary_std_string");
在这个调用中,编译器隐式构造了一个匿名的 std::string 临时对象,并直接将其绑定至 data 这个 const 引用上。这种机制免除了大型对象在传参过程中的深拷贝开销,同时在编译期提供了稳固的只读防护。相较于传递指针,这种既高效又安全的借用模式,构成了 C++ 接口设计的核心基石。
四、 指针允许为空,引用默认必须绑定对象
指针对象独立存在的另一项决定性特质,在于它的数值可以合法地处于空状态。空状态并非代表指向物理内存的零号地址,而是由 C++ 语言设计的一个逻辑标识,用以宣告该指针目前脱靶,不指向任何有效实体。
在现代 C++ 标准下,这种空状态由具有独立类型的字面量 nullptr 唯一且严谨地表达。它彻底取代了历史代码中存在类型歧义的整型宏 NULL 或字面量 0,使得编译器在处理函数重载时能准确区分指针和整数类型。
Configuration* config_ptr = nullptr;
// 业务逻辑推进...
if (config_ptr != nullptr) {
    config_ptr->apply_settings();
}
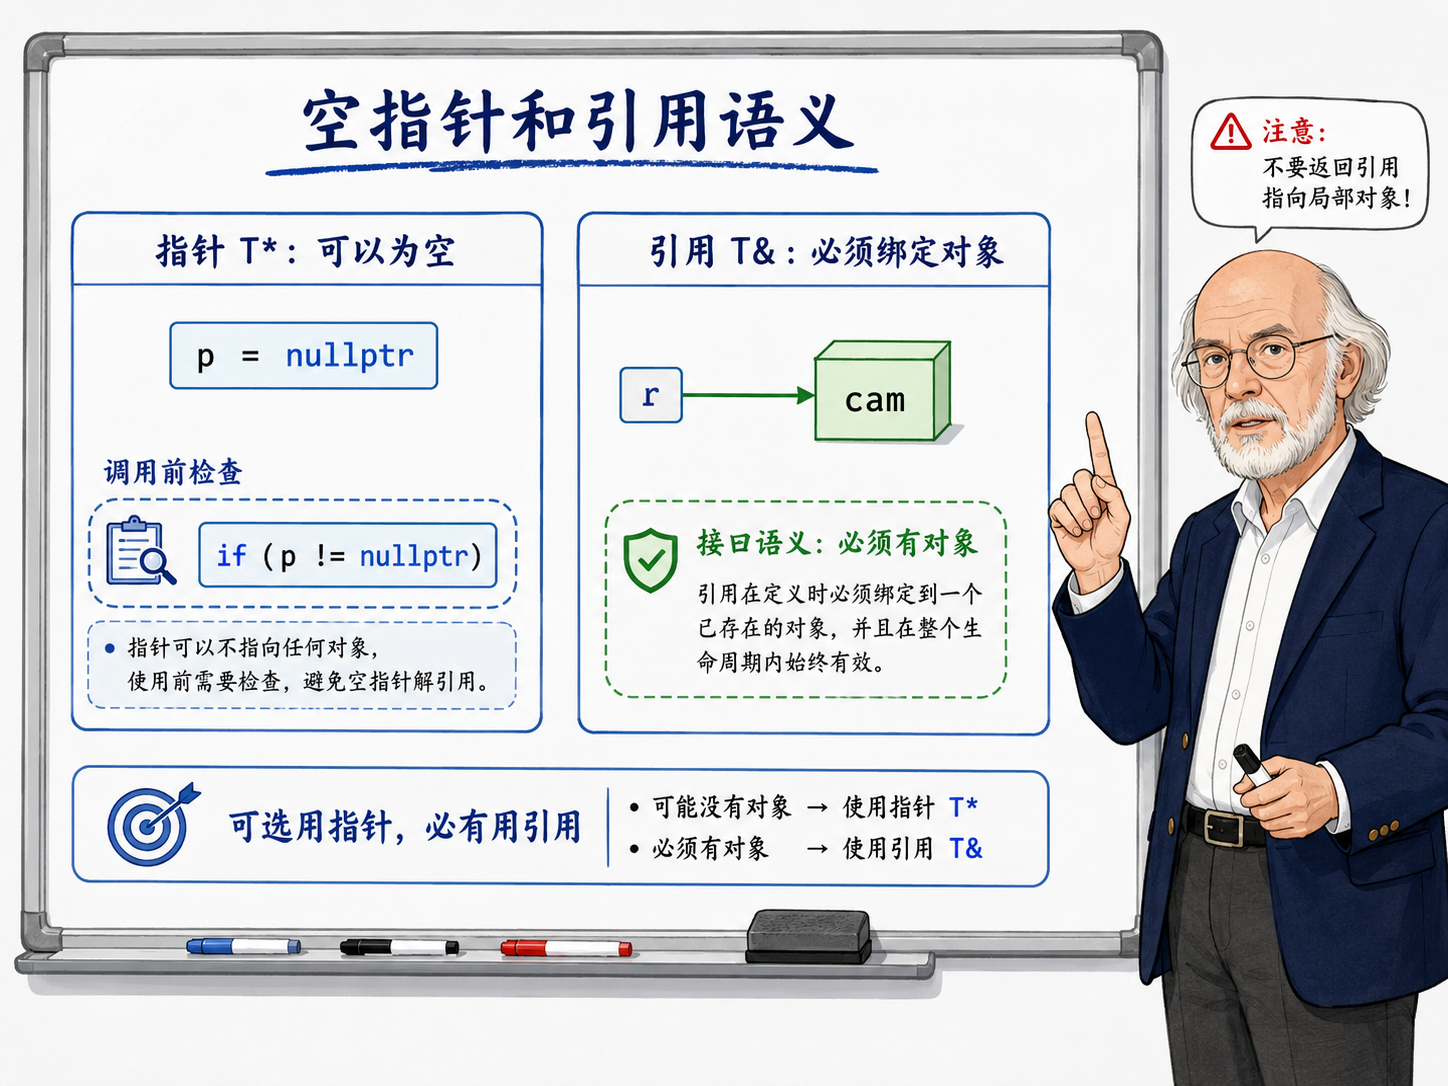
允许为空的特性,使得指针在接口设计中能够表达“可选性”(Optionality)。当指针作为函数参数出现时,它通常表达一种“可空借用”(Nullable Borrow)。调用方可以出借对象的访问权,但如果当前确实没有合适的实体,完全可以安全地传入 nullptr。函数内部通过显式的条件判定,能够分流执行不同的备用逻辑。
然而,C++遵循零成本抽象(Zero-cost Abstraction)的哲学,语言层面不会在每次解引用时自动植入性能损耗极大的空指针检查。因此,允许为空意味着每次解引用前都需要开发者自行验证指针的有效性。如果逻辑疏漏,直接对一个 nullptr 强行解引用,在 C++ 规则体系中属于未定义行为(Undefined Behavior, UB)。编译器在进行激进的控制流图优化时,如果在某条执行路径上推断出解引用动作,它会反向假定该指针在此前绝对不可能为空,从而可能毫无警告地移除掉上方那些看似多余的判空检查代码。这种由 UB 引发的逻辑错乱,往往比显式的段错误更加诡异,极大地提升了排查难度。
对比之下,引用的优势在防御性编程中显现出来。由于 C++ 语法的约束,引用在声明的瞬间必须绑定到一个已存在的合法对象上,语言层面上不存在“空引用”的合法表达。因此,当函数接口声明接收一个引用时,它在语义上明确表达了“必须提供对象”。这种设计直接在模块的接口层面建立了防御工事:调用方只能传递确切存活的实体对象。在函数内部,开发者摆脱了有效性校验的负担,无需编写多余的防守代码。将“可能为空”的边缘状态拦截在接口外部,是降低工程复杂度的有效手段。
五、 悬空:生命周期结束后的地址残留
明确区分了“物理地址数值”与“存储于该坐标的实体对象”后,就能理解 C++ 内存模型中最隐蔽的缺陷来源:悬空访问(Dangling Access)。
对象的地址仅仅是一个固定的坐标。而对象实体,则遵循严格的生命周期法则(如栈空间的分配与回收、动态内存的分配与释放)在特定的时间窗口内存活。当一个局部对象离开其作用域被析构,或者一块动态内存被 delete 回收时,该对象的生命周期随之结束。底层的分配器会将这块地址标记为空闲,并随时准备将其划拨给后续的新对象。
底层机制的危险在于:原对象生命周期终结时,那些曾经保存过该地址的指针变量与引用,并不会自动清零或产生任何失效警告。它们内部存储的数值依然保留着那个已被系统回收的旧地址。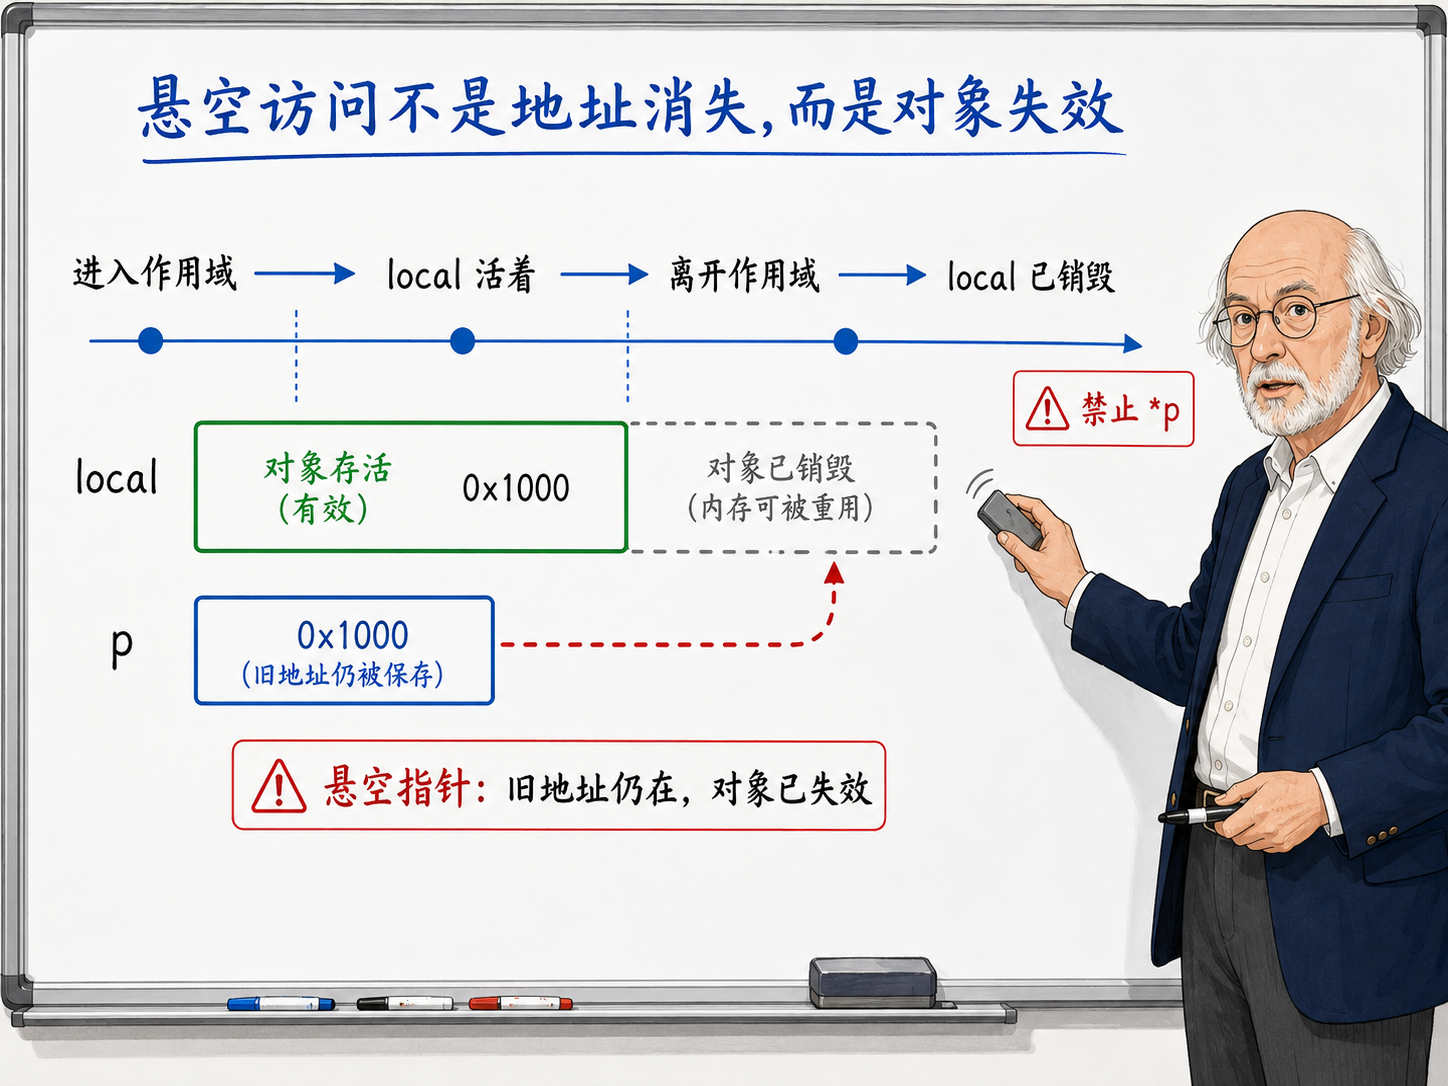
// 致命反例:返回局部作用域内对象的地址
int* trigger_doom() {
    int local_ammunition = 100;
    return &local_ammunition; // 危险:local_ammunition 在函数结束时生命周期终结
}
当函数 trigger_doom 执行完毕退出时,其所在栈帧被弹空,local_ammunition 所在的内存被正式视为无效数据。但函数却将那块废弃内存的坐标通过返回值交给了调用者。这个残留的坐标,就是悬空指针(Dangling Pointer)。如果返回的是引用,便产生了悬空引用(Dangling Reference)。
悬空指针和悬空引用的本质完全一致:访问路径(坐标或别名)的存活时间,超越了目标对象的实际生命周期。程序依然持有一把合法的旧钥匙,但门后的系统结构已经被彻底重组。
悬空的隐蔽性在于它是一种潜在的状态错位。栈帧回退或内存释放时,出于性能考量,系统往往不会立刻清零这块内存。如果系统还没来得及用新数据覆盖那块区域,通过悬空指针读取甚至可能获得看似完全正确的“旧数据”。这种伪装的成功会在测试阶段掩盖问题的严重性,让开发者误以为代码逻辑正确。
在复杂的实际运行环境中,这块空闲内存很快会被重用,分配给新的对象(可能是一个 std::string 对象、一个控制多线程同步的 mutex,或者是包含敏感信息的用户数据结构)。此时如果执行悬空指针的覆写操作,会导致毫无征兆的数据污染和状态机错乱,甚至在距离原始错误代码十万八千里的另一条线程中引发崩溃。这种空间复用带来的内存踩踏(Use-After-Free),其排查成本极高。
悬空现象揭示了一个铁律:地址永不消失,消失的只有对象的合法存活期。一切访问途径(指针或引用),其持有的寿命跨度,绝不允许超越目标对象的生命周期。确保访问路径始终落在合法的生命周期时间窗口内,是构建安全 C++ 程序的底线。
六、 借用与拥有:所有权的根本区别
名字、指针与引用,在机制层面仅仅提供了触达物理内存的通道。但在规模庞大的系统工程中,“具备访问目标的能力”与“承担目标生命周期的管理”,是两项截然不同的职责。这就引出了现代系统编程中最关键的议题——所有权(Ownership)。
对于分配在栈上的局部对象或是存放在静态数据区的全局对象,其生命周期的起落由编译器根据确定的词法作用域与装载机制自动处理。当开发者通过非 const 引用、const 引用或裸指针去访问这些对象时,建立的纯粹是一种“借用”(Borrowing)或“观察”(Observing)的关系。我们仅仅是凭借通道临时索取数据或执行更改,既不负责,也没有能力去干预这些对象的最终销毁。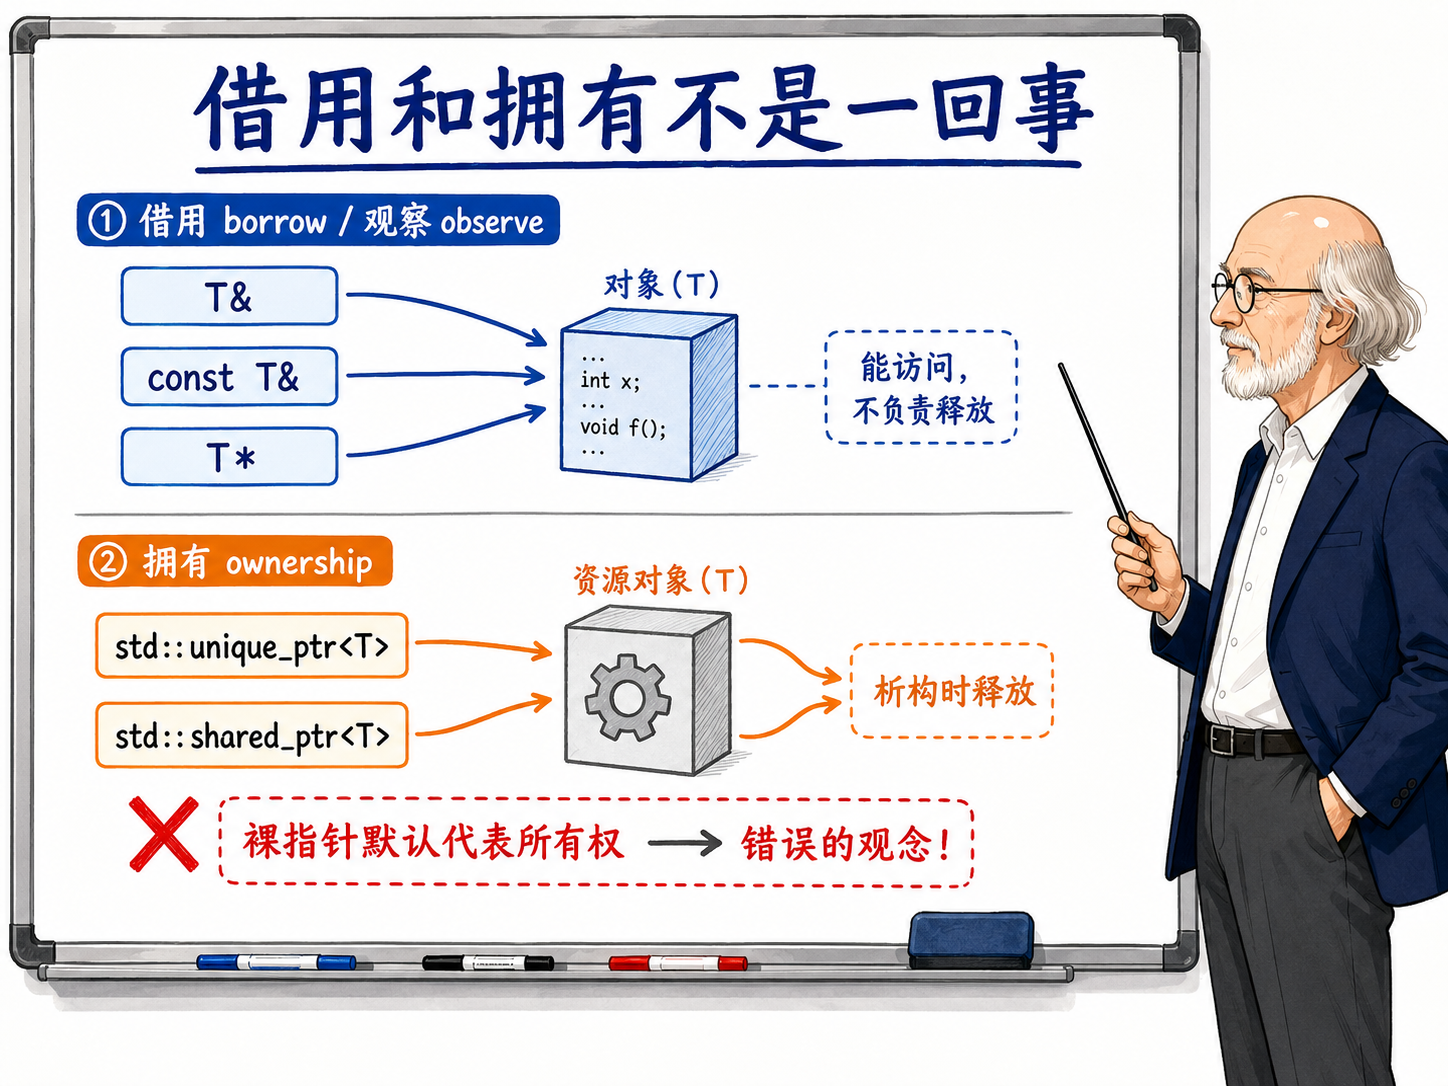
然而,当对象需要跨越函数调用的界限长久存活,或是对象占据的内存规模在编译期无法被预测时,动态内存分配(Dynamic Allocation)便成为必经之路。此时,编译器交出了生命周期的自动管理权,代码逻辑必须亲自接管,在堆区申请内存,并在未来的适当时机负责将其归还。这就是所有权的实质体现。掌握了所有权,就意味着必须承担清理资源的强制责任,这不仅包括回收内存,还涵盖关闭文件句柄、释放网络连接等各种系统资源的善后工作。
在早期的 C++ 接口设计中,由于语言抽象工具的局限,裸指针被迫承担了双重角色。它有时表示轻量级的观察者,仅仅“借用数据”;有时又表示所有权的移交,暗示接收方需要在任务结束时负责调用 delete 将其释放。
// 早期 C++ 接口风格,存在极大的所有权歧义
Entity* fetch_entity();         // 调用者拿到的指针,是否意味着接管了所有权?需要释放吗?
void consume_entity(Entity* e); // 调用方在调用此函数后,对象是否已经被内部销毁?
由于语言类型系统未能在语法层面对这两种语义进行严格区分,面对返回裸指针的接口,开发者往往需要查阅历史文档、挖掘源码或依赖脆弱的团队口头约定来判断所有权归属。裸指针作为参数或返回值时,无法自动表明它是一个只读视图还是一个需要释放的管理权凭证。这种依赖文档约定的做法,在漫长的工程迭代中极易因为人员更迭或疏漏而失效。遗漏 delete 会导致系统资源的无尽泄漏(Memory Leak),而重复 delete 则会对同一块内存释放两次(Double Free),直接引发进程崩溃。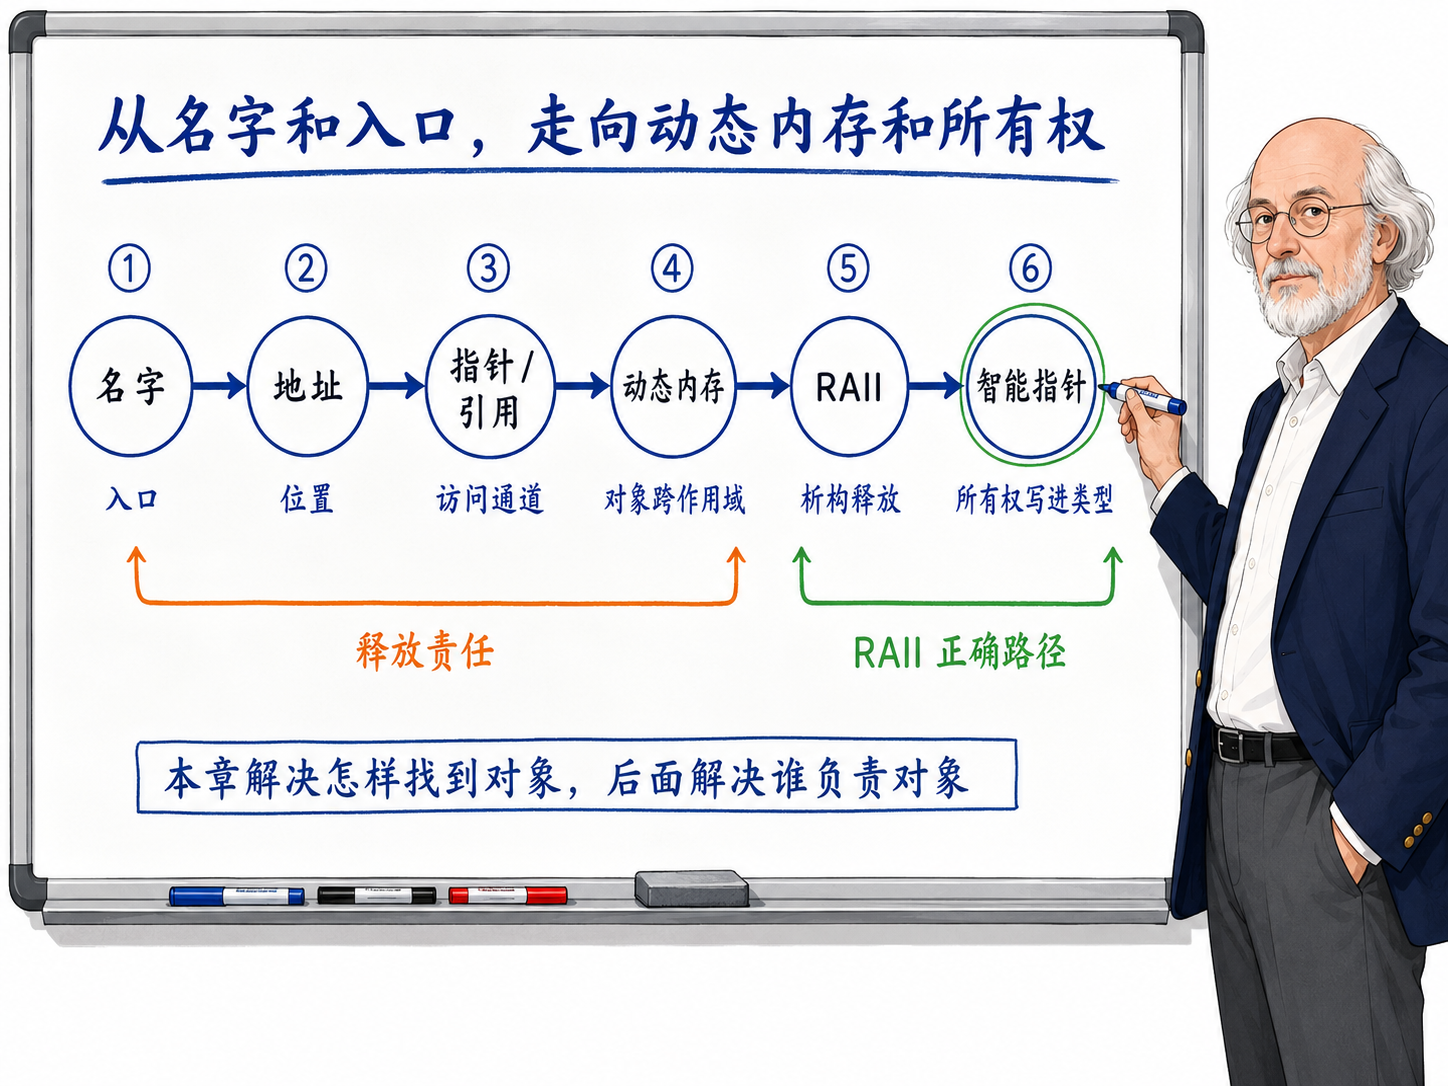
为此,现代 C++ 致力于将所有权语义编码到类型系统中,让接口签名自身成为无需注释即可理解的契约文档。当函数接收裸指针(T*)或引用(T&/const T&)时,它明确传达了“借用”意图:函数仅在调用期间临时访问对象,绝不染指其生命周期管理。而当接口的返回值或参数是 std::unique_ptr<T> 时,则是在宣告一次彻底的“所有权转移”:资源的控制权被唯一地、不可撤销地从调用方移交给接收方。如果采用 std::shared_ptr<T>,则表示资源进入“共享所有权”模式,其生命周期由所有共享者共同决定,直到最后一个共享者放弃所有权时才被释放。这种基于类型的显式所有权表达,将资源管理的责任从依赖开发者记忆的脆弱约定,转移到由编译器强制保障的强类型规则上,极大地降低了大型项目中因所有权模糊而导致的内存安全风险。
现代 C++ 资源管理模型的进步,在于通过强大的类型系统将这两种语义彻底剥离。裸指针和引用被重新定位并严格限制在安全的借用与观察场景,默认不再表达对动态内存的所有权掌控。
在代码评审中,判断一个接口是否健康,可以先看它有没有把这层语义写进类型:引用通常表示调用期间必有对象,裸指针通常表示可选或非拥有访问,std::unique_ptr 表示独占所有权转移,std::shared_ptr 表示共享生命周期管理。类型越能直接说明资源责任,调用方越少依赖注释、经验和口头约定。
而那些涉及资源创建、所有权转移与共享的沉重职责,被交托给由 RAII(资源获取即初始化)原则支撑的自动化机制。RAII 将资源的管理周期与对象的生命周期深度绑定。现代 C++开发中广泛使用的 std::unique_ptr 和 std::shared_ptr 等智能指针,在底层依然依赖地址和指针运作,但通过类型系统显式地宣告了“独占所有权”或“共享所有权”。它们利用局部对象离开作用域必然触发析构函数的机制,哪怕在异常抛出的路径上,也能安全地自动执行清理逻辑,彻底替代了裸指针在资源管理上的职责。理解了名字、地址与访问权限之间的差异,才能明白将资源管理强制约束到类型系统和生命周期内,是驾驭现代 C++ 复杂工程的必然选择。
阅读导航



