
MySQL 入门与常用 SQL 校招面试题
MySQL 入门与常用 SQL 校招面试题
先理解数据库解决的实际问题,再学习 SQL 如何表达查询。不要把 SQL 写法、逻辑含义和数据库真实执行步骤混在一起。
本文面向初学者和校招面试准备者,以 MySQL 8.4、InnoDB 为主要口径。先看具体数据怎样变化,再理解背后的职责和规则。下文 SQL 及结果是按给定数据核对的教学推演,未在数据库中实测;配图已按提示词生成,并附有原始提示词链接。
本文示例数据
本篇使用三张表:users 保存用户,orders 保存订单,products 保存商品。users.id、orders.id、products.id 分别标识各表记录;orders.user_id 表示订单属于哪个用户。本例没有声明外键,关联查询由 SQL 条件表达,不能仅凭列名认为数据库已检查引用完整性。
| users.id | name |
|---|---|
| 1 | Alice |
| 2 | Bob |
| 3 | Carol |
| orders.id | user_id | status | amount | created_at |
|---|---|---|---|---|
| 101 | 1 | paid | 100.00 | 2026-01-01 10:00:00 |
| 102 | 1 | pending | 200.00 | 2026-01-02 10:00:00 |
| 103 | 1 | paid | 50.00 | 2026-01-03 10:00:00 |
| 104 | 2 | paid | 80.00 | 2026-01-03 10:00:00 |
products 只有商品 1:Book,price 为 19.90,初始 stock 为 10。paid 表示已支付,pending 表示待支付;这里只用两个状态解释查询,不代表完整订单状态机。
下面的初始化 SQL 只供新建、独立的练习环境使用,不要在业务库中执行。
数据库名若已存在,应换一个未使用的练习库名;CREATE DATABASE 失败时停止,不要继续 USE 或插入。脚本不删除已有库表,也不通过 IF NOT EXISTS 掩盖旧数据。
大家可以使用在线 sql 语句工具练习
CREATE DATABASE mysql_chapter1_demo
  CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;
USE mysql_chapter1_demo;

CREATE TABLE users (
  id BIGINT NOT NULL PRIMARY KEY,
  name VARCHAR(80) NOT NULL,
  KEY idx_users_name (name)
) ENGINE=InnoDB;

CREATE TABLE orders (
  id BIGINT NOT NULL PRIMARY KEY,
  user_id BIGINT NOT NULL,
  status VARCHAR(20) NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  created_at DATETIME NOT NULL,
  KEY idx_orders_user_status (user_id, status),
  KEY idx_orders_created_id (created_at, id)
) ENGINE=InnoDB;

CREATE TABLE products (
  id BIGINT NOT NULL PRIMARY KEY,
  name VARCHAR(80) NOT NULL,
  price DECIMAL(10,2) NOT NULL,
  stock INT NOT NULL DEFAULT 0
) ENGINE=InnoDB;

INSERT INTO users (id, name)
VALUES (1, 'Alice'), (2, 'Bob'), (3, 'Carol');

INSERT INTO orders (id, user_id, status, amount, created_at)
VALUES
  (101, 1, 'paid', 100.00, '2026-01-01 10:00:00'),
  (102, 1, 'pending', 200.00, '2026-01-02 10:00:00'),
  (103, 1, 'paid', 50.00, '2026-01-03 10:00:00'),
  (104, 2, 'paid', 80.00, '2026-01-03 10:00:00');

INSERT INTO products (id, name, price, stock)
VALUES (1, 'Book', 19.90, 10);
字段类型和索引是本篇示例的起点,不是生产订单表的完整设计。金额使用 DECIMAL,时间使用 DATETIME,避免把本篇查询过程与浮点误差、会话时区转换混在一起。示例数据很小,即使存在索引,优化器也可能选择扫描,不能从预期结果推断实际执行计划。
第 3 题的各个更新场景分别从库存 10 开始;不要先提交扣减再直接套用另一个场景的预期值。所有练习会话结束事务后,可在此独立练习库中将商品 1 的库存重新设为 10:
START TRANSACTION;
UPDATE products SET stock = 10 WHERE id = 1;
COMMIT;
第 4、5 题分别创建 demo_products、demo_delete,不会改变以上三张表;重复练习需另用空的练习库,不能把重复建表错误当作初始化成功。其余查询结果均以订单初始数据未改变为前提。
1. 什么是 MySQL?为什么需要关系型数据库?
相关问法:什么是关系型数据库?MySQL 与其他数据库有什么不同?|示例依赖:users、orders。
一句话理解与用途
MySQL 是关系型数据库管理系统:它把业务数据组织成表,并提供查询、修改、约束、并发控制和故障恢复能力。数据库是被管理的数据集合;MySQL 是管理这些数据的软件;SQL 是与它交互的语言。
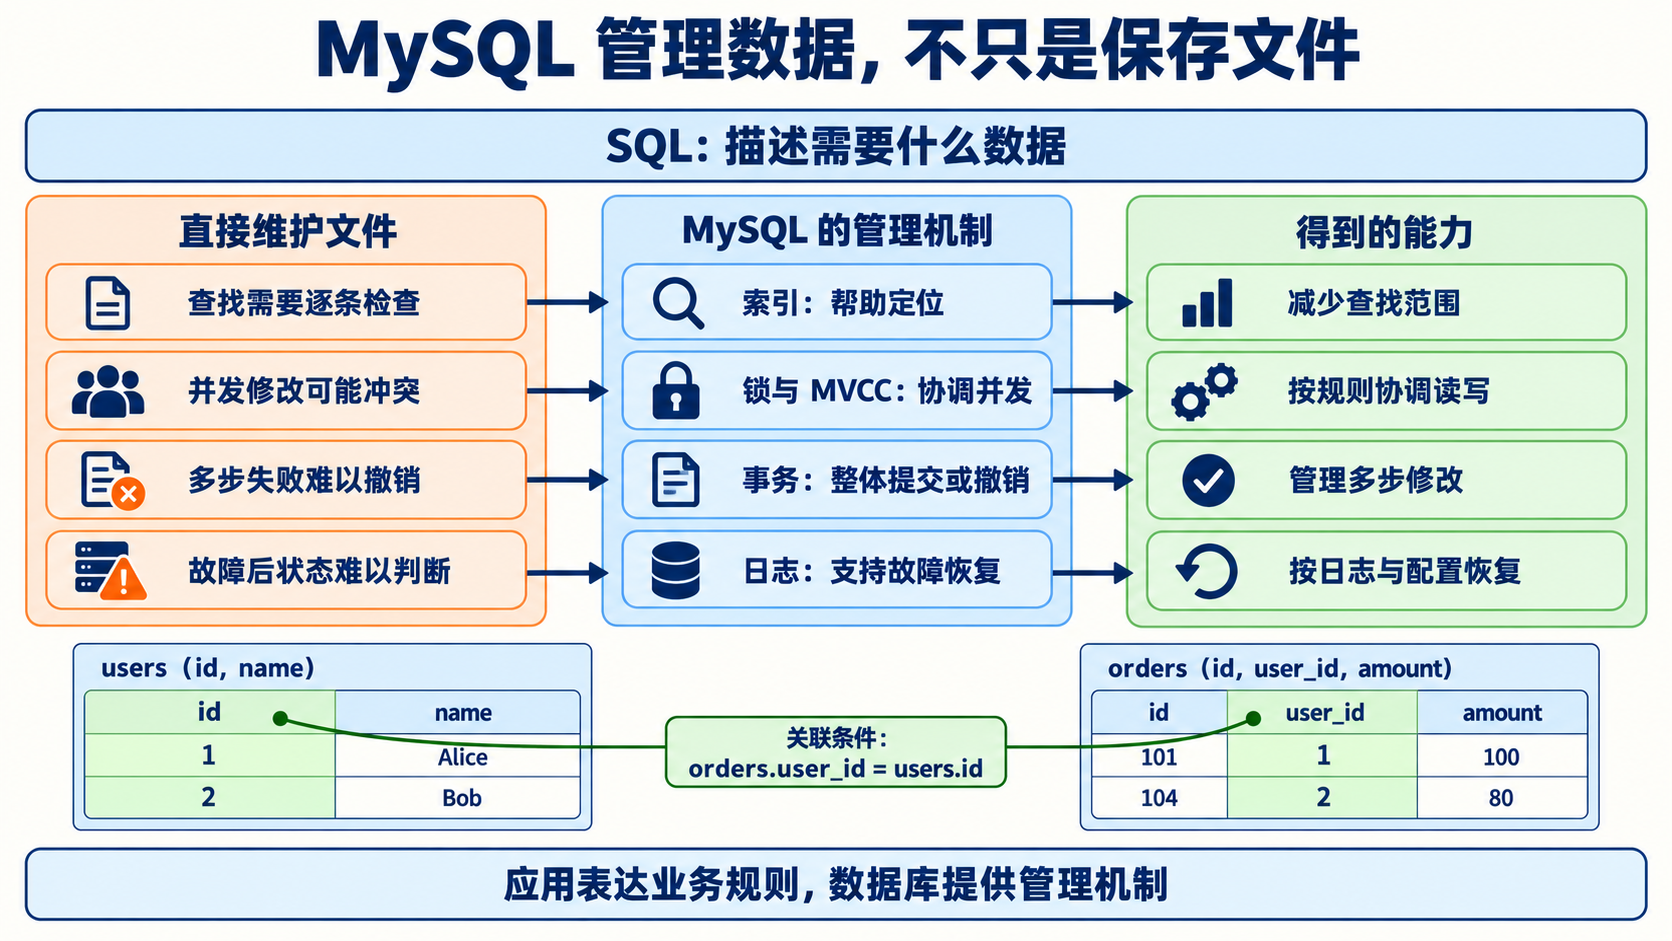
假设你把所有订单写进一个文本文件。起初只有十条记录,用程序逐行读取就能找出某个用户的订单。数据增长后,你会遇到四个问题:查一次要读很久;两个程序同时改文件可能覆盖彼此结果;扣款成功而创建订单失败不知道如何撤销;程序突然掉电,不清楚哪些修改真正保存了。数据库把这些普遍需求做成了可重复使用的基础能力。
从表开始理解
表可以先看成带有规则的二维数据集合。列规定一类属性,例如订单编号、用户编号和金额;行表示一个具体对象或事实。数据类型规定一列能保存什么值,约束规定哪些数据不允许进入表。主键用于标识记录,表之间通过共同字段建立联系。
“关系型”中的关系来自关系模型,不是说每张表都必须有外键。我们可以将用户姓名只存于 users,把订单所属用户的编号存于 orders,再在查询时关联,避免每笔订单重复维护用户资料。
具体看 Alice:users 中只需保存一行 1、Alice,她的三笔订单则分别保存 user_id = 1。以后修改姓名,只修改用户资料即可;如果把姓名复制到每笔订单,更新时就可能漏改其中一行。关联字段让我们既能分开维护对象,又能在需要时组合查询。需要保留下单时的姓名快照则是另一种明确的业务需求,不能把所有冗余都认定为错误。
SELECT id, amount
FROM orders
WHERE user_id = 1
ORDER BY id;
统一数据中,这条语句返回订单 101、102、103,金额分别为 100、200、50。应用描述“要用户 1 的订单”,MySQL 负责选择和执行查找方法。SQL 的这种特征叫声明式:主要说明目标,而不是手工编写每一次磁盘访问。
这段 SQL 可以逐句理解:FROM 指定输入表,WHERE 选择属于用户 1 的记录,SELECT 决定输出订单编号和金额,ORDER BY 明确结果顺序。id 区分不同订单,user_id 表示共同的所属用户,所以同一个 user_id 出现三次是合法的一对多关系,而不是主键重复。
数据库提供了什么
索引帮助减少查找范围;事务把多步更新组成可提交或撤销的整体;锁和多版本机制协调并发;日志支持异常恢复;权限限制谁能查看或修改数据。它们不是互不相关的功能,而是共同维护一个能被许多应用安全使用的数据系统。
关系型设计还要求应用正确表达业务规则。例如金额不为负可以用约束保护,但“退款是否经过审核”需要应用流程参与,数据库不会自动理解业务。
如果只用文件,程序也能自行实现查找结构、互斥和恢复记录,但必须把这些机制一起做对。数据库的价值不只是“存到硬盘”,而是把查询与可靠修改组织成统一接口。例如库存扣减和订单创建要么都成功、要么一起撤销,就需要事务;两个请求同时买最后一件商品,则还需要正确的并发更新方式。数据类型或一个主键不能独自解决这些问题。
适用边界
MySQL 常用于需要结构化查询、关联和事务的业务。PostgreSQL、Oracle 等也提供这些基础能力,选择应比较所需功能、运维经验、兼容性、许可和生态,不能无条件断言哪一个最快。InnoDB 则是 MySQL 中负责数据存取等工作的存储引擎,不是与 MySQL 平级的产品概念。
面试回答
MySQL 是关系型数据库管理系统,用表、行和列管理数据,SQL 则是表达查询和修改需求的语言。例如用户资料与订单分开保存,通过用户编号关联,避免每笔订单重复维护同一份资料。相比自行维护文件,MySQL 提供索引、事务、并发控制、权限和日志恢复等基础能力,但应用仍要正确表达业务规则。MySQL 是管理软件,InnoDB 是存储引擎,不能把二者或其他数据库产品放在同一层级比较。
2. MySQL 的内部架构是什么?
相关问法:Server 层与存储引擎层如何分工?
一句话理解与用途
MySQL 大体分为 Server 层和存储引擎层:前者理解 SQL、选择方案并组织执行,后者按约定接口保存和访问数据。这种分层让 SQL 的通用处理与底层存储机制可以分别演进。
可以把查询理解为一次有分工的工作,但不要只记“上层指挥、下层干活”。关键是知道每个阶段拿到什么、交出什么。
一条 SQL 怎样被分工处理
- 连接管理接受 TCP 或 Unix Socket 连接,认证账号并维护字符集、事务状态等会话信息。身份认证回答“你是谁”,对象权限检查回答“能操作什么”。
- 解析及名称解析将 SQL 文本转成内部结构,检查语法,解析表名、列名和表达式。如果列不存在,不能等到磁盘读取阶段才发现。
- 优化器选择执行计划。执行计划是实现同一查询的具体步骤,例如先扫描哪张表、使用哪个索引、如何连接和排序。
- 执行器按照计划向存储引擎取记录,并完成相应过滤、计算、聚合或结果输出。它不是把整张表一次性搬来后才开始工作。
- 存储引擎实现记录和索引的访问。以 InnoDB 为例,它管理数据页、Buffer Pool、事务锁和用于恢复的日志。
SELECT name FROM users WHERE id = 1;
这条查询经过解析后,优化器通常可以选择主键定位;执行器调用 InnoDB 的访问接口;InnoDB 在聚簇索引中寻找记录。需要的页在 Buffer Pool 中就直接使用,不在时才加载。统一数据中的结果为 Alice。
把各阶段的产物连起来看
解析阶段拿到的是 SQL 文本,需要确认 users 和 id、name 的含义,而不是此时就已经读到了 Alice。优化阶段拿到的是可以执行的查询表达,比较主键定位等候选方案后交出计划。执行阶段拿到计划,才真正向引擎请求记录,再把 name 组成输出。即使某次实现把部分工作交错进行,也不能把三者的职责混为一谈。
这里的“页”是一块可以容纳多条记录的存储管理单位。Buffer Pool 缓存的是这些页:两条不同 SQL 访问同一页,也可能复用缓存;它并不保存“这段 SQL 对应 Alice”这样的整条查询答案。页命中后仍然要定位记录、判断可见性并处理结果,不是跳过所有执行工作。
常见模块分别属于哪一层
Server 层还负责视图、内置表达式、权限、Binlog 和引擎事务协调等通用能力。InnoDB 的 Buffer Pool 缓存页;Redo 支持页面修改的崩溃恢复;Undo 用于撤销和历史版本;锁与 MVCC 共同支撑并发事务。此处先理解职责,后续各题再逐一展开。
MySQL 允许表采用不同引擎,因此不能把 InnoDB 的所有特性说成任意 MySQL 表都具备。MyISAM 表就不能因为运行在 MySQL 中而自动获得 InnoDB 事务能力。
再看优化器的意义:查一名用户可以主键定位,查几乎全体用户却可能直接扫描更划算。两种计划都能得到正确结果,但访问工作量不同。执行器负责把选定方案落实,不能把“选择方案”和“实际取行”当成同一个阶段。
配图:一条 SQL 经过哪些层
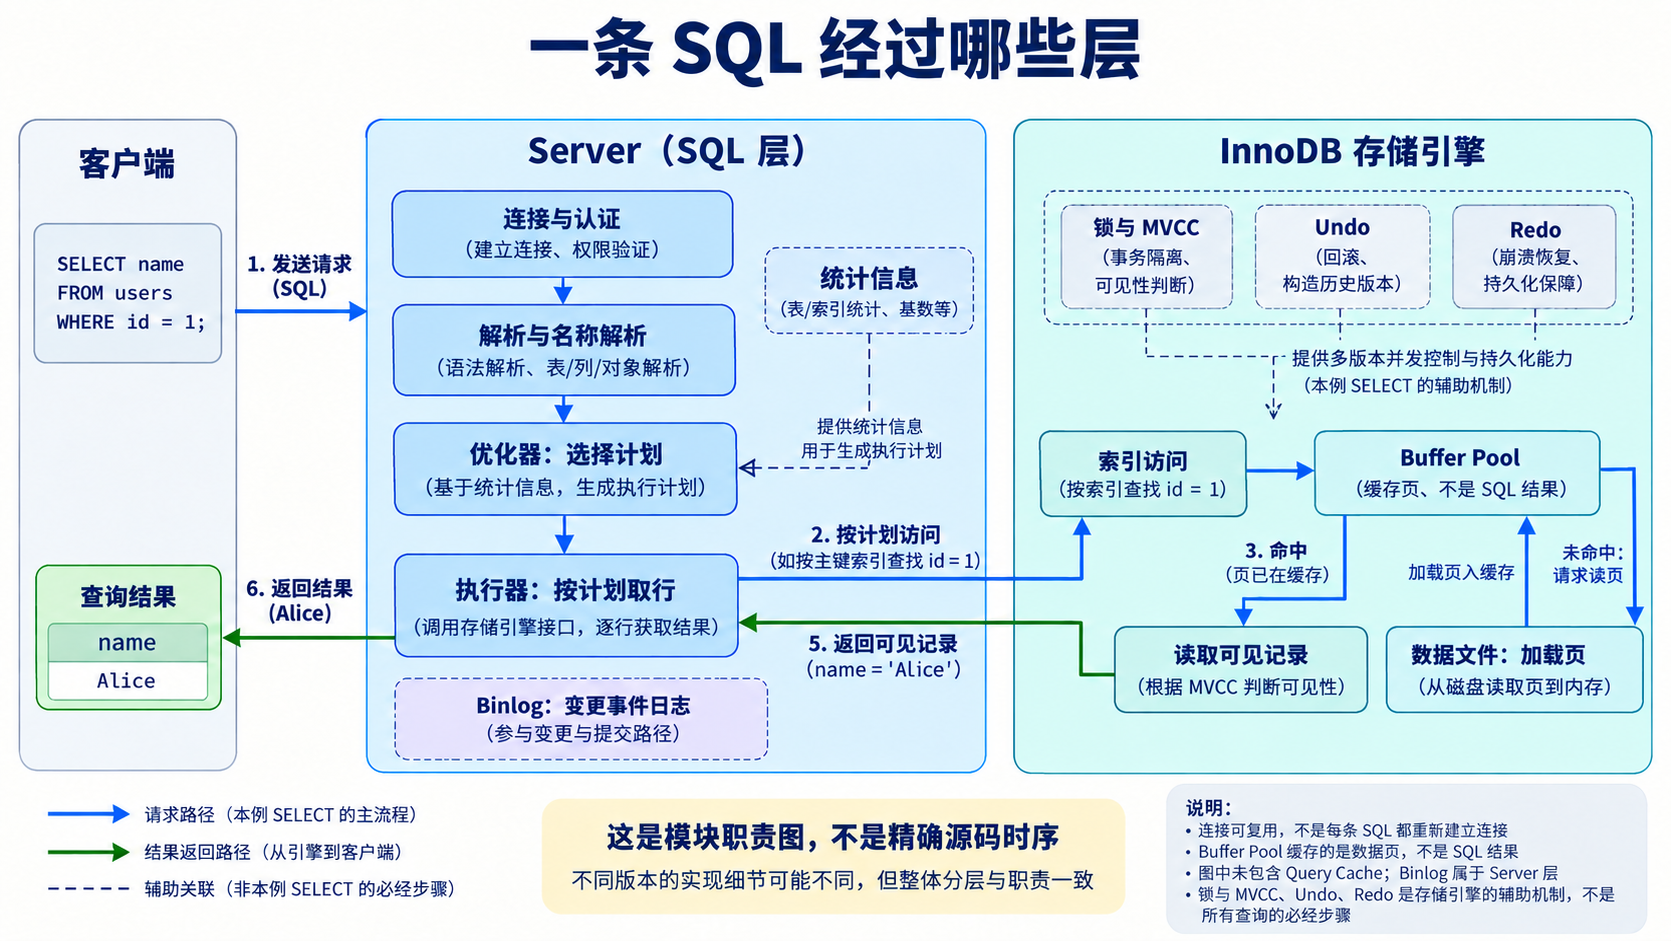
区分 Server 与 InnoDB 的职责,并沿请求、页缓存和结果返回路径理解一条 SQL。
适用边界
旧架构图中的 Query Cache 缓存整条查询的结果,MySQL 8.0 已移除。Buffer Pool 缓存底层页,两者不是同一种缓存。优化器根据统计信息估算成本,可能估错,因而有索引也不代表必然选择它。官方:8.0 移除功能
面试回答
MySQL 可以分为 Server 层和存储引擎层。Server 接收连接并认证,将 SQL 解析成可处理的表达,优化器选择计划,执行器按计划调用引擎并组织输出;Binlog 也属于 Server。InnoDB 负责数据和索引访问,并提供页缓存、锁、MVCC、Redo 和 Undo。Buffer Pool 缓存页,不是 SQL 的整条结果;Query Cache 在 MySQL 8.0 已移除。选择访问路径与真正读取记录是不同职责,有索引也不表示一定采用它。
3. 一条查询 SQL 和一条更新 SQL 分别如何执行?
查询要找到并返回符合条件的数据;更新除了找到记录,还要解决并发修改、失败撤销和提交后恢复。因此两者共用 SQL 处理入口,但存储引擎中的后半段工作不同。
查询流程
SELECT id, amount FROM orders WHERE id = 101;
客户端先建立或复用连接,发送 SQL。MySQL 解析语句,检查名称和权限,优化器生成访问计划。执行器按计划请求 InnoDB 定位订单;引擎按当前事务可见性规则返回数据;执行器处理输出列后,经当前连接返回结果。初始结果是 101、100.00。
注意,连接池中的同一连接可以执行多条语句,不能把“建立 TCP 连接”当作每条 SQL 必有的额外成本。结果也可能逐步发送,不一定等到所有数据全部生成才统一返回。
按本例的主键访问路径,执行器要的是订单 101,而不是把四笔订单全取出来再在应用中挑选。InnoDB 定位相应索引页;缺页时先加载,页已缓存时复用。随后按本事务的可见性取得记录,执行器只输出 id 和 amount,因此不会把 status、created_at 也自动作为结果列返回。这里的 100.00 来自初始化数据,而不是 EXPLAIN 的估算。
配图:SELECT 查询的返回路径
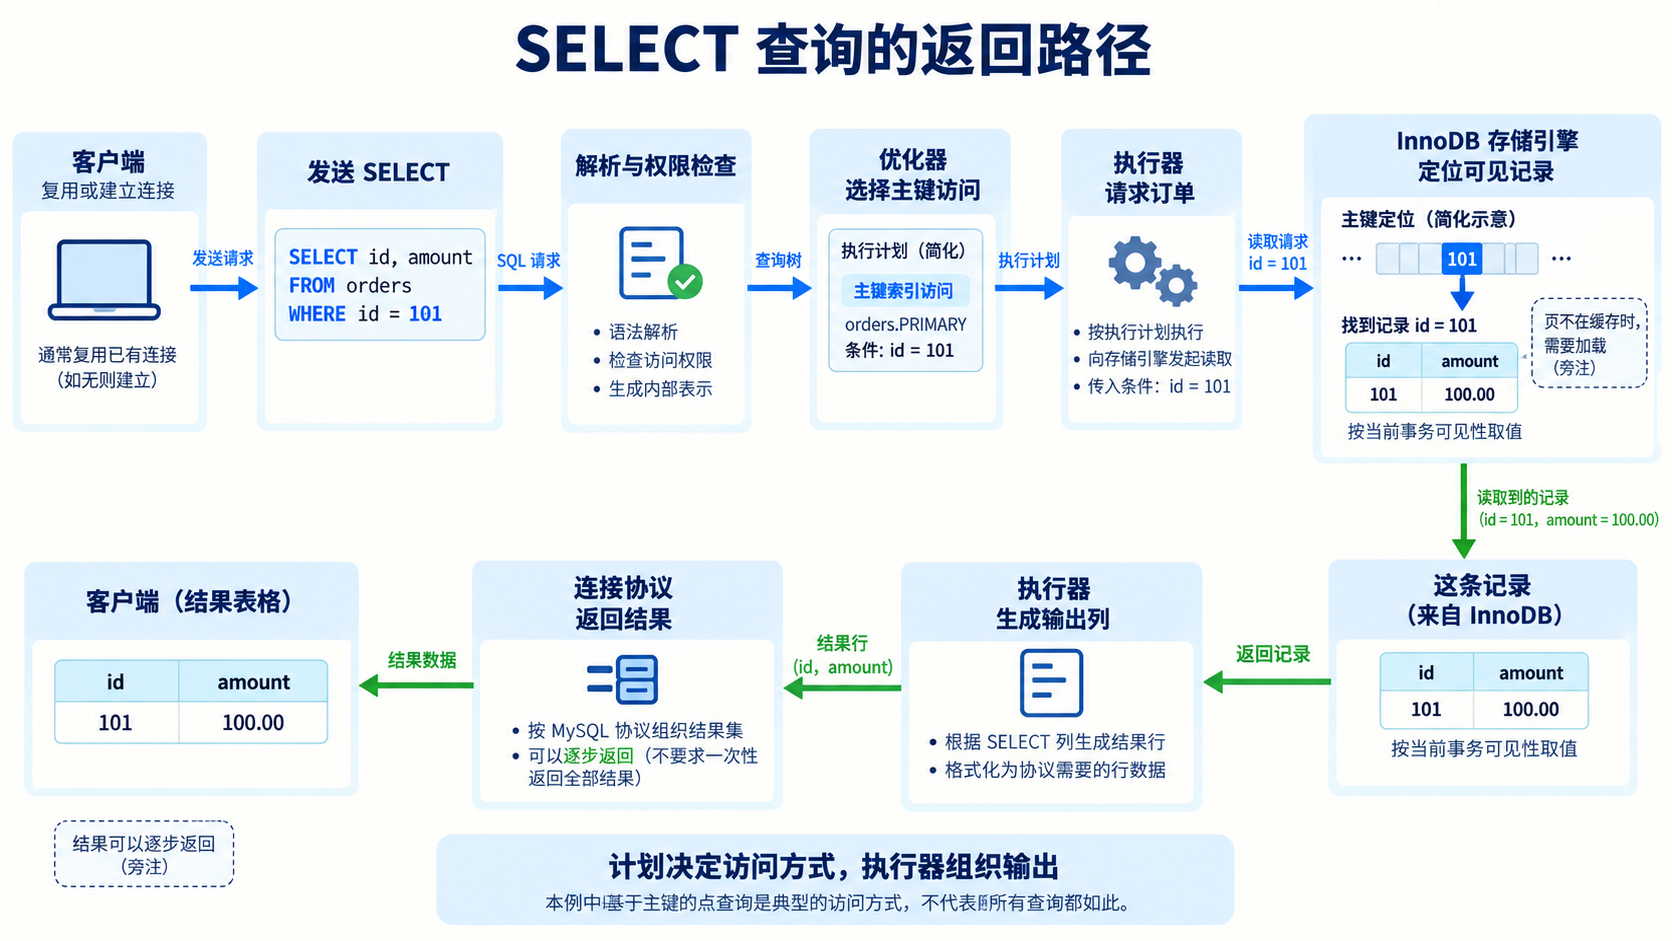
沿订单 101 展示从主键定位、可见记录到客户端输出的过程。
更新流程
START TRANSACTION;
UPDATE products SET stock = stock - 1
WHERE id = 1 AND stock > 0;
SELECT ROW_COUNT() AS affected_rows;
COMMIT;
上面是初始库存为 10 时的成功路径,affected_rows 应为 1。实际应用应在 UPDATE 后立即取得驱动返回的影响行数,或用紧跟 UPDATE 的 ROW_COUNT() 查看;如果不是预期的一行,就进入回滚或失败处理,不能无条件走到 COMMIT。上面的 SQL 用于演示成功路径,没有代写应用的条件分支。官方:UPDATE 的影响行数
概念上可按下面的依赖理解:
- 解析和优化后,按主键找到商品,读取要修改的当前状态;若另一事务已持有冲突锁,就需要等待。
- 判断库存条件。只有符合条件的行才扣减;应用应检查受影响行数,0 行不等于成功卖出一件。
- InnoDB 在修改过程中保存必要 Undo 信息,以便回滚和重建旧版本;在 Buffer Pool 中修改页面,并产生相关 Redo。
- 若开启 Binlog,Server 层按日志格式记录该事务的变更信息。
- 提交时,存储引擎和 Server 按协调机制确定提交结果,并按刷盘配置满足持久化要求;事务结束释放相关事务锁。
初始库存 10,成功执行一次后为 9。若在提交前主动回滚,库存恢复为 10。应用不能把“SQL 没报语法错误”与“业务更新成功”混为一谈。
另一种结果是商品不存在或库存已经为 0:条件不满足,UPDATE 可以正常结束却没有扣减。这时不能向用户返回购买成功。数据库负责按语句原子地判断与修改,应用负责把影响行数解释成成功、售罄或对象不存在等业务结果。
为什么不先查库存,再把旧值减一写回?
假设两个请求都先查到库存 10,然后都执行 SET stock = 9,数据库即使让两条 UPDATE 先后执行,最后也仍是 9,却可能被应用当作卖出了两件。这是把过期的应用内结果写回造成的问题。SET stock = stock - 1 WHERE stock > 0 把判断和扣减放在同一次数据库更新中;竞争同一记录的写者需要协调,不能各自只根据先前读到的 10 决定结果。
可以把独立练习中的两次请求推演为:A 开启事务并扣减到 9,尚未提交;B 对商品 1 执行同样 UPDATE,可能等待 A 的冲突锁。A 提交后,B 继续时基于可修改的当前状态扣减到 8;若 A 回滚,B 则可能从恢复后的 10 扣减到 9。如果初始只剩 1 件且 A 提交买走,B 就应因库存条件不满足而影响 0 行。这个推演假定只有这两次修改、没有超时或其他错误,应用仍需处理真实执行结果。官方:UPDATE 与索引记录锁
独立验证回滚路径
先恢复商品 1 库存为 10,确认没有遗留事务,再执行下面的教学示例:
START TRANSACTION;
UPDATE products SET stock = stock - 1
WHERE id = 1 AND stock > 0;
SELECT stock FROM products WHERE id = 1;
ROLLBACK;
SELECT stock FROM products WHERE id = 1;
同一事务内可看到自己的库存 9;回滚后再次查询应为 10。Undo 提供撤销所需信息,而 Redo 解决故障恢复中的页面修改问题,它们不是两份相同的日志。成功提交后再执行普通 ROLLBACK,不会撤销那次已提交扣减。至于创建订单、发消息是否与扣库存一起成功,还要看它们是否在同一事务边界或采用了其他协调方式。
配图:库存扣减:条件、修改与提交
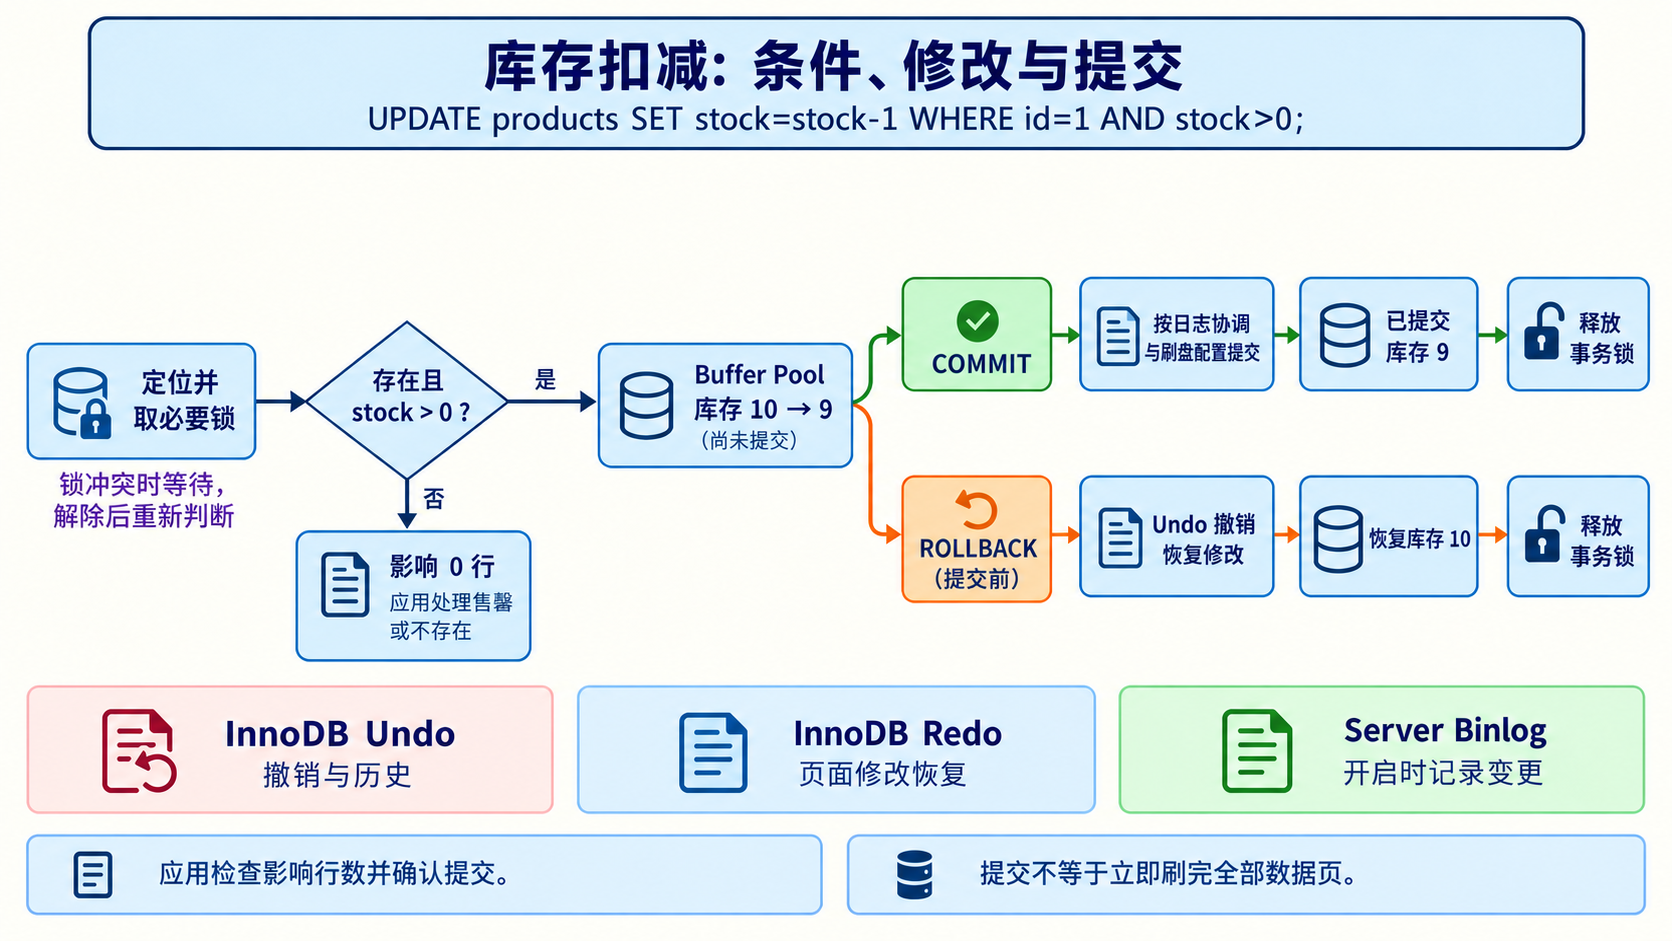
区分影响 0 行、锁等待、事务内修改、提交和回滚;日志卡片表示职责,不是固定源码时序。
重要边界
这是解释职责和依赖的模型,不是内核源码中每个日志写入函数的固定顺序。条件可能下推到存储引擎,日志也可以批量刷写。更新内存页可以发生在提交前,提交不要求立即写回所有数据页;持久性靠日志和刷盘规则共同保证。
进一步阅读:事务、WAL、Undo、Binlog、两阶段提交、宕机恢复。
面试回答
查询和更新都经过解析、优化和执行器调用引擎。查询按访问路径及事务可见性取得记录,再输出需要的列;更新还要协调冲突锁、判断条件、保存 Undo、修改内存页并产生 Redo,开启 Binlog 时还要记录变更。库存扣减应把 stock > 0 和 stock - 1 放在同一 UPDATE 中,再检查影响行数,而不是先读旧值再覆盖写回。提交通过日志协调和刷盘策略支持恢复,不等于立即刷完所有数据页;提交前回滚和已提交后补偿也不是一回事。
4. 如何创建表、插入数据和修改表结构?
相关问法:建表、添加列、删除列、插入数据。|示例依赖:本题独立 demo_products 表。
概念与用途
DDL 定义数据库对象,例如 CREATE、ALTER、DROP;DML 操作表中的数据,例如 INSERT、UPDATE、DELETE。先有明确表结构,数据才能遵守统一类型和约束。
CREATE TABLE demo_products (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  name VARCHAR(80) NOT NULL,
  price DECIMAL(10,2) NOT NULL,
  stock INT NOT NULL DEFAULT 0
) ENGINE=InnoDB;
INSERT INTO demo_products (name, price) VALUES ('Book', 19.90);
INSERT INTO demo_products (name, price, stock)
VALUES ('Pen', 2.00, 10), ('Bag', 30.00, 5);
ALTER TABLE demo_products
  ADD COLUMN note VARCHAR(100),
  ADD COLUMN source_code VARCHAR(20);
ALTER TABLE demo_products
  DROP COLUMN note,
  DROP COLUMN source_code;
SELECT name, stock FROM demo_products ORDER BY id;
在新建空表上依次运行,最后返回 Book/0、Pen/10、Bag/5。Book 没指定库存,因此使用默认值。明确列清单可以避免表新增列之后,插入值与列的对应关系变得模糊。
对照每条 SQL 看变化
| 操作完成后 | 列数 | 行数 | 变化的是 |
|---|---|---|---|
| CREATE TABLE | 4 | 0 | 建立列、类型、默认值与主键规则 |
| 两条 INSERT | 4 | 3 | 写入 Book、Pen、Bag 三条记录 |
| ADD COLUMN note、source_code | 6 | 3 | 每行增加两个可空字段,本例原有行取 NULL |
| DROP COLUMN note、source_code | 4 | 3 | 移除这两个字段,不删除三条商品记录 |
本例假设新表的自增起点与步长均为 1,因此三条商品的 id 是 1、2、3。省略 id 是让数据库分配标识,不是省略主键约束。CREATE TABLE 只建立结构;INSERT 才增加行。INSERT (name, price) 中两个值按列清单对应,stock 从 DEFAULT 0 取得,不能将这个 0 理解为“未知库存”。
配图:建表、增行与修改结构

对照同一张表的列数和行数,区分新增记录、增加列与删除列。
边界
SQL 字符串用普通单引号;标识符必要时用反引号,不能使用中文弯引号代替。一次删除多个列需要分别写 DROP COLUMN。DDL 经常具有隐式提交语义,不能把“包在事务里”理解成可撤销所有结构修改。
在大表上,同一 ALTER 可能即时修改元数据,也可能重建数据。INSTANT、INPLACE、COPY 是具体操作和版本支持的能力,在线 DDL 仍可能等待元数据锁,不能承诺“加列永远不锁表”。
默认值也不是对所有不合法输入兜底:省略 stock 可以使用默认值,但给 NOT NULL 列显式传入 NULL,并不等价于省略该列。设计接口时要区分缺省、空值和实际的零,避免错误数据被当成正常业务状态。
即使把 ALTER 放在 START TRANSACTION 和 ROLLBACK 之间,也不能据此设计“试着改表,再回滚”的业务流程;普通表的这些 DDL 会涉及隐式提交。大表上的变更还可能等待正在使用表定义的事务,或复制、重组记录。因此变更前要核对具体操作支持的算法和锁行为,而不是把语句长度当作成本。官方:隐式提交、在线 DDL 操作能力
面试回答
CREATE TABLE 定义列、类型、默认值和约束,带列清单的 INSERT 增加记录,ALTER TABLE 增删字段。DDL 管结构,DML 管数据,增加或删除列不会等同于增加或删除行。省略 stock 可以使用 DEFAULT 0,但显式 NULL 不等同于省略。普通表的这些 DDL 涉及隐式提交,不能依赖普通 ROLLBACK 撤销;大表变更还要核对算法、重建成本和元数据锁等待,不能凭语句短就认为成本低。
5. DELETE、TRUNCATE 和 DROP 有什么区别?
相关问法:删除部分数据、清空表、删除表;DELETE 能否回滚?|示例依赖:本题独立 demo_delete 表。
一句话理解与用途
DELETE 删除行,TRUNCATE 清空表,DROP 删除表这个对象。选择取决于你希望保留什么,而不是只看哪个命令更短或更快。
| 维度 | DELETE | TRUNCATE TABLE | DROP TABLE |
|---|---|---|---|
| WHERE 条件 | 支持 | 不支持 | 不支持 |
| 执行后表结构 | 保留 | 保留 | 删除 |
| 类型 | DML | DDL | DDL |
| 普通事务回滚 | InnoDB 中未提交可回滚 | 不可用 ROLLBACK 撤销 | 普通表不可用 ROLLBACK 撤销 |
| DELETE 触发器 | 按删除行触发 | 不触发 | 不触发 |
| 自增计数 | 通常不重置 | 通常重置为初始值 | 随表对象消失 |
用一次实验理解回滚
仅在独立练习库执行下面的删除示例。 demo_delete 与商品、订单表无关;执行 DROP 后该表不再存在,后续查询它会报错,不是返回零行。
CREATE TABLE demo_delete (
  id INT PRIMARY KEY AUTO_INCREMENT,
  note VARCHAR(20)
) ENGINE=InnoDB;
INSERT INTO demo_delete (note) VALUES ('keep'), ('remove');
START TRANSACTION;
DELETE FROM demo_delete WHERE id = 2;
SELECT COUNT(*) FROM demo_delete;
ROLLBACK;
SELECT COUNT(*) FROM demo_delete;
TRUNCATE TABLE demo_delete;
SELECT COUNT(*) FROM demo_delete;
DROP TABLE demo_delete;
三个计数依次为 1、2、0。最后表已不存在。DELETE 在显式事务中尚未提交,所以可恢复;TRUNCATE 走 DDL 路径,不会生成供用户按普通事务逐行撤销的操作历史。
同样从两行表开始比较:DELETE WHERE id = 2 后还剩一行;本例在提交前 ROLLBACK,恢复为两行。TRUNCATE 后表还可以继续插入和查询,只是所有数据行已清空。DROP 后则连列定义、索引和这个表对象一起移除,需要重新建表才能继续使用。配图中的三个分支各自从两行初始表开始,不是跳过回滚后连续应用三种操作。
决定能否回滚的不是命令名字中有没有“删除”,而是操作的事务语义与当前提交状态。若在 autocommit=1 下单独执行 DELETE 且语句已成功提交,后来再写 ROLLBACK 也不会把它变成未提交操作。因此“DELETE 可以回滚”必须带上 InnoDB、有效事务、尚未提交这些前提。
配图:DELETE、TRUNCATE、DROP:删除的对象不同
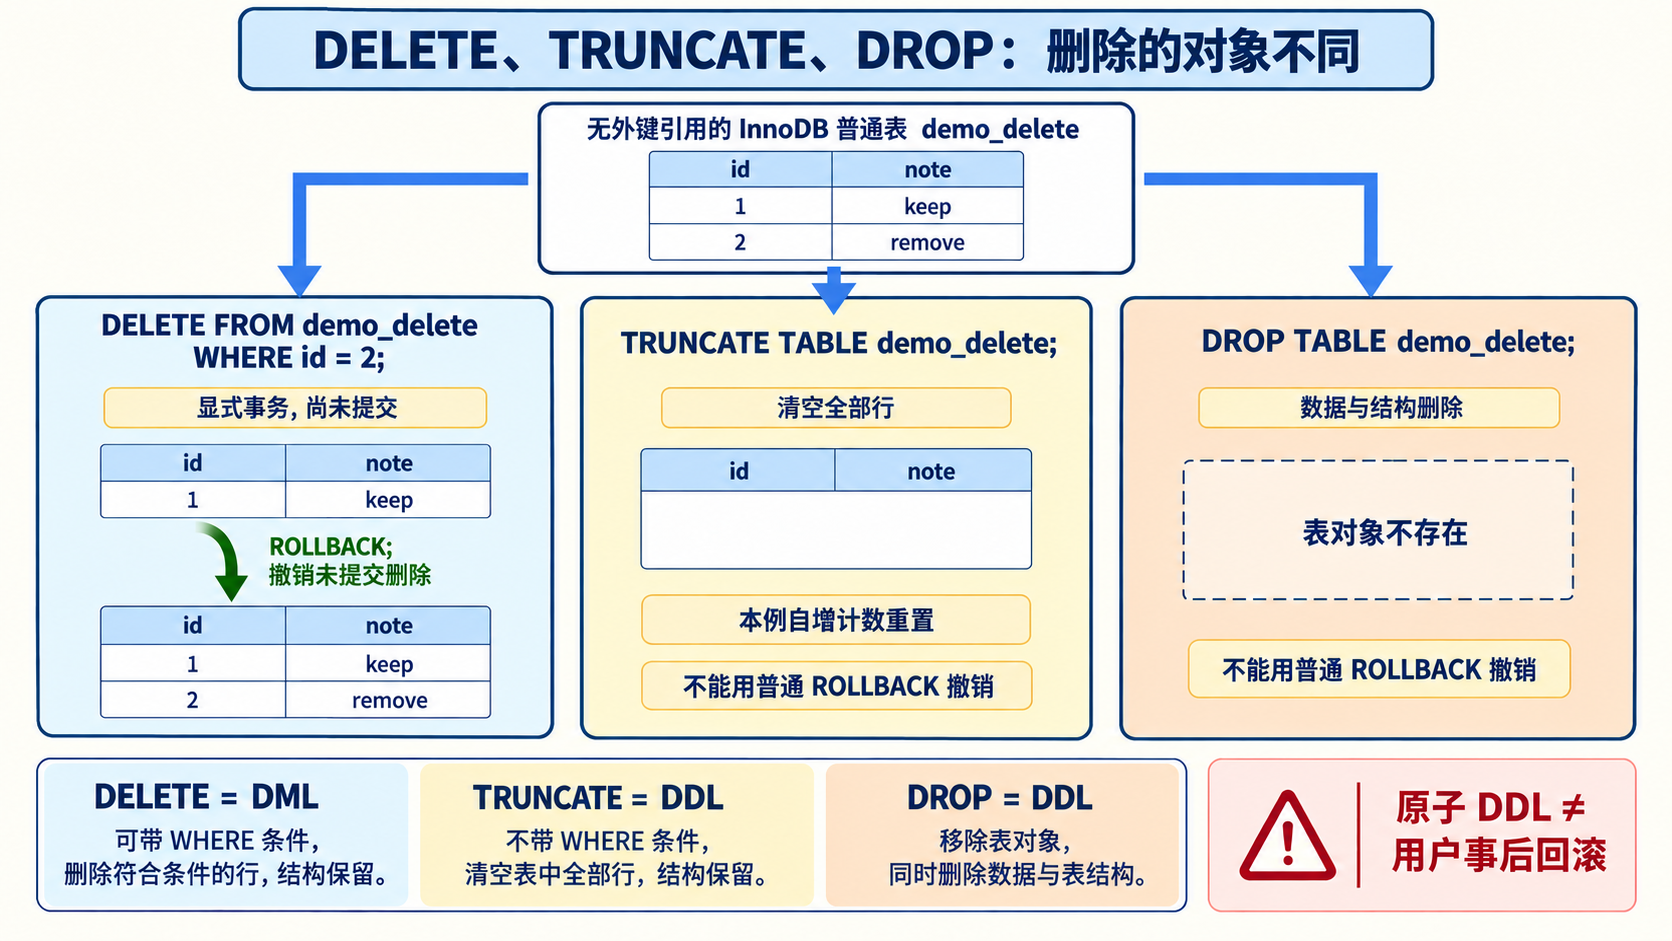
三个独立分支从相同的两行表开始,比较保留数据、结构及回滚的条件。
为什么清空表常用 TRUNCATE
逐行 DELETE 需要维护索引、锁和撤销信息,大表清空时可能产生大量工作。TRUNCATE 对 InnoDB 通常采用重新创建表的方式处理,因此往往更适合“所有行都不要了”的场景。但它要取得所需元数据锁,遇到长事务可能等待,不能理解为永远瞬间完成。
DELETE 是否释放磁盘空间是另一层问题。记录被删除后,页面中的空间可供后续使用,文件大小不一定立即缩小;是否归还操作系统还与表空间及重建方式有关。
必须分清的边界
普通表的 DROP、TRUNCATE 会涉及隐式提交;不要在未完成业务事务中随手执行。MySQL 8 的原子 DDL 是保证故障下结构操作整体成功或失败,不是允许执行完后由用户 ROLLBACK 撤销。临时表存在部分不同事务语义,不能外推到普通表。
原子 DDL 的问题是“机器在操作途中故障,能否避免留下半完成结构”;用户事务回滚的问题是“应用能否把刚执行的修改主动撤销”。二者保护不同场景,不能因为支持原子 DDL 就认为 TRUNCATE 可以在执行后反悔。官方:原子 DDL
外键也会限制删除或清空。例如某表被其他表引用时,TRUNCATE 可能被拒绝;DELETE 可能受到 RESTRICT 或 CASCADE 等规则影响。本题实验故意使用无外键独立表,避免与其他示例混淆。官方:TRUNCATE
面试回答
DELETE 按行删除,可带 WHERE,在 InnoDB 有效且尚未提交的事务中能回滚;已经自动提交的 DELETE 不能事后靠 ROLLBACK 撤销。TRUNCATE 清空普通表但保留结构,通常重置自增,不触发 DELETE 触发器;DROP 则删除整个表对象。TRUNCATE 和普通表 DROP 都不能用普通事务回滚撤销。原子 DDL 解决操作途中故障的完整性,不是让用户事后反悔;删除行也不保证数据文件立刻缩小。
6. ORDER BY 和 LIMIT 如何使用?怎样稳定地取前 N 行?
相关问法:排序、前十行、分页。|示例依赖:orders。
概念与问题
ORDER BY 指定结果的排序规则;LIMIT 限制返回数量或先跳过若干行。表是数据集合,没有“天然第一页”的业务含义。要显示最新订单,必须告诉数据库按什么判断新旧。
SELECT id, created_at FROM orders
ORDER BY created_at DESC, id DESC
LIMIT 2;
初始数据中,104 和 103 的时间相同,使用 id 作为第二排序列后,结果稳定为 104、103。只按 created_at 排序无法决定这两条谁先出现。
ASC 表示升序,也是默认值;DESC 表示降序。多列排序从左到右比较,只有前一列相同时才比较后一列。下一页可写 LIMIT 2 OFFSET 2,等价于 LIMIT 2, 2:先跳过两条,再取两条。
把比较过程展开
103、104 的 created_at 都是 2026-01-03 10:00:00,时间这一列无法区分它们。补上 id DESC 后,104 大于 103,便明确排在前面;102 的时间早一天,101 再早一天。因此完整顺序为 104、103、102、101,LIMIT 2 返回前两条,偏移 2 再取 2 条返回 102、101。LIMIT 的第一个偏移参数从 0 开始,不是页码。官方:LIMIT 与排序
SELECT id, created_at FROM orders
ORDER BY created_at DESC, id DESC
LIMIT 2 OFFSET 2;
这种顺序是我们定义的展示规则,不是事务提交先后。即使 id 来自自增,也不能据此证明某条记录一定先提交。索引能按键定位和有序遍历,但一般不提供任意筛选结果的行号,所以深 OFFSET 也不等于直接跳到第 N 条而不检查前面的结果。
配图:时间相同,用唯一 ID 决定顺序
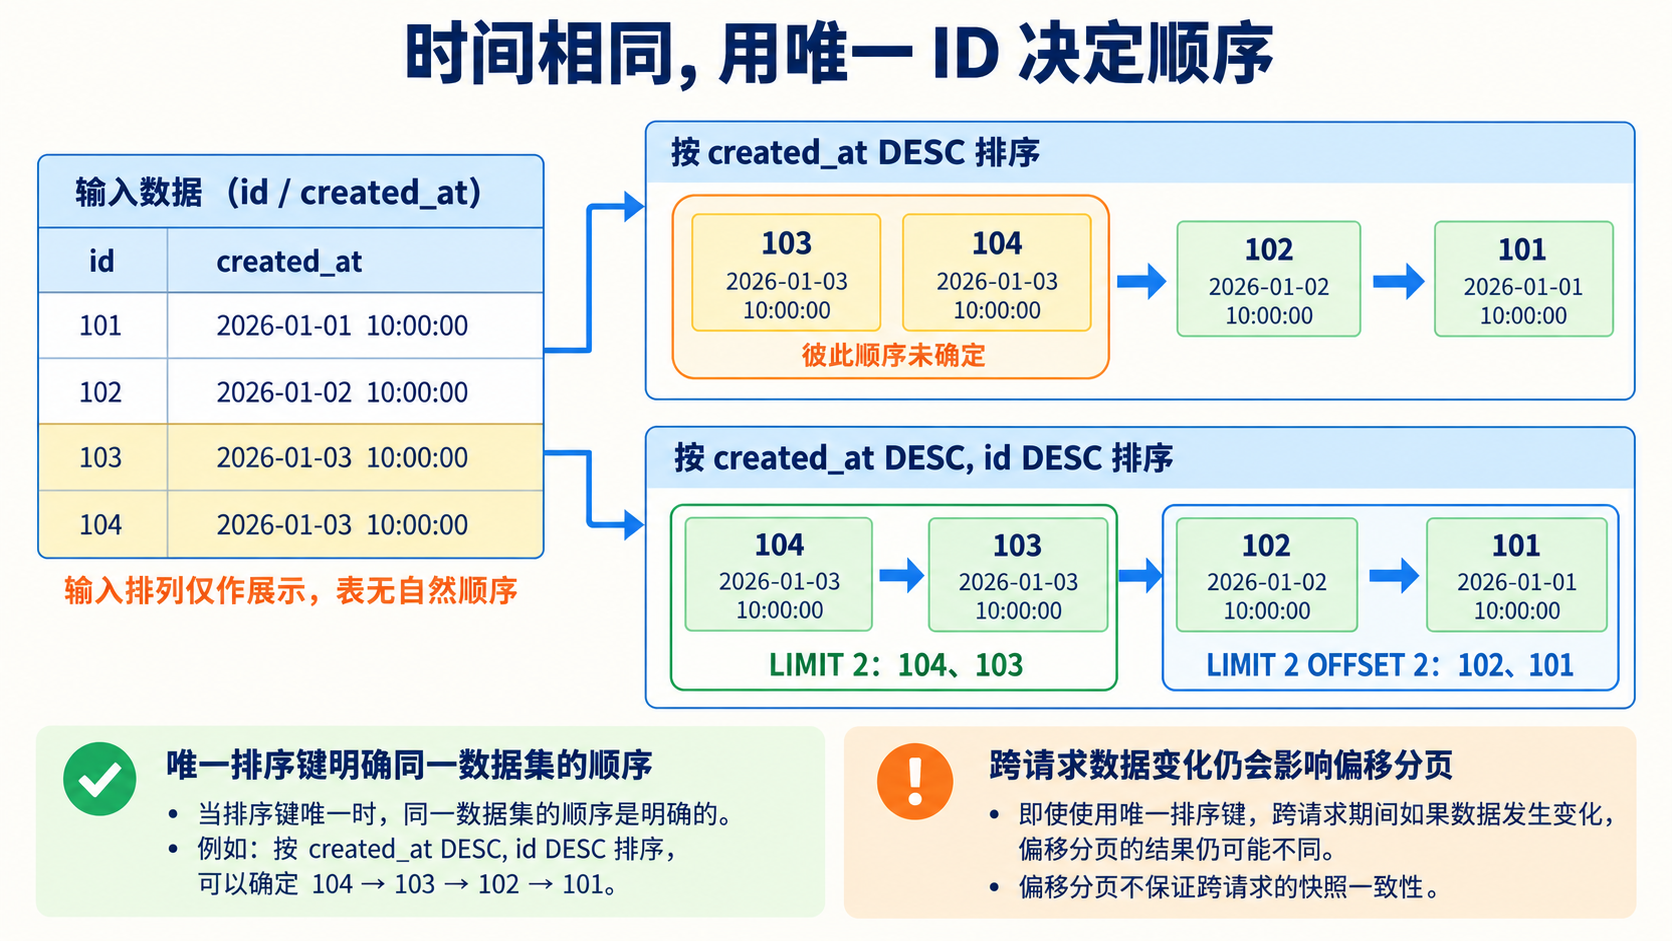
展示相同创建时间如何由 id 决定顺序,以及 LIMIT 取前两条和 OFFSET 跳过两条。
原理与边界
MySQL 可能利用索引已有顺序返回结果,也可能额外排序。执行计划中的 filesort 表示使用额外排序过程,不意味着一定把数据写到磁盘,内存足够时可以在内存完成。
稳定排序只解决同一数据集的顺序。如果两次分页之间插入或删除记录,偏移分页仍可能重复或漏项;这是数据变化问题,不是再加一列排序就能全部解决。优化方法见深分页。
例如第一请求已经返回 104、103,随后新增一笔比它们更新的订单 105。若第二请求在新视图中执行 OFFSET 2,当前顺序变为 105、104、103、102、101,它会返回 103、102,103 就重复了。唯一排序没有失效,变的是两次请求的输入集合。滚动加载可考虑完整排序键游标;需要固定结果则还要定义快照或业务冻结边界。
面试回答
ORDER BY 定义结果顺序,LIMIT 控制数量或偏移。没有明确排序就没有可靠的业务前 N 行;时间相同要补唯一键,例如 created_at DESC、id DESC,才能明确 104、103 谁在前。OFFSET 是跳过的行数,不是页码,深偏移通常仍有扫描成本。索引可能提供顺序,filesort 也不一定落盘。唯一排序只约束同一数据集,并发插入删除后仍可能造成偏移分页重复或遗漏。
7. SQL 的逻辑处理顺序是什么?WHERE、GROUP BY、HAVING 如何配合?
相关问法:关键字执行顺序、分组过滤。|示例依赖:orders。
一句话理解与用途
WHERE 判断一行是否参与后续处理,GROUP BY 把行分成组,聚合函数计算每组结果,HAVING 再判断哪些组留下。理解这个顺序,就能知道条件应该放在哪里。
可以先把订单想成一叠单据:先挑已支付订单,再按用户分堆,把每堆金额相加,最后留下总额达到门槛的用户。真实数据库不一定物理分堆,但查询含义与这个过程一致。
SELECT user_id, SUM(amount) AS total
FROM orders
WHERE status = 'paid'
GROUP BY user_id
HAVING SUM(amount) >= 100
ORDER BY total DESC, user_id ASC
LIMIT 10;
逐步看结果
初始订单为:用户 1 的 101 已支付 100、102 待支付 200、103 已支付 50,以及用户 2 的 104 已支付 80。
- FROM 取得订单这个输入集合。
- WHERE 从本次计算中排除未支付的 102,剩 101、103、104;它没有删除原表记录。
- GROUP BY 按 user_id 分为两组。
- SUM 得到用户 1 的 150 和用户 2 的 80。
- HAVING 仅保留总额至少 100 的组,即用户 1。
- SELECT 产生 user_id 和 total,ORDER BY 排序,LIMIT 限制输出数量。
完整记忆路线可写为:FROM/JOIN 与 ON → WHERE → GROUP BY/聚合 → HAVING → SELECT → DISTINCT → ORDER BY → LIMIT。外连接中,ON 先决定哪些行匹配,再补齐应保留的未匹配行,WHERE 才对连接结果过滤。
| 阶段 | 本例剩下的输入或结果 |
|---|---|
| WHERE 之后 | 101/用户 1/100,103/用户 1/50,104/用户 2/80 |
| GROUP BY 与 SUM 之后 | 用户 1:150;用户 2:80 |
| HAVING 之后 | 用户 1:150 |
| SELECT、ORDER BY、LIMIT 之后 | 输出一行 user_id = 1、total = 150 |
为什么不能把 SUM(amount) >= 100 直接搬到同一查询块的 WHERE?WHERE 此时判断的是单条输入记录,还没有这组记录的合计。而 status = 'paid' 是每条订单都能独立判断的条件,应该先过滤;否则若先把用户 1 的待支付 200 也加入聚合,再试图过滤组,计算对象已经变了。选择 WHERE 或 HAVING 的关键是条件针对一行还是聚合后的组,不是哪个关键字更好背。
配图:WHERE 筛行,HAVING 筛组
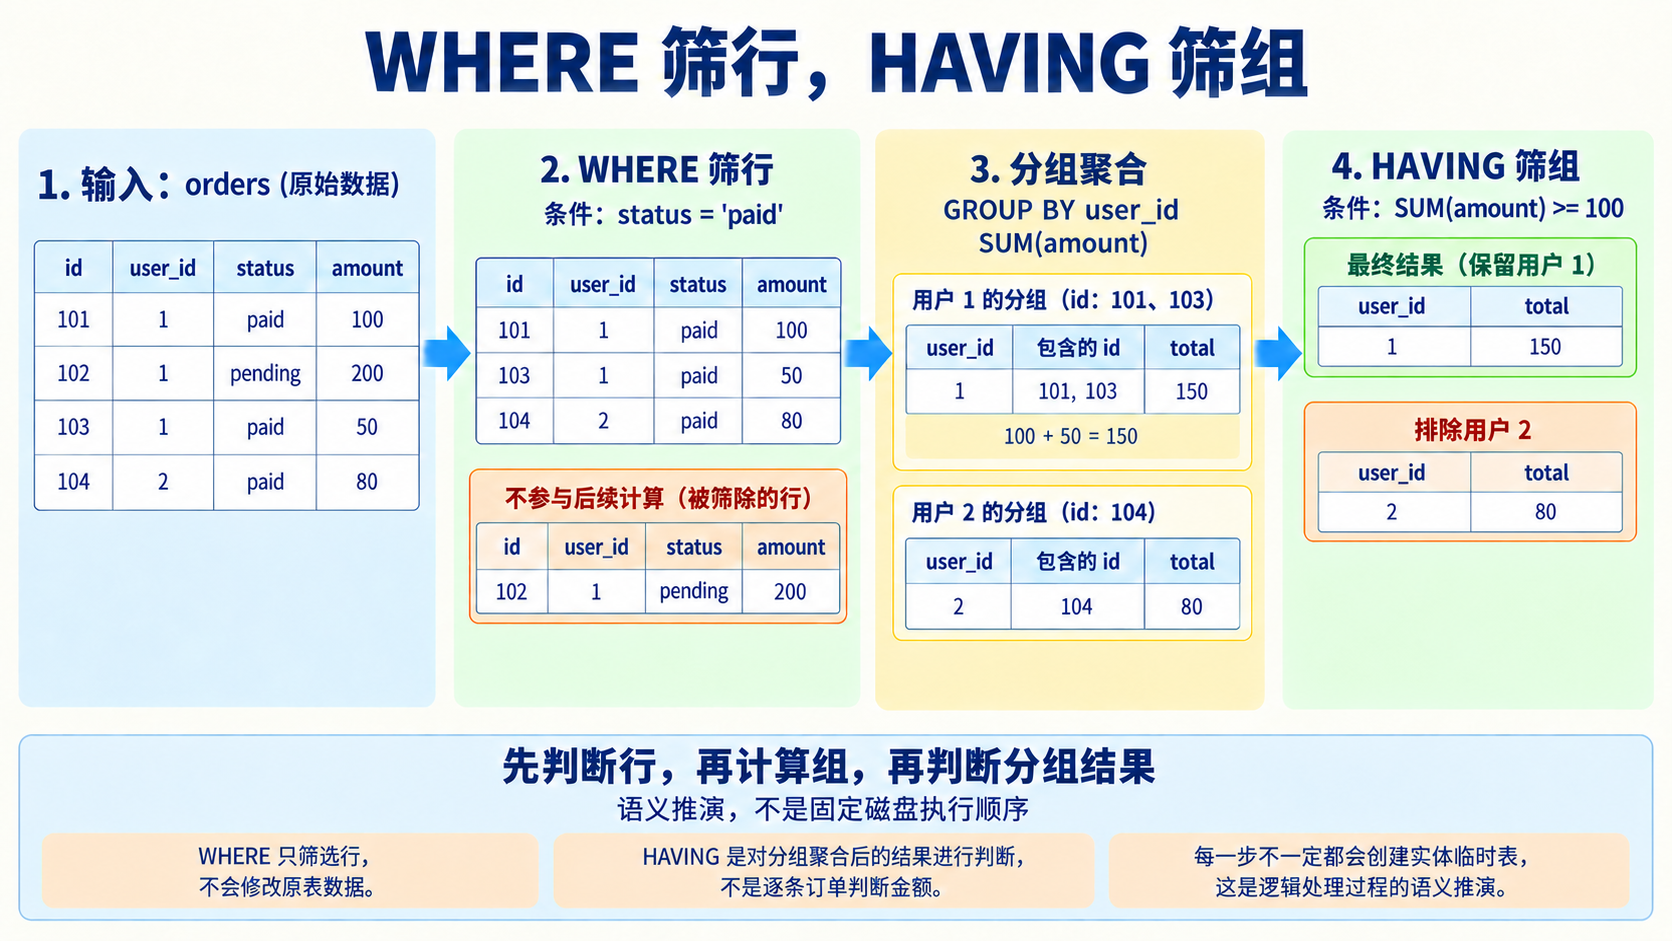
将四笔订单依次筛选、分组和聚合到用户 1 的 150,过滤不会删除原表数据。
这不是固定的磁盘执行顺序
优化器可以把某些筛选提前、使用索引直接定位,或重写子查询,只要保持语义。比如 WHERE 限制某个主键时,不需要真的扫描全部输入再丢弃。因此“逻辑处理顺序”帮助理解结果,不等于每次必然创建一个中间表。
默认启用 ONLY_FULL_GROUP_BY 的环境下,SELECT 的非聚合列必须符合分组或函数依赖规则,不能随意返回组中某一条记录的字段。例如按用户分组后再返回任意订单 id,会让“究竟是哪笔订单”没有清晰含义。MySQL 允许部分别名在 HAVING 中使用,这是它的名称解析能力,不改变筛选组的概念。
适用边界
WHERE 与 GROUP BY 可以一起用,而且普通行条件通常适合提前过滤。HAVING 也可用于没有显式 GROUP BY 的聚合,把整个输入视为一组;因此“只能跟 GROUP BY 一起用”不准确。
GROUP BY 不自动保证输出顺序,需要排序仍应写 ORDER BY。SELECT 中的 total 是 SUM(amount) 的别名,本例可以在 ORDER BY 使用它,但不能按“别名已经在 SQL 前面写过”推断 WHERE 就能使用它。逻辑处理顺序是便于解释语义的模型,MySQL 的别名解析与优化能力需要另行区分。官方:GROUP BY 与函数依赖、列别名的使用范围
面试回答
SQL 逻辑上先构造 FROM/JOIN 输入、按 ON 匹配,再用 WHERE 筛行,GROUP BY 分组聚合,HAVING 筛组,随后输出、去重、排序和限制数量。已支付状态能逐行判断,所以放 WHERE;组内金额合计要在聚合后用 HAVING 判断,不能直接搬到同一查询块的 WHERE。这是结果语义的推演,不是固定物理执行步骤。HAVING 也可作用于没有显式 GROUP BY 的聚合,分组本身不保证排序。
8. DISTINCT 如何去重?怎样查找重复数据?
相关问法:查询唯一值、查找重复行。|示例依赖:orders。
概念与用途
DISTINCT 对结果中整组选择列去重;GROUP BY ... HAVING COUNT(*) > 1 则用于识别多次出现的业务键。它们都不自动删除原表记录。
SELECT DISTINCT user_id, status
FROM orders ORDER BY user_id, status;
SELECT user_id, status, COUNT(*) AS occurrences
FROM orders GROUP BY user_id, status
HAVING COUNT(*) > 1;
第一条返回 (1,paid)、(1,pending)、(2,paid) 三种组合;第二条返回用户 1、paid、2。虽然同一个用户出现多次,但状态不同的行不会被 DISTINCT 合并,因为比较的是整组列。
重复发生在哪一层?
原始订单的 id 分别是 101、102、103、104,没有重复主键。只选择 user_id 和 status 后,101、103 都投影成 (1,paid),重复才出现在这组输出列上。DISTINCT 将两份相同组合输出一次,但订单 101 和 103 都仍在数据库中。如果同时选择 id,四个输出行的 id 不同,就不会合并成三行。
分组统计走另一条路线:(1,paid) 有两条输入,(1,pending) 有一条,(2,paid) 有一条;HAVING COUNT(*) > 1 只留下第一组以及计数 2。COUNT 在这里回答“这一组合出现多少次”,不回答“两笔订单中应该删除哪笔”。官方:DISTINCT 优化
为什么先定义“重复”
订单 id 不同就表示不同数据库行,但同一支付请求可能被重复建立两笔订单。判断重复应该使用请求编号等业务键,而不是把所有字段都加入 GROUP BY,也不是只看两行外观相似。上例按用户和状态分组只是教学,不代表同一用户不应有两笔已支付订单。
COUNT() 统计行;COUNT(column) 不计该列为 NULL 的行。分组查重复通常用 COUNT(),避免漏计。输出列应与分组键或聚合一致,不能分组 name、category 却随意输出不相关字段。
发现重复后还要决定保留哪条、如何合并关联记录,这属于数据修复,不能直接用 DISTINCT 当作删除方案。比如两笔订单金额不同,即使请求号相同,也应先核实业务事实,再处理,避免去重时删掉合法记录。
识别已有重复与防止新重复是两件事。业务明确要求唯一且必填的请求编号,应由 NOT NULL、正确的唯一约束配合事务处理保护;仅在插入前查询一次,两个并发请求仍可能都查到“不存在”,随后分别写入。唯一约束的列应按业务身份选择,不能把本例的 user_id、status 组合设为唯一而阻止合法订单。官方:PRIMARY KEY 与 UNIQUE 约束
配图:结果去重与重复组合统计
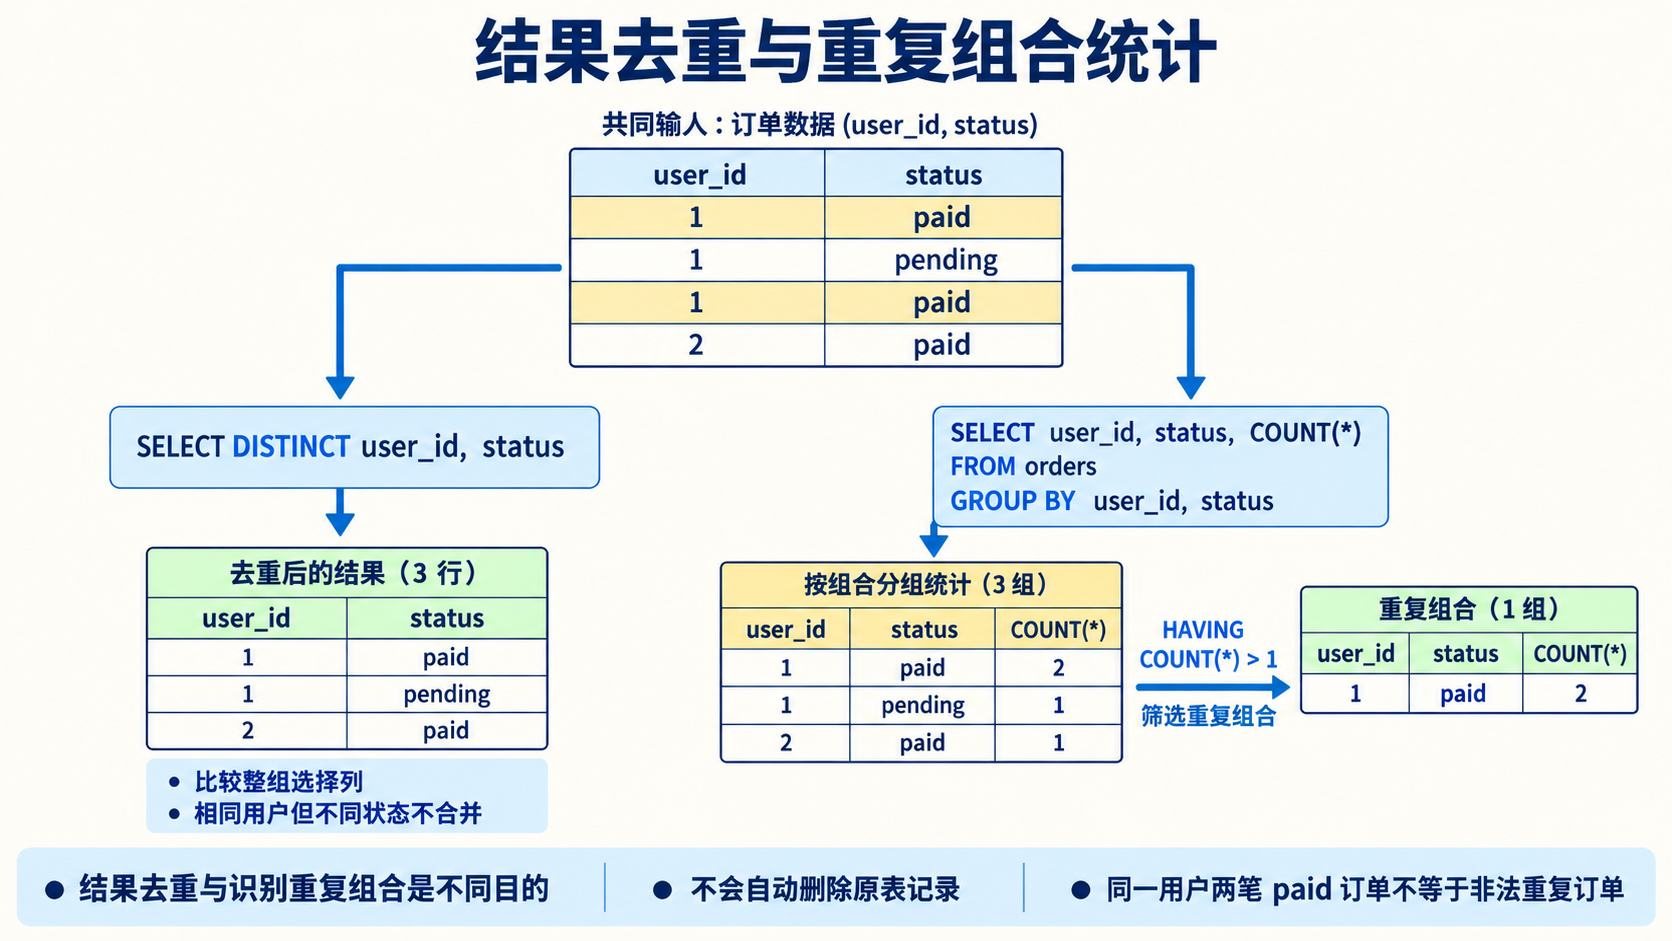
用相同输入区分 DISTINCT 的三种组合与 HAVING 留下的重复组合计数。
面试回答
DISTINCT 对 SELECT 的整组输出列去重,不会删除原表记录。订单 101、103 虽然是不同记录,只输出 user_id 和 status 时却都成为 (1,paid),因此结果只保留一次;若同时输出不同的 id,就不会合并。查找重复组合可 GROUP BY 业务键并 HAVING COUNT(*) > 1,但必须先定义业务上的重复,不能把两笔合法的已支付订单误判为错误。识别、修复与用唯一约束防重复是不同工作。
9. UNION 和 UNION ALL 有什么区别?
相关问法:多个查询结果怎样合并?|示例依赖:orders。
概念与用途
两者都把多个查询结果按行合并。UNION 去除合并结果中的重复行,UNION ALL 保留所有行。它们是纵向追加结果,与 JOIN 横向组合列不同。
SELECT user_id FROM orders WHERE id IN (101, 104)
UNION ALL
SELECT user_id FROM orders WHERE id = 103;
两侧分别产生 1、2 和 1,合并后有三行。把 UNION ALL 改成 UNION 后只剩 1、2 两个不同值。未加整体 ORDER BY 时,不保证实际显示顺序。
把两个查询的输出当作两叠相同列结构的结果:第一叠有 user_id 为 1、2 的两行,第二叠有 user_id 为 1 的一行。UNION ALL 直接保留三次出现;UNION 判断合并后的输出值,两个 1 相同,因此只输出一次。101、103 是不同订单,但它们的来源身份没有被选出来,所以不能阻止 user_id = 1 的结果被去重。
需要确定顺序时,给整个结果排序
SELECT user_id FROM orders WHERE id IN (101, 104)
UNION ALL
SELECT user_id FROM orders WHERE id = 103
ORDER BY user_id;
此时输出值的顺序为 1、1、2。若改为 UNION,排序后的值为 1、2。ORDER BY 作用于合并后的结果,而不是只排第二个查询。这里两条重复行的输出内容完全相同;若还要区分来源,就需要在输出中明确加入来源字段。
配图:UNION ALL 保留重复,UNION 去重
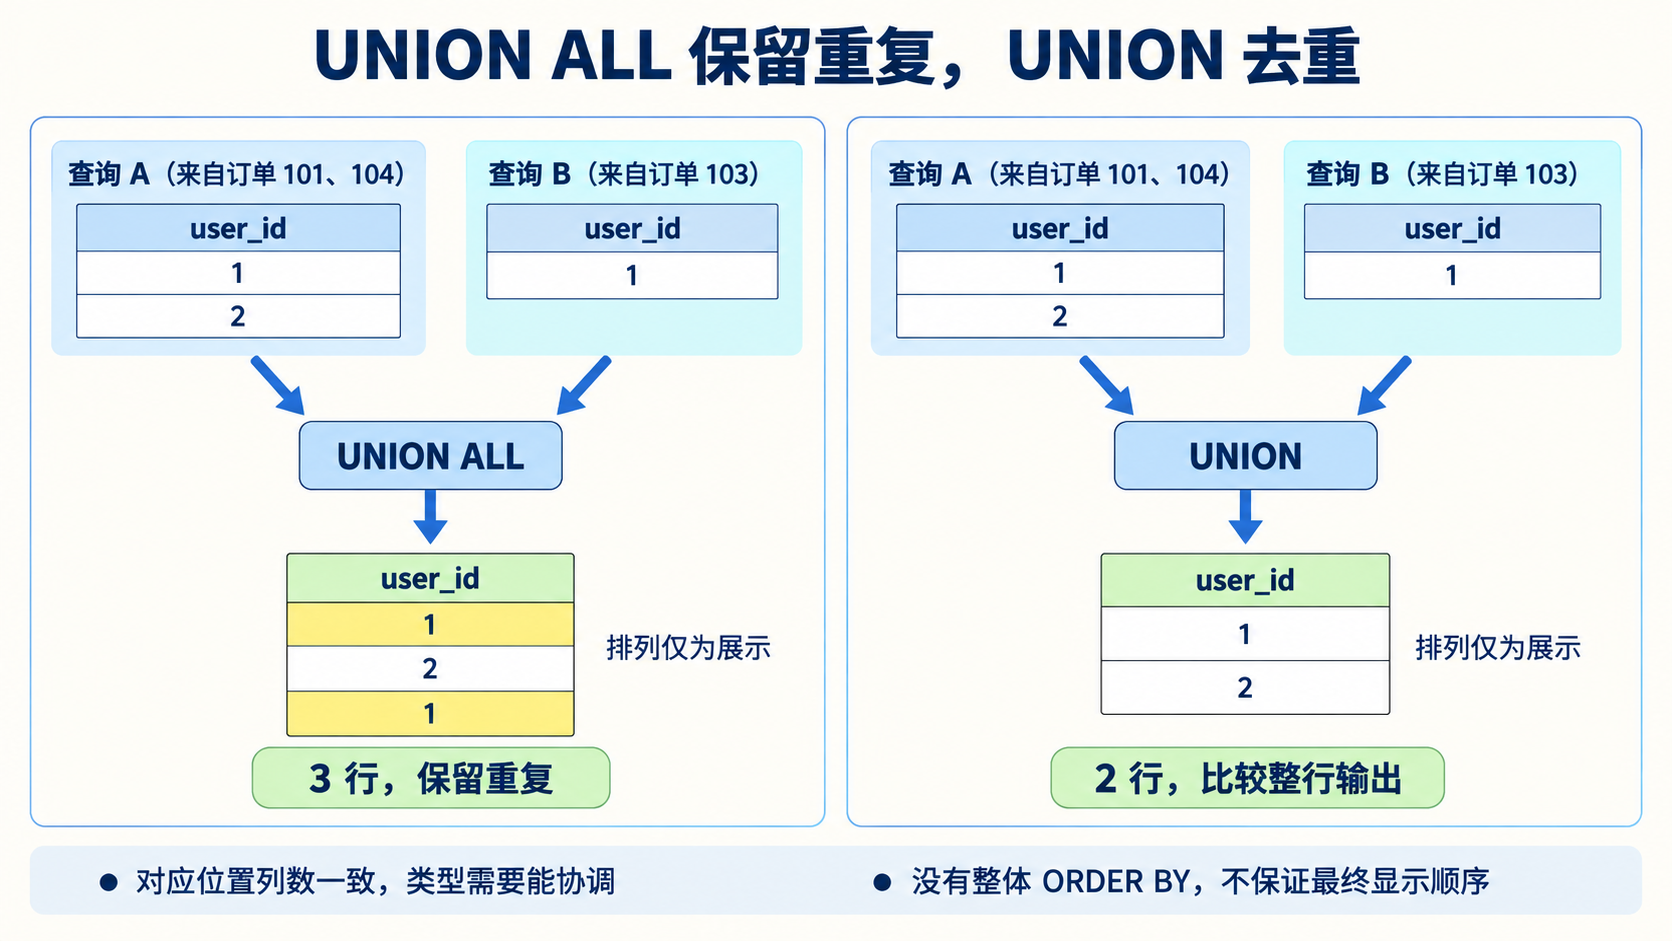
合并同样的两份输出,比较保留三次出现与去重为两个值,图中排列不代表默认输出顺序。
使用条件与代价
两侧列数必须一致,对应位置的类型需要能协调。比较重复时比较整行输出,而不是来源表中的主键。去重需要额外处理,UNION ALL 通常更省,但如果业务要求用户只出现一次,就不能为了性能省掉去重。
若需要整体排序,可在最后写 ORDER BY;若对子查询分别排序和 LIMIT,需要使用括号表达各自范围,不能以为前一部分排序会自动决定最终顺序。
对应列是按位置协调,不会因为两边列别名相同就自动重排。例如两边都输出“用户编号、状态”可以按这个顺序合并,不能一边输出这两列,另一边却颠倒位置,再期待数据库按名称替你匹配。去重还受输出类型与比较规则影响;避免为了凑列数而把无关数据强行放在同一列。官方:集合操作的去重与排序
例如要把本月活跃用户和上月活跃用户合成一份联系人名单,可能需要 UNION;要统计两个月一共出现多少次活动,则可能要保留重复。先问是否保留同一对象的多次出现,比单纯背哪个更快更重要。
面试回答
UNION 和 UNION ALL 都按行合并查询结果,前者对整个输出行去重,后者保留所有出现。对应列按位置协调,列数必须一致、类型需要兼容,不是按列名自动匹配。只输出 user_id 时,来自不同订单的相同用户编号仍会被 UNION 合并。业务允许重复时 UNION ALL 可以省去去重工作,但不能为了性能改变结果语义。需要确定整体顺序,应在合并结果上明确 ORDER BY。
10. JOIN 是什么?各种连接有什么区别?
相关问法:内外连接、自连接、全连接。|示例依赖:users、orders。
一句话理解与用途
JOIN 按关联条件把多个表的行组合到一个结果中。拆表让用户资料与订单独立维护,连接则让我们查询“谁下了什么订单”,不必把姓名重复写进每个表。
表中的 user_id 是关联值;ON 指定怎样认为两行匹配。若一个用户有三笔订单,该用户在连接结果中会出现三次,这不是数据库莫名重复,而是一对多关系的展开。
用三位用户理解连接
统一数据中,Alice 有订单 101~103,Bob 有 104,Carol 没有订单。
SELECT u.id, u.name, o.id AS order_id
FROM users AS u
LEFT JOIN orders AS o ON o.user_id = u.id
ORDER BY u.id, o.id;
这会产生五行:Alice 三行、Bob 一行、Carol 一行且 order_id 为 NULL。把 LEFT 改为 INNER,Carol 就不出现。
| u.id | u.name | LEFT JOIN 的 order_id | INNER JOIN 是否保留 |
|---|---|---|---|
| 1 | Alice | 101 | 是 |
| 1 | Alice | 102 | 是 |
| 1 | Alice | 103 | 是 |
| 2 | Bob | 104 | 是 |
| 3 | Carol | NULL | 否 |
JOIN 的计算对象是行组合:Alice 的一行用户资料分别与三行订单满足 ON 条件,所以形成三个组合。LEFT 中的“保留左侧全部行”是保证每个左侧对象不会仅因没有匹配而消失,不是保证输出行数等于左表行数。若两边关联值都出现多次,组合数量还可能相乘,需要先理解业务关系再判断是否出现非预期重复。
| 写法 | 核心语义 |
|---|---|
| INNER JOIN | 仅返回满足关联条件的组合 |
| LEFT JOIN | 保留左侧全部行,右侧不匹配时补 NULL |
| RIGHT JOIN | 对称地保留右侧全部行 |
| CROSS JOIN | 构造笛卡尔积;无约束时 3 位用户乘 4 笔订单是 12 行 |
| 自连接 | 同一张表用不同别名参与连接,仍使用上述连接类型 |
自连接可用于员工与经理、订单与替代订单等自引用关系。它不是另一个 SELF JOIN 关键字,而是同一个表被当成两个角色。
例如在 orders 上用两个别名 a、b,连接条件为 a.user_id=b.user_id AND a.id<b.id,可找同一用户不同订单的配对。用户 1 的三笔订单形成 (101,102)、(101,103)、(102,103) 三对;小于条件避免自己配自己及正反重复。两个别名不是复制两张持久化表,只是查询中的不同角色。
配图:INNER 与 LEFT JOIN:是否保留未匹配用户
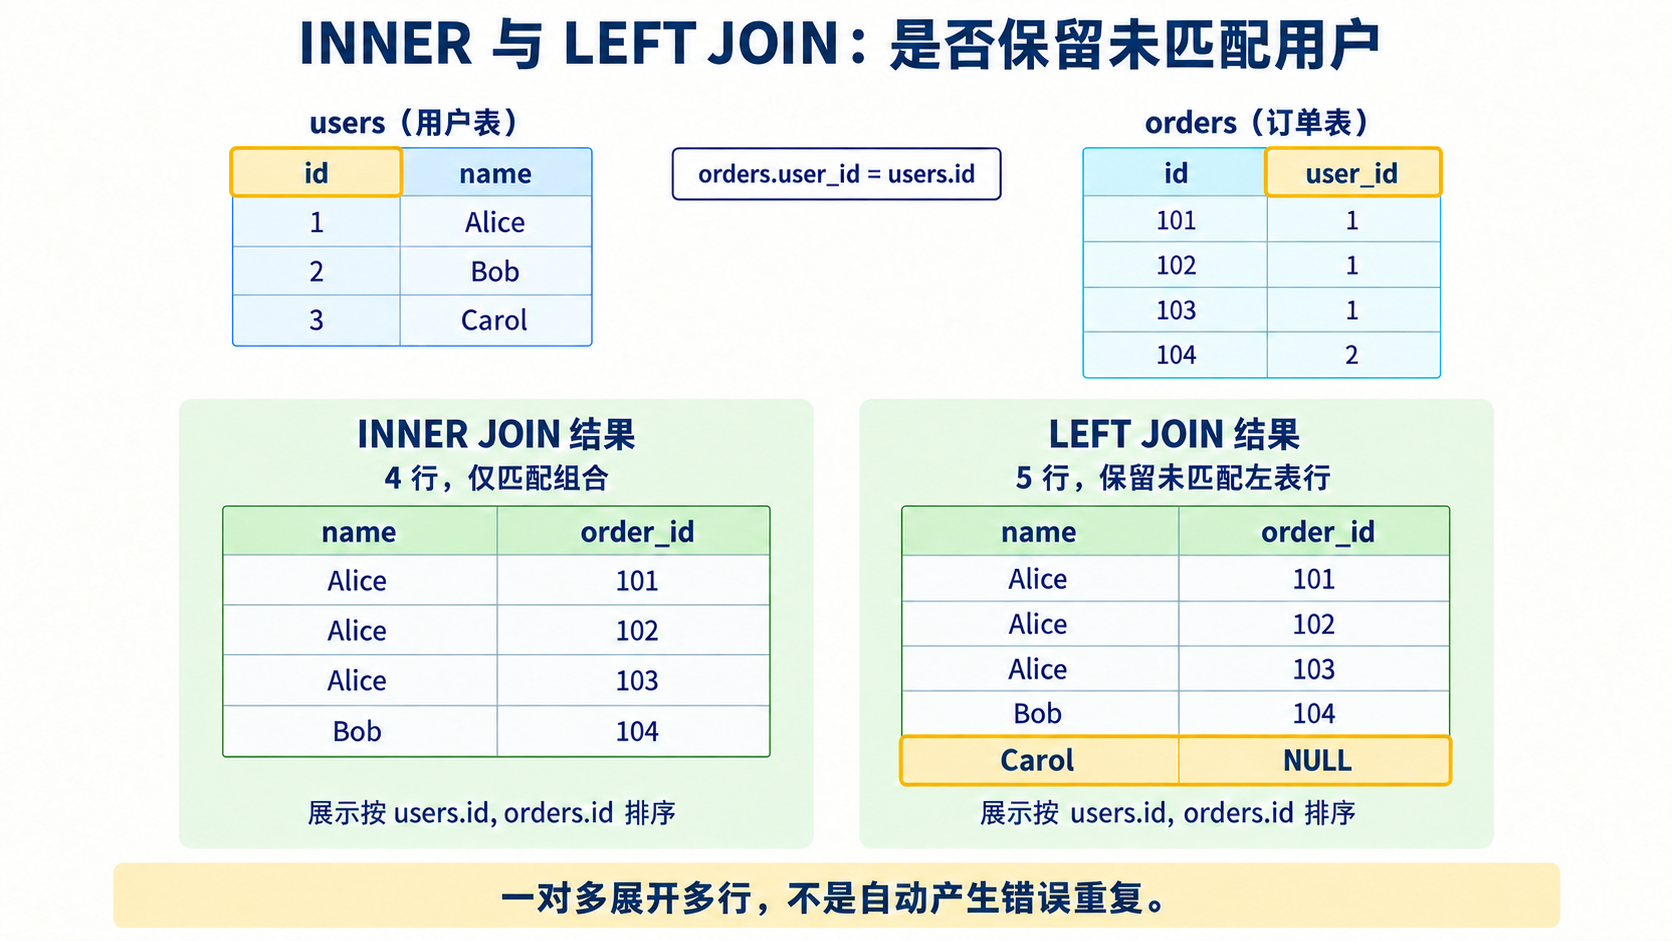
直接展示 INNER 的四行与 LEFT 的五行,解释 Alice 的多行展开和 Carol 的补 NULL 行。
ON 与 WHERE 的位置会改变结果
要保留所有用户、但只显示已支付订单,应把支付条件写在 ON 中:
SELECT u.id, o.id AS order_id
FROM users AS u
LEFT JOIN orders AS o
  ON o.user_id = u.id AND o.status = 'paid'
ORDER BY u.id, o.id;
如果改为 WHERE o.status = 'paid',Carol 的补 NULL 行无法满足条件,会被过滤掉。外连接因此在这个条件下产生类似内连接的结果。
对应的完整写法如下,唯一改变是支付条件的位置:
SELECT u.id, o.id AS order_id
FROM users AS u
LEFT JOIN orders AS o ON o.user_id = u.id
WHERE o.status = 'paid'
ORDER BY u.id, o.id;
可以用相同数据核对两个结果:
| 支付条件的位置 | 按 u.id、o.id 排序后的结果 | 行数 |
|---|---|---|
| ON 中 | (1,101)、(1,103)、(2,104)、(3,NULL) | 4 |
| WHERE 中 | (1,101)、(1,103)、(2,104) | 3 |
ON 中放 paid,表示“只把已支付订单视为右侧匹配”:Alice 已有两条匹配,所以不再额外补 Alice/NULL;Carol 没有匹配,保留一条 NULL 行。WHERE 中放 paid,则先构造 LEFT JOIN 结果,再筛掉 pending 订单和 Carol 的补 NULL 行。NULL = 'paid' 的判断结果是 UNKNOWN,不是 TRUE;WHERE 只留下条件为 TRUE 的结果。这个结论只针对此类排除 NULL 的条件,不是任意 WHERE 都会把外连接变成内连接。官方:JOIN 语义、NULL 的处理
配图:LEFT JOIN:条件放 ON 与 WHERE,结果不同
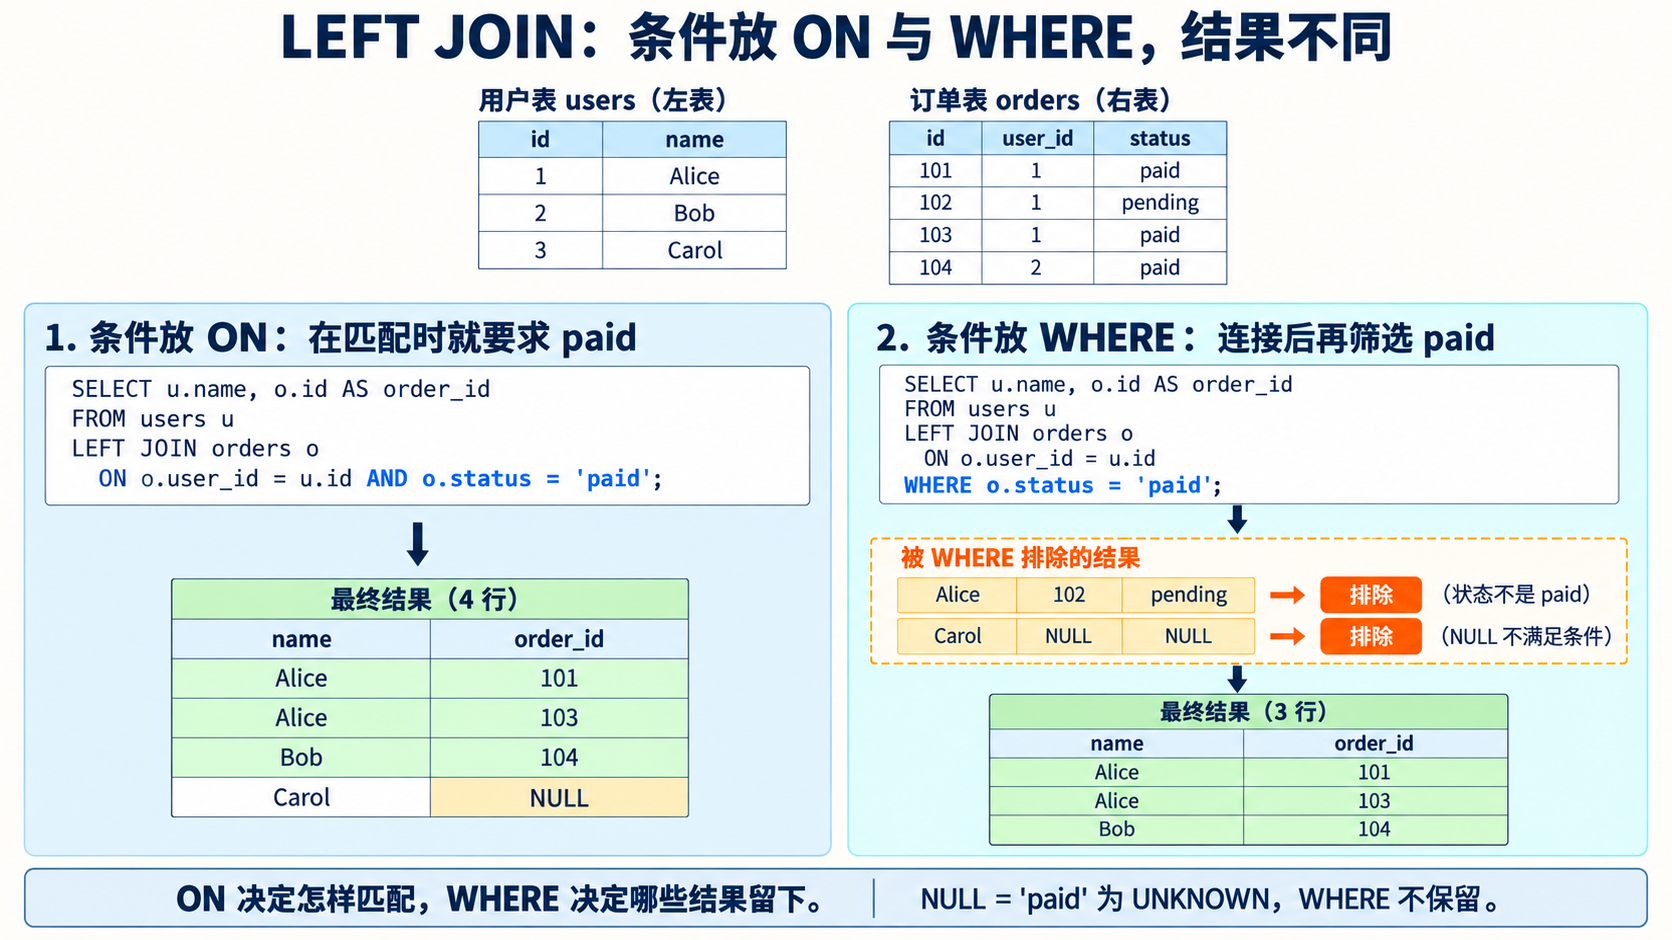
在同一份用户与订单数据上,比较 ON 保留 Carol 与 WHERE 排除补 NULL 行的过程。
适用边界
MySQL 8.0/8.4 没有直接的 FULL OUTER JOIN。需要模拟时,思路是“左连接结果 UNION ALL 右侧未匹配结果”,后半部分用左表非空主键判断未匹配,避免重复计入匹配行。直接把两个完整外连接 UNION 起来可能误删业务上应保留的相同行。
连接条件是否有索引、匹配多少行会影响性能;但不能说所有连接都会先完整生成笛卡尔积。优化器可能采用索引查找或其他连接算法。
面试回答
JOIN 按条件组合多表记录,一对多关系可以让一个用户展开成多行。INNER 只保留匹配组合;LEFT、RIGHT 保留指定一侧的未匹配行,并在另一侧补 NULL;CROSS 构造笛卡尔积,自连接只是同表以不同别名参与查询。外连接中 ON 决定匹配,WHERE 再过滤结果,本例 WHERE o.status='paid' 会排除 Carol 的补 NULL 行。MySQL 8.0/8.4 没有直接的 FULL OUTER JOIN,模拟时要避免重复匹配行和错误去重。
11. LIKE 和 REGEXP 分别适合什么查询?
相关问法:% 与 _、正则匹配。|示例依赖:users;字面量示例不依赖表。
概念与用途
LIKE 适合简单通配匹配,REGEXP 适合更复杂的模式,例如编码是否符合格式。前者规则少、容易读懂;后者表达力强,但应控制扫描范围和表达式复杂度。
SELECT name FROM users WHERE name LIKE 'Al%';
SELECT 'A_01' LIKE 'A!_%' ESCAPE '!' AS matched;
SELECT 'P123' REGEXP '^P[0-9]{3}$' AS valid_code;
第一个结果为 Alice;后两条为 1。LIKE 中 % 表示零个或多个字符,_ 表示恰好一个字符。要匹配真正的下划线或百分号,可以显式设置转义字符,避免反斜杠与 SQL 模式造成理解歧义。
REGEXP 中 ^ 表示开头,$ 表示结尾,[0-9]{3} 表示三个数字。没有首尾约束时,模式可以匹配文本中的某个片段,不等于检查整串是否完全符合规则。
沿字符串逐段判断
Al% 要求先有 Al,后面的字符可以没有,也可以有多个,所以 Alice 匹配,Bob、Carol 不匹配。%li% 则允许 li 前后出现任意长度内容,Alice 中的 li 因而匹配。_ 是一个字符的占位符,不是字面量下划线;A!_% ESCAPE '!' 先匹配 A,再把 !_ 解释成真正的下划线,最后由 % 接收 01,因此 A_01 匹配。不要把字符个数等同于 UTF-8 字节数。
| 待检查字符串 | REGEXP '^P[0-9]{3}$' 的结果 | 原因 |
|---|---|---|
| P123 | 1 | P 后面恰好三个数字 |
| XP123 | 0 | 开头不是 P |
| P12 | 0 | 数字不足三个 |
| P1234 | 0 | 三个数字后还有内容 |
这些输入均为不带换行的普通编码字符串,用来解释开头、结尾和重复次数。真实格式校验还需明确允许字符、长度和输入规范,不应把一段正则当成所有业务规则。
配图:LIKE 与 REGEXP:匹配目标不同
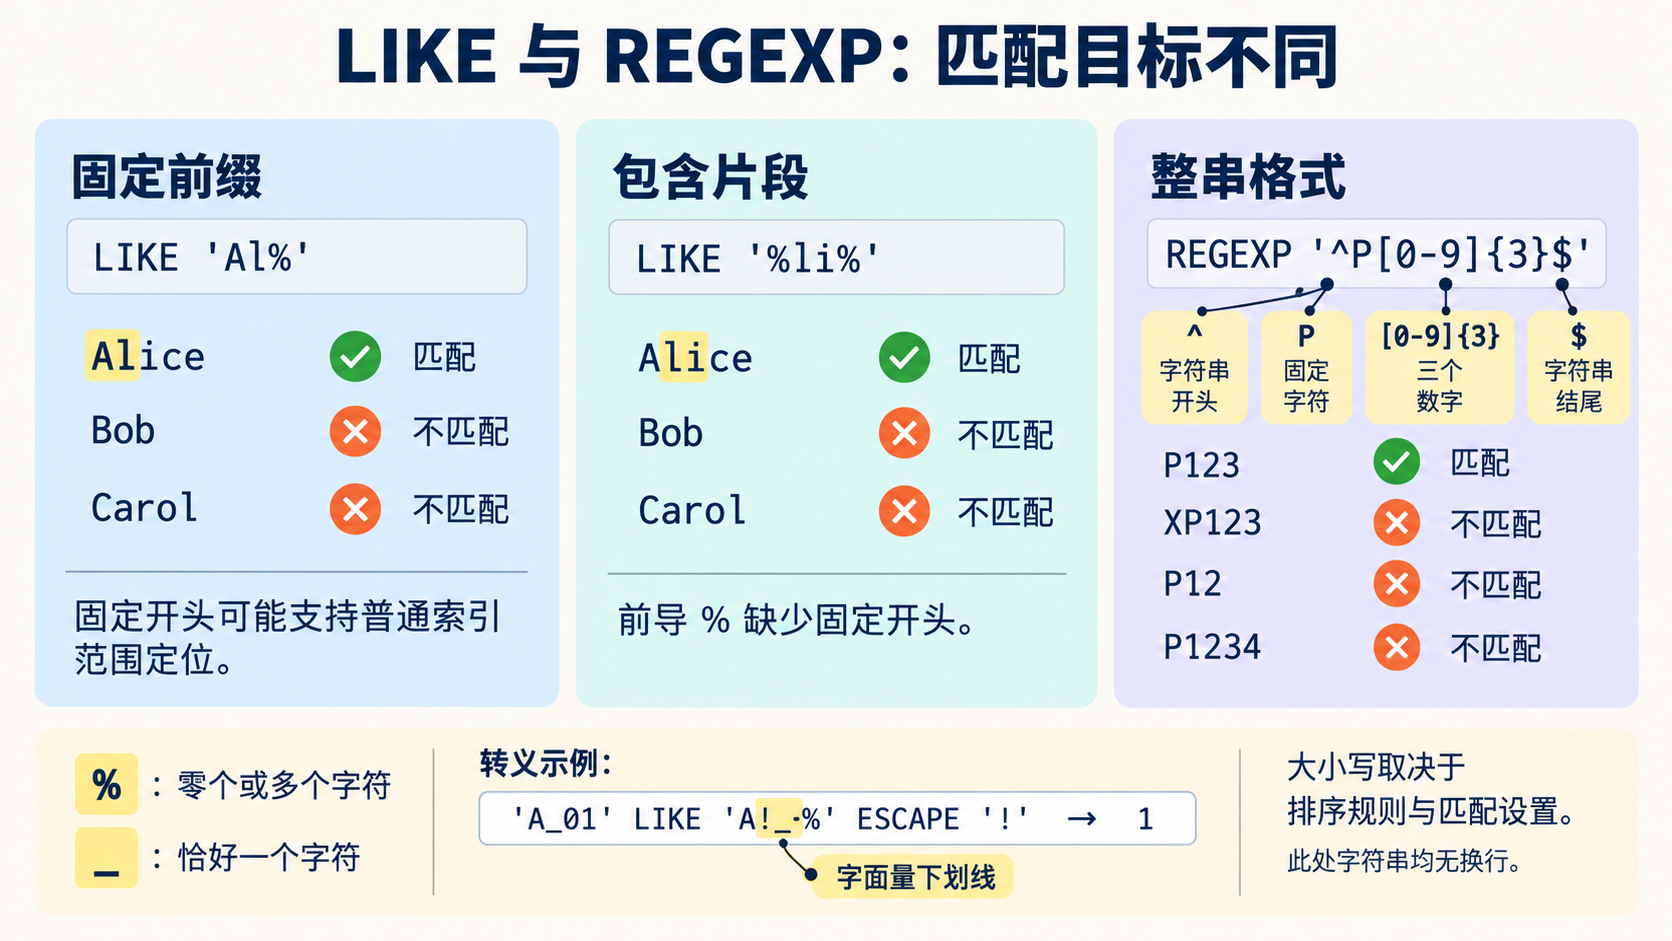
对比固定前缀、包含片段和完整编码格式,并展示字面量下划线的转义规则。
适用边界
字符比较通常受字符集与排序规则影响,不能笼统说 LIKE 或 REGEXP 永远区分大小写。普通 B+Tree 对固定前缀 LIKE 'Al%' 可能形成范围定位;LIKE '%li%' 缺少固定开头,通常不能按同样方式定位,但可能扫描覆盖索引,因此“不能高效定位”与“完全不用索引”不同。正则一般也不能替代普通索引定位。
原因在于普通有序索引按字符串从开头比较:固定 Al 前缀可以帮助限定候选范围;仅知道中间含 li,则不同开头的键都可能匹配,不能只查看一个固定前缀区间。前缀定位后也可能需要进一步检查完整模式。是否采用索引仍取决于比较规则、数据分布和计划;三行 users 的小样本不能证明真实业务性能。官方:LIKE 范围优化
本例初始化使用 utf8mb4_0900_ai_ci,应在该比较规则下解释 LIKE 的大小写行为。MySQL 8.x 的正则由 ICU 支持;需要显式指定正则大小写匹配时,可了解 REGEXP_LIKE 的 match_type 参数,而不是假设所有环境与模式默认相同。官方:正则表达式
面试回答
LIKE 用 % 表示零个或多个字符、_ 表示一个字符,适合简单模式;需要字面量下划线时可显式设置 ESCAPE。REGEXP 表达更复杂的模式,本例用 ^P[0-9]{3}$ 检查不带换行的编码是否为 P 加三个数字,片段匹配不等于完整格式校验。大小写需结合排序规则和匹配设置。普通有序索引可以利用固定前缀限定候选,前导通配和正则通常难以同样定位,但不能据此断言完全不使用索引。
阅读导航



