AI数字人项目介绍
2026/10/6大约 4 分钟
AI数字人项目介绍
在AI时代,在复杂业务场景下,使用C++构建一个高并发、低延迟、无损画质以及音画同步的数字人底层引擎具有一定挑战。本项目从基础开始构建实时数字人系统。
项目背景
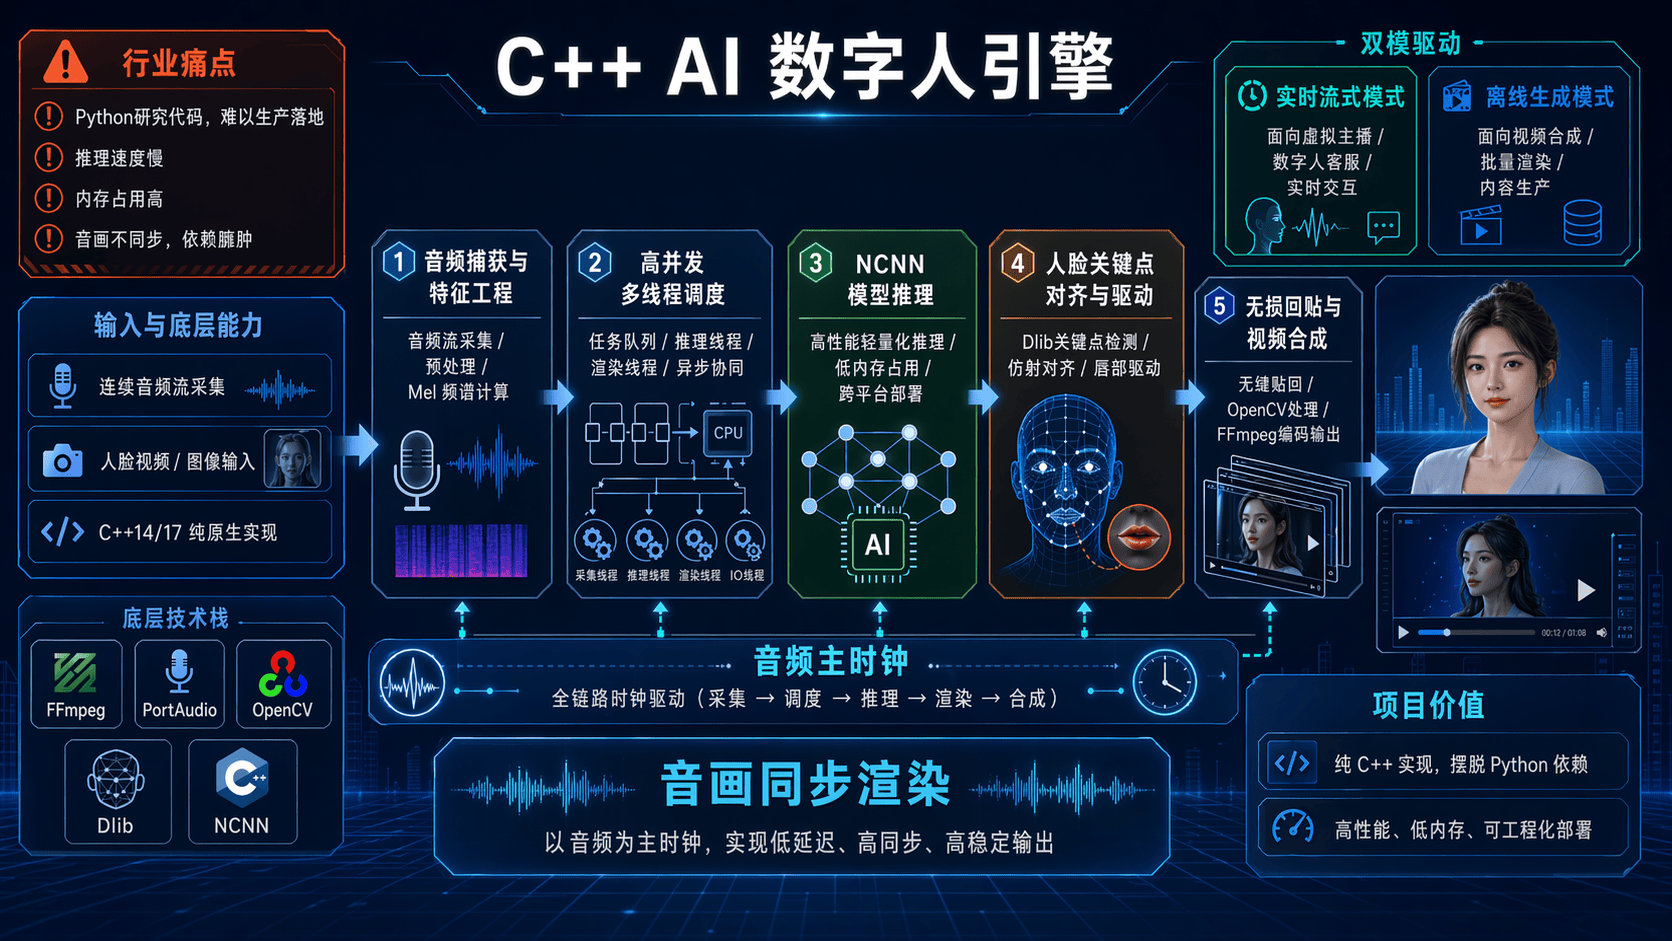
随着人工智能技术的爆发,AI 虚拟主播、数字人客服等应用场景层出不穷。然而,市面上大多数开源项目(如原版 Wav2Lip)均是基于 Python 编写,推理速度慢、内存占用高、音画不同步、环境依赖极其臃肿,无法直接应用于高效生产环境中。
本项目采用纯C++编写,底层融合了FFmpeg、OpenCV、Dlib以及NCNN深度学习推理框架。
核心知识点
多线程并发系统架构
- Pimpl:隔离底层第三方库依赖,实现快速编译与接口隐藏
- 高并发调度:基于
std::mutex与std::condition_variable构建带超时的线程安全队列 - 生产者-消费者模型:音频拉取、特征提取、模型推理以及视频渲染四个独立线程的生命周期与异常状态管理
基于NCNN的深度学习模型推理
- C++集成NCNN推理框架与Vulkan GPU加速
- Tensor空间转换:图像 BGR 与 RGB 的色彩空间转换、多通道张量(6通道输入)的内存拼接、均值与方差归一化计算
- 音频特征 Tensor 与视觉特征 Tensor 的联合输入策略
音频信号处理
- PCM 数据解封装:通过 FFmpeg (
libavformat,libswresample) 读取任意格式音频并重采样 - 时频域转换:汉明窗 (Hamming Window) 预加重处理,以及基于 OpenCV
dft的离散傅里叶变换 - Mel 频谱特征工程:梅尔滤波器组(Mel Filterbanks)构建、幅度谱计算、20*log10 分贝转换与静音阈值截断
计算机视觉(Opencv、Dlib)
- 面部关键点追踪:基于 Dlib 的 68 点高精度人脸五官定位
- 仿射变换机制 :计算双眼旋转矩阵,将人脸精准缩放至 96x96 标准模型输入空间
- 逆仿射与无损回贴:利用逆矩阵将生成的嘴巴等比例、无损地镶嵌回原高清背景图
- 边缘平滑算法:多边形掩码生成、形态学膨胀、高斯模糊实现人脸无缝融合
音画同步机制
- 以音频主时钟为主
- 基于
PortAudio的高优先级底层硬件回调统计played_samples计算绝对时间戳 - 构建抖动缓冲(
Jitter Buffer)与Frame Scheduler对不同的情况分别处理,比如丢帧追赶与阻塞等待的同步状态机
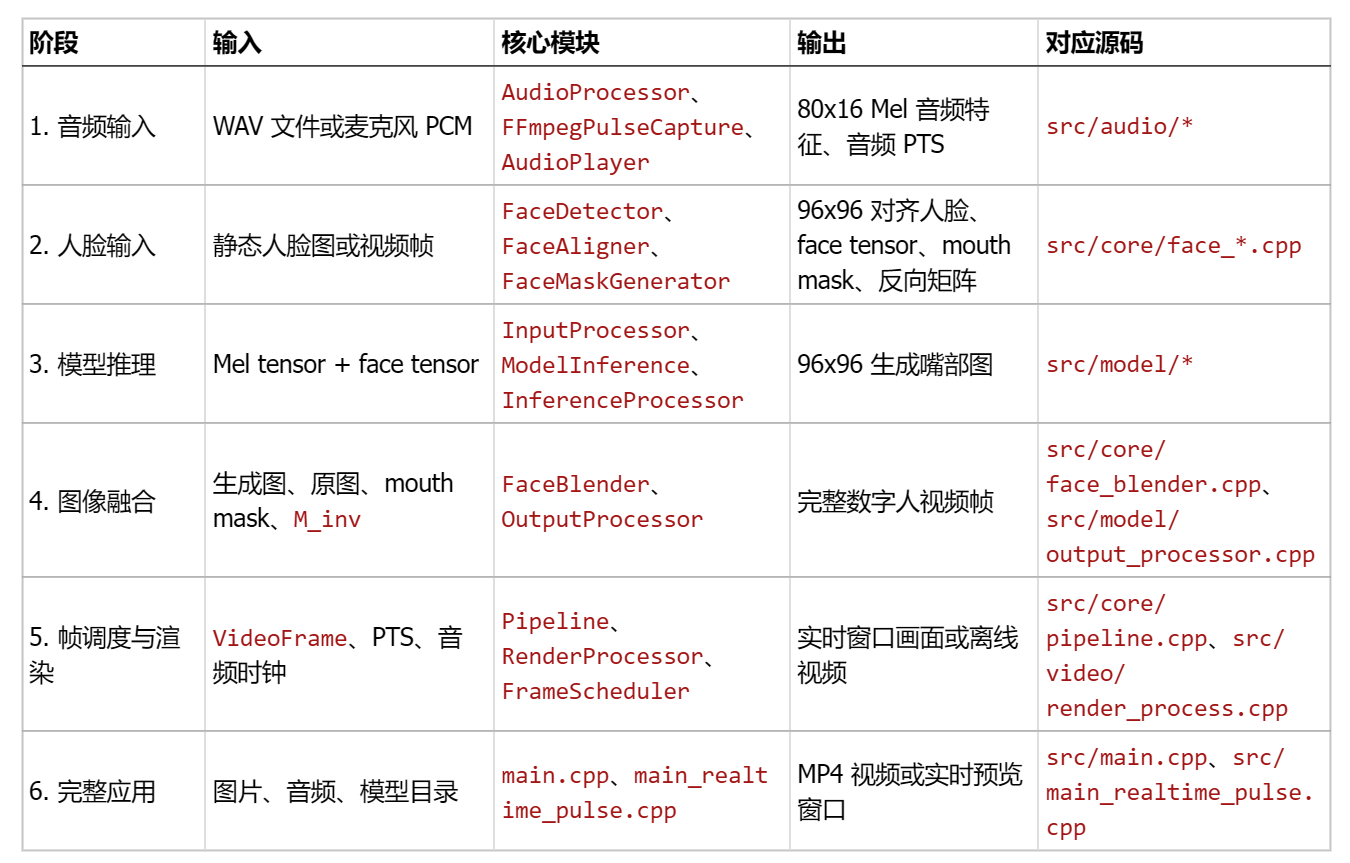
项目整体数据流
能学到哪些技术?
音视频底层编解码与驱动开发
主要使用FFmpeg与PortAudio,重点集中在两个方面:
- 使用
FFmpeg底层API(libavformat、libavcodec、libswresample)等,可以掌握AVPacket与AVFrame的生命周期管理,实现音频的解封装、解码与 16kHz 目标采样率重采样。 - 利用
PortAudio编写高优先级实时硬件回调函数paCallback,可以直接向声卡底层喂PCM数据,并基于played_samples提取硬件绝对时间,实现系统主时钟
C++内存管理与性能优化
- 使用Pimpl设计模式,编写接口
- 零拷贝与移动语义:使用
std::move与右值引用,降低矩阵cv::Mat的深拷贝开销 - 使用智能指针
std::unique_ptr配合RAII机制,处理内存泄漏与野指针等常见问题
深度学习推理框架部署
- 掌握基于NCNN的深度学习推理框架的部署,使用C++部署深度学习模型,比如
Wav2Lip与MuseTalk - Tensor张量的转换:深入理解神经网络的输入输出机制,手动处理图像色彩空间转换(比如区分OpenCV的BGR与模型使用的RGB空间),掌握多通道的张量拼接与数据归一化处理
- 掌握如何开启Vulkan GPU硬件加速,配置FP16半精度推理与内存轻量化模式。还会涉及到模型预热、生命周期的管理等