
C++ 枚举与命名空间:enum class 和名字归属
11 枚举和命名空间:给值和名字划边界
随着程序规模的增长,代码中需要管理的名字和状态会越来越多。分数等级、订单状态、菜单命令,这些值本来就属于一组固定选项;工具函数、业务函数、测试函数,这些名字也需要有清楚的归属。
枚举解决固定值集合的问题,命名空间解决名字归属的问题。
本章的核心判断只有两条:
- 枚举:给一组合法值划边界
- 命名空间:给一组名字划边界
这两个工具本身不复杂,但它们决定了代码能不能长大。在一个小程序里,用int status = 2;表示状态、直接写一个Print()函数也能跑。但项目变大后,状态越来越多,函数名越来越多,读者需要更明确的边界。枚举把"哪些值合法"写进类型,命名空间把"这个名字属于哪里"写进代码结构。
用整数表示状态容易写错
先看一个用 int 表示订单状态的例子:
int status = 2;
这行代码本身很难读。2 是已支付、已发货,还是已取消,需要读者去找文档或注释。
可以加常量:
const int kPending = 1;
const int kPaid = 2;
const int kShipped = 3;
const int kCancelled = 4;

int status = kPaid;
可读性好了一点,但 status 仍然只是 int。这意味着,理论上你仍然可以写:
status = 999;
编译器很难知道这是非法状态。对于需要约束取值范围的场景,更适合的工具是枚举。
用整数表示状态最大的问题,是它把业务含义藏起来了。2 对编译器只是一个普通数值,对读者也只是一个数值,读者必须额外记住"2 代表 paid"。这类隐含约定越多,代码越容易出现状态错用。枚举的作用,就是把这些约定从注释里搬进类型系统中,让编译器帮忙检查。
这类直接出现在代码里的数字常被称为魔法数字。它们的危险不在于数字本身,而在于数字背后的含义没有在代码结构里体现——status == 2 看上去像普通的整数比较,读者需要额外知道它的业务含义。常量能改善名字问题,但状态变量仍然是整数。枚举继续往前走一步:让状态本身变成一个独立类型。
枚举把固定选项收成一个类型
在现代 C++ 中,优先使用 enum class:
enum class OrderStatus {
  kPending,
  kPaid,
  kShipped,
  kCancelled,
};
OrderStatus 是一个独立类型,它的合法值集中在大括号里。定义变量时:
OrderStatus status = OrderStatus::kPaid;
读者能直接看到两点信息:status 是订单状态,并且只能从这组状态里选择。
enum class 的枚举值必须通过类型名访问:
OrderStatus::kPending
OrderStatus::kPaid
OrderStatus::kShipped
OrderStatus::kCancelled
这让名字边界更清楚。kPaid 属于 OrderStatus,使用时写完整范围,读者不会把它和别处的同名 kPaid 混淆。
可以写成: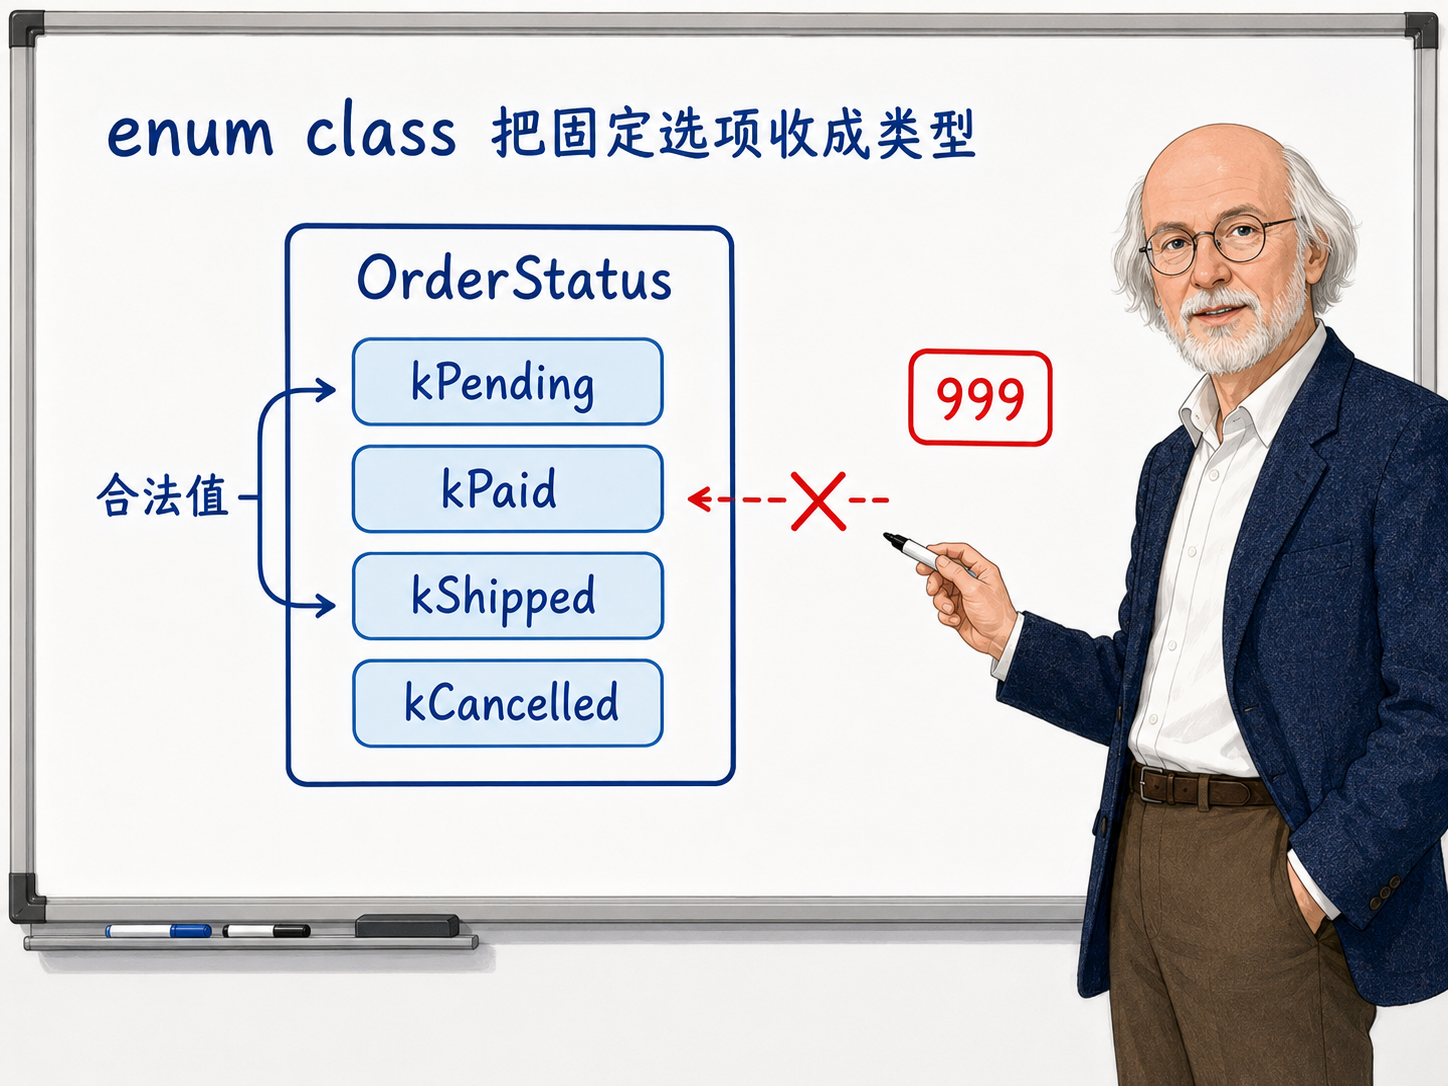
通过枚举,状态从"普通整数"变成了"有边界的独立类型"。
这层边界会直接改善阅读体验。读到 OrderStatus status,你能知道它是订单状态;读到 OrderStatus::kPaid,你能知道它是订单状态集合里的合法值。代码不再依赖读者去记魔法数字——状态越多,枚举带来的清晰度提升越明显。
枚举还能让函数接口更清楚。比较这两个声明: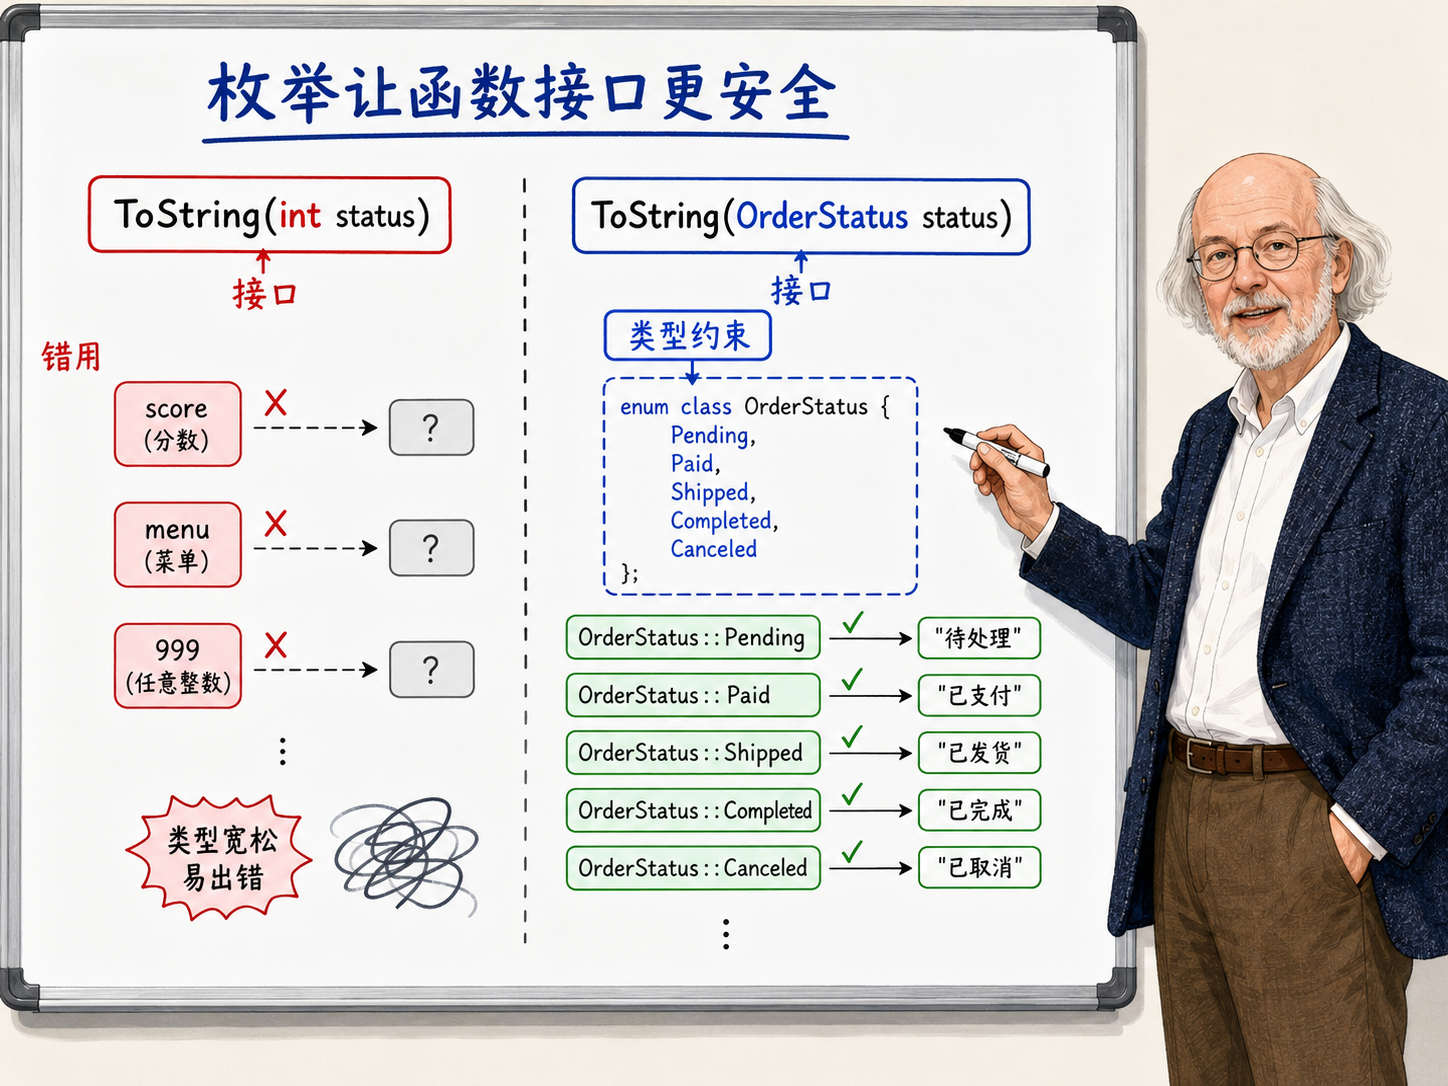
std::string ToString(int status);
std::string ToString(OrderStatus status);
第一个版本需要一个整数,调用者可能传入任何 int,比如分数或数组下标。第二个版本直接说明需要订单状态,调用者不能随手传入其他数据。类型越贴近业务角色,编译器越能挡住误用。
switch 很适合处理枚举
枚举在实际代码中经常和 switch 搭配。比如把订单状态转成字符串:
#include <string>

enum class OrderStatus {
  kPending,
  kPaid,
  kShipped,
  kCancelled,
};

std::string ToString(OrderStatus status) {
  switch (status) {
    case OrderStatus::kPending:
      return "pending";
    case OrderStatus::kPaid:
      return "paid";
    case OrderStatus::kShipped:
      return "shipped";
    case OrderStatus::kCancelled:
      return "cancelled";
  }

  return "unknown";
}
switch 的每个 case 都对应一个枚举值,读者能看出这个函数覆盖了哪些状态。以后如果新增一个状态,比如 kRefunded,开发者可以回来检查 switch 是否也需要新增分支。
这种结构比散落的整数判断更稳: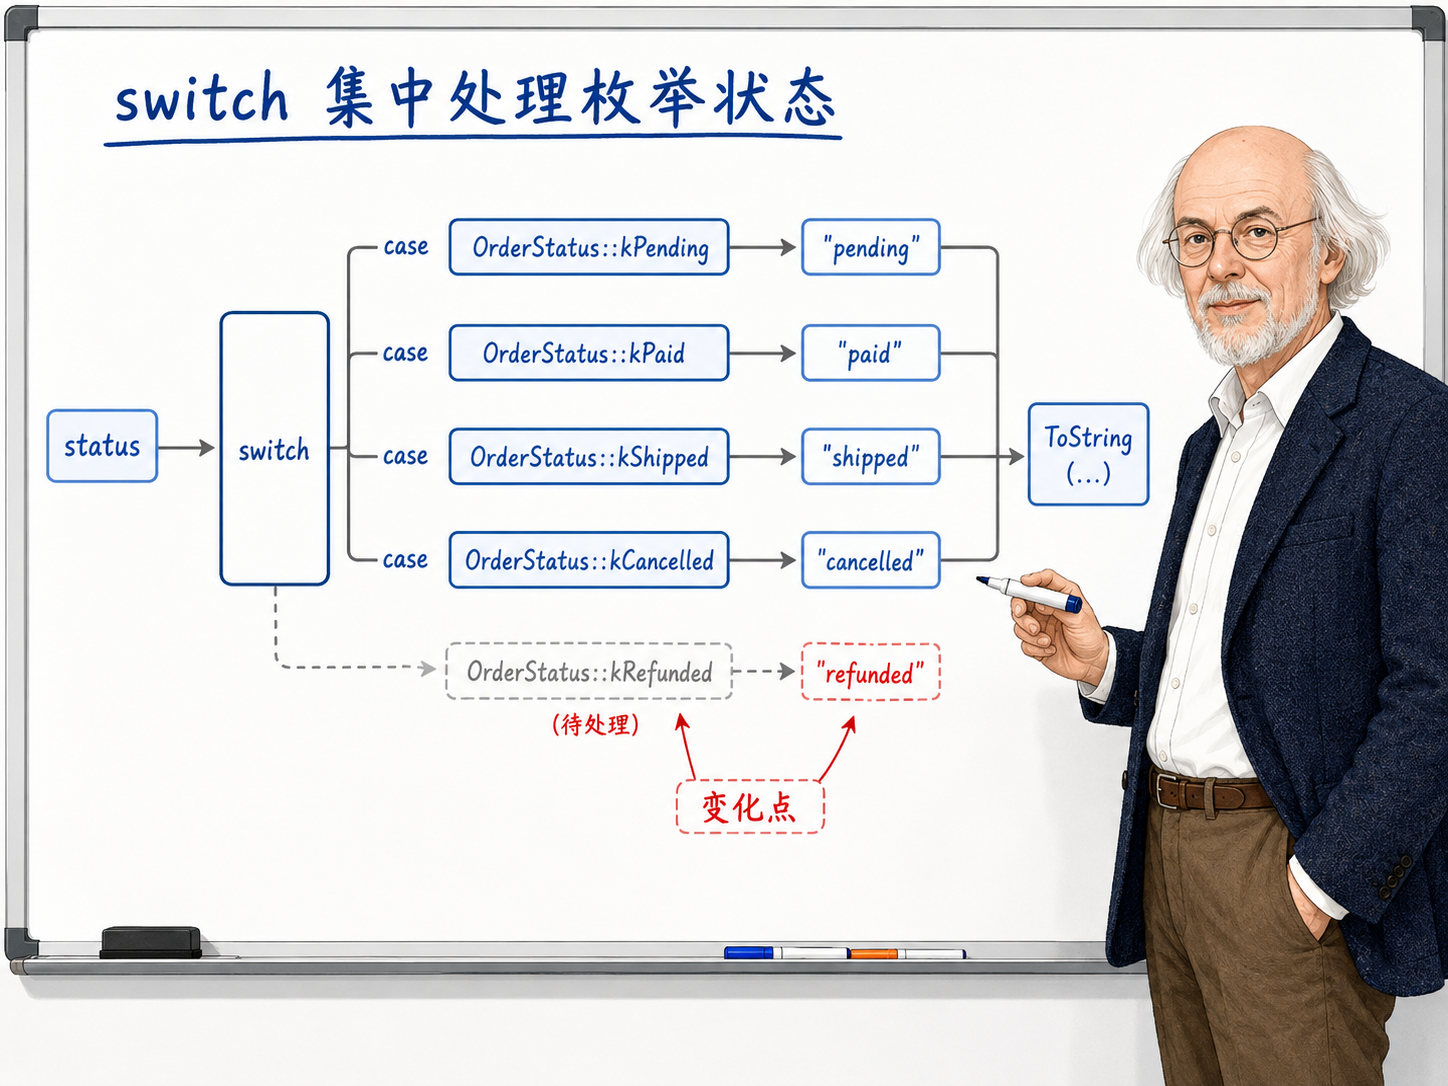
基础阶段可以在 switch 后补一个 return "unknown";,确保函数总有返回路径。在更严格的项目里,还会配合编译器警告来检查枚举分支是否覆盖完整。
switch 和枚举搭配还有一个好处:它把针对同一组状态的处理逻辑集中起来。读者想知道订单状态怎么显示,只需要看 ToString;想知道新增状态会影响哪里,也能顺着 switch 找。相比在代码里到处写 if (status == 2),这种结构更容易维护。
这也给后续修改留下了明确入口——状态集合变了,先看 enum class;状态展示变了,先看 ToString;状态逻辑变了,先看对应的 switch。好代码不是永远不用改,而是改动入口清楚。枚举和 switch 的组合,把固定状态的变化点集中管理起来。
enum class 的边界更清楚
C++ 也有传统 enum:
enum OrderStatusOld {
  kPending,
  kPaid,
};
传统 enum 的枚举值会进入所在作用域,名字边界较弱。enum class 的枚举值则必须通过类型名访问:
OrderStatus status = OrderStatus::kPaid;
这更适合基础阶段建立清晰模型——类型名在左边,合法值挂在类型名下面,读者能看出每个值来自哪一组。
enum class 和整数之间的混用也更少。你不能随手把普通整数当成 OrderStatus 使用,这让状态建模更稳。底层存储类型可以指定,比如 enum class OrderStatus : int,这属于补充知识,本系列先不展开。
基础阶段优先用 enum class 的原因就是边界清楚。传统 enum 更容易把枚举值散布到外层作用域,读者需要额外判断名字来源。enum class 每次使用都带着类型名,虽然多敲几个字符,但换来的是更稳定的阅读模型。
enum class 也减少了不同枚举之间的混用。订单状态里的 kPaid 和支付状态里的 kPaid 在语义上不同。写成 OrderStatus::kPaid 或 PaymentStatus::kPaid,来源一眼可见。工程环境里,多写类型名的成本很小,避免误读的收益很大。
枚举值的名字也要保持语义一致。OrderStatus 下放 kPending、kPaid、kShipped 很自然,因为它们都是订单状态。如果把 kHighPriority 也放进去,语义就混淆了。枚举应该表达一组互斥的合法选项,而不是作为常量的杂物箱。
判断一个枚举是否合适的方法:看这个变量在任意时刻是否只能处于这些状态之一。订单只能处于待支付、已支付、已发货、已取消等状态之一,适合枚举;分数是 0 到 100 的连续数值,不适合用枚举列出每个分数。枚举适合固定集合,范围数值仍用数值类型配合校验逻辑表达。
命名空间让名字有归属
枚举给值划边界,命名空间给名字划边界。
看一个成绩处理相关的工具函数:
namespace grade {

int ClampScore(int score) {
  if (score < 0) {
    return 0;
  }
  if (score > 100) {
    return 100;
  }
  return score;
}

}  // namespace grade
ClampScore 定义在 grade 命名空间里。调用时写:
int score = grade::ClampScore(120);
grade::ClampScore 表示"这是 grade 范围里的 ClampScore"。这和 std::cout 是相同的模式:cout 是 std 命名空间里的名字。
命名空间类似目录前缀: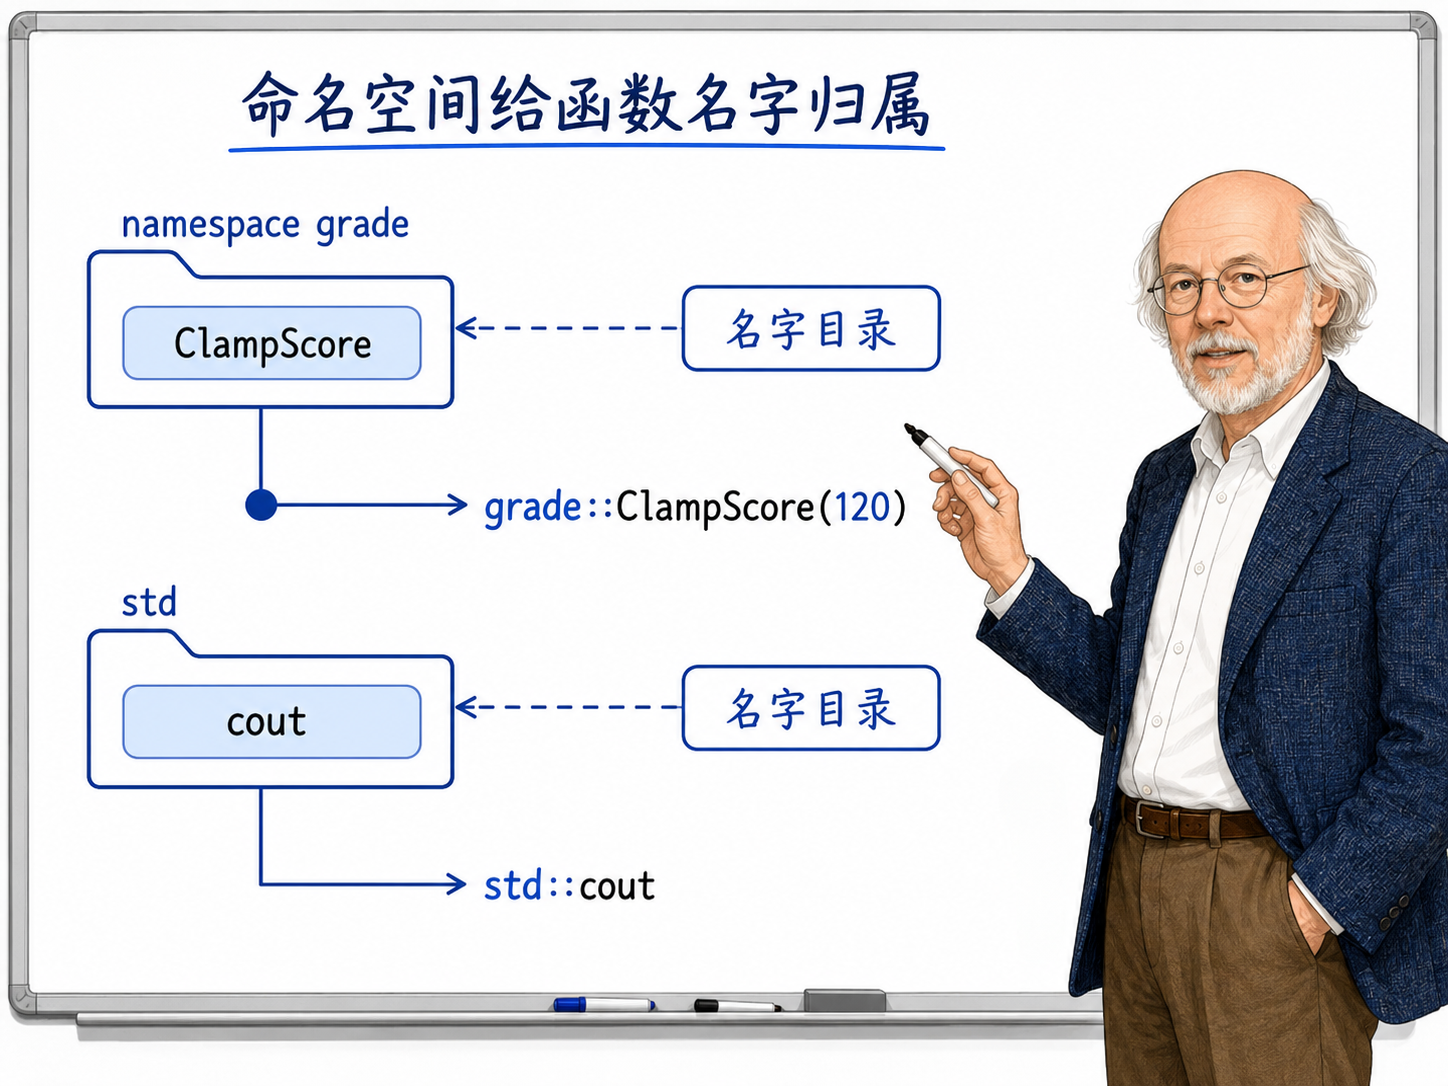
项目变大后,不同模块经常会出现 Print、Parse、Validate 这样的通用名字。命名空间让这些同名函数归属于不同范围,减少冲突,让代码组织更清楚。
命名空间就像代码里的"名字目录"。grade::ClampScore 和 network::ClampScore 可以共存,因为隶属于不同范围。读者看到前缀,就能知道函数来自哪个模块。大型代码库中,函数名本身可能比较短,补充上下文的任务就由命名空间承担。
命名空间不仅仅是防止重名,它还在表达模块边界。grade::ClampScore 说明函数属于成绩模块;std::cout 说明名字来自标准库。项目越大,函数名越倾向于缩短,因为上下文交给了命名空间。合理的命名空间前缀,能让调用点自带来源信息。
基础阶段不要急于使用过深的命名空间层级。grade::ClampScore 已经能表达清楚归属;写成 project::training::score::grade::ClampScore 对小程序反而复杂。命名空间的目标是帮读者定位名字来源。
命名空间也无法替代好的函数命名。grade::Run() 依然含糊,因为 Run 没有传达具体动作;grade::ClampScore() 则清楚很多。前缀说明归属,函数名说明动作,两者配合,调用点的信息才完整。基础代码里,用一层清楚的命名空间,加上具体的函数名就足够了。
命名空间里的名字在逻辑上应该是一组相关能力。成绩模块里放等级枚举、分数校验、转换函数和输出函数,都围绕同一个业务。如果把不相关的工具函数放进同一个命名空间,归属关系就模糊了。命名空间应该帮助读者缩小搜索范围。
:: 是作用域解析
回顾前面用过的 :: 符号:
std::cout
OrderStatus::kPaid
grade::ClampScore
它们遵循的是同一套理解模型: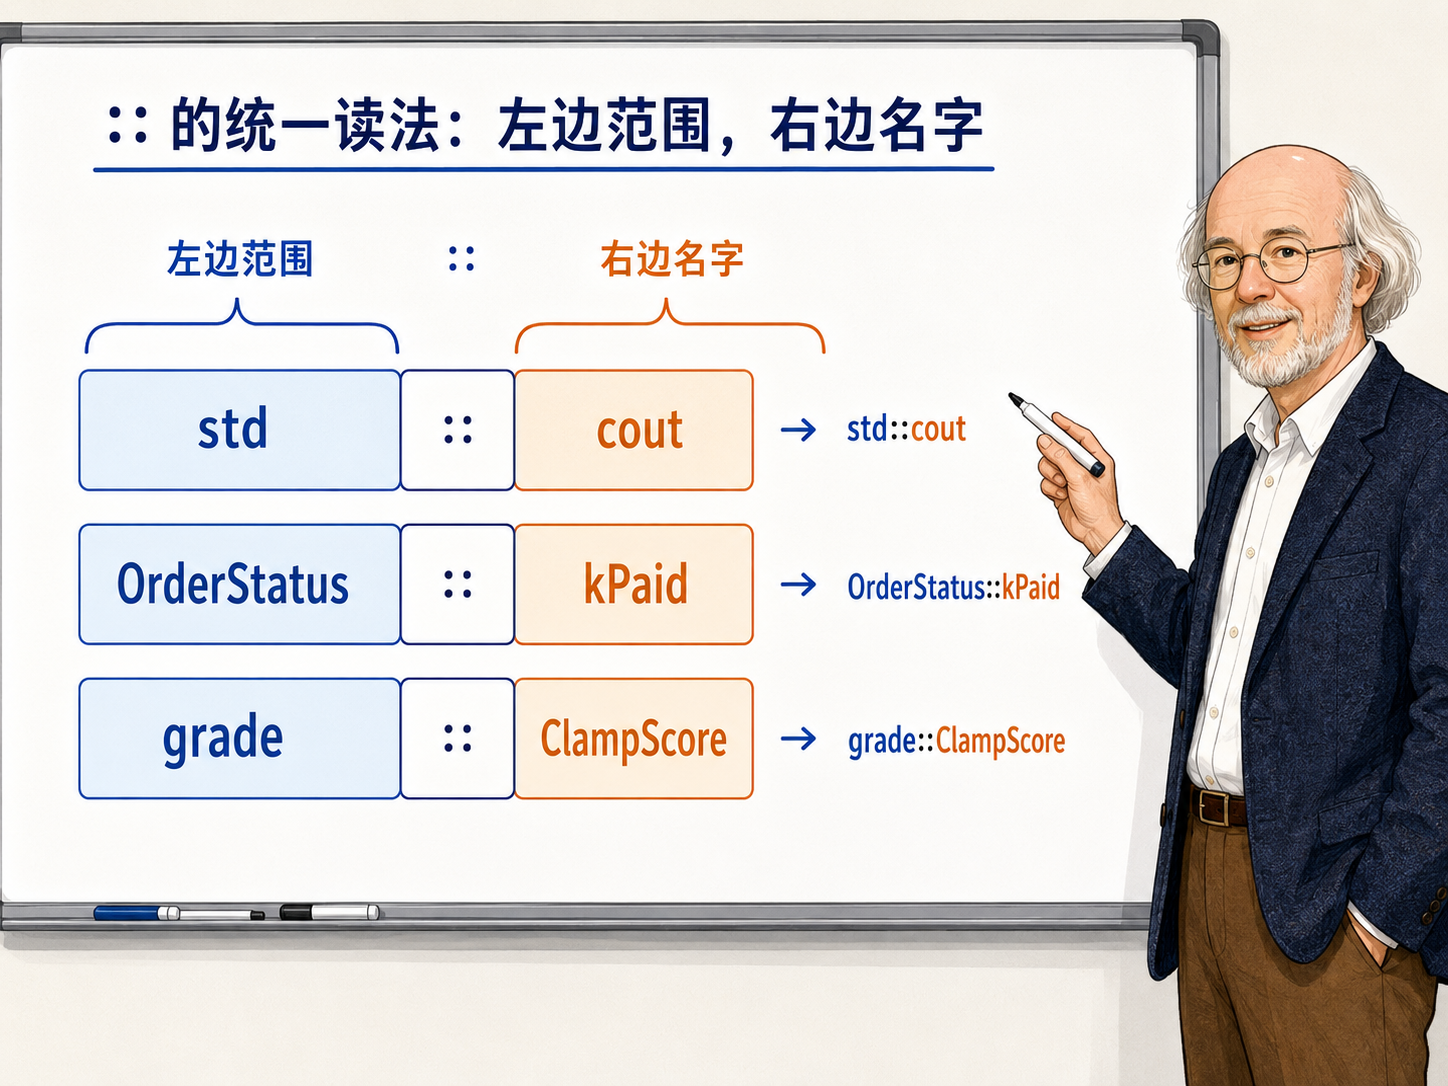
std::cout 指 std 命名空间里的 cout;OrderStatus::kPaid 指 OrderStatus 枚举里的枚举值;grade::ClampScore 指 grade 命名空间里的函数。
建立这个统一理解后,遇到 project::module::Parser、std::vector<int> 这样的写法,可以用同一套模型解读:看到 ::,先看左边的范围,再读右边的名字。它们都在表达名字的归属关系。
:: 的作用就是声明"右边这个名字在左边这个范围里"。范围可以是命名空间、枚举类型,也可以是类。基础阶段先掌握命名空间和 enum class 这两种常见用法,后面学类和静态成员时会自然接上。
正因如此,基础教程中不建议一开始就大量使用 using namespace std;。它能省去写 std::,但会隐藏名字的来源。保留 std::cout、std::string 等完整写法,是为了让读者意识到名字来自标准库。等熟悉命名空间概念后,再根据项目规范判断如何局部使用 using 声明。
局部的 using 声明有时是合理的。比如在一个短函数里写 using std::cout;,可以减少反复输出时的前缀。但基础教程保持完整前缀更有利于建立直觉——std:: 会强化"这个名字来自标准库"的认知。
一个完整示例
下面这段代码把枚举、switch、命名空间和 :: 放在一起:
#include <algorithm>
#include <iostream>
#include <string>

namespace grade {

enum class GradeLevel {
  kExcellent,
  kGood,
  kPass,
  kFail,
};

int ClampScore(int score) {
  return std::max(0, std::min(100, score));
}

GradeLevel GetLevel(int score) {
  score = ClampScore(score);

  if (score >= 90) {
    return GradeLevel::kExcellent;
  }
  if (score >= 80) {
    return GradeLevel::kGood;
  }
  if (score >= 60) {
    return GradeLevel::kPass;
  }
  return GradeLevel::kFail;
}

std::string ToString(GradeLevel level) {
  switch (level) {
    case GradeLevel::kExcellent:
      return "excellent";
    case GradeLevel::kGood:
      return "good";
    case GradeLevel::kPass:
      return "pass";
    case GradeLevel::kFail:
      return "fail";
  }

  return "unknown";
}

}  // namespace grade

int main() {
  int score = 86;
  grade::GradeLevel level = grade::GetLevel(score);
  std::cout << grade::ToString(level) << "\n";
  return 0;
}
在这段代码中,GradeLevel 枚举将成绩等级收拢为一组固定值;grade 命名空间将等级相关的函数组织在一起;grade::GetLevel 和 grade::ToString 的调用方式清楚地说明了来源归属。
阅读这段代码时,重点看三条边界线: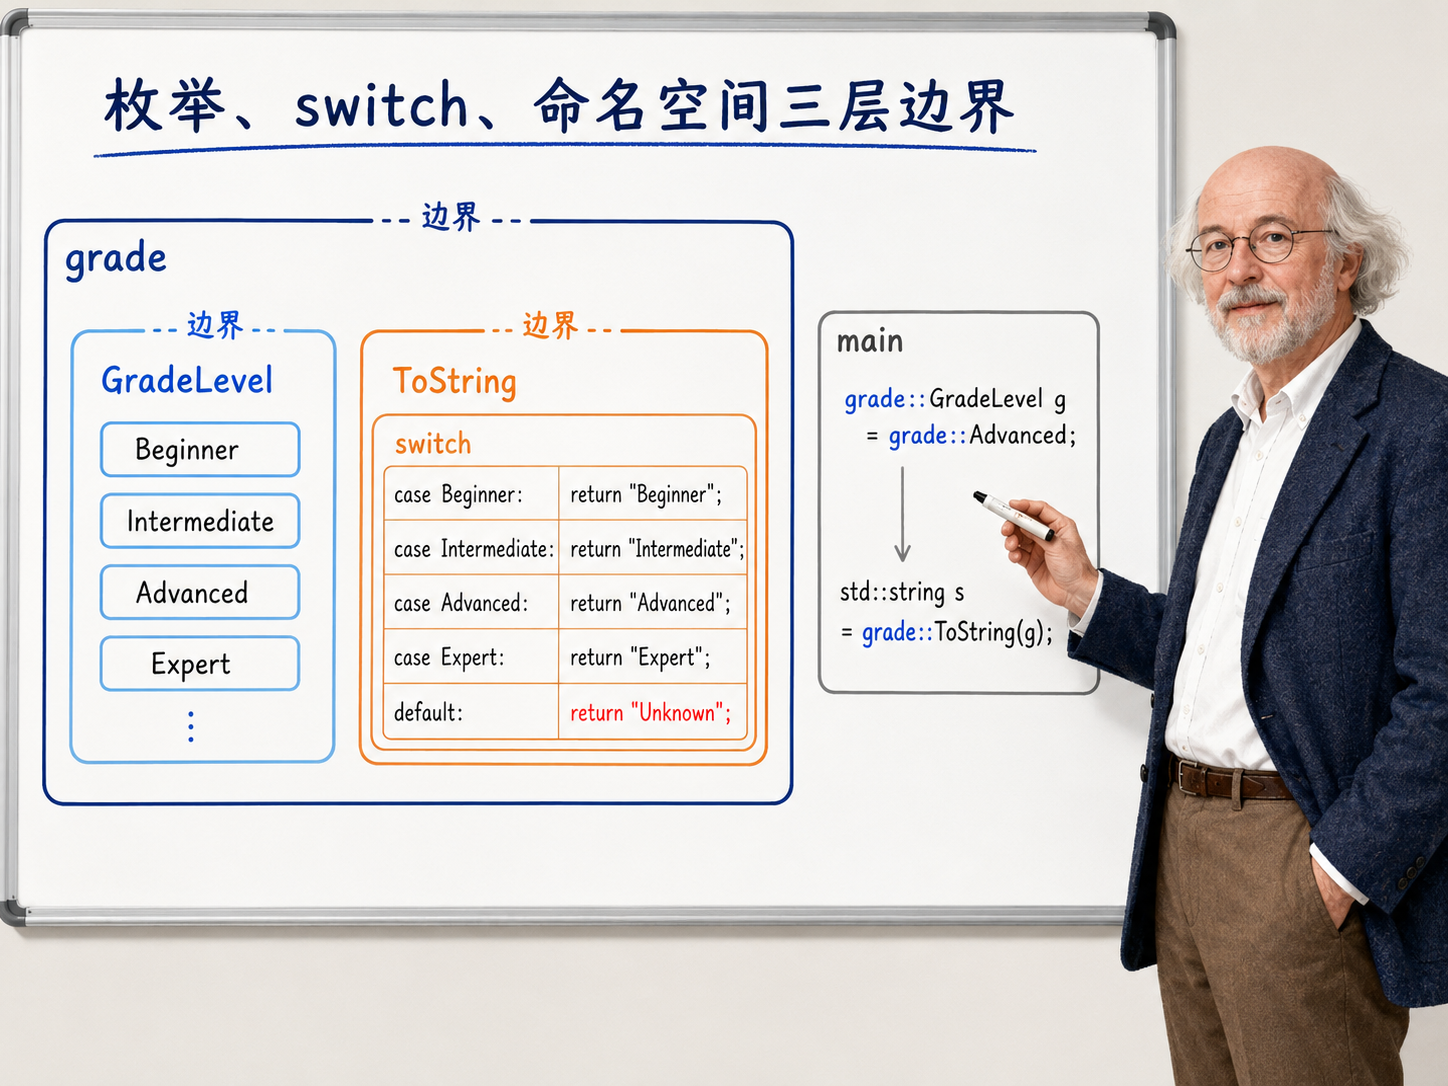
也可以从调用点出发,反向拆解信息传递:grade:: 前缀说明来源,ToString 说明动作,level 说明操作对象。命名空间和函数名配合,调用点就能传达意图信息。
今后在代码中遇到 ::,养成先看左边确认范围、再看右边解读名字的习惯。这个模式不仅适用命名空间和枚举,后续在类、静态成员、嵌套类型和标准库中同样有效。
枚举和命名空间让小程序有了工程代码的基本结构。下一章会把前面的基础语法串联起来:用变量保存数据,用表达式计算,用控制流判断,用函数拆分逻辑,用 const 引用传递参数,用枚举表达状态,用命名空间组织函数。
这一章的核心概念是:状态通过枚举表达,模块名字通过命名空间组织。这种写法会增加一些类型名和前缀,但能省去阅读者的猜测成本。在基础阶段养成习惯,后面进入类体系、STL、工程项目时,代码结构会更稳固。
枚举和命名空间在本质上做的是同一件事:给边界命名。枚举给"哪些值合法"命名,命名空间给"这些名字属于哪里"命名。项目变大后,难的不是写一条语句,而是让读者判断出每个值、每个函数、每个类型归属哪里。边界清楚,后续的维护成本会大幅降低。
阅读导航



