
C++ 作用域与生命周期:名字可见性和对象存活
06 作用域和生命周期:名字在哪能用,对象活到什么时候
函数把一段逻辑装进了一个有名字的单元。开始写函数以后,我们马上就会遇到两个边界问题:一个名字到底在哪些地方能用,以及一个对象究竟会存在多长时间。
这两个问题看起来有点像,但它们关注的核心并不一样。作用域用来管理名字的可见范围,而生命周期管理的是对象在运行时的存活时间。在平时写代码时,很多基础的 bug 其实都源于把这两个边界搞混了。
我们可以先看一个小例子:
#include <iostream>
#include <string>

int main() {
  int score = 75;

  if (score >= 60) {
    std::string message = "passed";
    std::cout << message << "\n";
  }

  return 0;
}
在这个例子里,message 是在 if 的大括号内部定义的,因此它只在这对大括号里可见。如果离开了这对大括号,再去访问 message,编译器就会提示找不到这个名字。
这就说明大括号不只是用来排版的符号,它实际上划定了一道名字的边界。
在 C++ 里,大括号不仅是把几行代码组织在一起,更是在向编译器声明:在这里面定义的某些名字,一旦出了这个范围就失效了。通常来说,作用域越小,我们在阅读代码时需要记住的名字就越少。把临时变量限制在尽可能小的范围里,是保持代码逻辑清晰的一个好习惯。
作用域管理名字
作用域的核心就是回答一个问题:这个名字到底在代码的哪一部分是合法的。
我们最常碰到的就是块作用域。任何被大括号包裹起来的一段代码,在 C++ 里都可以被当成一个完整的块:
if (score >= 60) {
  std::string message = "passed";
  std::cout << message << "\n";
}
这里的 message,它的作用域从定义的那一行开始,一直到遇到当前块的右侧大括号为止。只要出了这个块,这个名字就失去了意义。
这个范围可以用图清晰地表示出来: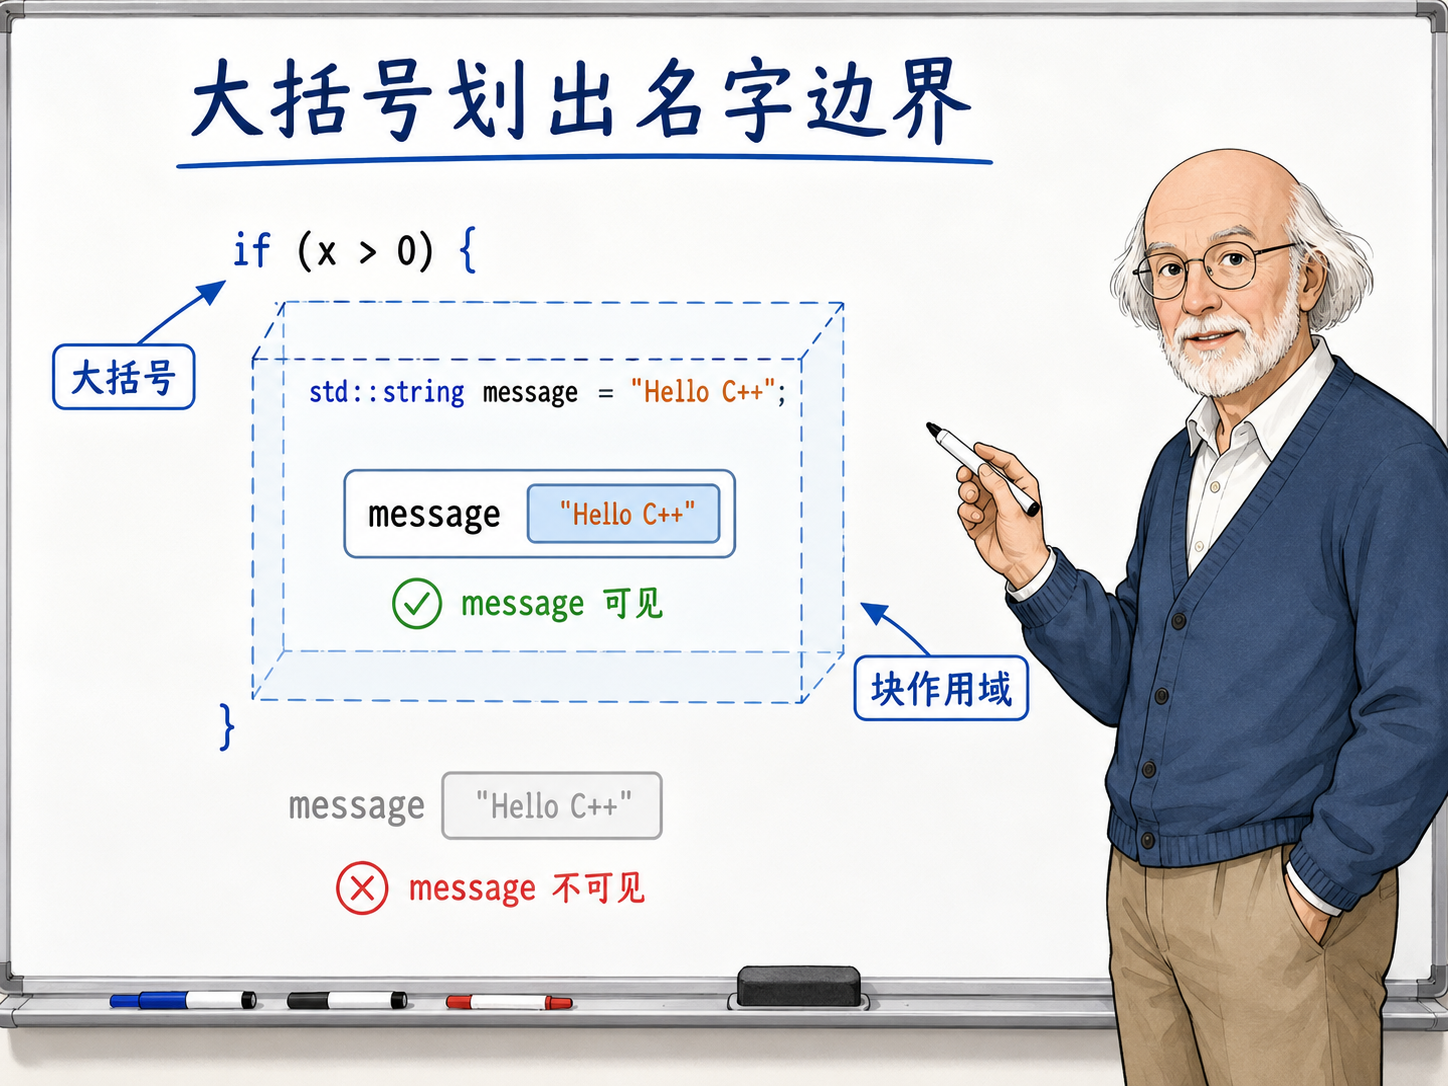
类似的规则也适用于 for 循环,循环变量同样受到块作用域的管理:
for (int i = 0; i < 3; ++i) {
  std::cout << i << "\n";
}
在这个例子中,变量 i 属于 for 语句和它的循环体。循环结束后,外面的代码就无法再使用 i 了。这其实是一件好事,因为循环变量本来就只是为了循环逻辑存在的。把它限制在循环内部,可以避免它对外部的代码产生不必要的干扰。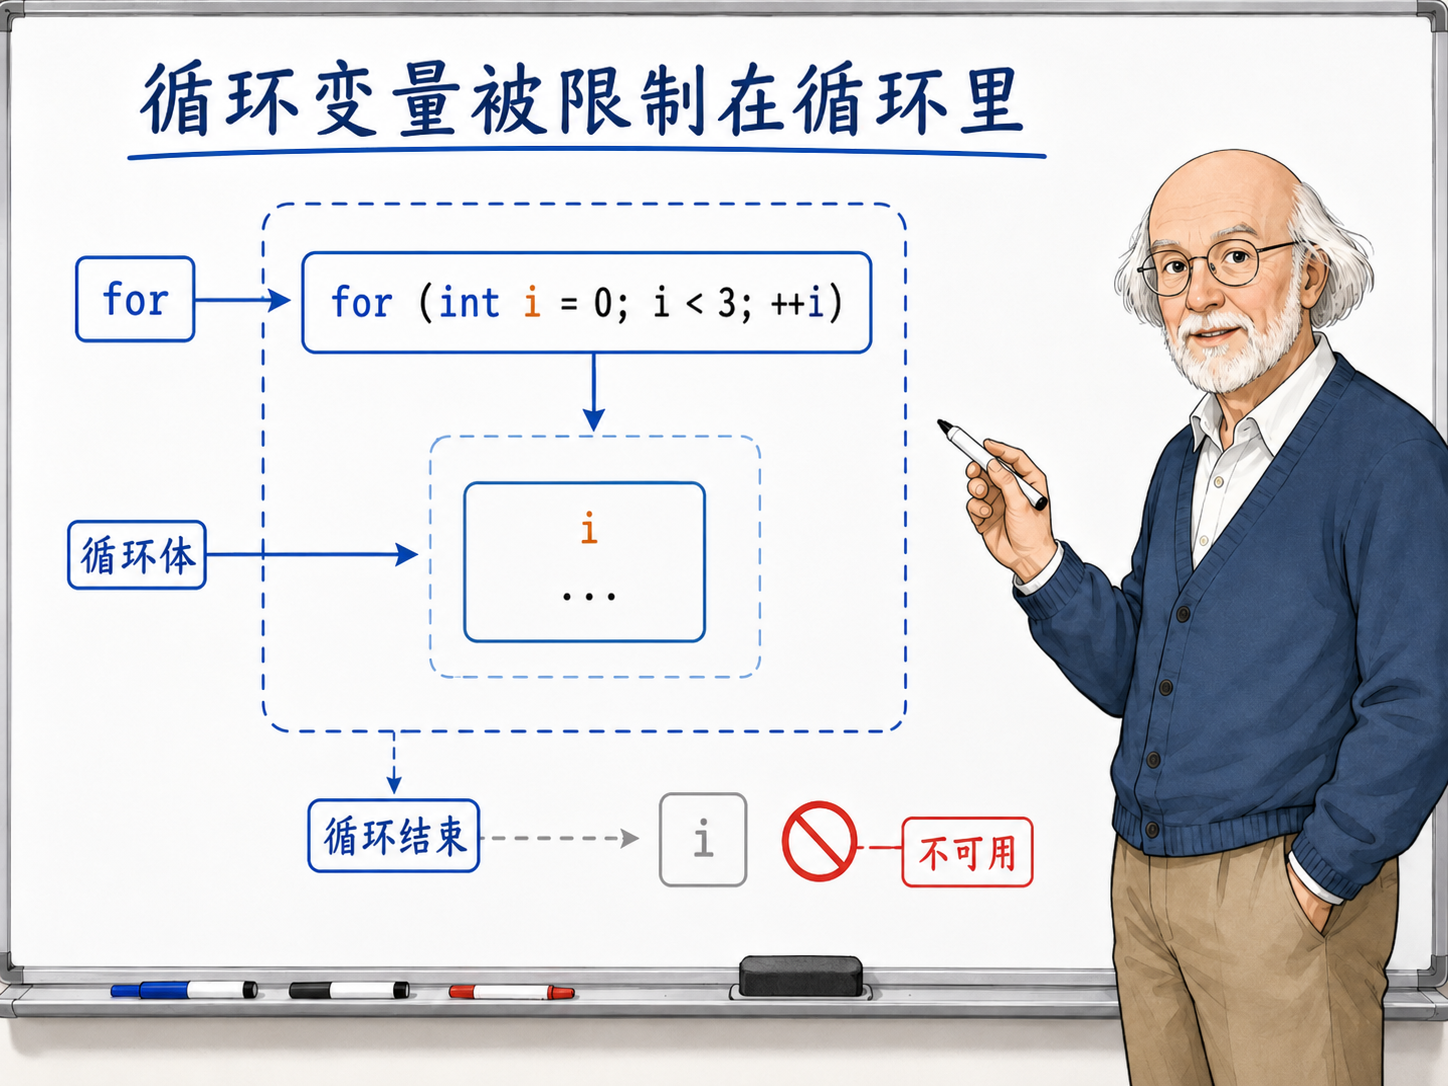
当然,函数本身也会形成一个独立的作用域: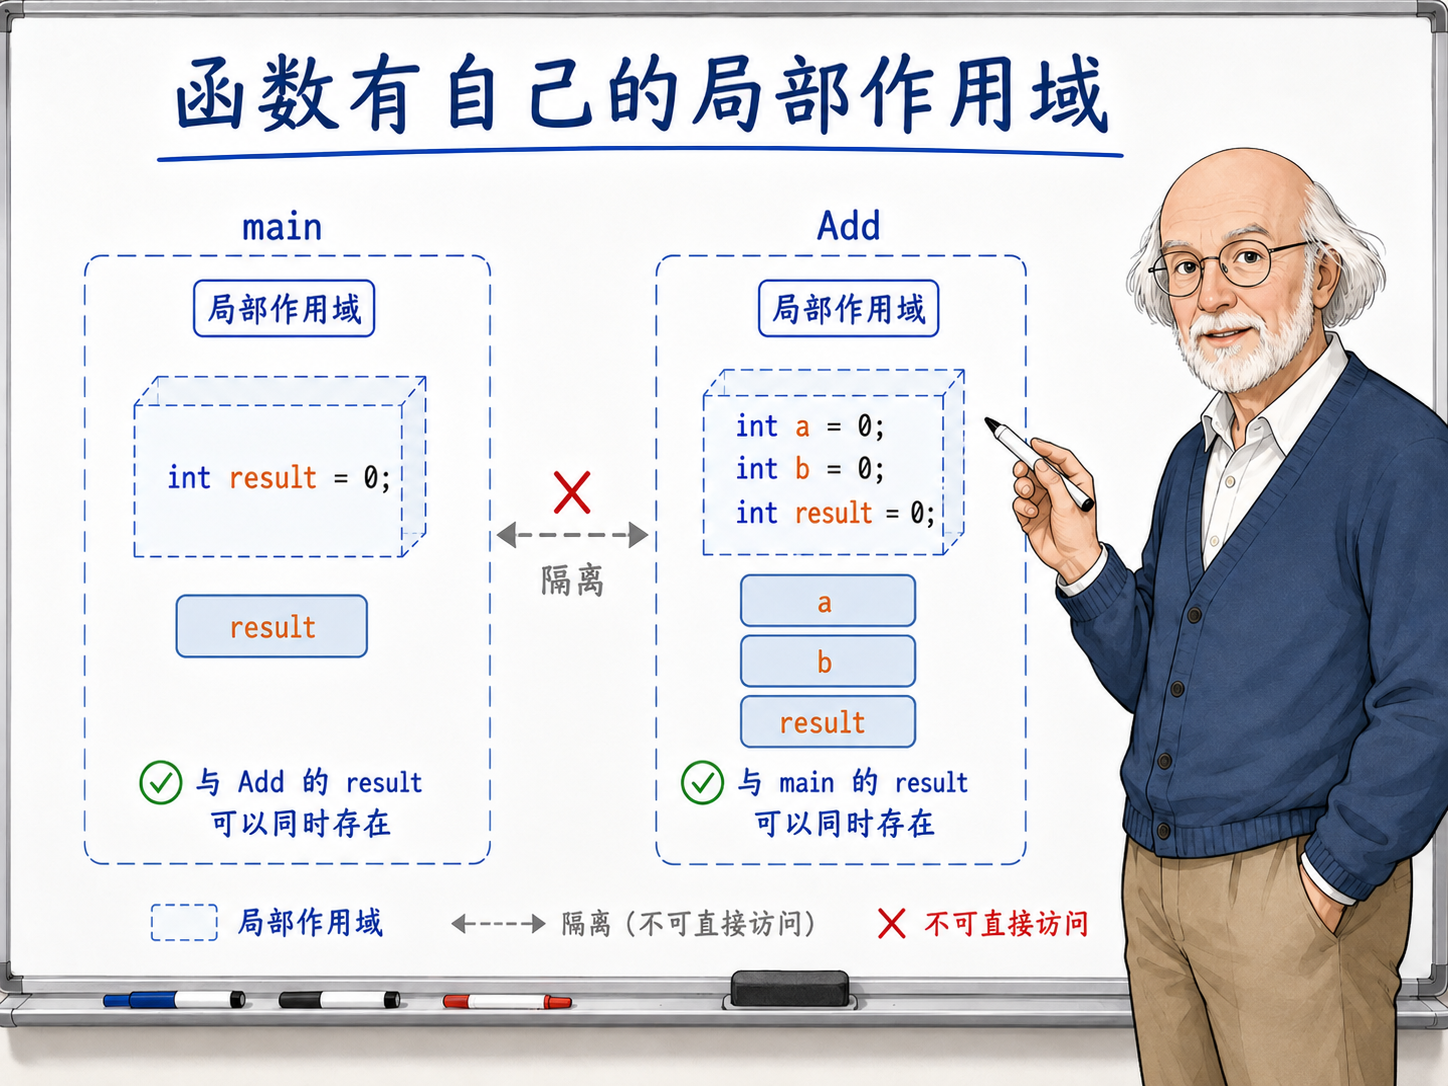
int Add(int a, int b) {
  int result = a + b;
  return result;
}
这里的 a、b 还有 result 都是 Add 函数内部的名字,外部的 main 函数是不能直接使用的。也正是因为不同的函数有着各自独立的作用域,所以它们内部即使使用了相同的变量名,也不会互相冲突。
这套规则在无形中让函数之间保持了良好的隔离。Add 里的 result 和别处的 result 除了名字一样以外,没有任何实际关联。因此,在阅读一个函数时,我们可以放心地把注意力集中在当前的局部环境里。变量名不会跨越函数的边界,这也是函数能够有效封装逻辑的底层支撑。
原则上,作用域划分得越小,名字管理起来就越省心。如果一个变量只有接下来的三行代码需要用到,那就直接定义在那三行附近;如果一个变量纯粹是为循环计数的,那就把它放在 for 的括号里。这种习惯带来的好处很直接:看代码的人不需要去猜测几十行之后是否还会用到这个名字,也不用为了确认一个变量的状态而在文件的上下文中来回翻找。很多时候,变量定义的位置本身就能提供清晰的阅读线索。
这种做法也能有效减少代码的误用。比如循环里的 i 在循环结束后就自动失效,外面的代码即使不小心写错了也无法访问;if 里的临时变量 message 出了大括号就立刻作废,不用担心被后续的逻辑误用。把变量放在最贴合它逻辑的作用域里,其实就是把那些“不要在外部使用”的约束直接交给了编译器去执行检查。
有些人在写代码时习惯在函数开头就把所有变量都定义好,这无意间就放大了变量的作用域。如果前面声明了一堆名字,很久之后才真正用到,阅读者就得在脑海里一直记着它们。更顺应直觉的做法是,等到真正需要用到某个变量时再去定义它,这样变量出场时,前后的逻辑能立刻解释它的作用。
生命周期管理对象
作用域讨论的是名字在语法上的可见性,而生命周期关注的则是具体的对象。一个对象是在什么时候被创建出来的,又是在什么时候被销毁的,这属于生命周期要解答的问题。
对于普通的局部变量来说,它们通常是在程序运行到那行定义语句时被创建,而在执行流离开当前作用域时被销毁:
void PrintMessage(bool passed) {
  if (passed) {
    std::string message = "passed";
    std::cout << message << "\n";
  }
}
当程序执行到 if 块内部时,message 对象被正式建立。等到执行完大括号里的最后一句,离开 if 块时,message 的生命周期也就随之结束,它之前占用的内存和资源会被系统清理。
如果是像 int 这种简单的基础类型,销毁的过程没有太多额外的动作。但对于像 std::string 这样内部包含数据的对象,在它被销毁时可能就需要执行特定的资源释放工作。关于对象具体是如何构造和析构的,我们在后面的资源管理章节会详细展开,这里只需要先建立起对其发生时机的基本直觉即可。
同样的机制也适用于函数内部的局部变量:
int Add(int a, int b) {
  int result = a + b;
  return result;
}
每次调用 Add 函数时,都会创建出专属于这一次调用的 a、b 和 result。一旦函数计算完成并返回结果,这些局部对象的生命周期也就宣告完结。
可以说,生命周期完全是一个在程序运行起来之后才会涉及的概念。作用域是在写代码时提示你这个名字是否合法,而生命周期是在程序运行时决定那个对象是否还在内存中。普通局部变量的行为很直观,在哪儿定义的就在哪儿创建,出了块或函数就销毁。但到了后续引入引用和指针的时候,这个问题就会变得有些复杂——因为你可能会保留一个指向某个位置的访问入口,而那个位置上的对象可能已经结束了它的生命周期。
当我们连续调用同一个函数时,每次产生的局部变量也是完全独立的:
int first = Add(1, 2);
int second = Add(10, 20);
第一次调用时的 a 和第二次调用时的 a 属于两次不同的执行过程。它们只是恰好使用了相同的名字,内部保存的全是各自那次调用的独立数据。
正是这条规则保证了函数的安全复用。执行 Add(1, 2) 和 Add(10, 20) 时,系统不会让它们共享同一份 a 和 b。每次调用都有自己独立的局部对象,返回后这些对象也各自结束生命周期。只要一个函数没有去修改外部的全局变量,也没有保留内部的静态状态,那么它的计算结果就只取决于传入的参数。这种逻辑清晰的函数,无论是阅读理解还是编写测试都会轻松很多。
对象的生命周期结束,通常也意味着它占用的资源需要被释放。像 int 这种基础类型在退场时没有明显的动作,但如果是 std::string 或 std::vector 这种对象,在销毁时就会去清理内部管理的内存。C++ 非常依赖这一套自然机制:对象创建时获取资源,销毁时自动释放资源。目前我们只需要记住最基础的规则:局部对象的生命存续是跟着作用域走的,离开了作用域,生命周期也就结束了。
有了这套机制,我们在写代码时就不需要手动去追踪并清理每一个局部的字符串。像 std::string message 一旦离开了它所属的代码块,自己就会完成收尾工作。等我们稍后学到 RAII 和复杂的资源管理时,你会发现 C++ 实际上是把各种资源都纳入了这种生命周期模型中。不过在基础阶段,首要任务还是先理清“对象能存活多久”这个基本概念。
作用域和生命周期的关系
对于绝大多数普通的局部变量而言,名字的可见范围和对象的存活时间看起来确实很一致:刚进入作用域就创建对象,离开作用域时名字失效,同时对象也被销毁。
比如下面这段代码:
{
  int value = 10;
  std::cout << value << "\n";
}
在这段代码中,value 这个名字只在大括号内部有效,而存储数据的那个 int 对象,也仅在这几行代码的执行期间短暂存在。
但即便它们常常同步发生,本质上依然是两个独立的概念。作用域是编译器在检查代码时遵循的一套名字规则,而生命周期是程序在运行时对象实际存在的时长。等我们接触到引用、指针,甚至动态内存时,这种区别就会显现出来。某个名字失效了,代码里无法再引用它,并不代表底层的对象已经销毁;反之,如果一个对象已经销毁了,但程序里还保留着指向它的指针,就会引发危险的内存访问错误。
在现阶段,我们可以先将这两个概念简单区分开: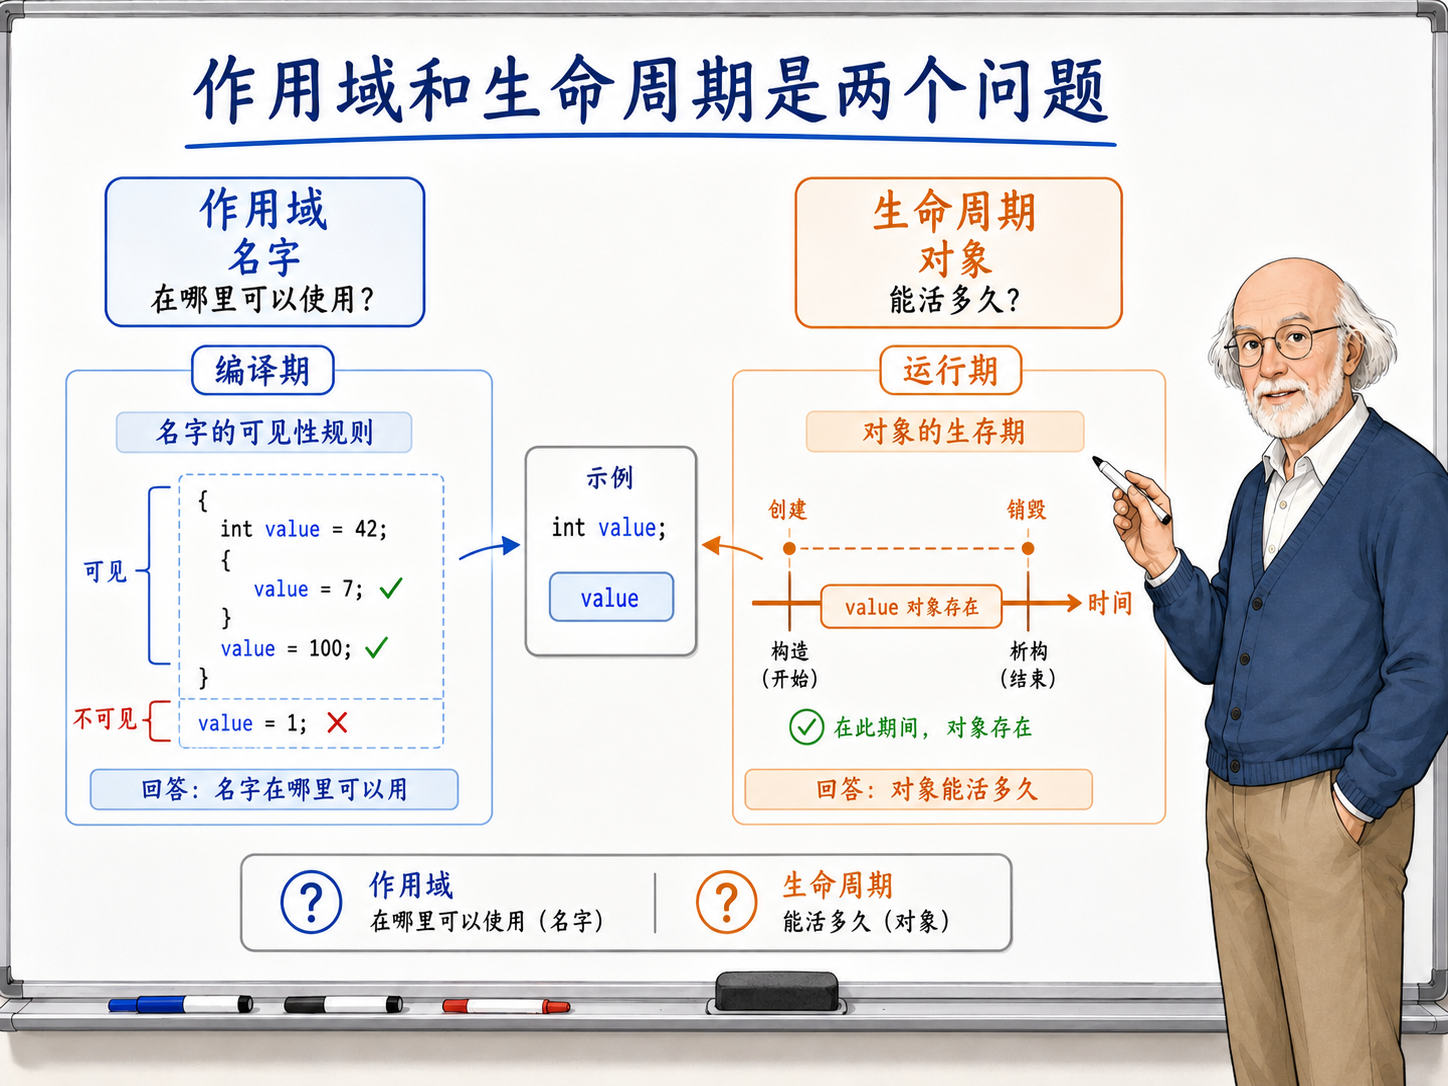
作用域:名字在哪能用
生命周期:对象活到什么时候
把这两个概念分开看待后,很多问题会变得更容易理解。有可能一个对象依然存活,但指代它的名字已经超出了作用域,导致当前的代码无法访问它;也有可能一个对象已经被清理,但由于存在旧的指针,程序依然保留着它曾经的内存地址。虽然我们在基础章节不会去深入拆解那些危险的案例,但先理清这两个问题的方向是很有必要的。
这种区分对于理解后续的引用和指针尤为关键。引用和指针本质上都是在提供一种访问对象的途径,但它们无法改变普通局部对象的生命周期。一旦对象的生命周期结束,这些之前保留的访问途径就会失效,继续使用是不安全的。初学者常被提醒要避免返回局部变量的引用,或者不要随意保留局部对象的指针,背后的原因正是对这条边界的考量。
名字遮蔽会增加阅读成本
在 C++ 中,如果有嵌套的作用域,内层是允许定义一个与外层同名的变量的。这时候内层的名字就会将外层的名字“遮蔽”起来: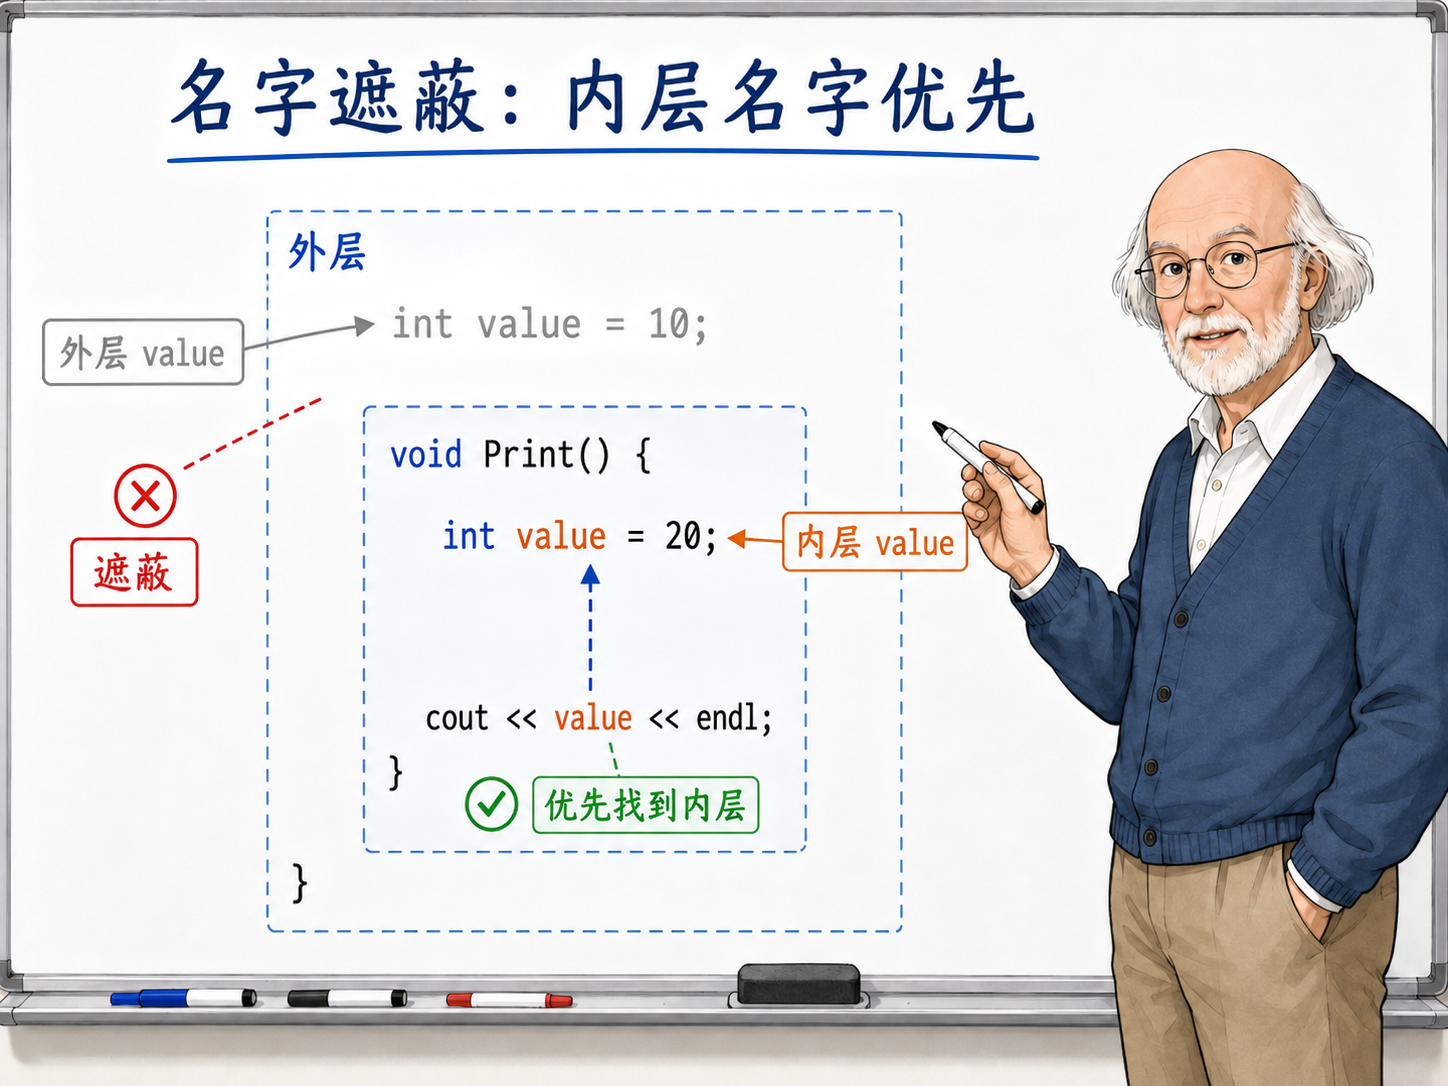
#include <iostream>

int value = 10;

void Print() {
  int value = 20;
  std::cout << value << "\n";
}

int main() {
  Print();
  return 0;
}
运行这段代码,Print 函数输出的结果是 20。因为函数内部的局部变量 value 遮蔽了外部的全局变量 value。只要处在 Print 的作用域内,直接访问 value,编译器就会优先匹配内层的那个变量。
虽然这种名字遮蔽在语法上是合法的,但它不可避免地增加了代码的阅读成本。当你看到 value 时,需要花额外的精力去判断当前指代的究竟是哪一个 value。如果在很短的代码块里偶尔出现影响还不大,但在长篇幅的代码中如果频繁出现同名遮蔽,会极大降低代码的可读性。
一种更清晰的做法,是让变量名直接体现出它所承担的角色:
int global_limit = 10;

void Print() {
  int local_value = 20;
  std::cout << local_value << "\n";
}
一旦赋予了变量准确的名字,作用域的边界也就自然而然地清晰了。
名字遮蔽带来的主要困扰在于,它让同一个名字在不同的位置指向了不同的对象。编译器能够准确无误地处理这种关系,但阅读代码的人却需要反复去确认当前的上下文。在小示例中它只是一个语言特性,而在多人协作的工程里,它很容易引发误解。因此在编写代码时,保持名字的角色清晰,远比利用作用域规则去复用同一个名字要合适得多。
全局名字要克制使用
如果一个变量定义在所有函数的外部,它就会拥有一个相当大的作用域:
int max_score = 100;

int ClampScore(int score) {
  if (score > max_score) {
    return max_score;
  }
  return score;
}
因为定义在外部,其后的所有代码都可以直接访问 max_score。在写一些简短的练习代码时,这样做图个方便并没有什么问题;但在实际的工程中,使用全局的可变数据需要极其谨慎。因为任何能够看到它的代码都可以对它进行修改,这会使得数据的状态变更难以追踪。
为了让逻辑更清晰,更可靠的做法是将这类数据通过参数显式地传递进去:
int ClampScore(int score, int max_score) {
  if (score > max_score) {
    return max_score;
  }
  return score;
}
通过参数传递的好处是,它将依赖关系直接展现在了函数的接口上。任何人在看到函数声明时,都能立刻明白这个函数需要 score 和 max_score 才能正常工作。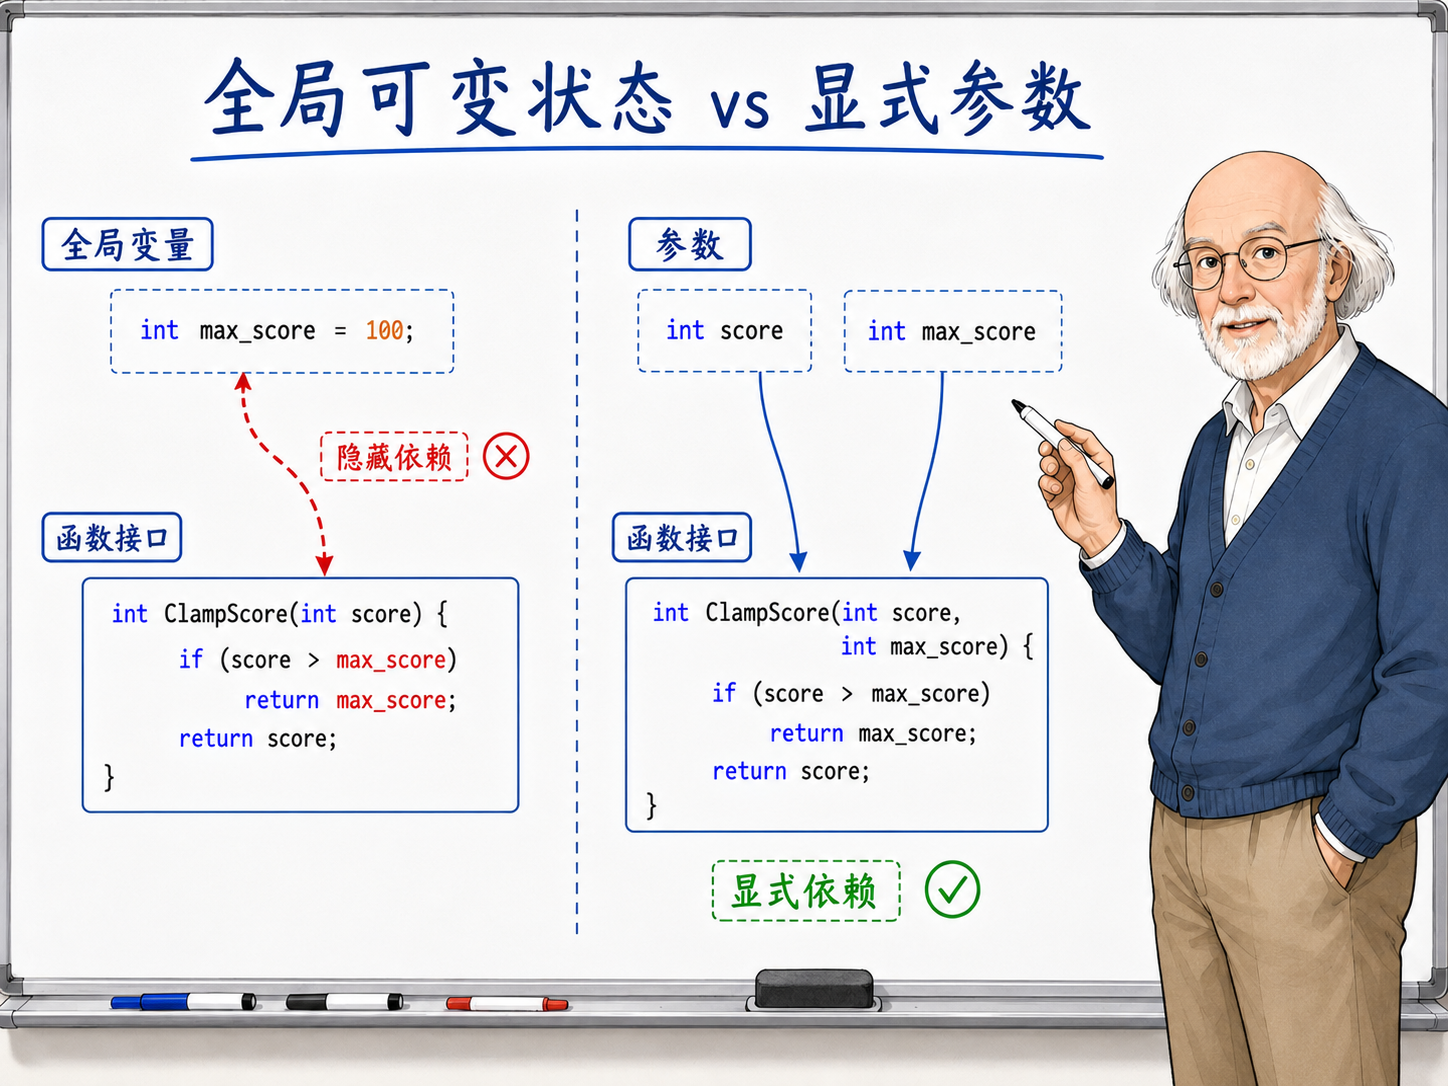
当然,像是不变的全局常量,或者放在命名空间里的工具函数,它们有其合理的使用场景,这点我们在后面会探讨。在学习的初期阶段,重要的是培养良好的习惯:优先使用局部变量,优先依赖参数传递,尽量不要把普通的可变数据暴露在过大的作用范围里。
坚持这个习惯的核心目的是让代码状态保持可追踪性。局部变量的影响范围仅限于其所在的代码块,参数的传递路径可以从函数调用中看清。相比之下,全局可变数据可能会被项目中的多个地方读取或修改。一个变量的作用范围越大,我们就越难搞清楚它当前的值是如何计算出来的。所以,尽可能地缩小名字的作用范围,本质上是为了降低阅读和理解代码的难度。
与之相对,全局常量要安全得多,因为它一旦创建就不会再发生改变。全局可变对象的风险在于它的不可控性——如果一个函数内部隐式依赖了某个全局变量,调用者仅看函数参数是发现不了这层依赖的。一旦程序出现状态异常,排查问题的范围就可能扩散到多个文件。因此,将依赖明确地写在参数里,是现阶段非常稳妥的做法。
这并不是说不能在函数外部定义任何名字。实际上,常量、类型、独立的功能函数以及各种工具类,通常都会定义在较大的作用域中以便复用。我们真正需要克制使用的,是那些普通的、状态会发生变化的数据。如果一个值需要变动,就尽量把它限制在相关的逻辑内部;如果它需要在多个函数之间共享,就优先选择参数传递,让这种依赖关系能够清晰地体现在函数的签名中。
静态局部变量:名字范围小,存活时间长
在局部变量中,使用了 static 修饰的变量是一个比较特殊的例外:
#include <iostream>

int NextId() {
  static int id = 0;
  ++id;
  return id;
}

int main() {
  std::cout << NextId() << "\n";
  std::cout << NextId() << "\n";
  std::cout << NextId() << "\n";
  return 0;
}
运行这段程序,输出的数字会依次递增:
1
2
3
虽然 id 这个名字依然受限于 NextId 函数内部,外部代码无法直接访问它。但不同的是,代表这个 id 的对象并没有在函数执行完毕后被销毁——它在多次函数调用之间保留了自身的状态。
这就是一个典型的“名字作用域很小,但生命周期很长”的例子: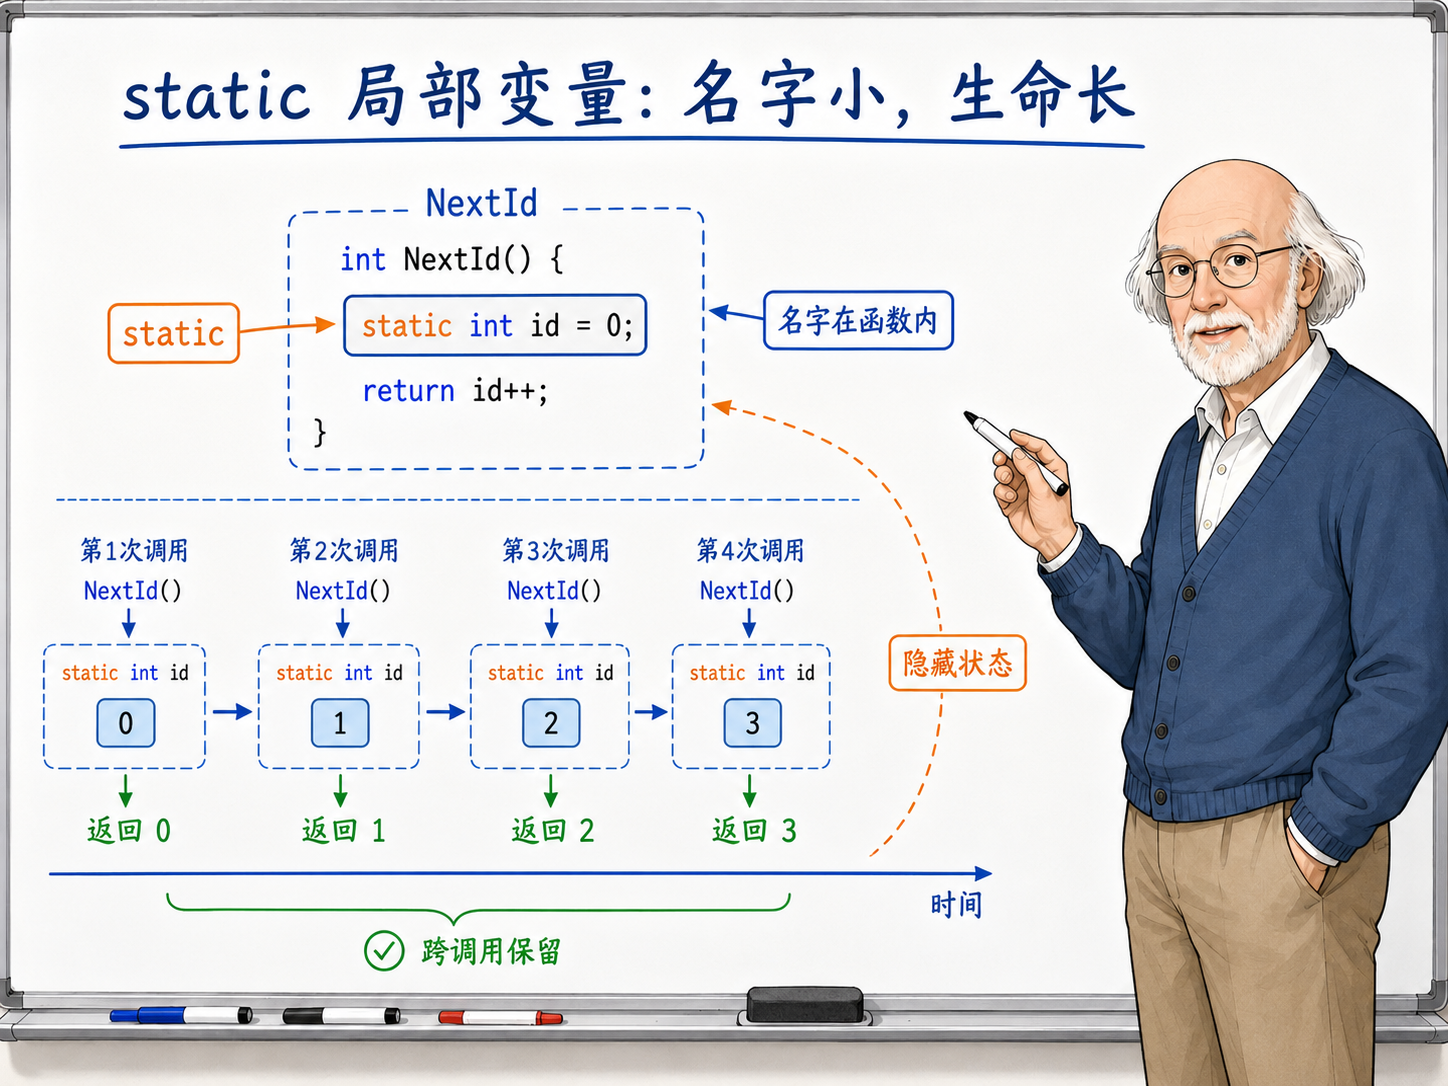
static 局部变量
  名字:限制在函数内部
  对象:多次函数调用之间持续存在
这种机制适合用来在函数内部保存一些简单的状态,比如一个内部计数器。但在实际使用时应该保持克制,因为这种隐藏的状态会让函数的行为变得依赖历史调用轨迹。像 NextId 这样的函数,它的返回值不仅取决于本身的逻辑,还取决于之前被调用过的次数。对于阅读代码的人来说,这是一个需要额外留意的细节。
关于静态变量的初始化顺序,以及在多线程环境下的复杂性,我们会在后续进一步探讨。在当前阶段,只需要能将其与普通的局部变量区分开即可。
static 局部变量的存在主要是为了满足某些“必须在函数内部记录历史状态”的特定场景。它的名字被限制在函数作用域内,这有助于减少全局污染;但它的状态跨越多次调用持续存在,这也引入了状态不可控的风险。在阅读含有这类变量的代码时,需要意识到函数的行为具有延续性。
其实,static 局部变量也是一个很好的例子,它清晰地证明了作用域和生命周期是可以分离的:名字的作用范围被限制在函数内部,但底层的对象却可以一直存活。普通局部变量通常是“名字范围小,存活时间短”,而静态局部变量则是“名字范围小,存活时间长”。在后续学习引用、指针甚至是全局对象时,我们可以利用这种对照来更好地理解代码中潜在的问题。
一段完整演示
我们可以用一段稍微综合一点的代码,将块作用域、函数局部变量、名字遮蔽以及静态局部变量结合起来看一遍:
#include <iostream>
#include <string>

int NextId() {
  static int id = 0;
  ++id;
  return id;
}

void PrintResult(int score) {
  std::string message = "failed";

  if (score >= 60) {
    std::string message = "passed";
    std::cout << "inner message = " << message << "\n";
  }

  std::cout << "outer message = " << message << "\n";
}

int main() {
  PrintResult(75);
  std::cout << "id = " << NextId() << "\n";
  std::cout << "id = " << NextId() << "\n";
  return 0;
}
在这段程序中,PrintResult 函数内部有两个名为 message 的变量。内层 if 块中的 message 遮蔽了外层的 message。当代码离开 if 块后,内层的变量失效,外层的 message 恢复可见。虽然这段代码可以正常编译和执行,但在实际开发中,建议尽量避免使用这种同名遮蔽。
另外,NextId 函数中的 id 是一个静态局部变量。它的可见范围被限制在函数内部,但对象本身却跨越了多次调用保留着状态。
这个示例汇总了本章提到的几个核心边界:PrintResult 展示了块作用域和名字遮蔽的规则,而 NextId 则演示了名字的可见性与对象生命周期之间的分离。在阅读这类代码时,我们不仅要明确“这个名字在哪里有效”,还要进一步思考“这是否还是之前的那个对象?它的状态是否被保留了?”。
为了理清思路,可以按照这样的顺序进行阅读:
在理解作用域时,也可以把它想象成一层层嵌套的盒子: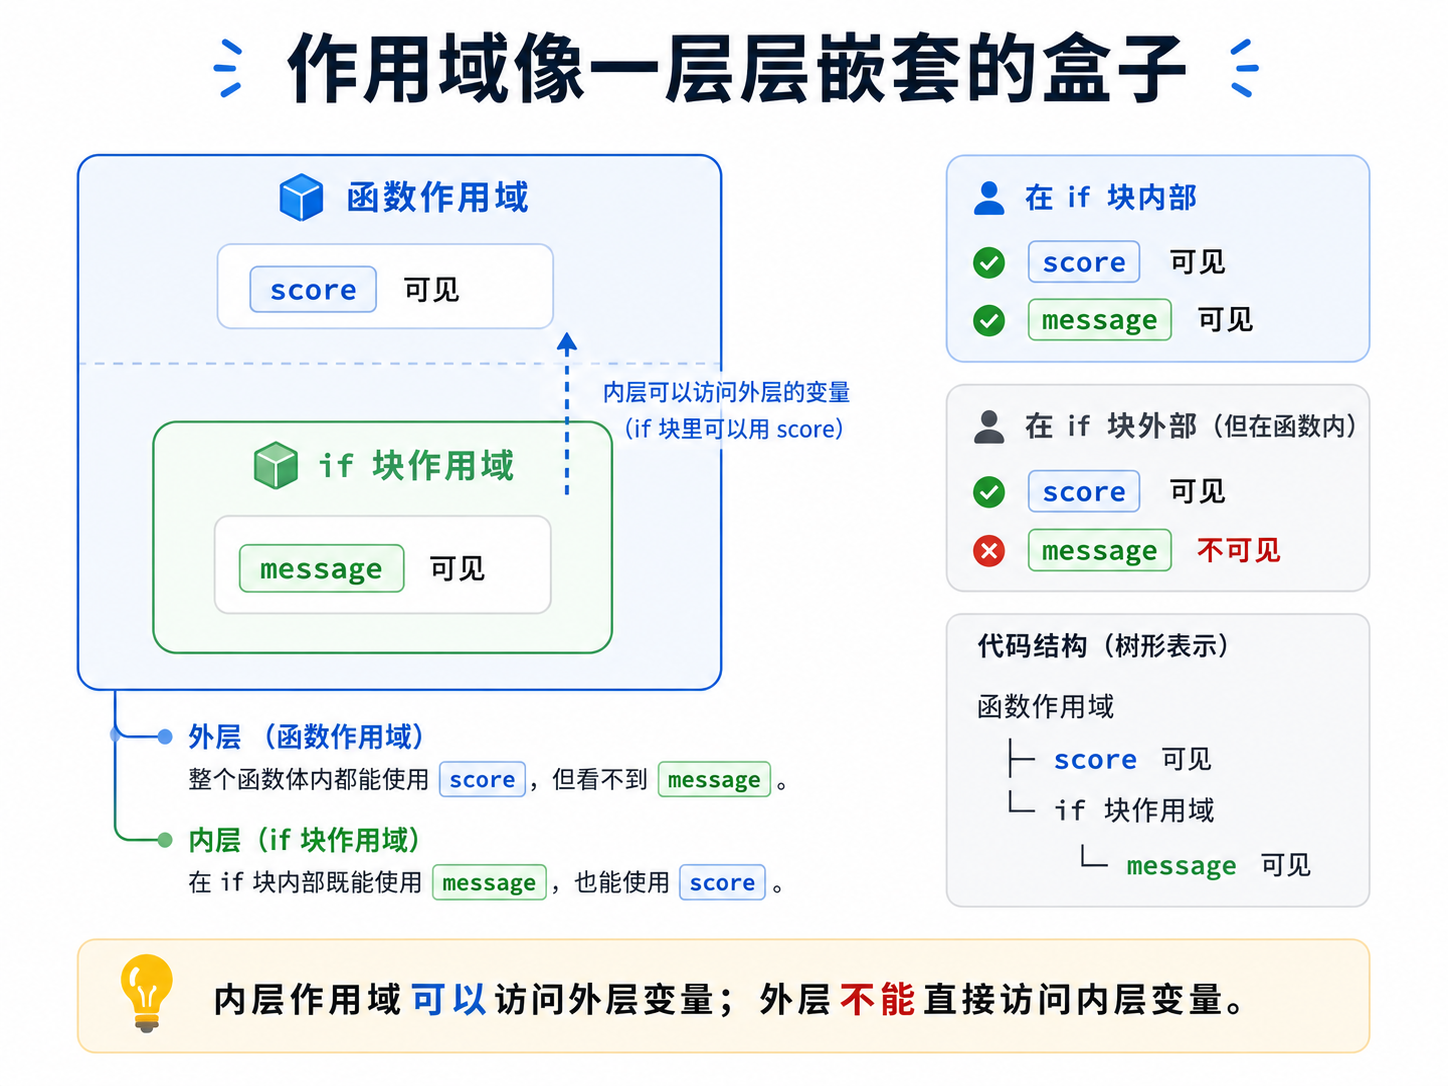
内层的盒子可以向外看到外层已经定义的名字,但外层盒子无法访问内层盒子中定义的名字。这就是为什么在 if 块里可以访问外部的 score,而离开了 if 块就无法再访问内部定义的 message。这个简单的层次模型足以解释日常开发中的多数作用域问题。
在理解生命周期时,可以结合这套层次模型一起看。普通局部对象通常在进入具体的语句时创建,在离开其所属的层级(盒子)时被销毁。而 static 局部变量则是特殊的例子:名字被限制在函数的层级内,对象却在多次调用中持续存在。如果对代码的行为拿捏不准,不妨先明确名字的作用层级,然后再去分析对象会在何时被清理。
读完这一章,一个非常重要的思路是:在分析问题时,要有意识地将“名字的作用范围”和“对象的存活时间”分开考虑。编译器能够帮助我们拦截大部分作用域引发的错误,比如试图访问已经超出作用域的 message;但生命周期相关的错误往往比较隐蔽,特别是在引用和指针介入后,访问已经销毁的对象会引发严重的问题。在基础阶段把这两个概念理顺,在后续学习引用、指针和对象生命周期管理时就会清晰许多。
使用变量名仅仅是我们访问对象的一种最直接的方式。在下一章,我们将会看到另一种方式:引用。引用允许我们为同一个对象赋予一个新的名字,并让函数的参数能够直接绑定到调用者提供的原始对象上。
阅读导航



