
C++ 编译链接错误排查:从头文件到动态库加载
10 看懂编译链接错误先判断它卡在哪一关
同样是"找不到",在 C++ 构建里可能是三件完全不同的事:
fatal error: 'math.h' file not found
use of undeclared identifier 'Add'
undefined reference to `Add(int, int)'
dyld: Library not loaded: libmath.dylib
第一条是预处理器找不到头文件,第二条是编译器在当前翻译单元里看不到声明,第三条是链接器找不到函数定义,第四条是程序启动时装载器找不到动态库。它们都带着"找不到"的味道,但发生阶段不同,解决方式也不同。看到错误先判断它卡在哪一关,比直接改代码、改 CMake、改环境变量更可靠。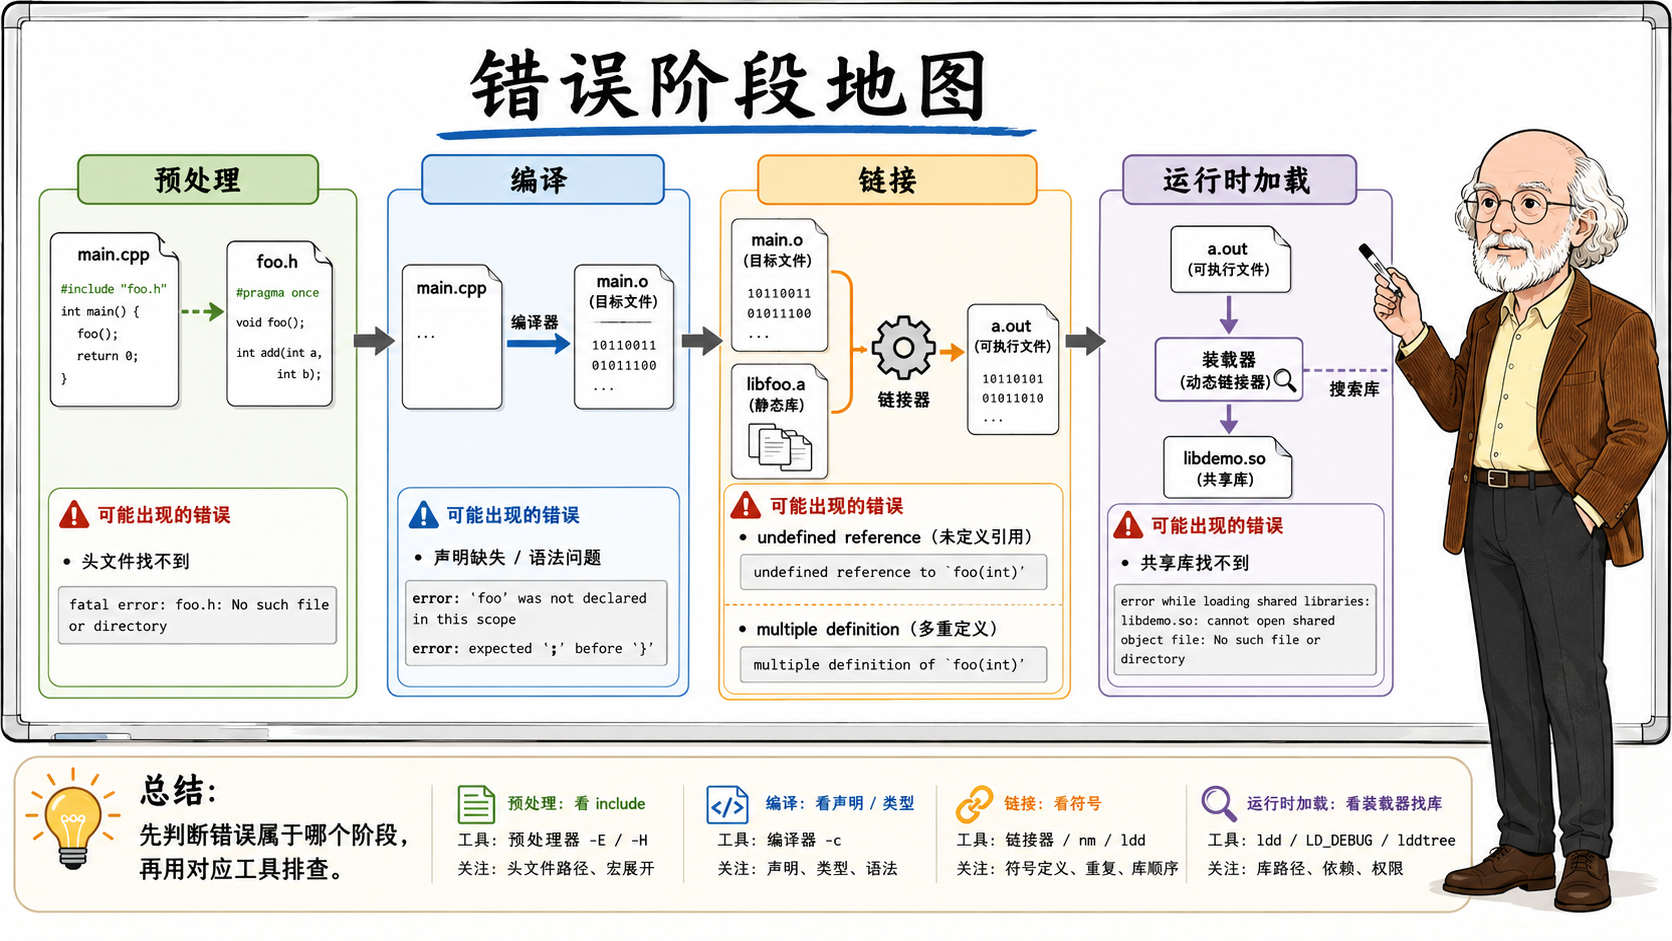
把本系列前 9 章的模型压成一张排错图,就是四道门。第一道门是预处理:处理 #include、宏和条件编译,生成完整翻译单元。第二道门是编译:检查语法、类型、声明、命名空间和访问权限,把翻译单元转成汇编。第三道门是链接:把目标文件和库放在一起,解析符号,处理重复定义,生成可执行文件。第四道门是运行时加载:程序启动时,系统装载器根据可执行文件中的依赖记录找到动态库并装入进程。
每道门检查的东西不一样。预处理器只关心文本层面的包含和宏展开,它不知道函数有没有定义。编译器只看当前翻译单元,它需要看到声明和类型信息,但不需要看到另一个 .cc 里函数体的机器码。链接器不再做 C++ 语法分析,它只看目标文件和库里的符号供需关系。运行时装载器也不关心源码,它只看动态库文件是否能按规则找到并加载。
所以排错的第一步是定位阶段,再决定修法。错误出现在 clang++ -c 时,通常还没进入链接。错误信息里出现 ld、undefined reference、duplicate symbol,通常已经进入链接。可执行文件已经生成,执行时才报错,通常是运行时问题。把阶段判断清楚,后面的排查范围会立刻缩小。
这个阶段判断比记住某条具体错误信息更重要。不同编译器、不同平台、不同语言标准版本,错误文本会变;构建链路的关卡不会变。Clang 可能说 use of undeclared identifier,MSVC 可能用另一套编号和措辞;GNU ld 和 Apple ld 对未定义符号的格式也不同。但只要你能看出"目标文件有没有生成"、"链接器有没有开始工作"、"程序是不是启动后才失败",就能把问题放回正确关卡。
排错时还要区分"当前文件"和"整个程序"。编译器处理的是当前翻译单元,所以它的错误通常围绕当前文件看不看得见声明、类型和模板定义。链接器处理的是整个程序,所以它的错误围绕所有输入合起来能不能提供唯一实体。运行时装载器处理的是机器上的文件布局,所以它的错误围绕动态库是否真的存在于可搜索位置。很多低效排查都来自把这三个视角混在一起:编译错误去改库顺序,链接错误去加 include,运行时错误去改头文件。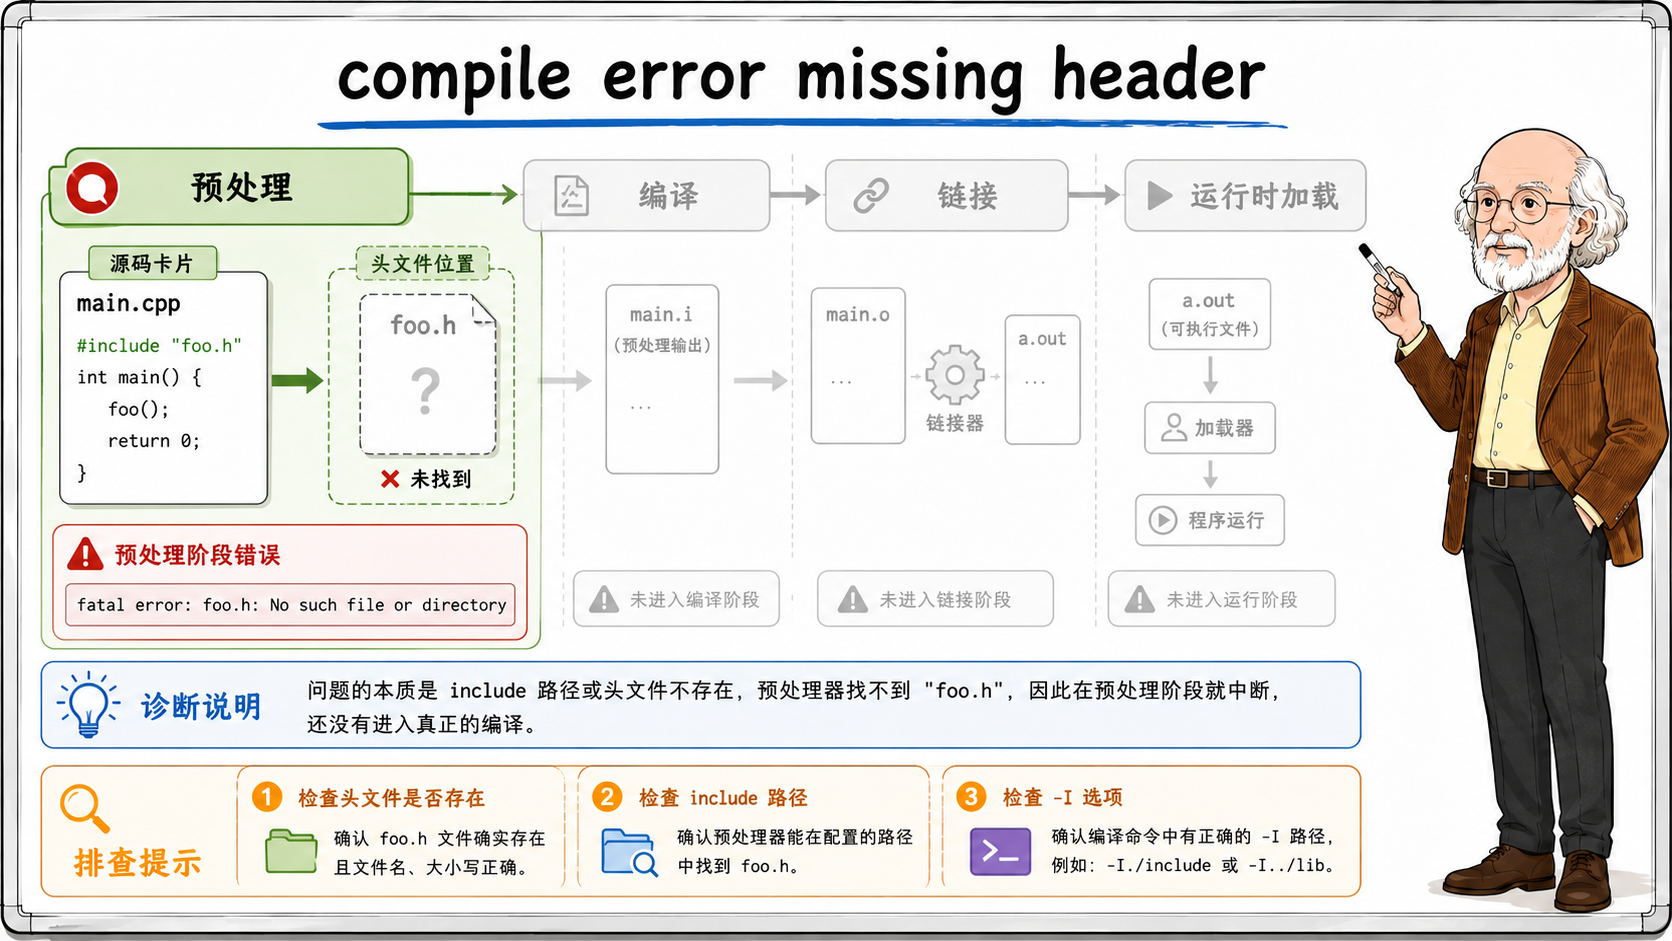
预处理阶段最常见的问题是头文件找不到。比如 missing_header.cc 写成这样:
#include "math_missing.h"

int main() {
  return 0;
}
编译时会报类似错误:
fatal error: 'math_missing.h' file not found
这个错误发生在预处理阶段。编译器还没来得及检查 main 函数里的类型,也没有生成目标文件。排查点是头文件是否存在、包含路径是否正确、引号包含和尖括号包含是否符合项目约定、构建命令有没有传入正确的 -I 目录。很多人遇到这类错误会去检查库有没有链接,这是方向错了。链接器还没上场,-L 和 -l 对头文件查找没有帮助。
头文件路径问题和库路径问题必须分开。-Iinclude 解决的是编译器在哪里找头文件,-Llib 解决的是链接器在哪里找库文件,运行时路径解决的是程序启动时装载器在哪里找动态库。三条路径服务三个阶段。把 -L 写得再正确,也不会让 #include "math.h" 成功;把 -I 写得再正确,也不会让链接器找到 libmath.a。
还有一种容易混淆的情况:头文件存在,但头文件内部又包含了另一个找不到的头文件。错误位置可能显示在第三方库的头文件里,真正要检查的仍然是预处理搜索路径。你要顺着 include 链看缺的是哪个文件,再判断它属于项目自己的 include 目录、系统 SDK、还是第三方依赖。只要错误发生在 #include 展开过程中,它就是预处理阶段的问题。
宏也会让预处理错误变得隐蔽。某个条件编译分支在本机没打开,在 CI 或另一个平台打开后开始包含新的头文件,于是突然报 file not found。排查这种问题时,最好保留触发错误的完整编译命令,确认宏定义、平台宏和 include 路径。预处理输出不是给人长期阅读的文章,但在疑难情况下用 -E 看展开结果,能直接确认编译器最终看到了哪段文本。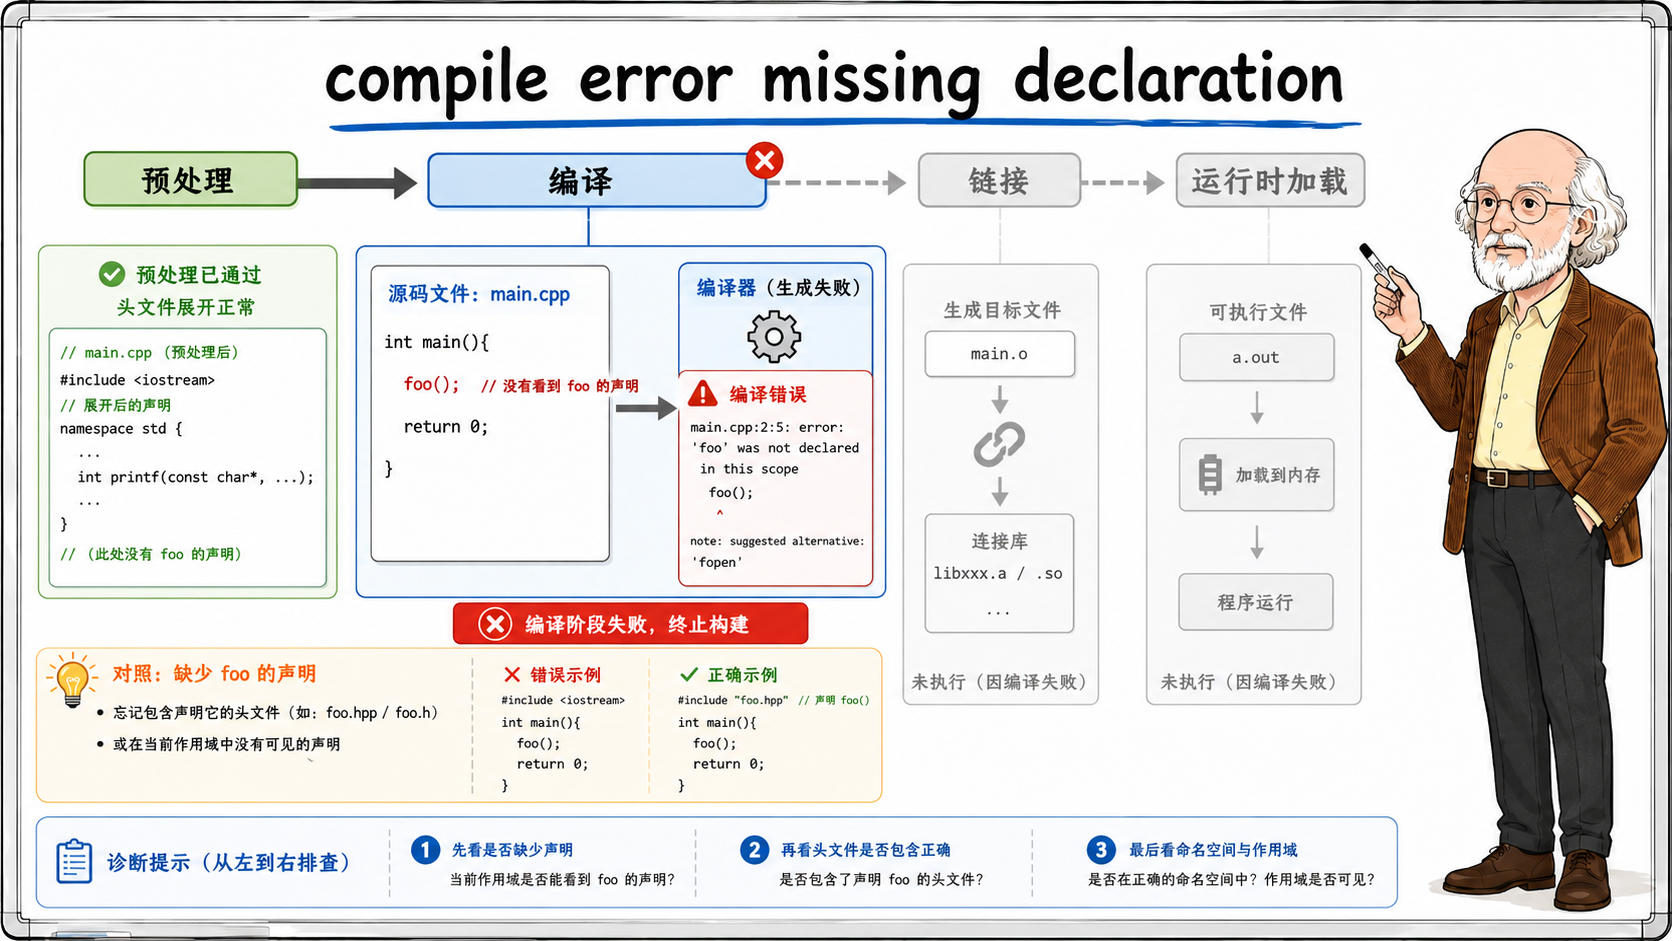
编译阶段另一个高频错误是缺声明。比如:
int main() {
  return Add(1, 2);
}
如果当前翻译单元里没有任何地方声明过 Add,编译器会报类似 use of undeclared identifier 'Add'。这个错误说明编译器正在检查 main 函数,发现它不知道 Add 是什么。此时不需要关心 Add 的定义是否在某个 .cc 文件里,也不需要关心库是否存在。编译器连这个名字的声明都没看到,链接阶段还轮不到它。
修复缺声明的方式是让当前翻译单元看见正确声明。通常做法是把函数声明放进头文件,并在使用方 .cc 里包含这个头文件:
// math.h
int Add(int left, int right);
// main.cc
#include "math.h"

int main() {
  return Add(1, 2);
}
这里的核心是"当前翻译单元"。第 3 章讲过,编译器每次只看一个预处理后的 .cc,它不会主动去扫描项目里的其他源文件。另一个文件里写了 int Add(int, int);,并不代表当前文件自动看得见。想让当前文件看见声明,就要通过头文件把声明带进来,或者在当前文件前面手写声明。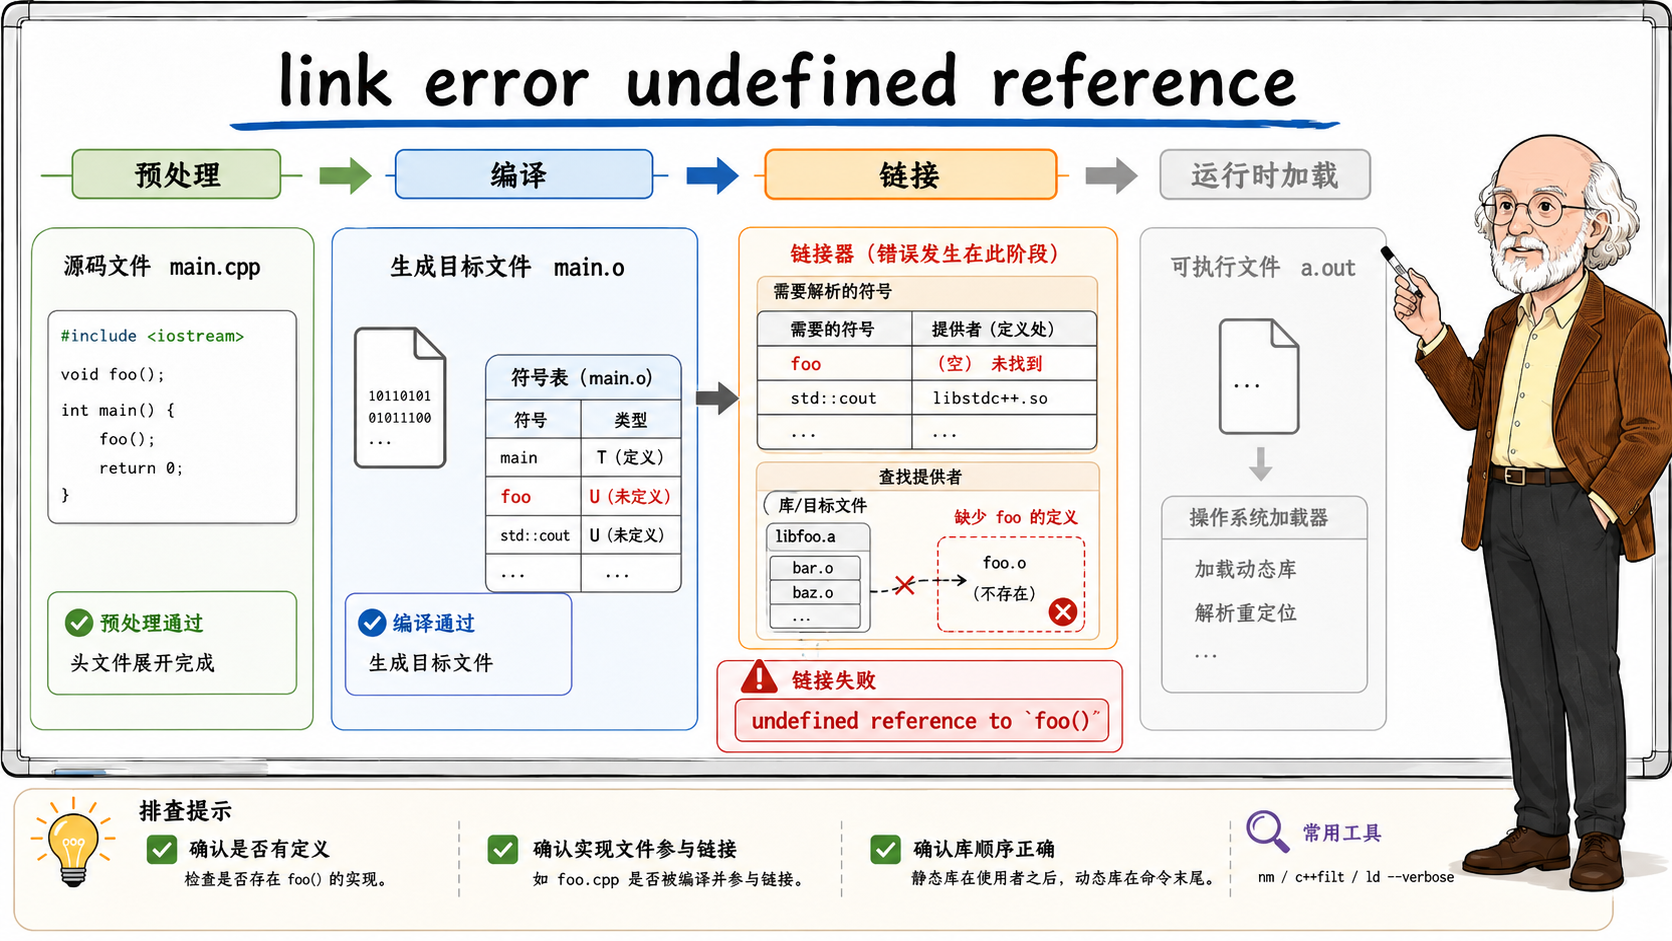
缺定义通常发生在链接阶段。看这个例子:
// missing_definition.cc
int Add(int left, int right);

int main() {
  return Add(1, 2);
}
这段代码能通过编译,因为编译器已经看到了 Add 的声明,知道它接收两个 int 并返回 int。但链接时会失败,因为整个链接输入里没有任何目标文件提供 Add 的定义。错误信息常见形态是 undefined reference to Add、Undefined symbols for architecture arm64 或类似文本。不同平台措辞不同,含义一样:某个目标文件引用了一个符号,链接器找不到任何定义来满足它。
修复缺定义要检查最终链接输入。函数体是否真的存在?定义所在的 .cc 是否被编译成 .o?这个 .o 是否传给链接器?静态库是否放进链接命令?动态库是否能在链接期找到并导出该符号?这类错误已经过了编译阶段,继续加头文件通常不能解决问题,因为头文件只提供声明,不提供外部函数的唯一实体。把函数体也写进头文件还可能制造第 5 章讲过的 ODR 问题。
缺声明和缺定义的分界很重要。缺声明时,编译器不认识名字,目标文件都生成不了。缺定义时,编译器认识名字,目标文件里留下一个未定义符号需求,链接器在全局范围内找不到供给。前者看 include 和声明,后者看 .o、.a、.so、.dylib 和链接命令。
名字修饰会让链接错误看起来更陌生。你在源码里写的是 Add(int, int),链接器输出里可能出现一串带命名空间、参数类型和编码规则的符号名。第 7 章讲过,这是 C++ 为了支持函数重载和命名空间做的 name mangling。不要被符号长相吓住,它仍然代表某个函数或变量的定义需求。可以用 nm 或带反修饰能力的工具把符号还原成更接近源码的形式,再回到定义是否参与链接这个问题。
静态库缺失和普通目标文件缺失也要分开看。少传一个 .o,链接器根本没有机会看到其中的定义;传了一个 .a,链接器还要按静态库规则判断是否抽取其中成员。第 8 章讲过,静态库顺序会影响抽取时机。如果 nm libxxx.a 能看到目标符号,但链接仍然报未定义,下一步就该检查库在命令行中的位置,而不是怀疑函数体没写。
链接阶段还会报重复定义。比如两个源文件都定义了同名外部函数:
// duplicate_a.cc
int Value() {
  return 1;
}
// duplicate_b.cc
int Value() {
  return 2;
}
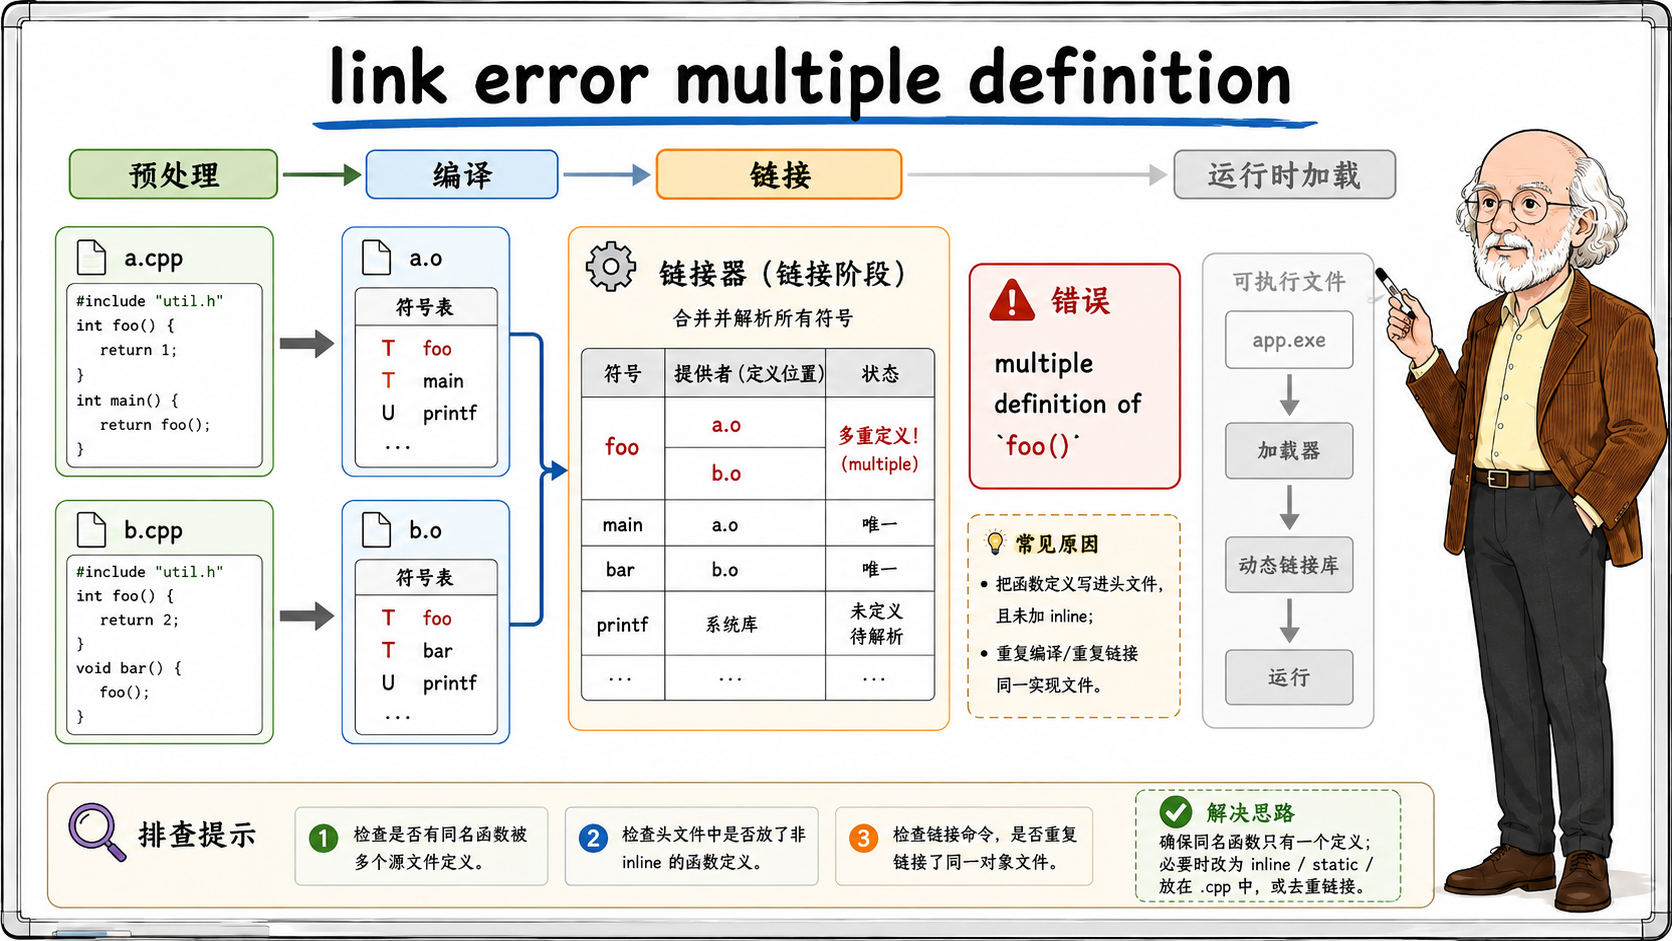
当这两个文件都编译成目标文件并进入同一次链接,链接器会发现两个强符号都声称自己是 Value 的定义。它无法替你选择哪一个是真的,于是报 multiple definition 或 duplicate symbol。这正是第 5 章 ODR 在链接阶段的表现:整个程序里同一个外部实体只能有一个定义。
重复定义常见来源有三类。第一类是把普通函数体写进头文件,又被多个 .cc 包含,最终每个翻译单元都生成一份外部函数定义。第二类是全局变量定义放在头文件里,被多个翻译单元各生成一份。第三类是两个库或两个目标文件里意外包含了同名强符号。排查时用 nm 查看相关 .o 或 .a,如果同一个符号在多个输入里都标记为已定义,就找到了冲突点。
修复方式要回到代码边界。普通函数的声明放头文件,定义放一个 .cc;需要放进头文件的短函数标成 inline;全局变量在头文件里用 extern 声明,在一个 .cc 里定义;C++17 以后确实需要头文件变量时用 inline 变量。不要用删除某个链接输入来掩盖重复定义,除非那个输入本来就不该进入程序。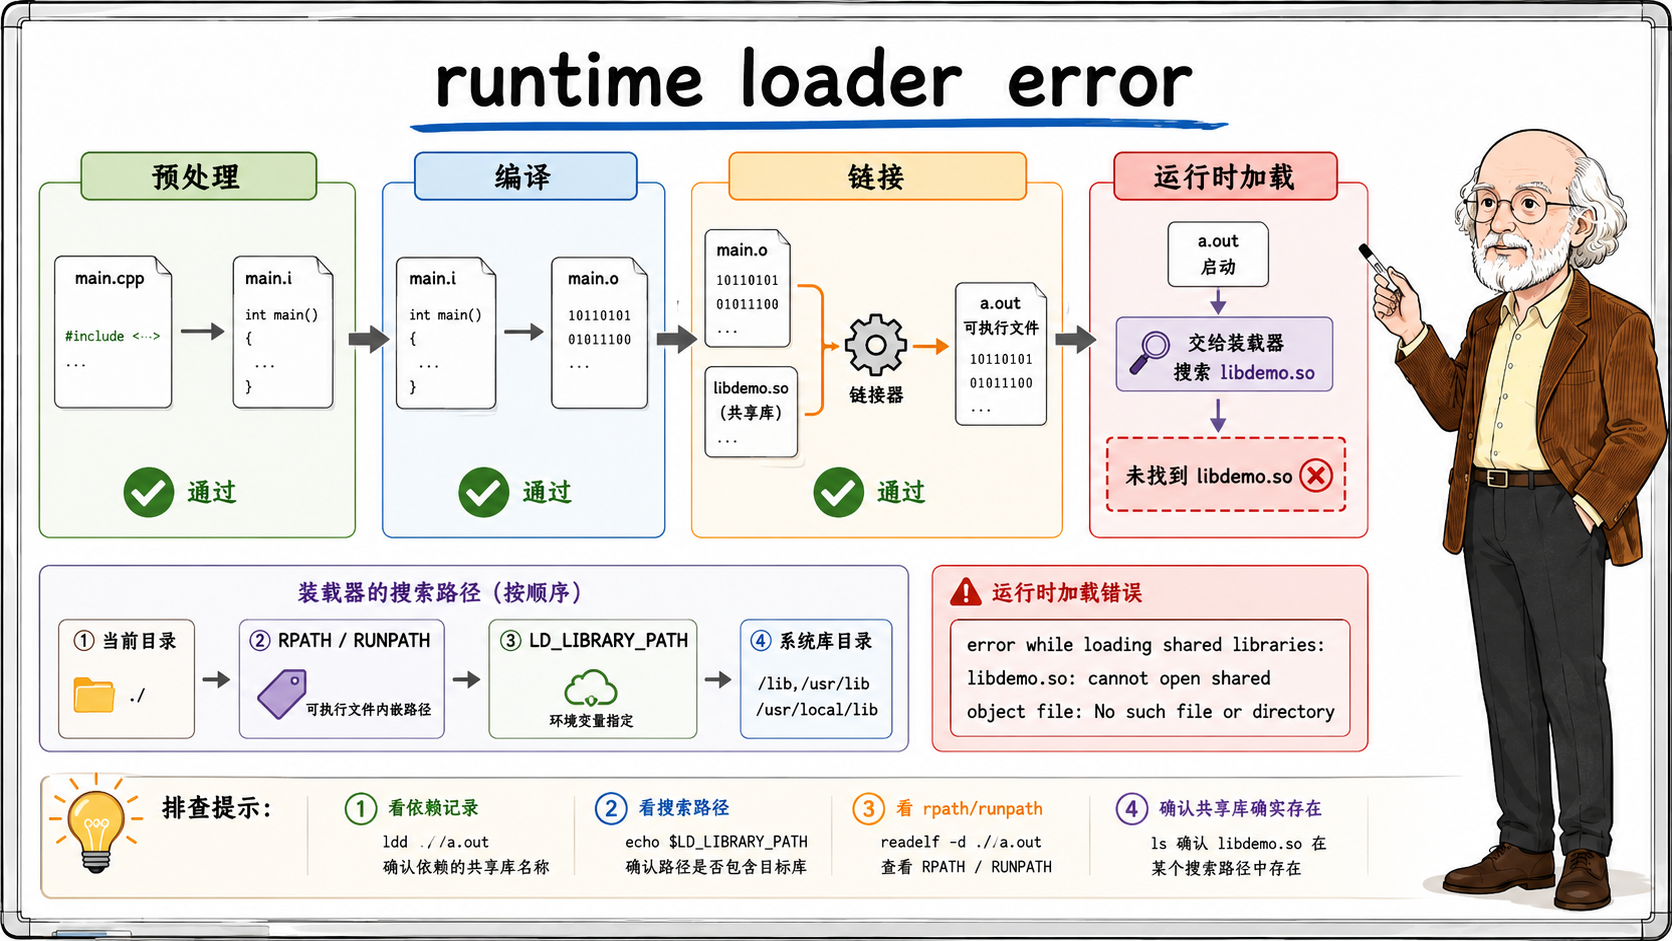
动态库把错误延伸到运行时。第 9 章已经讲过,链接期成功不代表运行期能找到库。比如 app 已经生成,执行时却报:
dyld: Library not loaded: libmath.dylib
或:
error while loading shared libraries: libmath.so
这类错误发生在程序启动时。源码已经编译过了,目标文件已经链接过了,可执行文件已经存在。失败的是系统装载器,它按运行时搜索规则找不到可执行文件依赖的动态库。排查点是动态库文件是否被一起发布、可执行文件内部记录的依赖名是什么、运行路径记录是否正确、环境变量是否只在当前终端有效、部署目录结构是否和构建时假设一致。
这类问题不要回头改 #include。头文件只影响编译阶段,装载器启动程序时根本不读取头文件。也不要只盯着 -L。-L 是链接期库搜索路径,运行时装载器不靠它找库。要检查运行时依赖,在 macOS 上常用 otool -L app,Linux 上常用 ldd app 或 readelf。工具显示依赖了哪个动态库,就按那个名字和路径线索去检查部署。
运行时加载错误还有一个特点:它经常只在目标环境复现。开发机上动态库在当前目录或系统缓存里,程序启动正常;打包到另一台机器后,库文件没跟过去,或者路径记录指向了开发机上的目录,程序立刻失败。排查这类问题时,不要只看构建日志。要在接近用户环境的目录结构里启动程序,并查看可执行文件记录的动态库依赖。能在干净环境启动,才说明运行时依赖真正闭环。
动态库版本不匹配也属于运行时或二进制边界问题。装载器找到了库文件,但库里缺少旧程序需要的符号,或者 ABI 已经变化,程序可能启动失败,也可能运行到某个调用点才崩溃。第 9 章讲过,动态库更新要同时考虑导出符号、对象布局和调用约定。看到这类问题,应该检查库版本和二进制兼容性,别只停留在"文件明明存在"这一层。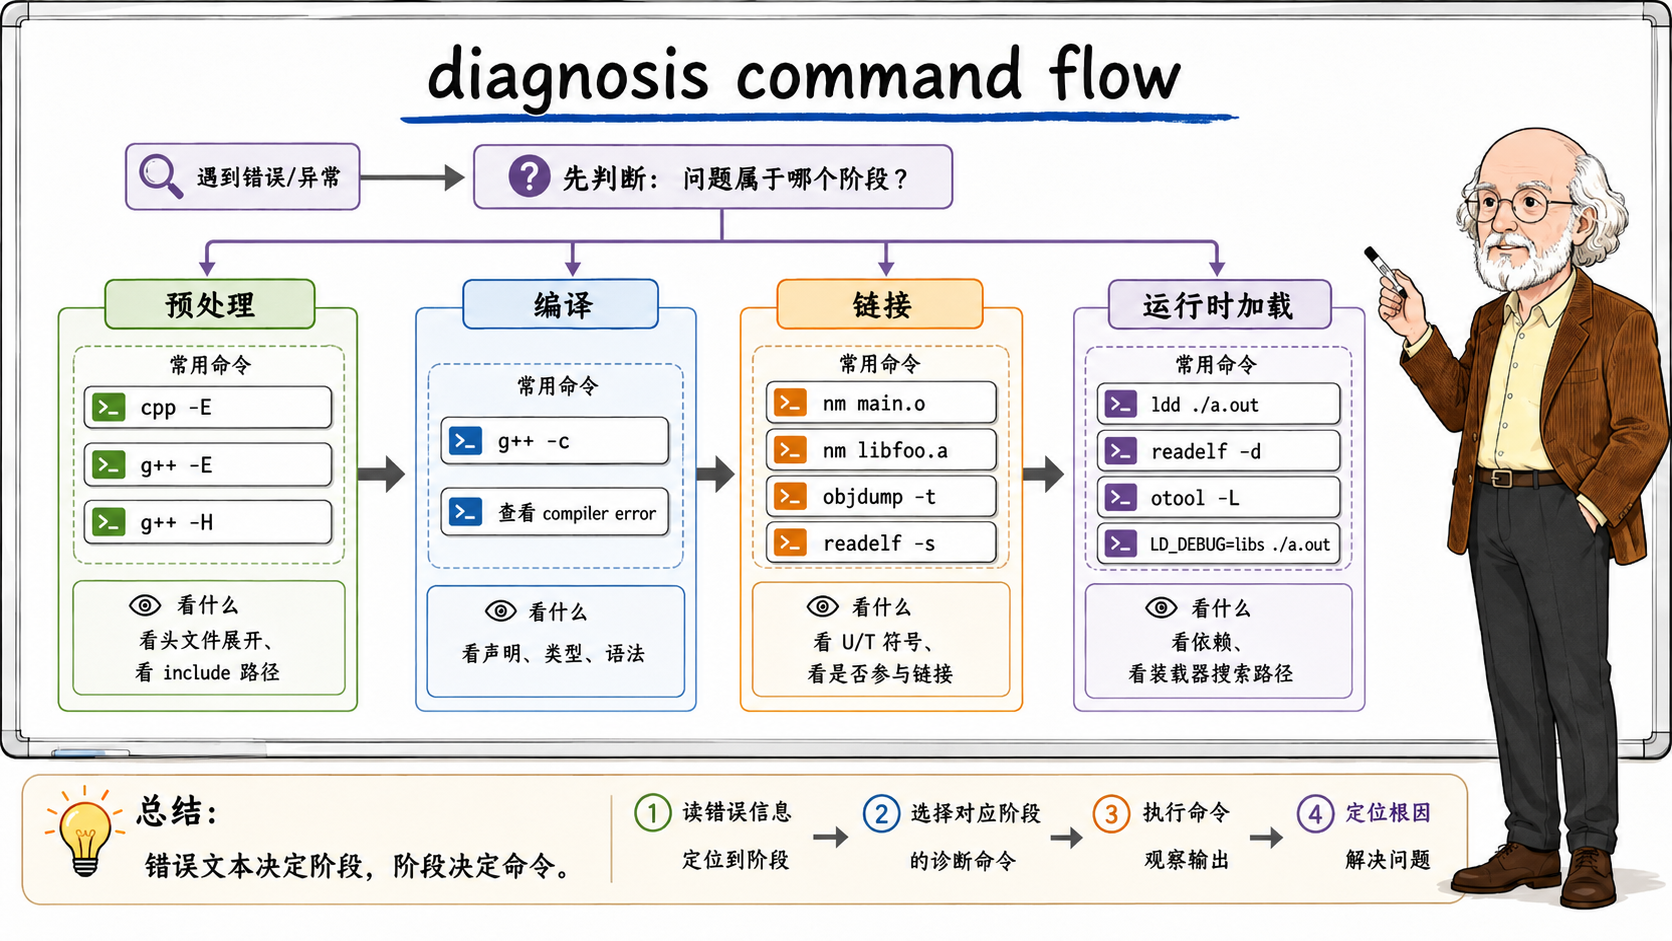
把常见错误放进一组对照项,排查时可以直接定位:
file not found 出现在 #include 附近,阶段是预处理,含义是头文件搜索失败,第一检查点是文件是否存在以及 -I 是否正确。
undeclared identifier 出现在函数体或表达式里,阶段是编译,含义是当前翻译单元看不到声明,第一检查点是是否包含了头文件以及声明是否在使用前可见。
no matching function 出现在函数调用处,阶段是编译,含义是找到了名字但类型或参数不匹配,第一检查点是函数签名、命名空间和重载集合。
undefined reference 出现在链接输出里,阶段是链接,含义是有引用没有定义,第一检查点是定义文件是否参与链接以及库是否传入。
multiple definition 出现在链接输出里,阶段是链接,含义是多个强定义冲突,第一检查点是头文件是否放了普通定义以及多个库是否重复提供同名符号。
library not found 出现在链接输出里,阶段是链接,含义是链接器找不到库文件,第一检查点是 -L 目录、库名和文件后缀。
Library not loaded 出现在程序启动时,阶段是运行时加载,含义是装载器找不到动态库,第一检查点是动态库部署位置、rpath 和环境变量。
这张表的价值不在背错误文本,而在建立判断顺序:先看错误发生在命令的哪个阶段,再看它对应哪类输入。预处理和编译阶段围绕当前翻译单元;链接阶段围绕最终输入集合;运行时加载围绕可执行文件的动态库依赖和机器上的文件布局。阶段不同,应该检查的对象也不同。
实际排查时可以按一个固定流程走。第一,看命令有没有生成 .o 或可执行文件。没有生成 .o,多半卡在预处理或编译;生成了 .o 但没有生成可执行文件,多半卡在链接;可执行文件已经生成,启动时才失败,多半卡在运行时加载。第二,看错误关键字。fatal error 加头文件名,查 include;undeclared、no member named、no matching,查声明、类型和命名空间;undefined reference、duplicate symbol,查目标文件和库;Library not loaded、shared libraries,查动态库运行时路径。第三,用对应工具验证,不在无关阶段反复试错。
对应工具也要按阶段选。看预处理结果,用 clang++ -E;看当前文件能否独立编译,用 clang++ -c;看目标文件符号,用 nm;看目标文件和段结构,用 objdump、otool 或 readelf;看动态库依赖,用 otool -L、ldd 或 readelf。这些工具不是为了炫技,它们的作用是把"猜"变成"看见"。你能看见某个符号在 main.o 里是 U,在 math.o 里是 T,就知道链接器有机会配对;你能看见两个目标文件都提供同一个 T,就知道重复定义不是编译器误报。
在团队协作里,错误报告也应该按阶段写清楚。只贴一句"编译失败"信息量很低。更好的报告包括:执行的完整命令、失败发生在编译还是链接还是启动、关键错误行、相关目标文件或库文件是否存在、已经用哪个工具确认过符号或依赖。这样别人接手时能直接沿着同一条链路继续查,不会重新从 include path 猜到运行时路径。
构建系统会把这些阶段包装起来,但不会消灭它们。CMake、Bazel、Make、Xcode、Visual Studio 都会生成或调度底层编译和链接命令。IDE 里点一下 Build,背后仍然是预处理、编译、汇编、链接和启动。遇到错误时,找到实际执行的底层命令非常重要。只要能拿到那条命令,就能用本章的四道门模型分析它卡在哪里。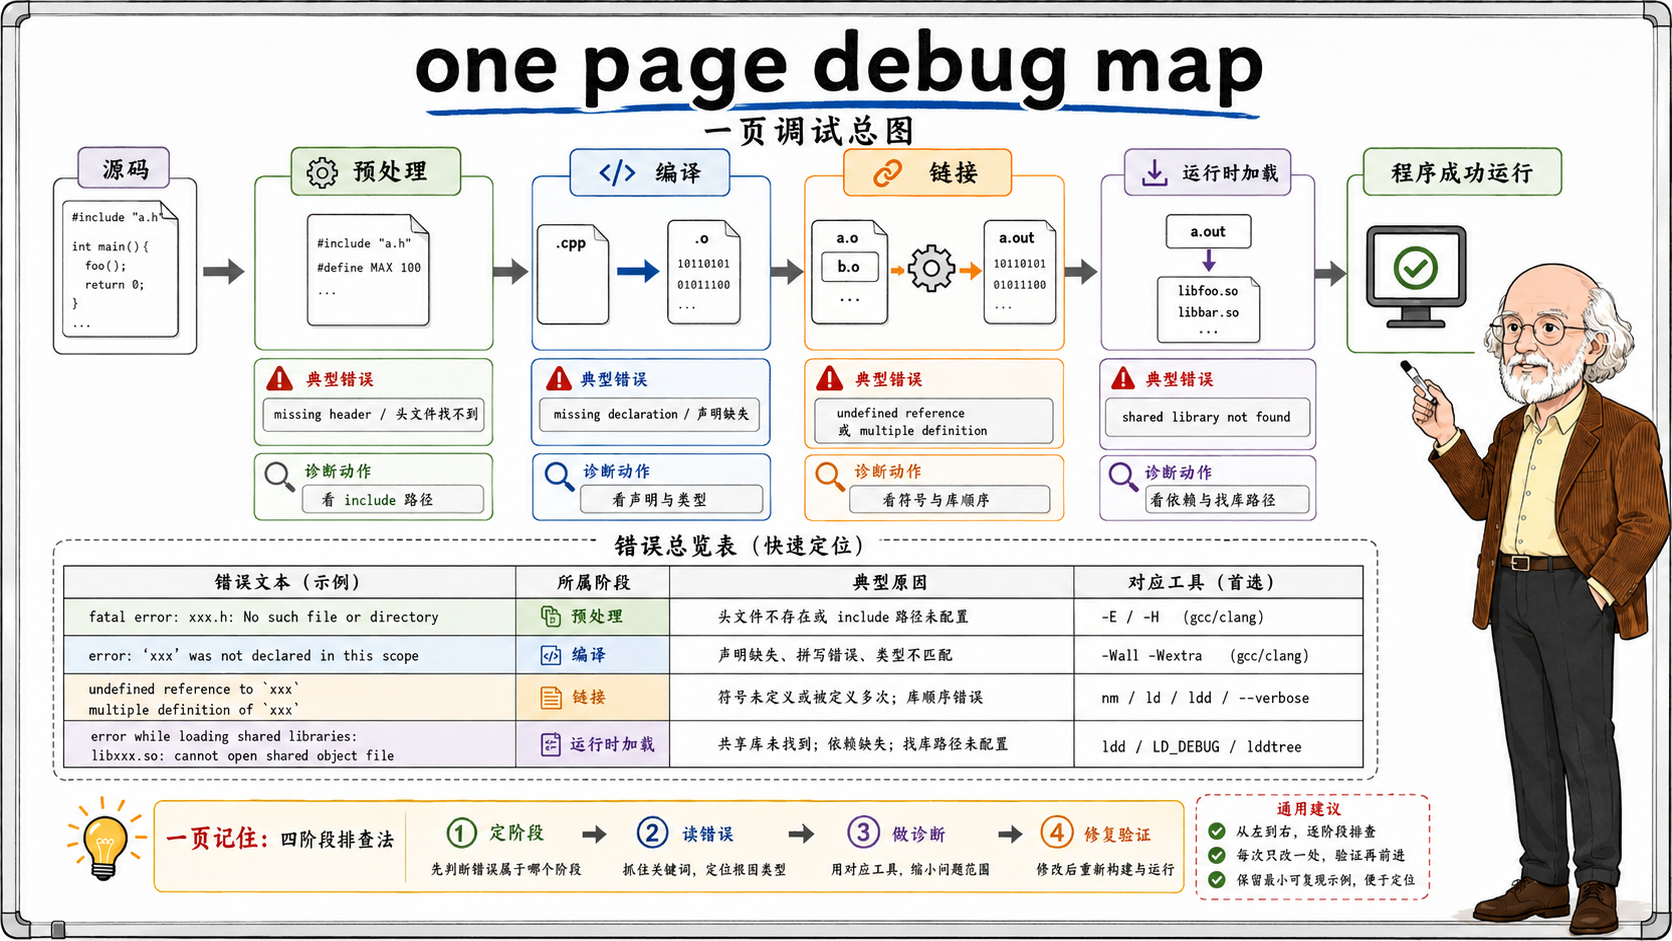
本系列到这里形成了一套完整模型。预处理把文本合成翻译单元,编译器只检查当前翻译单元,汇编器产出目标文件,目标文件用符号表记录供给和需求,链接器做全局符号配对,静态库提供一包可抽取的目标文件,动态库把依赖延迟到运行时装载。遇到错误时,把错误放回这条链路。缺头文件查预处理路径,缺声明查当前翻译单元,缺定义查链接输入,重复定义查 ODR,动态库启动失败查运行时路径。
真正稳定的 C++ 排错习惯就是这条:先定位阶段,再改对应输入。不要把所有错误都归结为"编译器抽风",也不要把所有找不到都交给 include path。阶段判断一旦准确,很多看起来复杂的构建错误会变成几次有方向的检查。
阅读导航



