
C++ ODR 单一定义规则:头文件与重复定义错误
C++ ODR 单一定义规则:头文件与重复定义错误
C++标准里有一个规则叫 One-Definition Rule,简称 ODR。它管的是一件事:同一个实体在一个程序里最多能被定义多少次。这个名字听起来像是标准委员会为了严谨搞出来的条文细节,但 ODR 在多文件 C++ 项目里引发的 multiple definition 错误,是所有 C++ 程序员都会撞上的问题。更麻烦的是,这个错误的触发路径和大多数初学者的直觉刚好相反。include guard 已经加了,单个 .cc 编译也过了,偏偏链接的时候链接器说"这个符号重复定义了"。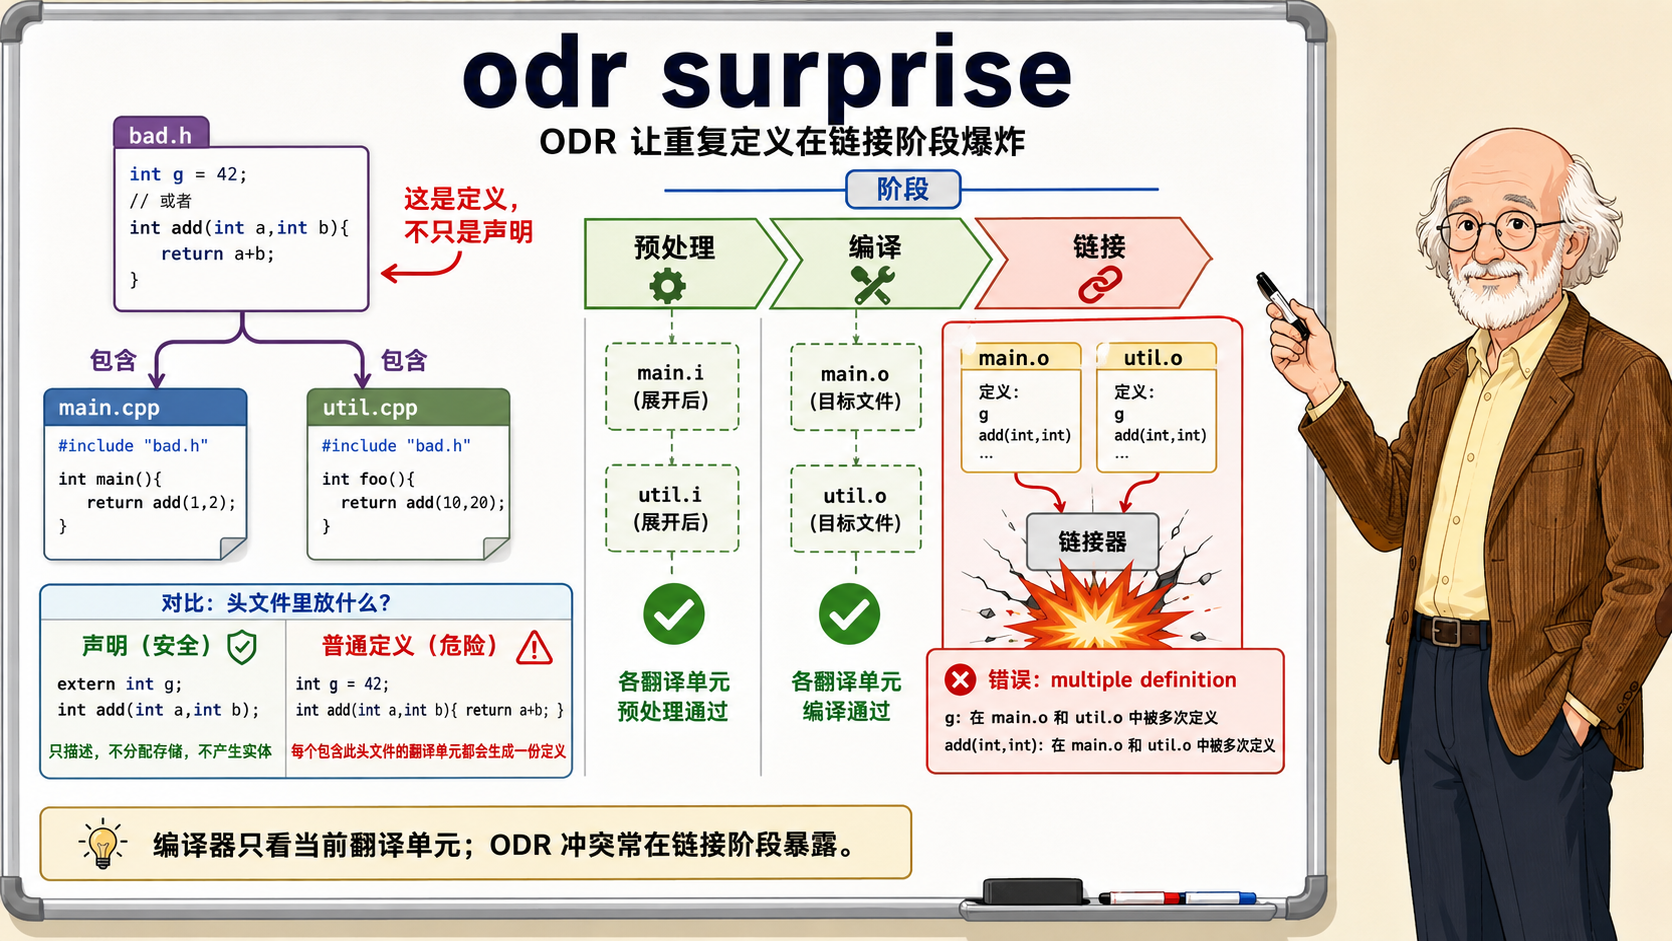
用一个具体的错误来建立直觉。写一个头文件 bad_math.h,里面放了一个带 include guard 的普通函数定义:
// bad_math.h
#ifndef BAD_MATH_H_
#define BAD_MATH_H_

int Add(int left, int right) {
  return left + right;
}

#endif
头文件本身没问题,include guard 也有。然后准备两个 .cc,分别 include 它:
// a.cc
#include "bad_math.h"

int UseA() {
  return Add(1, 2);
}
// b.cc
#include "bad_math.h"

int UseB() {
  return Add(3, 4);
}
再写一个 main.cc,声明 UseA 和 UseB 并调用它们:
// main.cc
#include <iostream>

int UseA();
int UseB();

int main() {
  std::cout << UseA() + UseB() << "\n";
  return 0;
}
分别编译三个 .cc:
clang++ -std=c++20 -Wall -c a.cc -o a.o      # 通过
clang++ -std=c++20 -Wall -c b.cc -o b.o      # 通过
clang++ -std=c++20 -Wall -c main.cc -o main.o # 通过
全部编译通过,include guard 也起了作用(每个翻译单元内部 Add 只被定义了一次)。链接这一步:
clang++ main.o a.o b.o -o app
链接器报错:multiple definition of 'Add(int, int)'。a.o 和 b.o 各提供了一份 Add 的函数体,链接器在合并符号表时看到了两个同名的外部可见符号,拒绝继续。
这个场景是 ODR 违规的最常见形态:头文件里放了普通函数定义,被多个翻译单元 include 后,每个翻译单元各自产出一份函数定义的目标代码。Include guard 保障了单个翻译单元内部不重复展开,但保障不了两个不同的翻译单元各自展开一次。ODR 管的是整个程序范围的唯一定义要求,include guard 的管辖范围止于当前翻译单元。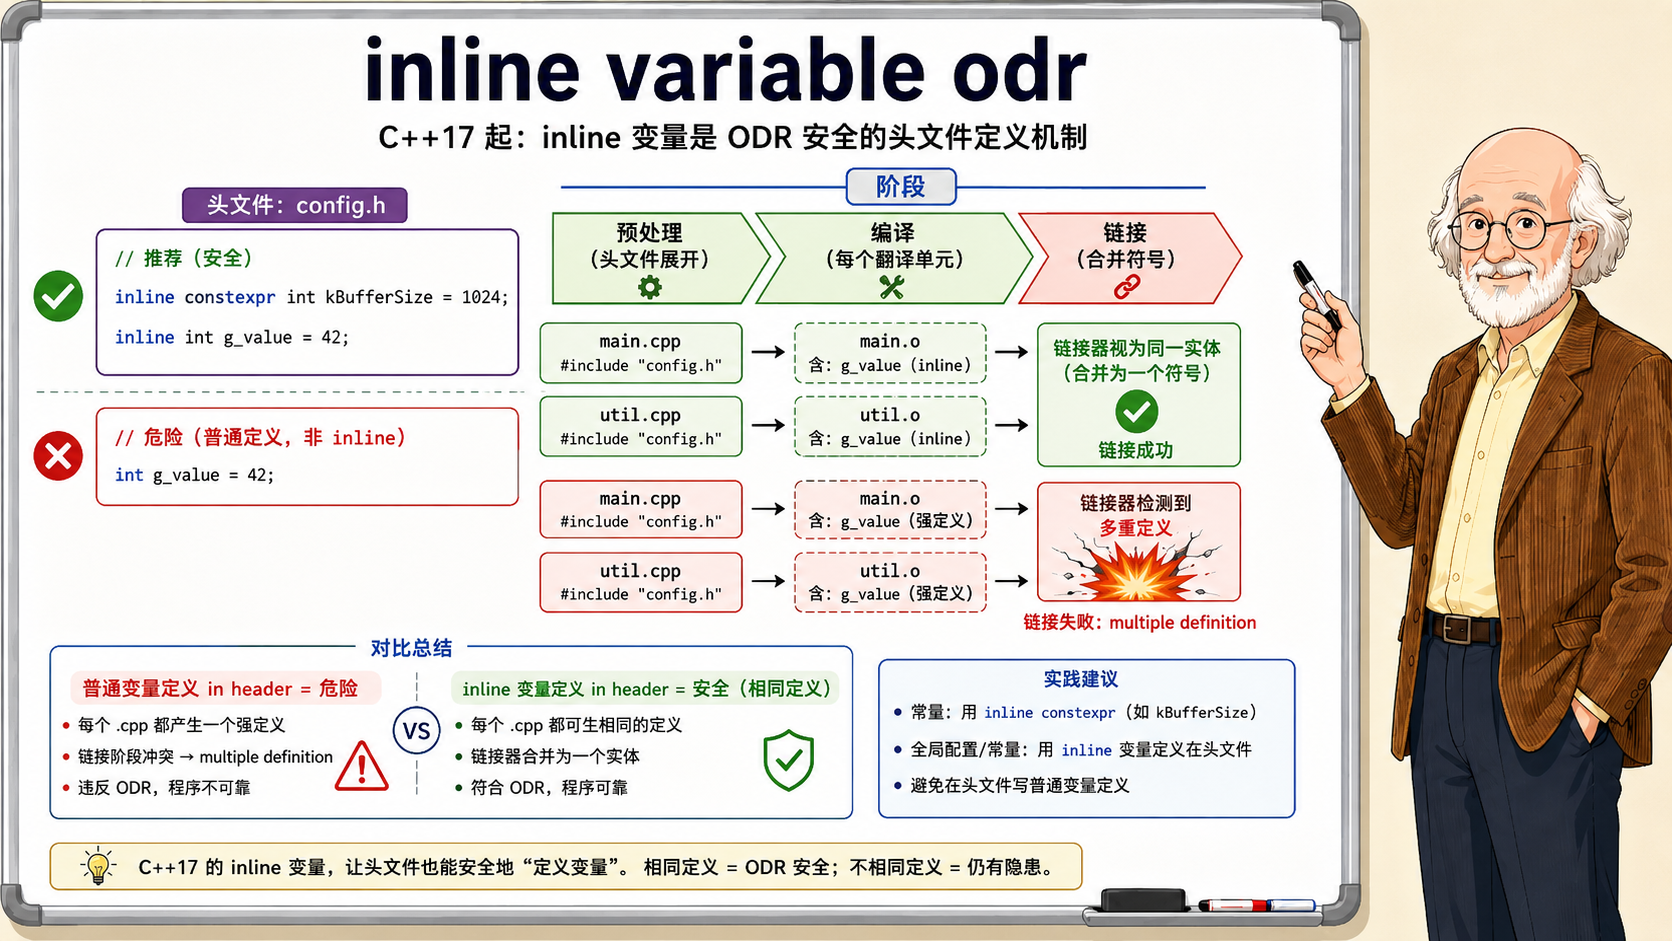
ODR 的核心规则用一句话可以概括:在整个程序中,每个非内联函数、全局变量和静态数据成员只能有一个定义。这个"整个程序"的范围包含了所有参与链接的翻译单元产出的目标文件和库。编译器在处理单个翻译单元时无法执行 ODR(它看不到其他翻译单元的内容),ODR 的最终裁决者实际上是链接器。链接器在遍历所有输入的目标文件和库的符号表时,如果发现某个应该有唯一定义的符号出现了多次,就报 multiple definition。
但 ODR 不是一条死规则。C++标准在 ODR 中明确列出了一组例外:允许出现在多个翻译单元中但内容必须一致的实体。这些例外包括类定义(class / struct 的完整定义)、模板定义(函数模板和类模板的定义体)、内联函数(inline 函数,包括类内定义的成员函数)、内联变量(C++17 的 inline 变量)。这些实体之所以需要例外,原因在前面几章已经交代清楚了:编译器在实例化模板、处理类对象布局、展开内联函数时需要看到完整定义,而编译器一次只处理一个翻译单元,无法跨翻译单元查找定义。允许这些定义进入多个翻译单元是分离编译模型的必然要求,没有这些例外,多文件 C++ 程序根本没法写。
这些例外附带一个严格的约束:每个翻译单元中看到的同一个实体的定义,必须由相同的 token 序列组成。通俗说,同一个 inline 函数在 a.cc 和 b.cc 中展开后,函数体的文本必须完全一致。如果头文件里的 inline 函数定义受到宏状态影响,在不同翻译单元中展开出了不同的 token 序列,程序不合法,且编译器不要求给出任何诊断(IFNDR)。这类"不同翻译单元看到不同定义"的 ODR 违规在编译和链接阶段都不会报错,但程序的运行时行为完全未定义。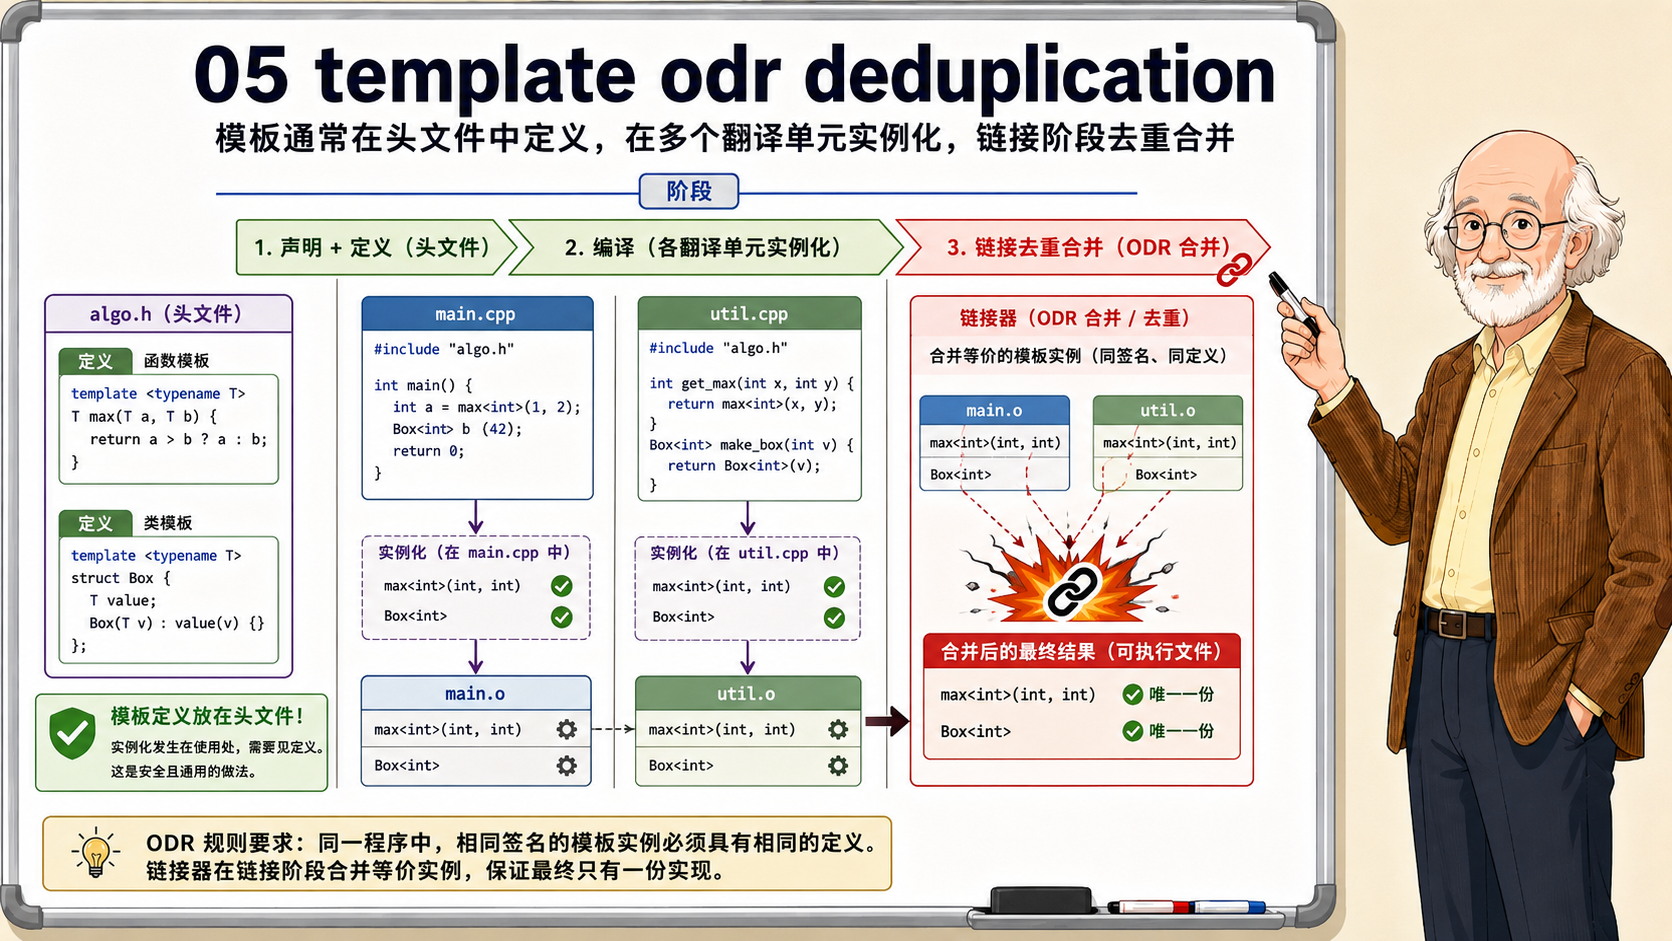
ODR 违规有两种表现时机,这取决于违规的类型。第一种是在链接期直接炸掉,链接器明确报 multiple definition。这是最常见、最好排查的情况,信号非常清楚。第二种是不报任何错误,但程序运行时行为不确定:ODR 对某些实体(特别是模板和内联函数)的"多定义但内容不一致"的情况归于 IFNDR,链接器不做检查,编译器也不做跨翻译单元的验证。不同编译器、不同优化级别下,可能随机选择了其中一份定义,也可能导致内存布局不一致引发的崩溃。这种"无声的 ODR 违规"是最危险的。
ODR 以整个程序为范围,是因为 C++ 的实体最终要在整个链接结果中共同存在。一个普通外部函数如果有两份定义,链接器无法知道调用方应该绑定到哪一份;一个全局变量如果有两份定义,程序中看似同一个状态就会变成两份存储;一个类定义如果在两个翻译单元里不一致,对象的大小、成员偏移和调用约定都可能出现分歧。编译器在单个翻译单元里只能相信自己看到的定义,链接器在合并阶段才第一次看到整个程序。ODR 正是用来把这些分散翻译单元重新约束成一个一致程序的规则。
避免 ODR 违规的工程习惯说起来不复杂。普通函数定义和普通全局变量定义放在 .cc 文件中,不要放在头文件里。头文件只放声明、类定义、模板定义、inline 函数定义、类型别名和枚举。如果一个函数体非常短,希望它放在头文件里以减少调用开销,那就明确加 inline 关键字。模板的定义虽然在语法上可以放 .cc,但大多数情况下只有显式实例化配合 .cc 定义才有实际意义,普通模板使用场景下模板定义必须放在头文件中,因为编译器在实例化时需要看到完整定义。
另外还有一条不太常被提起但同样重要的规则:一个实体即使只在程序中出现了一次定义,但如果它被多个翻译单元以不一致的方式使用,也可能构成 ODR 违规的变体。比如某个翻译单元在一个类上使用了 static_assert(sizeof(T) == 8),另一个翻译单元因为宏不同导致该类的大小变成 16 字节但仍然通过编译,两个翻译单元各自的行为推断不一致,同样属于未定义行为范畴。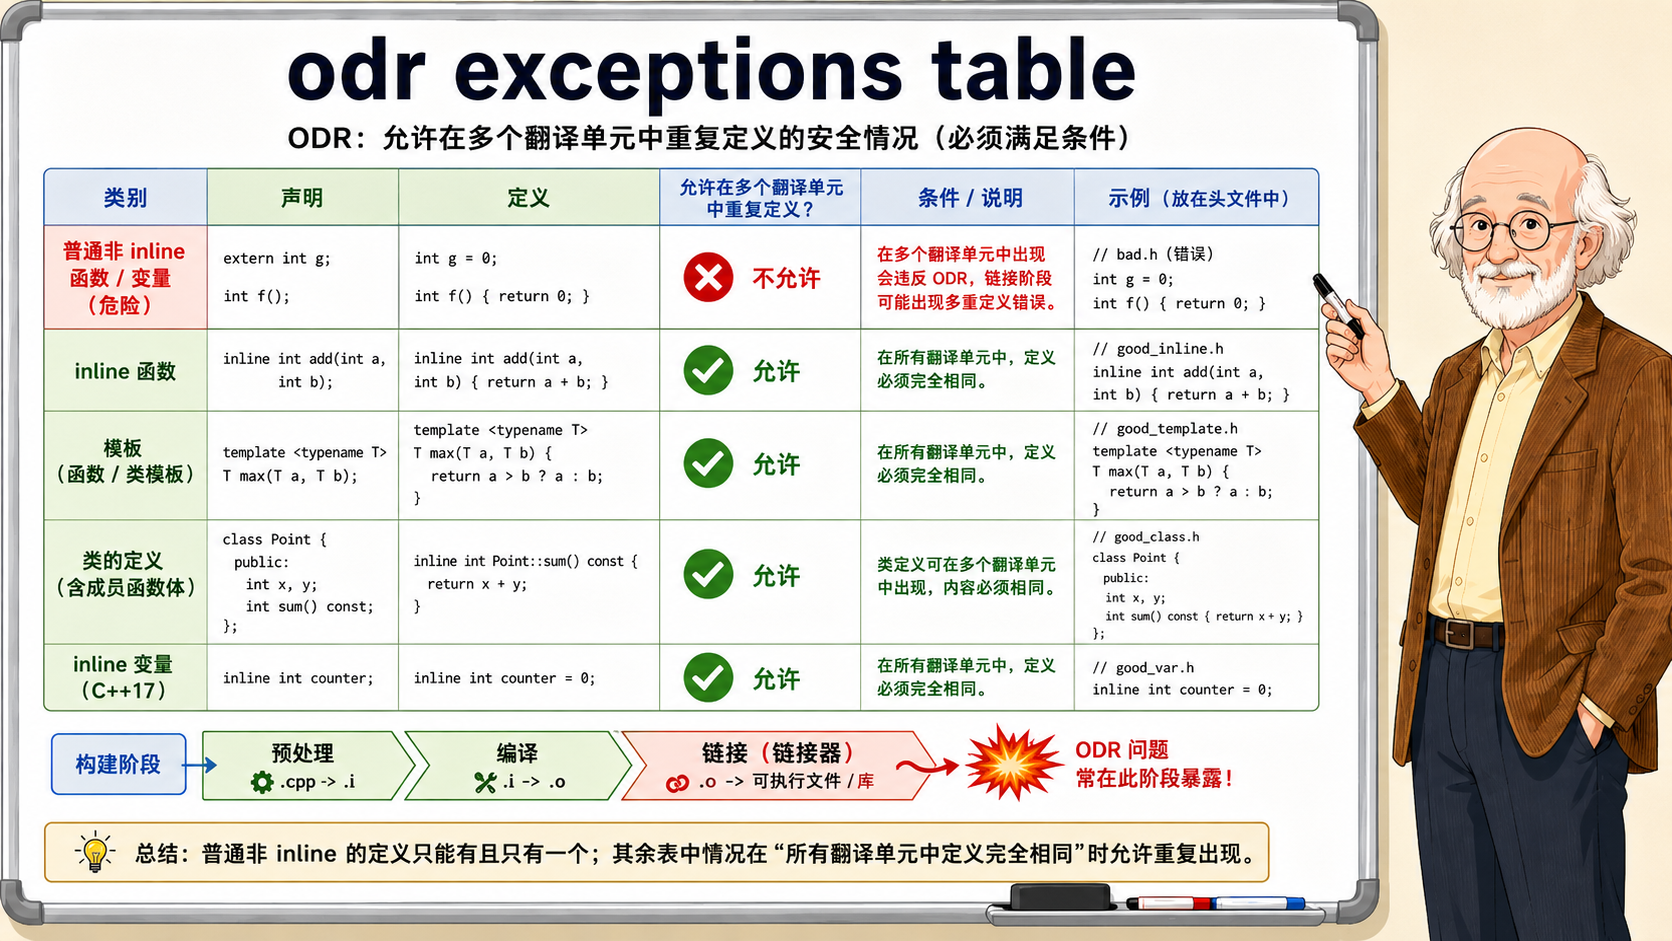
宏在 ODR 问题中扮演了一个容易被忽略的帮凶角色。假设一个头文件里定义了一个类,类的成员函数列表中某个函数的签名依赖于宏:
// widget.h
#ifndef WIDGET_H_
#define WIDGET_H_

struct Widget {
  int GetValue() const;
#ifdef ENABLE_EXTENDED
  int GetExtendedValue() const;
#endif
};
如果 a.cc 在 include widget.h 之前定义了 ENABLE_EXTENDED,而 b.cc 没有定义它,那么两个翻译单元实际看到的 Widget 类定义是不同的。这种不一致不会触发编译错误(各自语法正确),链接阶段也可能因为符号实际上都能对上而不报错,但程序的运行时行为已经是未定义的。函数成员列表不同已经足以违反 ODR;如果条件编译控制的是数据成员,问题会更直观:a.cc 认为 Widget 对象包含额外字段,b.cc 认为没有这个字段,同一个对象在两个翻译单元里的大小和成员偏移就不一致。对象布局不一致导致的数据损坏通常以非常隐蔽的方式表现出来。
头文件自包含(self-contained)原则是防范这类问题的一线手段。一个自包含的头文件,指它不依赖任何在 include 之前必须由使用者定义的外部宏、不依赖特定的 include 顺序、不假设某个符号在翻译单元中已经被声明。做到这一点的头文件,在任何翻译单元的任何位置被 include,展开后的内容都一致,ODR 例外实体的定义一致性自然就有了保障。代码审查时如果一个头文件在 include 之前要求使用者先 #define 某个宏才能正常工作,这通常是设计上的坏味道,值得重构。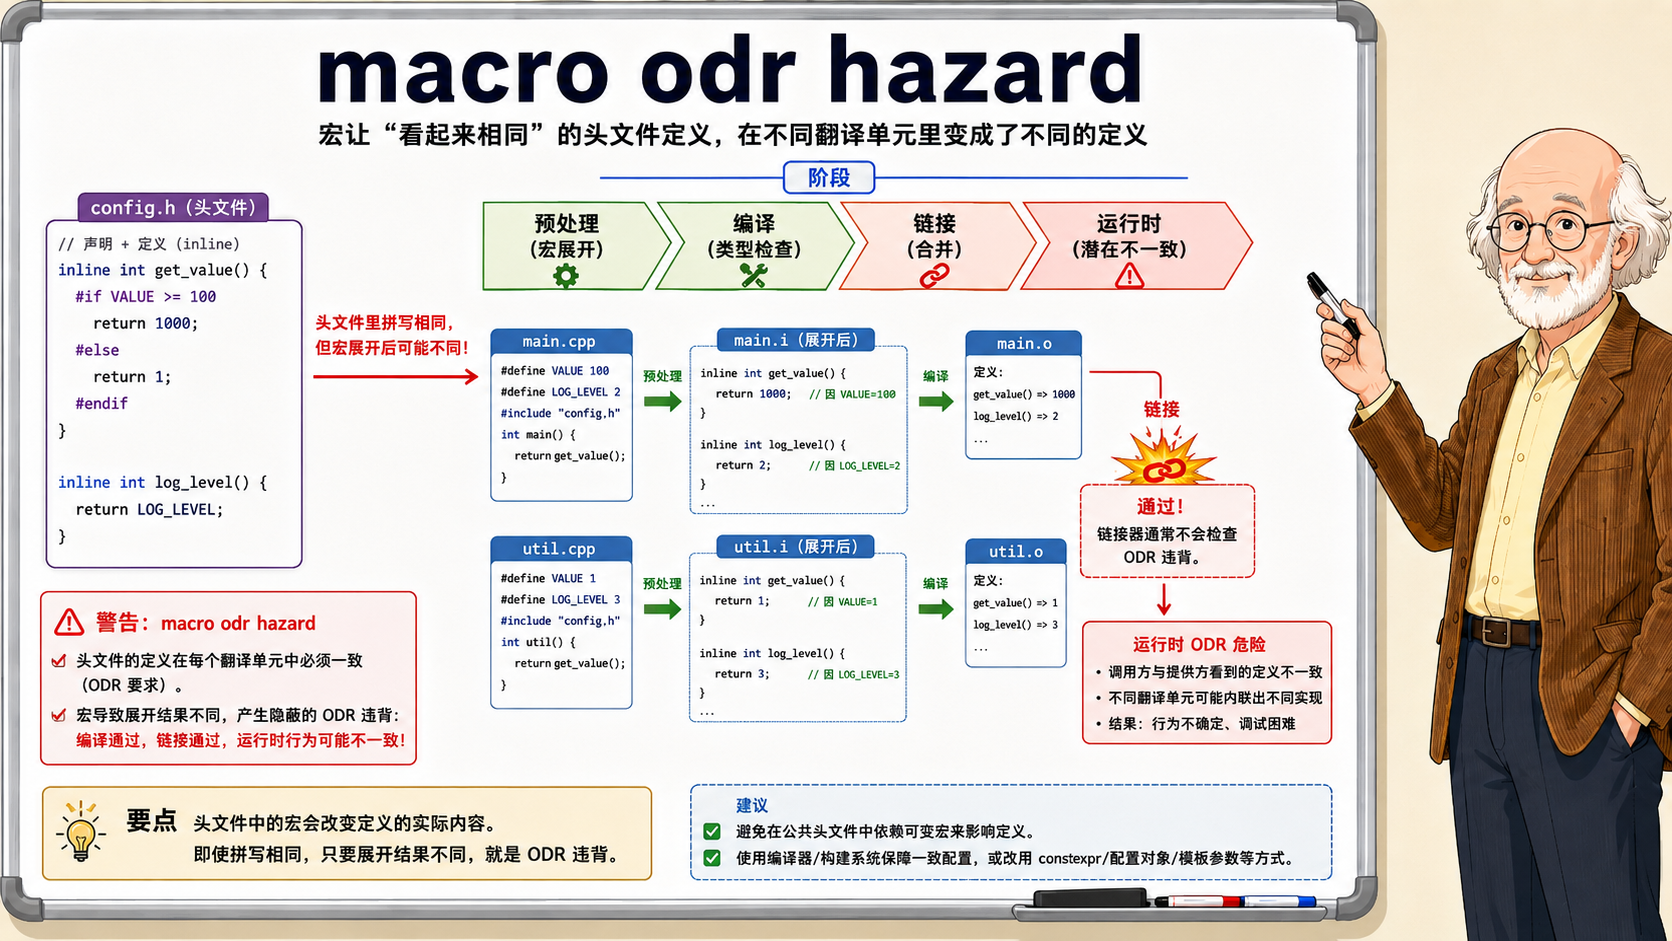
ODR 在模板上的表现有自己的一套规则。函数模板和类模板的定义可以出现在多个翻译单元中,但同一个模板的同一组模板实参在所有翻译单元中最多只能有一次显式实例化定义。这意味着你可以在头文件里放模板定义并让多个 .cc 自由使用,编译器会在每个翻译单元对每个被实际使用的模板实参组合生成实例化代码。链接器在最终阶段遇到多个翻译单元产生的相同模板实例化代码时,会执行去重(deduplication),保留一份而丢弃其余。这个过程叫"链接器去重",是链接器为了支持模板和 inline 函数的多定义场景而内置的能力。
链接器去重有一些微妙的边界。它不是魔法,只能去重完全相同的代码段。链接器在判断两个同名符号是否可以合并时,通常会比较对应的 section 内容的哈希值或逐字节对比。如果两个翻译单元因为宏状态不同而对同一个模板的同一组实参生成了不同的实例化代码,链接器无法识别它们是同一个逻辑实体。对于 inline 函数和隐式模板实例化产生的符号,不同编译器采取了不同策略:有的链接器对同名弱符号(weak symbol)直接保留任意一份,有的会报重复定义。无论哪种处理方式,只要定义不一致,程序的最终行为都是不可靠的。
显式实例化(explicit instantiation)是模板作者控制模板实例化位置的机制:在某个 .cc 文件中写 template int Add<int>(int, int);,编译器在那个翻译单元中生成该模板实参组合的实例化代码,其他翻译单元看到这个声明或模板定义后知道实例化已经存在,不会重复生成。这既减少了编译时间,也避免了链接器去重的额外工作。在大型模板库中,显式实例化配合 extern template 声明是控制编译负担的重要工具。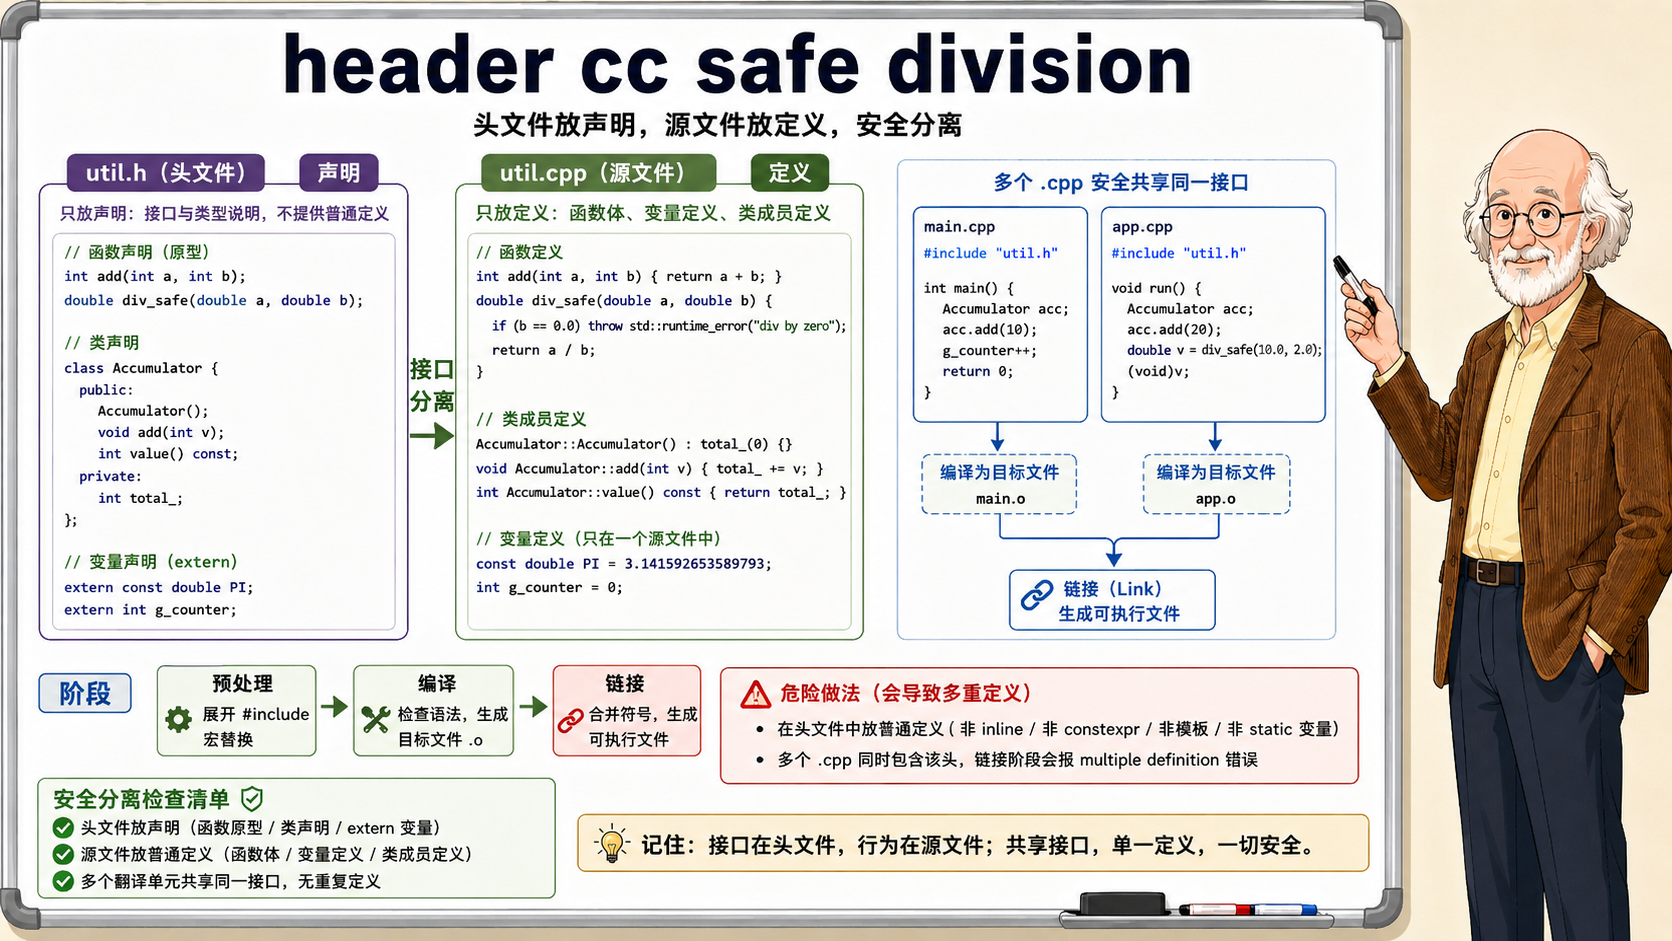
C++17 引入的 inline 变量让全局变量的 ODR 规则和 inline 函数对齐了。在 C++17 之前,头文件里不能放命名空间作用域的变量定义(const 的变量因为默认内部链接是个例外)。如果你需要一个在所有翻译单元中共享的全局变量,必须在一个 .cc 里定义它,在头文件里放 extern 声明。C++17 的 inline int g_config = 1; 允许这个定义直接出现在头文件中,每个 include 它的翻译单元各看到一份,链接器负责保留一份。这消除了之前在头文件中放全局变量需要绕的各种弯。
inline 变量同样受 ODR 例外的一致性约束:所有翻译单元中同一个 inline 变量的定义必须由相同的 token 序列组成,包括初始化器。如果头文件中的 inline int g_limit = MAX_DEFAULT; 在不同翻译单元中因为 MAX_DEFAULT 宏的值不同而展开出不同的初始化值,这是 ODR 违规,属于 IFNDR。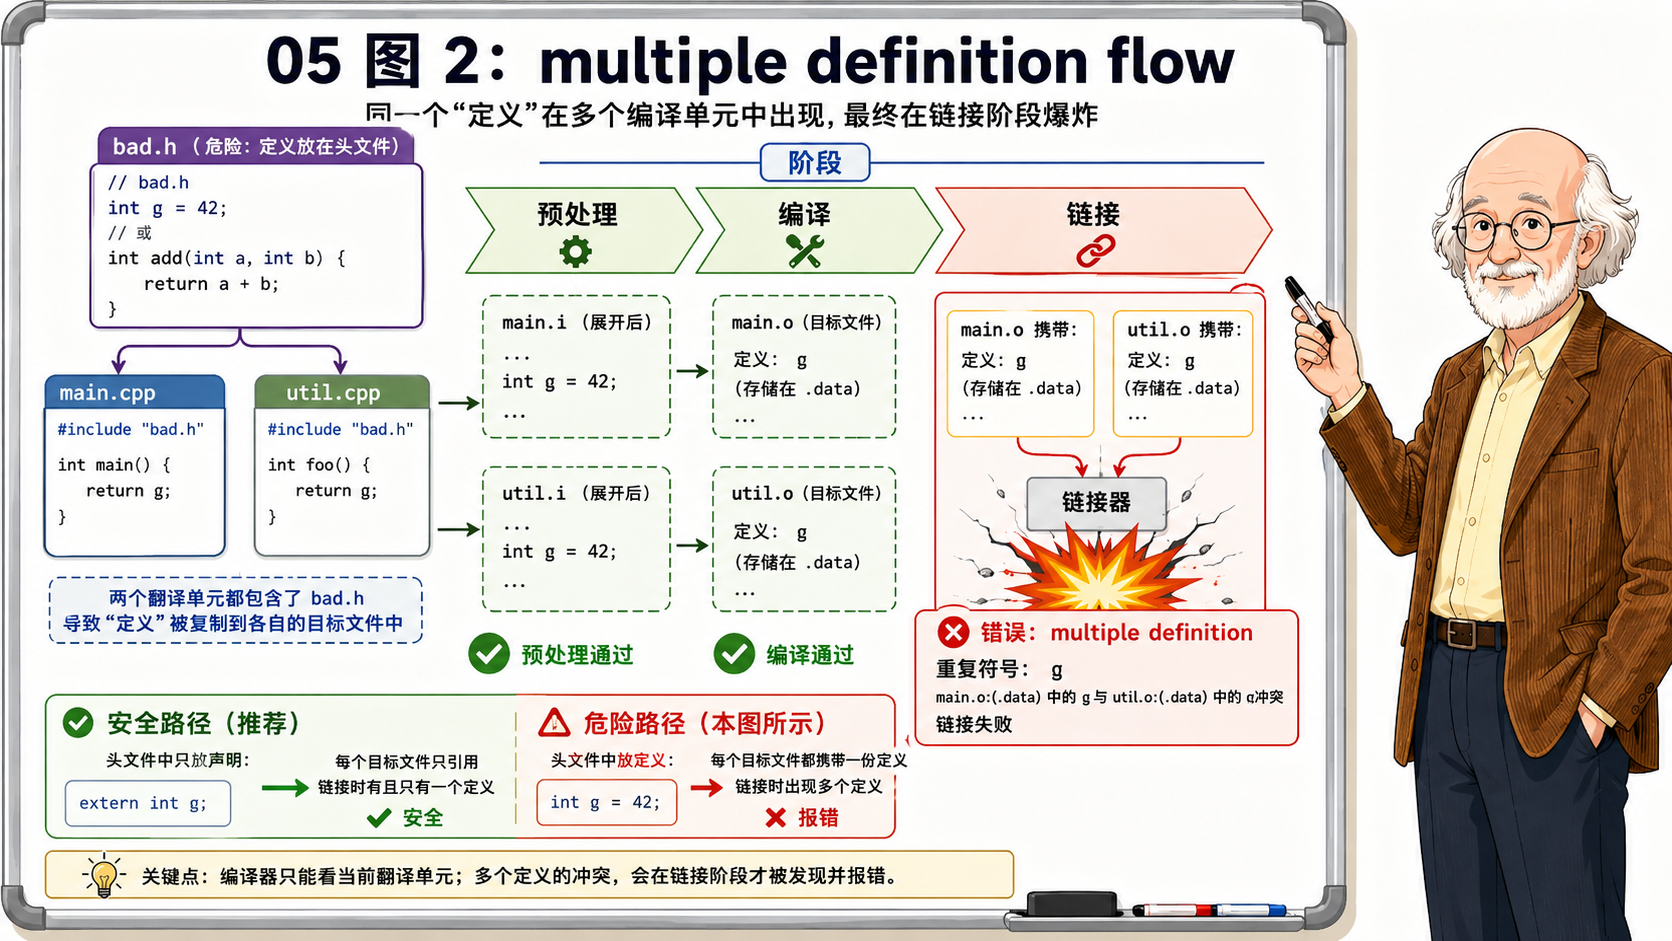
ODR 和 include guard 的对比,是本系列反复强调的一个核心区分。Include guard 守护的是同一个翻译单元内部的重复。#ifndef 加上 #define 让预处理器在第一次看到头文件时把它展开,下一次再看到同一个头文件时直接跳过。如果有人在一个 .cc 里同时写了 #include "math.h" 和通过另一条路径间接 include 了同一个 math.h,include guard 确保 math.h 在这个翻译单元里只展开一次。没有 include guard,同一个翻译单元内同一个结构体可能被定义两次,编译器直接在编译阶段报错。
ODR 守护的是整个程序的重复。即使每个翻译单元内部因为 include guard 保证了没有重复展开,两个不同的翻译单元各自产生了一份相同的函数定义,链接器仍然会报 multiple definition。Include guard 挡不住 ODR 违规,因为 ODR 违规发生在 include guard 已经完成使命之后的阶段。这个区分之所以重要,是因为很多初学者在头文件里放函数定义后触发 multiple definition,第一反应是检查 include guard 有没有写错。Include guard 写对了,问题在别处:函数体本来就该移到 .cc 文件里,或者加上 inline。
可以给这两种保护机制配一个形象的记忆锚点:include guard 是"翻译单元内的去重器",ODR 是"翻译单元间的执法者"。前者靠宏的状态做文本跳跃,在预处理层面工作;后者靠链接器的符号表做全局审计,在链接层面裁决。二者各管一摊,互不替代。用一个带函数定义的头文件做实验,分别验证 include guard 存在时单个翻译单元的编译结果、以及两个翻译单元各自 include 它之后的链接结果,这套对比实验有助于把两层保护机制的管辖范围真正区分清楚。如果只做过预处理输出的实验(看 include guard 如何阻止二次展开),没做过跨翻译单元的链接实验(看 ODR 如何报 multiple definition),对 C++ 多文件编译模型的认知就少了一块关键拼图。
排查 ODR 违规有一个实用的流程。遇到 multiple definition 错误,链接器通常会告诉你是哪个符号重复了,以及哪两个目标文件各提供了一份定义(Clang 和 GCC 的错误信息里通常会列出 first defined here 和 multiple definition 两个位置)。拿到符号名和目标文件名之后,追溯这两个 .cc 文件各自 include 了哪些头文件,定位到定义出现在哪个头文件里。如果定义是普通函数体或普通全局变量、没有 inline 修饰,解法是把它移到其中一个 .cc 中(或者它自己的 .cc 中),头文件只保留声明。如果定义本来就是 inline 函数却仍然报了重复定义,检查不同翻译单元中该 inline 函数展开后的内容是否一致,宏污染是这里最常见的元凶。
对于那些"静默"的 ODR 违规(没有链接错误,但运行时表现异常),排查思路需要从符号层面转到源码一致性检查。如果怀疑某个头文件在不同翻译单元中展开出了不同的内容,用 clang++ -E 分别对两个 .cc 做预处理输出,然后在两份输出中搜索同一个类名或函数名,对比实际展开的 token 序列是否一致。差异可能来自宏、#ifdef 分支、include 顺序导致的重定义,或者是 #pragma once 和 include guard 混用造成的边缘情况。
把三类后果分开,排查会更快。multiple definition 是重复提供普通外部定义,修头文件和 .cc 分工。undefined reference 是声明已经让编译通过,但链接阶段没有找到定义,修目标文件列表、库列表或缺失实现。IFNDR 是多个翻译单元看到的定义不一致,工具可能不报错,修宏、条件编译和头文件自包含。ODR 不是单纯的"不要重复写代码",它真正要求的是整个程序对同一个实体形成同一个理解。只要多个翻译单元对同一个实体产生了不同理解,程序就已经踩进了不可靠区间。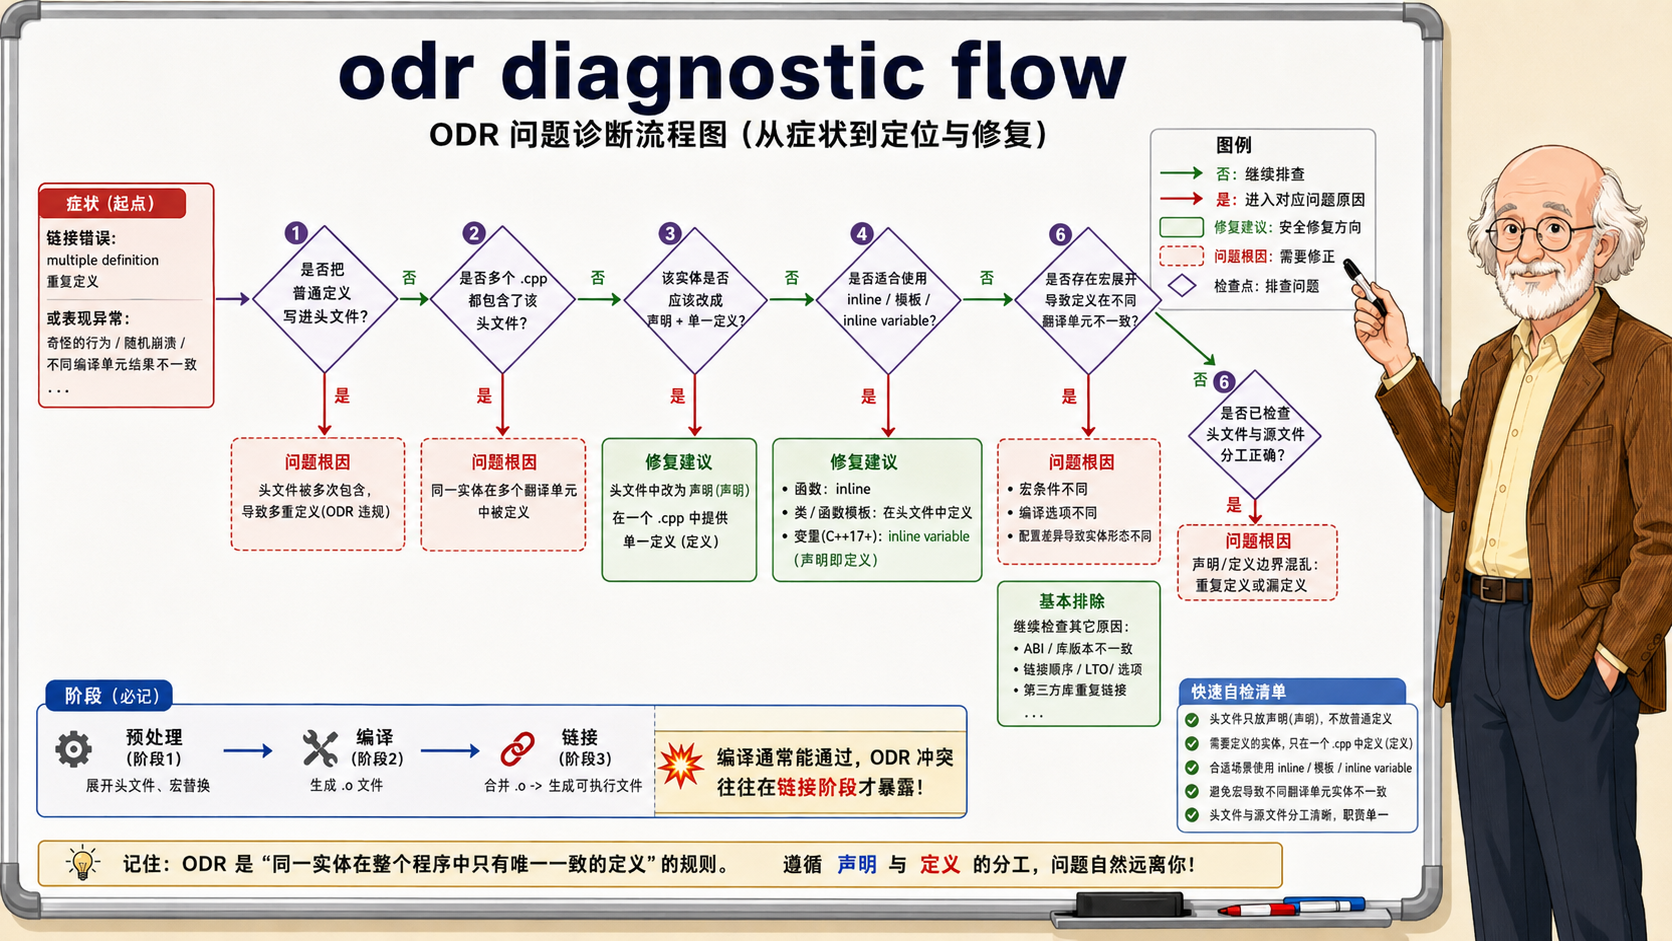
工程上最稳的做法,是让头文件保持可重复、可预测、可独立包含。普通实现进 .cc,共享接口进 .h,确实需要跨翻译单元重复出现的定义必须属于类定义、模板定义或 inline 实体。宏只用来控制平台差异和编译开关,避免让它改变公共类型布局和公共函数定义。这样写代码看起来更保守,但它换来的是链接行为可预测、二进制边界清晰、后续排错成本低,也更适合团队协作和长期维护。工程越大,这条纪律越值钱。
阅读导航



