
Redis 数据结构
Redis 数据结构
1. Redis 有几种数据表现形式?分别是什么?有哪些应用场景?
如果按照传统面试口径回答,Redis 有 5 种经典基础数据类型:
- String
- Hash
- List
- Set
- Sorted Set(ZSet)
不过严格来说,现代 Redis 已经不止这五种类型,还支持 Stream、Bitmap、Bitfield、HyperLogLog、GEO,以及新版本中的 JSON、Time Series、Vector Set 等。因此面试时最好先说明:
通常所说的 Redis 五种数据类型,指的是 String、Hash、List、Set 和 Sorted Set。除此之外,Redis 还提供 Stream、Bitmap、HyperLogLog、GEO 等扩展数据结构。
1. String:字符串
String 是 Redis 最基础的数据类型,可以保存文本、整数、浮点数、序列化对象和二进制数据。
常用命令包括:
SET、GETMSET、MGETINCR、DECRSETNXSET key value EX seconds
典型应用场景:
- 缓存对象、页面片段和接口结果;
- 计数器,例如文章阅读量、点赞数、库存和粉丝数;
- 分布式锁,例如使用
SET key value NX PX; - 验证码、登录令牌和临时状态;
- 分布式限流中的计数器。
需要注意:如果缓存的是完整对象,更新单个字段通常需要重新序列化整个对象;需要频繁修改对象字段时,Hash 可能更加合适。
2. Hash:哈希
Hash 是一个 field-value 映射表,适合保存具有多个属性的对象。
例如:
user:1001
  name  -> Chef
  age   -> 25
  city  -> Shanghai
常用命令包括:
HSET、HGETHMGETHDELHINCRBYHGETALL
典型应用场景:
- 用户信息;
- 商品信息;
- 购物车中“商品 ID—数量”的映射;
- 对象状态和配置项;
- 一组相关计数器。
Hash 可以只读取或更新对象中的某个字段,不需要读取整个对象。Redis 7.4 还开始支持为单个 Hash 字段设置过期时间,但生产环境中需要确认实际使用的 Redis 版本是否支持。
3. List:列表
List 是按照插入顺序排列的字符串序列,允许元素重复。它支持在列表两端快速插入和删除元素。
常用命令包括:
LPUSH、RPUSHLPOP、RPOPLRANGELMOVEBLPOP、BRPOP
典型应用场景:
- 栈和队列;
- 最新消息列表;
- 简单的异步任务队列;
- 按时间顺序保存最近的操作记录。
需要注意:
- List 根据下标随机访问中间元素的效率不高,不适合频繁随机查询;
- List 可以实现简单消息队列,但缺少完善的消息确认、消费组和消息重放能力;
- 对可靠性要求较高的消息场景,通常优先考虑 Redis Stream;
- “粉丝列表”通常更适合 Set 或 Sorted Set,因为一般需要去重、判断关系或者按时间排序。
4. Set:集合
Set 是无序且元素唯一的字符串集合,支持高效的成员判断以及交集、并集和差集运算。
常用命令包括:
SADD、SREMSISMEMBERSMEMBERSSINTERSUNIONSDIFFSRANDMEMBER
典型应用场景:
- 数据去重;
- 用户标签;
- 点赞、收藏和关注关系;
- 抽奖或随机推荐;
- 共同好友、共同关注;
- 利用交集、并集和差集实现关系计算。
例如,可以分别使用两个 Set 保存两名用户的关注列表,再通过 SINTER 求出共同关注。
Set 只能保证元素唯一,不能维护业务顺序;如果还需要按照时间、热度或分数排序,应使用 Sorted Set。
5. Sorted Set:有序集合
Sorted Set 也称为 ZSet。它与 Set 一样,成员不能重复,但每个成员都会关联一个 score,Redis 根据 score 对成员进行排序。
常用命令包括:
ZADDZREMZRANGEZRANKZSCOREZINCRBYZRANGEBYSCORE
典型应用场景:
- 积分排行榜、礼物排行榜和热度排行榜;
- 按时间排序的关注列表;
- 优先级队列;
- 延迟任务;
- 滑动窗口限流;
- 根据分数或时间范围查询数据。
例如,排行榜中可以把用户 ID 作为成员、用户积分作为 score。更新积分后,Redis 会自动维护排名。
需要注意:Sorted Set 的成员必须唯一,但不同成员的 score 可以相同;当 score 相同时,Redis 会按照成员的字典序进一步排序。
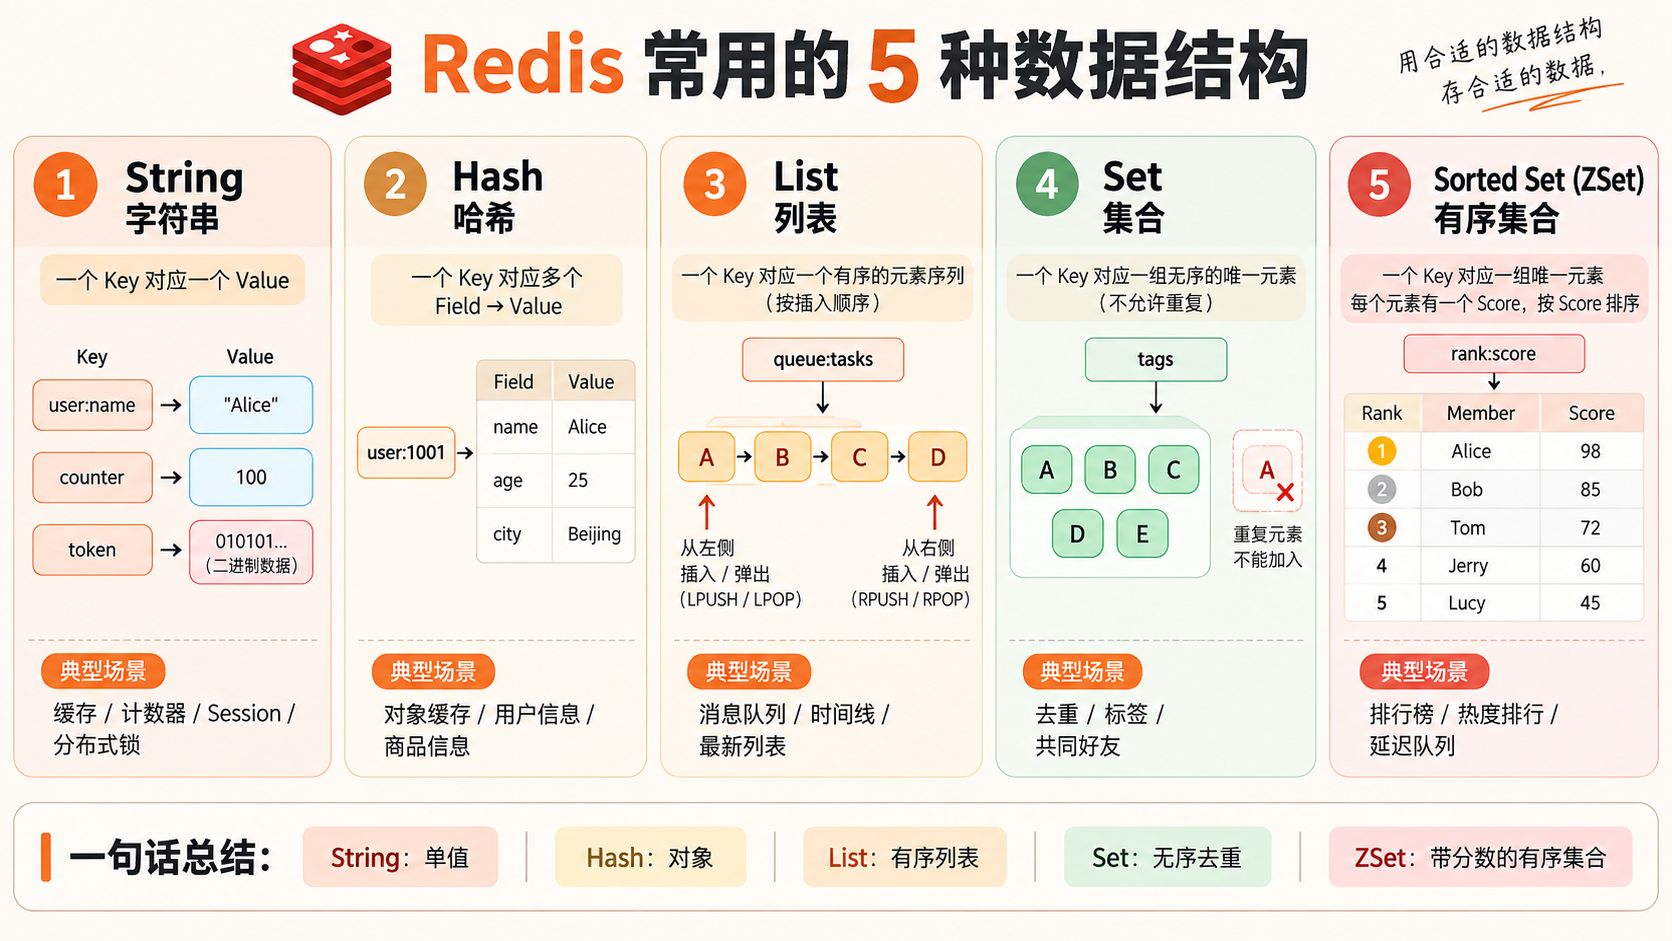
常见扩展数据类型
除了经典五种类型,面试中还经常涉及以下数据结构:
Stream
Stream 是 Redis 5.0 引入的、类似追加日志的数据结构,支持消息 ID、阻塞读取、消费组、消息确认和消息重放。
适用于:
- 消息队列;
- 事件流;
- 操作日志;
- 多消费者协作处理消息。
Bitmap
Bitmap 并不是独立的底层数据类型,而是基于 String 提供的一组位操作。
适用于:
- 用户签到;
- 活跃用户统计;
- 布尔状态记录;
- 大量用户的是非状态统计。
HyperLogLog
HyperLogLog 用于对集合基数进行概率统计,占用内存较小,但结果存在一定误差。
适用于:
- UV 统计;
- 独立访客数量;
- 大规模数据去重计数。
它只能用于近似计数,不能取回集合中的原始元素。
GEO
GEO 用于保存地理坐标并进行距离、半径或范围查询,其底层建立在 Sorted Set 之上。
适用于:
- 附近的人;
- 附近的门店;
- 配送范围判断;
- 两个位置之间的距离计算。
总结
| 数据类型 | 核心特点 | 典型应用 |
|---|---|---|
| String | 单值、支持原子增减 | 缓存、计数器、分布式锁 |
| Hash | field-value 映射 | 用户、商品、购物车 |
| List | 有序、可重复、两端操作高效 | 队列、栈、最新消息 |
| Set | 无序、元素唯一、支持集合运算 | 去重、标签、共同关注 |
| Sorted Set | 元素唯一、按照 score 排序 | 排行榜、延迟任务、滑动窗口 |
| Stream | 追加日志、消费组、消息确认 | 消息队列、事件流 |
| Bitmap | 基于位保存状态 | 签到、活跃统计 |
| HyperLogLog | 低内存近似基数统计 | UV、独立访客统计 |
| GEO | 地理位置查询 | 附近的人、门店距离 |
一句话概括:
String 适合保存单值和计数,Hash 适合保存对象,List 适合保存线性序列,Set 适合去重和集合运算,Sorted Set 适合需要排序的集合;可靠消息场景可以使用 Stream。
2. 说下 Redis 的几种底层数据结构?
共有六种:
简单动态字符串
双向链表
压缩列表
哈希表
跳表
整数数组

简单动态字符串
SDS(Simple Dynamic String)是 Redis 自己实现的动态字符串结构。与传统 C 字符串相比,它主要解决了获取长度效率低、扩容成本高、二进制不安全以及缓冲区溢出等问题。
SDS 的结构可以简化理解为
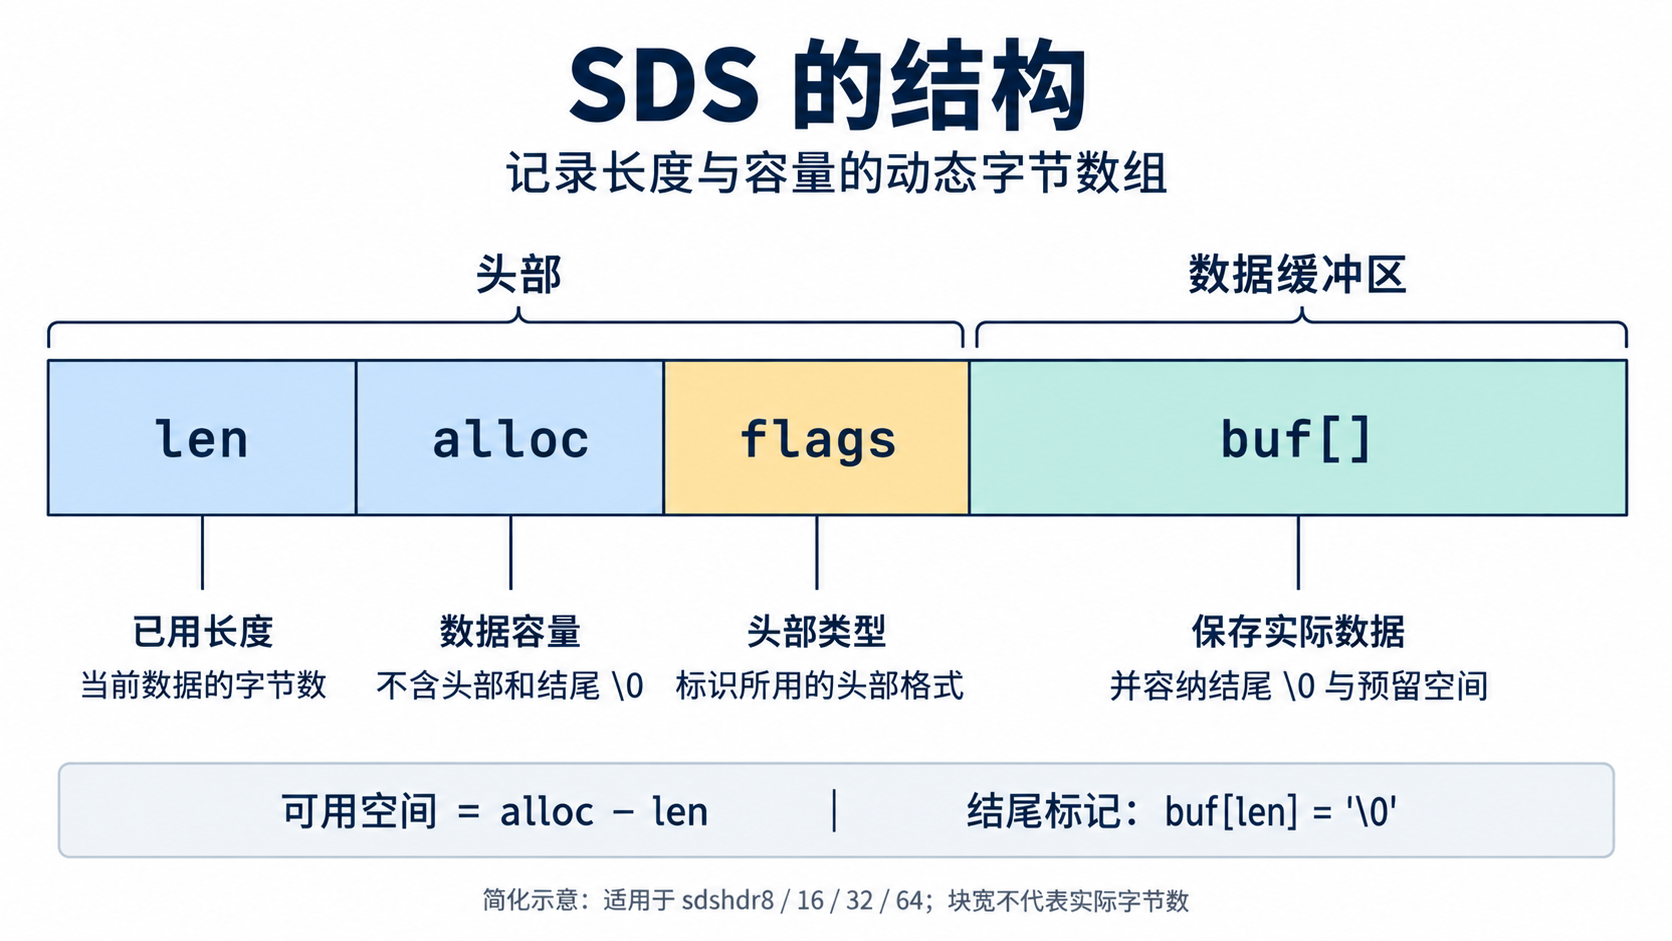
len:字符串当前实际使用的字节数;alloc:缓冲区能够保存的总字节数,不包含结尾的\0;,可用的为总的 - 已经使用的flags:记录 SDS 头部类型;buf[]:实际保存的数据。
O(1) 获取字符串长度
SDS 使用 len 字段记录字符串的实际长度,因此获取长度的时间复杂度为 O(1)。
传统 C 字符串没有单独记录长度,strlen() 必须从头遍历到结尾的 \0,时间复杂度为 O(N)。
二进制安全
C 字符串使用 \0 判断字符串结束,因此无法直接把中间包含 \0 的数据当作普通字符串处理。
SDS 根据 len 字段确定数据范围,数据中间可以包含任意字节,包括 \0,因此可以安全保存:
- 普通文本;
- 图片、音频等二进制数据;
- 序列化对象;
- 网络协议数据。
需要注意,SDS 的缓冲区末尾仍然会保留一个额外的 \0,目的是兼容部分 C 字符串函数;SDS 判断字符串结束依靠的是 len,而不是这个 \0。
空间预分配
当现有剩余空间不足时,SDS 会先扩容,再执行追加操作。在采用贪心扩容策略时,当前 Redis 源码中的规则可以概括为:
- 扩容后的所需长度小于
1 MB时,通常申请约两倍空间; - 扩容后的所需长度不小于
1 MB时,通常额外申请1 MB。
预留空间可以减少字符串连续增长时的内存重新分配次数,从而降低内存分配和数据复制的开销。
需要注意,SDS 也提供按实际需要精确扩容的非贪心接口,因此空间预分配并不是所有扩容场景都采用同一种策略。
惰性空间释放
当字符串缩短时,SDS 的部分操作通常只修改 len,不会立即缩小底层缓冲区。原来占用的空间会成为可用空间,后续字符串再次增长时可以直接复用。
例如:
原始状态:len = 10,alloc = 10
缩短之后:len = 6,alloc = 10
可用空间:alloc - len = 4
这样可以减少字符串频繁缩短和增长时产生的内存分配操作。
不过,“不会释放空间”并不是绝对规则。SDS 提供了重新调整容量和释放空闲空间的接口,Redis 在空闲空间过多等特定场景下也可能主动缩容。
降低缓冲区溢出风险
在追加数据之前,SDS 会根据 alloc - len 检查剩余空间。如果空间不足,就先进行扩容,然后再写入数据。
相比直接使用 strcat() 等 C 字符串函数,这种容量检查机制可以降低因为目标缓冲区空间不足而导致越界写入的风险。
节省头部内存
SDS 根据字符串长度使用不同大小的头部类型,例如 sdshdr8、sdshdr16、sdshdr32 和 sdshdr64。
较短的字符串使用较小的长度和容量字段,可以减少大量短字符串带来的额外内存开销。
SDS 相比传统 C 字符串的主要优势包括:
- 通过
len字段实现 O(1) 获取长度; - 通过长度而不是
\0判断数据范围,保证二进制安全; - 通过空间预分配减少连续增长时的内存分配次数;
- 通过复用空闲空间减少频繁扩容;
- 扩容前检查容量,降低缓冲区溢出风险;
- 保留结尾的
\0,兼顾部分 C 字符串函数的兼容性。
一句话概括:
SDS 本质上是一个记录了长度和容量的二进制安全动态字节数组,通过空间预分配和空闲空间复用减少内存重新分配,同时保留结尾的
\0以兼容部分 C 字符串操作。
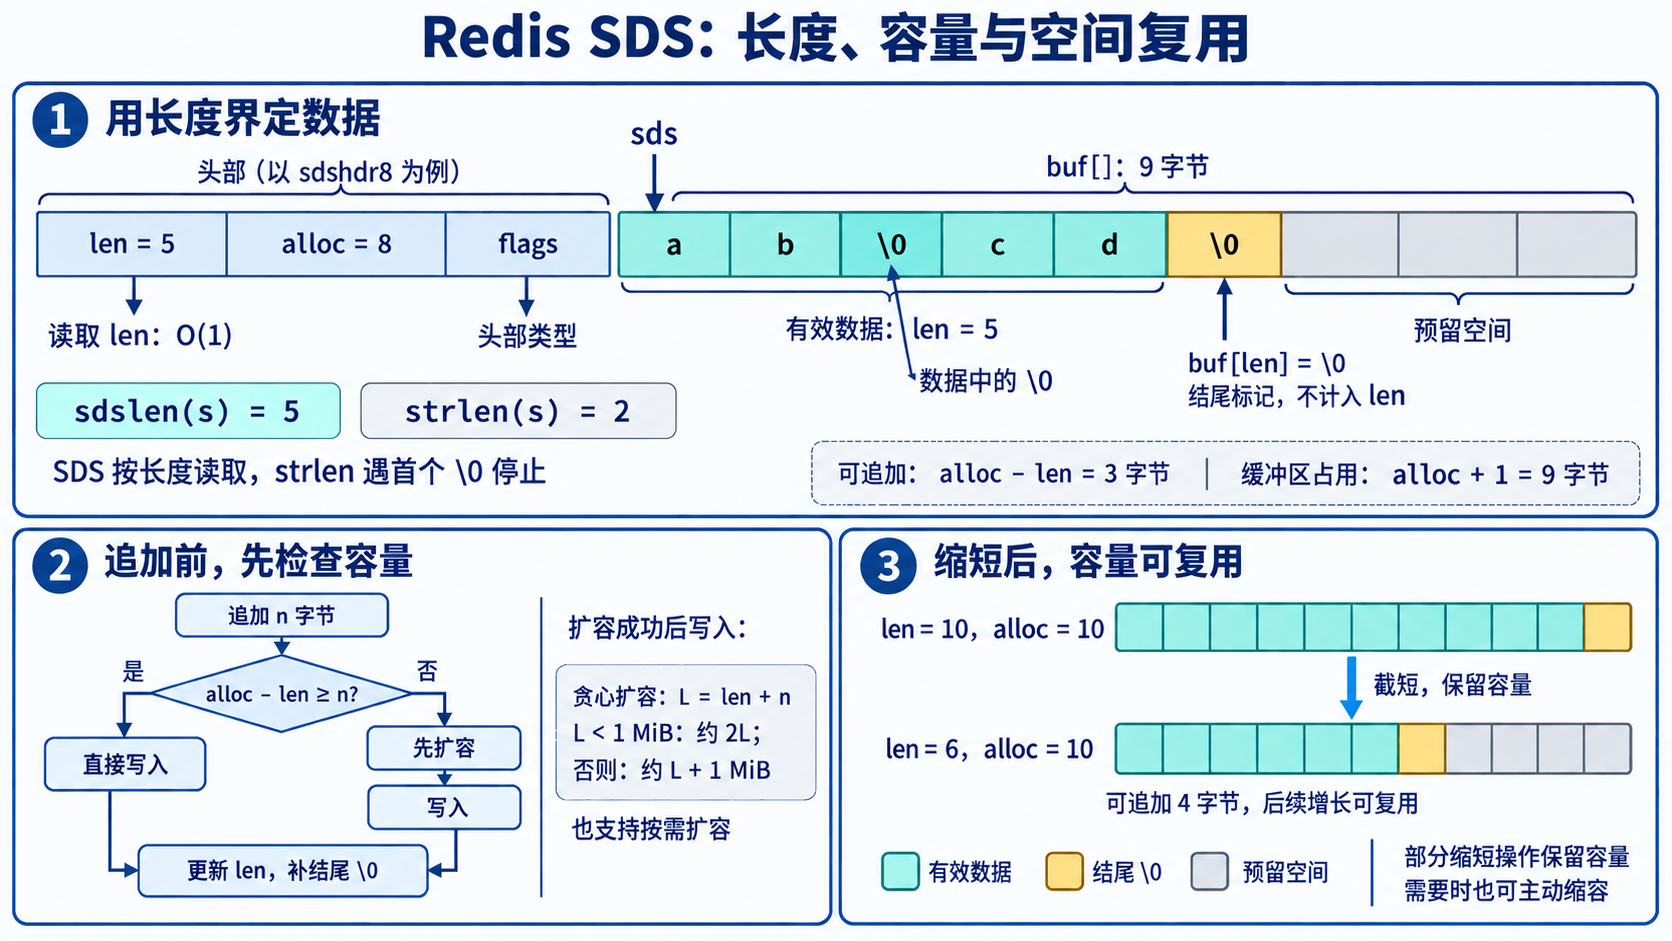
- sds 的详细示例
- 判断是否需要扩容
- 缩短后,容量复用
推荐阅读
跳表
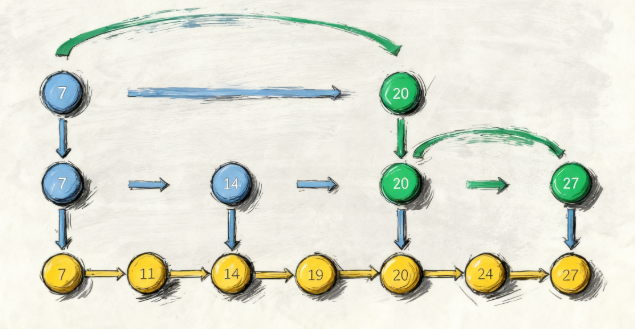
跳表是一种基于链表的数据结构,它通过在普通链表的基础上增加多级索引来实现快速查找。你可以把它想象成一座多层的立交桥:
- 底层:所有的数据都在这一层,按顺序排列
- 上层:每一层都是下一层的"快速通道",存储了部分节点的索引
这样设计的好处是:查找数据时可以先在高层快速跳跃,接近目标后再降到低层精确定位,大大提高了效率。
跳表层级结构示意图
为什么需要跳表?
上面说了,跳表是一种基于链表的数据结构,那么我们来说一下传统链表的局限
普通链表的局限
假设我们要在一个有序链表中查找元素 77
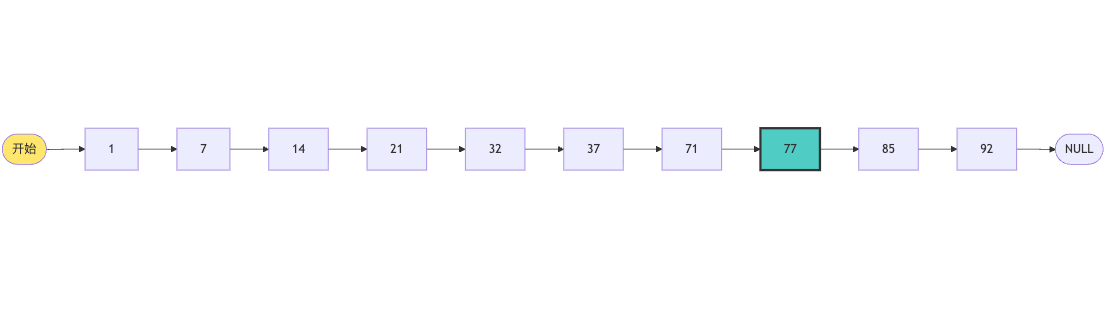
使用普通链表,我们必须从头开始,逐个节点比较,最坏情况下需要遍历 n 个节点,时间复杂度为 O(n)。
那我们想提高查找效率,应该怎么做呢?
跳表的优化思路
如果我们在链表上方建立一层索引,每隔一个节点抽取一个:
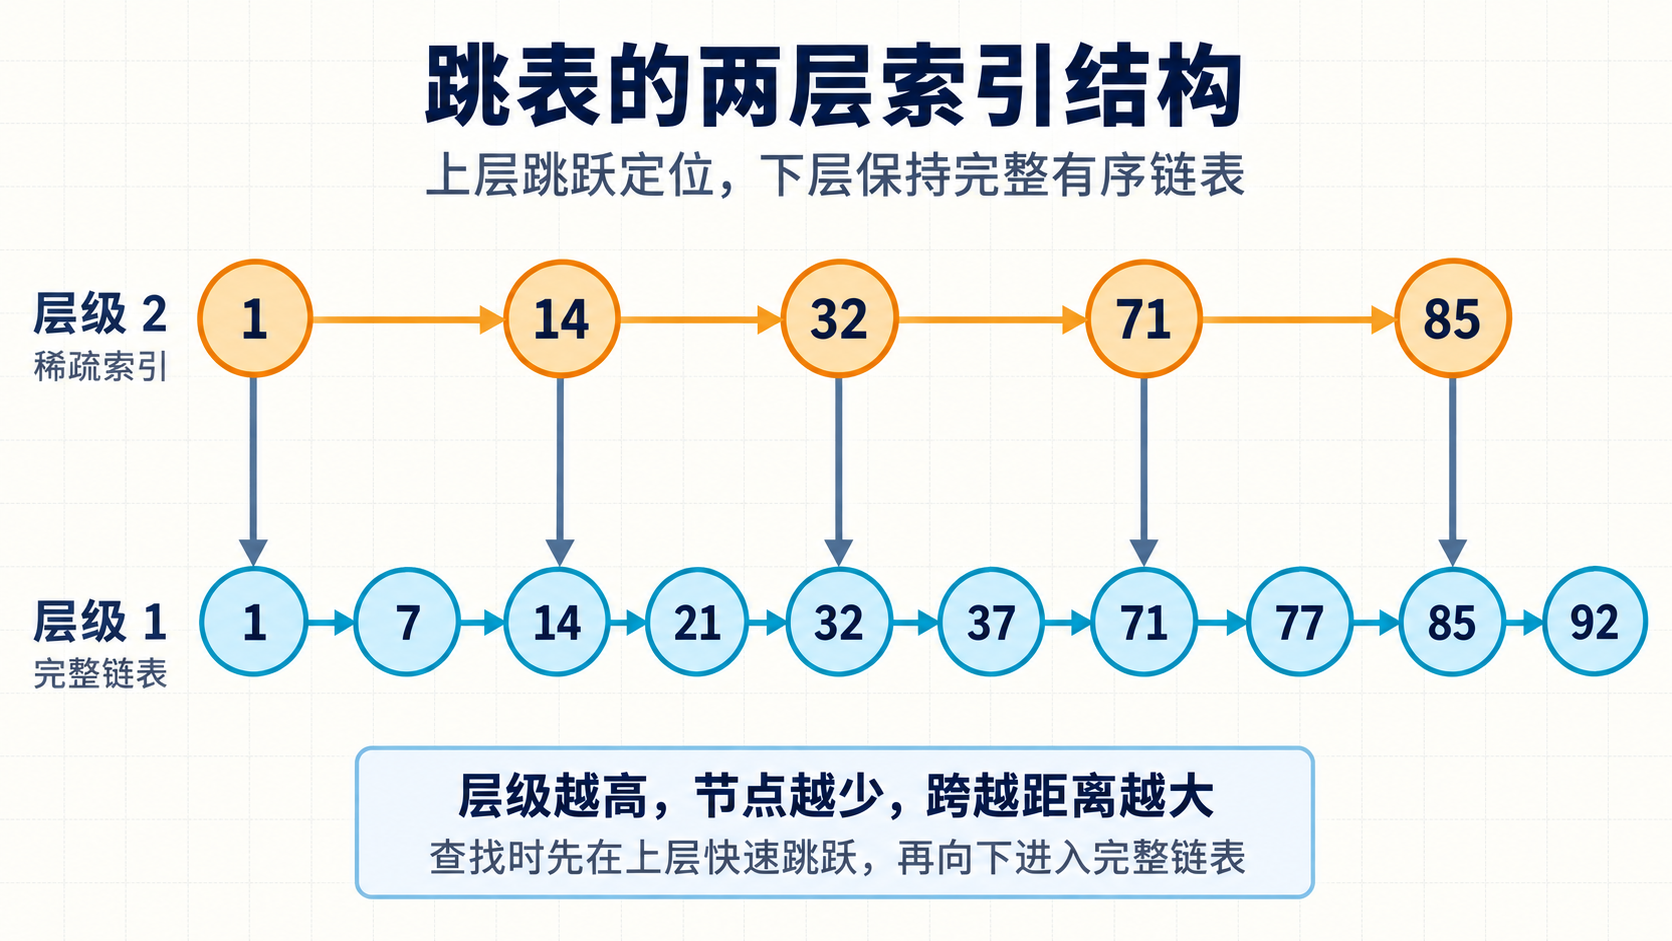
现在查找 77:
- 在层级2从1开始: 1 < 77,继续
- 到达14: 14 < 77,继续
- 到达32: 32 < 77,继续
- 到达71: 71 < 77,继续
- 下一个是85 > 77,降到层级1(从 71 降到下一级)
- 从71开始: 71 -> 77,找到!
相比原来的检索方式,效率得到了提升,如果继续增加索引层级,效率会进一步提升,这就是为什么需要跳表
跳表的结构设计
节点结构
每个跳表节点包含:
- 值(value): 存储的数据
- 多个指针(forward[]): 指向不同层级的下一个节点
// 跳表节点类
class SkipListNode {
private:
    // 节点存储的值
    int value;
    // 指向各层下一个节点的指针数组,索引 0 为最底层
    std::vector<SkipListNode*> forward;

public:
    // 构造函数:初始化节点值和层数(forward 数组大小)
    SkipListNode(int val, int level) : value(val) {
        // 初始化 forward 数组,每个元素初始化为 nullptr(指向空)
        forward.resize(level, nullptr);
    }

    // 友元声明:让 SkipList 类能直接访问节点的私有成员
    friend class SkipList;
};
完整跳表结构示例
一个典型的跳表看起来像这样:
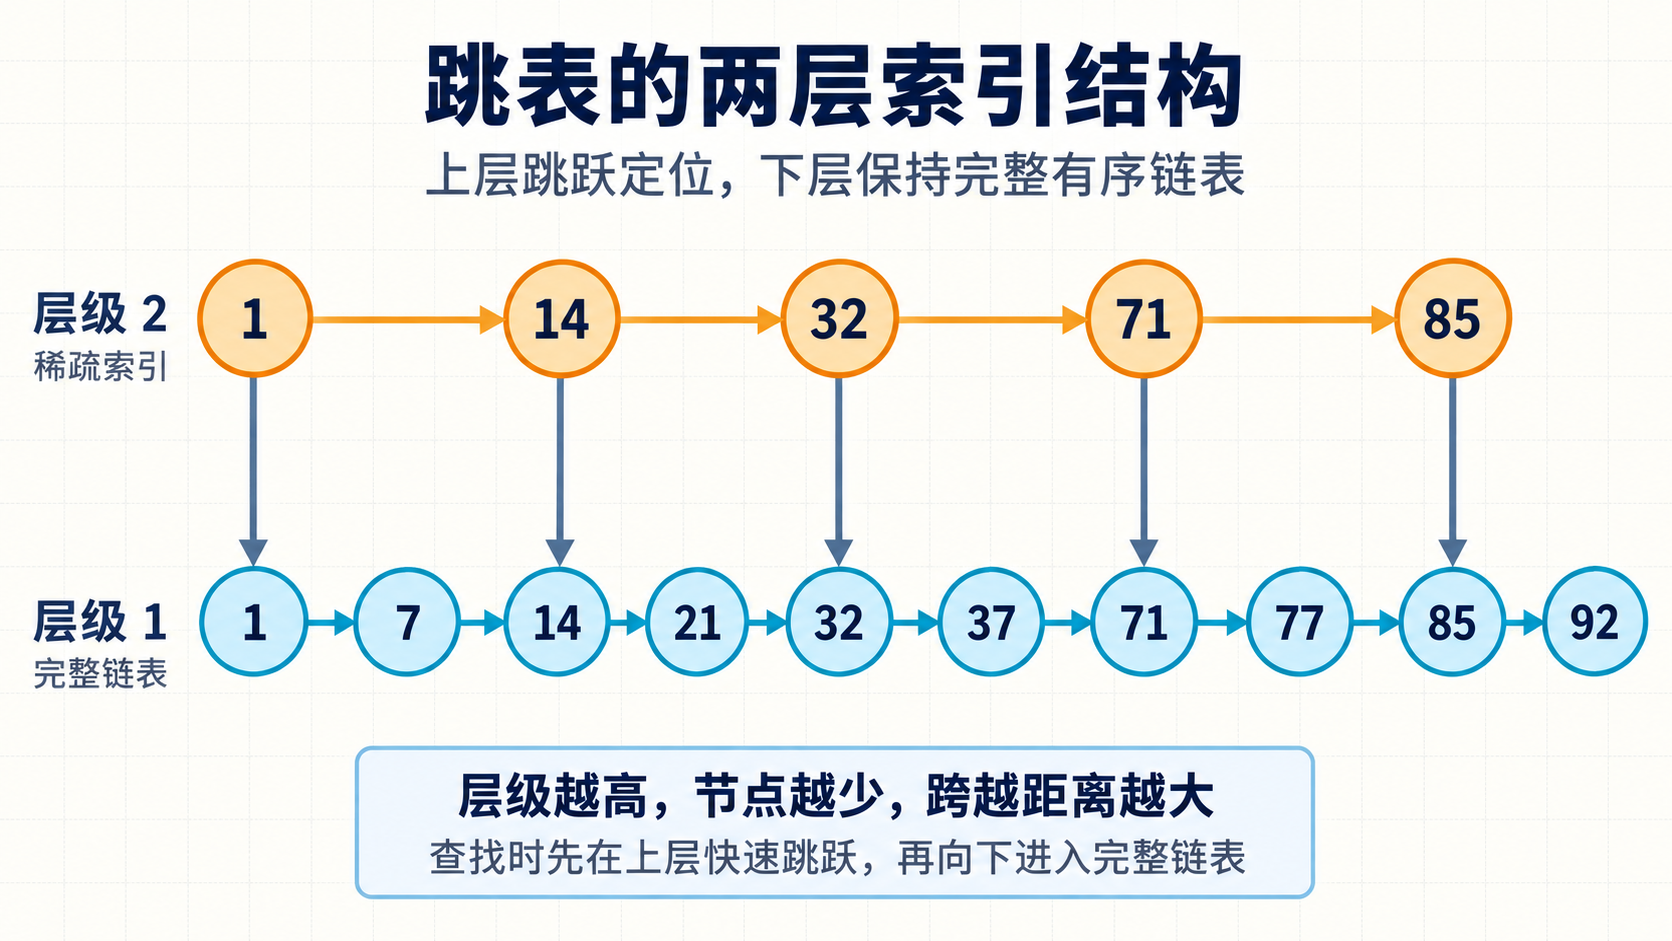
下面我们来说一下跳表的多种操作
核心操作详解
查找操作
从最高层开始,逐层向右查找,遇到大于目标值的节点就下降一层。
代码实现
简单的代码实现,来自训练营学员Lighters_
#include <iostream>
#include <memory>
#include <vector>
#include <random>

// 跳表节点结构体
template <typename T>
struct SkipListNode {
    T value_;
    std::vector<std::shared_ptr<SkipListNode<T>>> forward_;  // 指向不同层次的指针数组

    SkipListNode(int level, T val) : forward_(level + 1, nullptr), value_(val) {}
};

// 跳表类
template <typename T>
class SkipList {
public:
    SkipList(int maxlevel = 16)
        : maxlevel_(maxlevel), currentlevel_(0) {
        header_ = std::make_shared<SkipListNode<T>>(maxlevel_, T()); // 创建头节点
        dis_01_ = std::uniform_int_distribution<>(0, 1);
        gen_ = std::mt19937(std::random_device()());
    }

    // 随机生成跳表的层数
    int randomLevel() {
        int level = 0;
        while (dis_01_(gen_) && level < maxlevel_) {
            level++;
        }
        return level;
    }

    // 插入元素
    void insert(T value) {
        std::vector<std::shared_ptr<SkipListNode<T>>> update(maxlevel_ + 1); // 记录查找路径上的节点
        std::shared_ptr<SkipListNode<T>> current = header_;

        // 从高层开始查找
        for (int i = currentlevel_; i >= 0; i--) {
            while (current->forward_[i] != nullptr && current->forward_[i]->value_ < value) {
                current = current->forward_[i];
            }
            update[i] = current;
        }

        // 如果当前节点的下一个节点的值等于目标值,不进行插入
        current = current->forward_[0];
        if (current == nullptr || current->value_ != value) {
            int level = randomLevel();
            if (level > currentlevel_) {
                for (int i = currentlevel_ + 1; i <= level; i++) {
                    update[i] = header_;
                }
                currentlevel_ = level;
            }

            current = std::make_shared<SkipListNode<T>>(level, value);
            for (int i = 0; i <= level; i++) {
                current->forward_[i] = update[i]->forward_[i];
                update[i]->forward_[i] = current;
            }
        }
    }

    // 查找元素
    std::shared_ptr<SkipListNode<T>> search(T value) {
        std::shared_ptr<SkipListNode<T>> current = header_;
        for (int i = currentlevel_; i >= 0; i--) {
            while (current->forward_[i] != nullptr && current->forward_[i]->value_ < value) {
                current = current->forward_[i];
            }
        }
        current = current->forward_[0];
        if (current != nullptr && current->value_ == value) {
            return current;
        }
        return nullptr;
    }

    // 删除元素
    void deleteElement(T value) {
        std::vector<std::shared_ptr<SkipListNode<T>>> update(maxlevel_ + 1);
        std::shared_ptr<SkipListNode<T>> current = header_;

        for (int i = currentlevel_; i >= 0; i--) {
            while (current->forward_[i] != nullptr && current->forward_[i]->value_ < value) {
                current = current->forward_[i];
            }
            update[i] = current;
        }

        current = current->forward_[0];
        if (current != nullptr && current->value_ == value) {
            for (int i = 0; i <= currentlevel_; i++) {
                if (update[i]->forward_[i] != current) {
                    break;
                }
                update[i]->forward_[i] = current->forward_[i];
            }

            // 如果最高层的链表为空,降低当前层数
            while (currentlevel_ > 0 && header_->forward_[currentlevel_] == nullptr) {
                currentlevel_--;
            }
        }
    }

    // 打印跳表
    void printList() {
        std::cout << "SkipList: " << std::endl;
        for (int i = 0; i <= currentlevel_; i++) {
            std::shared_ptr<SkipListNode<T>> node = header_->forward_[i];
            std::cout << "Level " << i << ": ";
            while (node != nullptr) {
                std::cout << node->value_ << " ";
                node = node->forward_[i];
            }
            std::cout << std::endl;
        }
    }
private:
    int maxlevel_;
    std::shared_ptr<SkipListNode<T>> header_;
    int currentlevel_;
    std::uniform_int_distribution<> dis_01_;
    std::mt19937 gen_;
};

int main() {
    SkipList<int> skipList;

    skipList.insert(3);
    skipList.insert(6);
    skipList.insert(7);
    skipList.insert(9);
    skipList.insert(12);
    skipList.insert(19);
    skipList.insert(17);
    skipList.insert(26);
    skipList.insert(21);
    skipList.insert(25);

    skipList.printList();

    auto node = skipList.search(19);
    if (node != nullptr) {
        std::cout << "Found: " << node->value_ << std::endl;
    }
    else {
        std::cout << "Not found!" << std::endl;
    }

    skipList.deleteElement(19);
    skipList.printList();

    return 0;
}
时间复杂度: O(log n)
推荐阅读:
压缩列表 Ziplist
压缩列表(Ziplist)是旧版 Redis 为节省内存设计的一种紧凑数据结构。
这里的“压缩”并不是使用 Gzip 等算法压缩数据,而是通过以下方式减少内存占用:
- 所有元素保存在一块连续内存中;
- 不为每个元素单独申请内存;
- 不保存前后节点指针;
- 根据数据类型和长度采用变长编码。
它本质上是一个由多个变长元素组成的连续字节数组,并不是给每个元素分配固定大小空间的普通数组。
整体结构
Ziplist 的整体结构如下:
<zlbytes><zltail><zllen><entry1><entry2>...<entryN><zlend>
各字段的作用如下:
zlbytes:整个 Ziplist 占用的字节数;zltail:最后一个元素相对于 Ziplist 起始地址的偏移量;zllen:元素数量;entry:实际保存的元素;zlend:结束标记,值为0xFF。
通过 zlbytes 可以直接得到整个结构的大小,通过 zltail 可以快速定位最后一个元素。

Entry 的结构
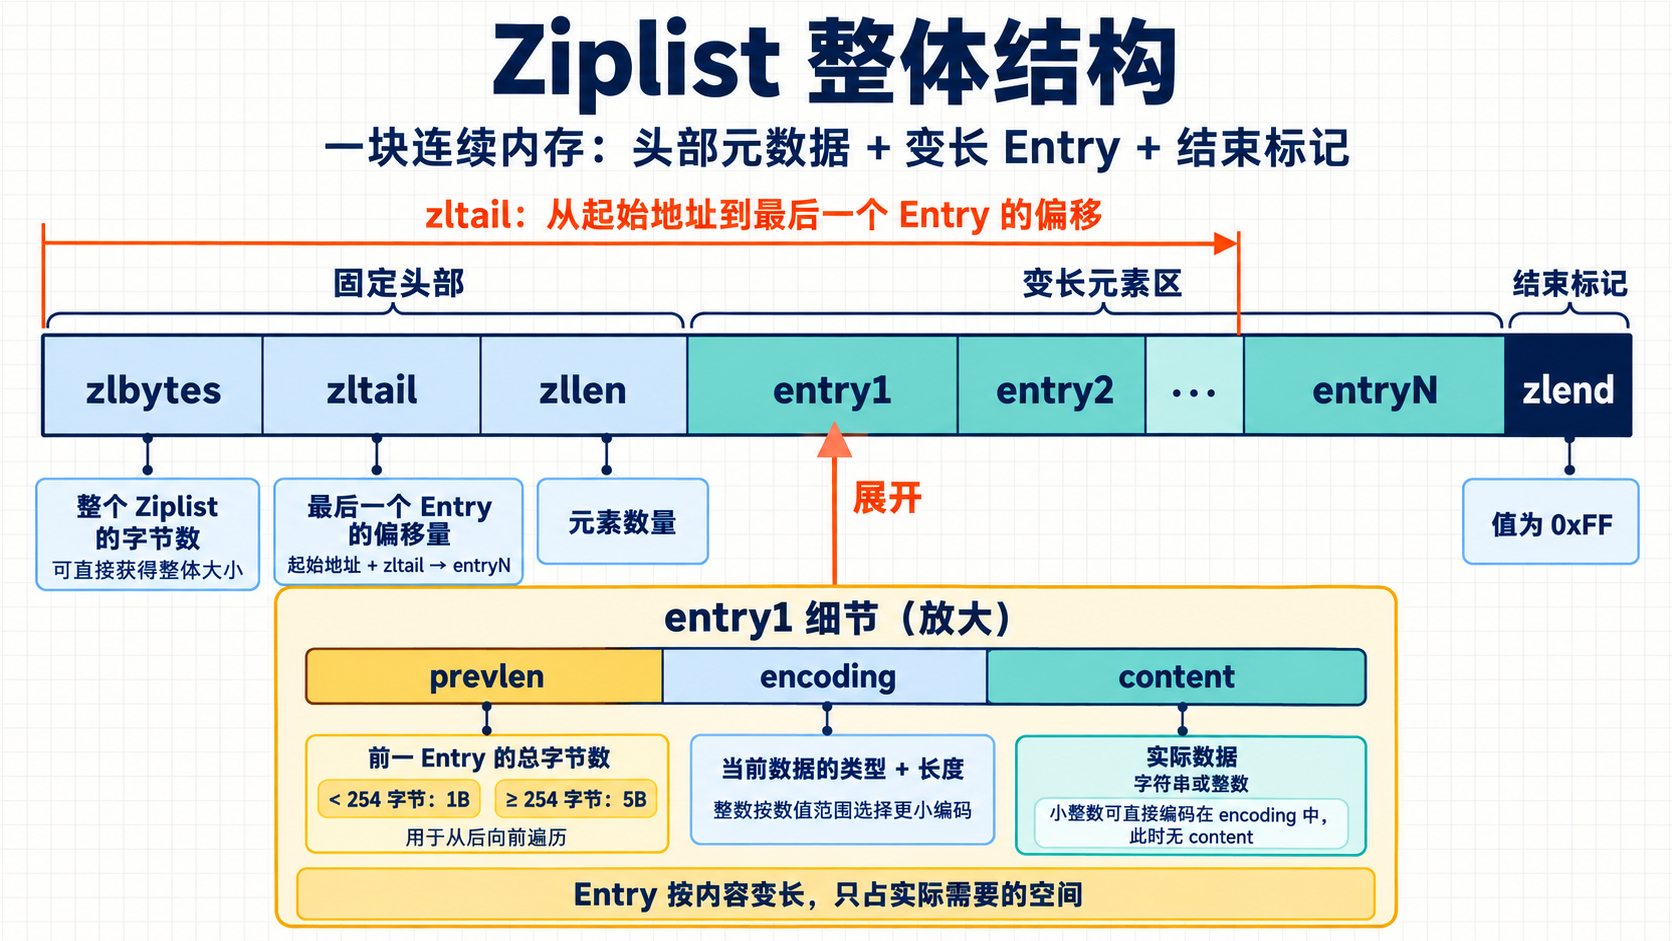
每个 Entry 的结构可以概括为:
<prevlen><encoding><content>
prevlen
记录前一个 Entry 占用的字节数,用于从后向前遍历:
- 前一个 Entry 长度小于 254 字节时,使用 1 字节保存;
- 前一个 Entry 长度大于或等于 254 字节时,使用 5 字节保存。
encoding
记录当前元素的数据类型和数据长度。
Ziplist 支持保存字符串和整数。整数会根据数值范围选择更小的编码,不一定按照字符串形式保存,从而进一步节省空间。
content
保存元素的实际数据。由于 encoding 已经记录了数据类型和长度,因此每个 Entry 可以按照实际需要占用不同大小的空间。
为什么节省内存?
普通双向链表中的每个节点通常需要保存:
- 数据;
- 前驱指针;
- 后继指针;
- 内存分配器产生的额外开销。
Ziplist 将所有元素紧凑地放在一块连续内存中,不需要为每个元素保存前后指针,也不需要分别申请内存,因此在元素数量较少、内容较小时能够显著降低内存占用,并具有较好的 CPU 缓存局部性。
Ziplist 的缺点
1. 查询中间元素效率较低
Ziplist 只能根据 Entry 的长度逐个计算下一个元素的位置,因此按下标查找中间元素通常需要遍历,时间复杂度为 O(N)。
2. 插入和删除可能移动大量数据
由于所有元素存储在连续内存中,在中间插入或删除元素时,后续数据通常需要整体移动;扩容时还可能需要重新分配并复制整块内存。
因此,Ziplist 更适合元素数量少、单个元素较小的场景。
3. 可能发生连锁更新
如果一个 Entry 的长度发生变化,后一个 Entry 的 prevlen 可能需要从 1 字节扩展为 5 字节。
后一个 Entry 变大后,又可能导致再后面的 Entry 继续扩展,从而产生连续更新,这种现象称为连锁更新。
例如:
entry1 变大
    ↓
entry2 的 prevlen 从 1 字节扩展为 5 字节
    ↓
entry2 总长度变大
    ↓
entry3 的 prevlen 也可能需要扩展
极端情况下,连锁更新会导致多次内存移动,影响性能。
在 Redis 中的使用
在 Redis 6.2 及以前,Ziplist 主要用于:
- 元素较少、内容较小的 Hash;
- 元素较少、内容较小的 Sorted Set;
- 作为 Quicklist 节点内部的紧凑存储结构。
当元素数量或元素大小超过配置阈值时,Redis 会将数据转换为更适合大规模数据的编码。
从 Redis 7.0 开始,小型 List、Hash 和 Sorted Set 的紧凑编码已经主要由 Listpack 替代;Redis 7.2 之后,小型 Set 也可以使用 Listpack。Ziplist 相关代码仍可能用于旧数据格式兼容,但不再是新版本的主要紧凑编码。
总结
Ziplist 是一块连续内存,其中每个元素根据实际数据类型和长度采用变长编码。它通过减少指针、独立内存分配和额外元数据来节省内存,但中间插入、删除和扩容可能引发数据移动,
prevlen的长度变化还可能导致连锁更新。因此它只适合保存少量、小体积元素,并已在 Redis 7.0 之后逐步被 Listpack 替代。
推荐阅读
3. 各类型键值对如何操作?
建议大家这块可以了解一下,有的公司问考察这些
String
- 如何设置一个键为 name,值为 Alice 的键值对?
SET name Alice
- **获取键 **name 的值?
GET name
- **若键 **age 的值为数字 25 ,如何让其自增1 ?
INCR age
- 同时设置键 key1 的值为 value1 ,键 key2 的值为 value2 ?
MSET key1 value1 key2 value2
- **获取键 **name 的值的长度?
STRLEN name
Hash
- 为键 user:1 添加字段 username 和 age ,分别设置为 Bob 和 30 ?
HSET user:1 username Bob age 30
- 获取键 user:1 中 username 字段的值?
HGET user:1 username
- 获取键 user:1 中的所有字段和值?
HGETALL user:1
- 检查键 user:1中是否存在字段 email ?
HEXISTS user:1 email
获取键 user:1 中所有字段的个数?
HLEN user:1
List
- 将元素 red、green、blue 从左到右推入名为 colors 的列表?
LPUSH colors red green blue
- 从名为tasks的列表中弹出一个元素(从右侧弹出)?
RPOP tasks
- 获取名为 queue 的列表中的所有元素?
LRANGE queue 0 -1
- 将元素 yellow 插入到名为 colors 的列表中,使其成为列表的最后一个元素?
RPUSH colors yellow
- 获取名为 numbers 的列表中的前3个元素?
LRANGE numbers 0 2
Set 类型
- 将元素 apple、banana、cherry 添加到名为 fruits 的集合中?
SADD fruits apple banana cherry
- 从名为 fruits 的集合中移除元素 banana ?
SREM fruits banana
- 获取名为fruits 的集合中的所有元素?
SMEMBERS fruits
- 计算名为 nums 的集合中的元素数量?
SCARD nums
- 检查元素 orange 是否存在于名为 fruits 的集合中?
SISMEMBER fruits orange
Sorted Set
- 添加元素 user1 和 user2 到名为 users 的有序集合中,并分别设置它们的分数为 80 和 90 ?
ZADD users 80 user1 90 user2
- **删除有序集合 **users 中的元素 user1 ?
ZREM users user1
- **获取有序集合 **users 中元素 user2 的分数?
ZSCORE users user2
- **获取有序集合 **users 中排名前3的元素(分数从低到高)?
ZRANGE users 0 2
- **统计有序集合 **scores 中分数在 70 到 80 之间的元素个数?
ZCOUNT scores 70 80
综合命令
- 判断键 key1 是否存在 ?
EXISTS key1
- 设置键 test 的值为 value,并设置其过期时间为60秒 ?
先SET test value ,再 EXPIRE test 60 (或者使用SETEX test 60 value一次性完成)
- **删除键 **key2 、key3 ?
DEL key2 key3
- 获取当前数据库中键的数量 ?
DBSIZE
- **查看键 **name 对应的值的数据结构类型 ?
TYPE name
4. 跳表相比平衡树,在 Redis 有序集合应用中有哪些优势?
跳表和平衡树都可以完成有序数据的查找、插入和删除。平衡树通常能保证最坏 O(log N),跳表则依靠随机层高实现期望 O(log N)。
Redis 在有序集合中选择跳表,主要是因为它实现简单、范围遍历方便,并且容易支持排名查询。
实现和维护相对简单
平衡树在插入和删除节点后,可能需要通过旋转、变色或其他操作维持树的平衡,实现细节比较复杂。
跳表通过随机算法决定节点层数。插入或删除时,只需要修改搜索路径上各层的指针和跨度,不需要执行复杂的平衡操作,因此代码更容易实现、调试和维护。
范围查询非常自然
Redis 有序集合经常需要执行以下操作:
- 按
score查询一个范围; - 按排名查询一个范围;
- 正序或倒序遍历;
- 删除指定分数或排名范围内的元素。
跳表可以先通过高层索引,以期望 O(log N) 的时间定位范围起点,然后沿最底层链表连续遍历结果。
如果范围内包含 M 个元素,范围查询的时间复杂度为:
O(log N + M)
Redis 跳表节点还包含后退指针,因此也能方便地进行倒序遍历。
容易支持排名查询
Redis 跳表的每一层不仅保存前进指针,还保存 span,表示当前节点到下一个节点之间跨越了多少个底层节点。
Redis 在查找过程中累加 span,即可计算元素排名,或者根据排名定位元素。因此:
ZRANK、ZREVRANK的时间复杂度为 O(log N);- 按排名执行范围查询的时间复杂度为 O(log N + M)。
平衡树也可以实现排名功能,但通常需要额外维护子树节点数量,把普通平衡树扩展为顺序统计树。
批量范围删除更直接
跳表定位到范围起点后,可以沿最底层链表依次删除范围内的节点。
平衡树删除每个节点时通常都需要重新维护平衡;跳表不需要旋转或变色,只需调整相关层级的指针和 span,实现相对直接。
层高按需分配
Redis 跳表通过随机算法生成节点层数,层数越高,出现概率越低。节点只为自己实际拥有的层级分配空间,并不是所有节点都分配最大层数。
这使其内存使用具有一定的灵活性。不过需要注意:
跳表并不一定比平衡树更省内存。
Redis 跳表每层需要保存前进指针和 span,节点还包含后退指针。它的优势主要是层数按概率分布、平均额外层数可控,而不能简单概括为“内存占用一定小于平衡树”。
Redis 为什么还要配合字典?
对于使用跳表编码的有序集合,Redis 会同时维护:
- 字典:根据成员查找元素和分数,平均时间复杂度为 O(1);
- 跳表:维护分数顺序,支持范围和排名查询,期望时间复杂度为 O(log N)。
两种结构共享同一批逻辑数据,分别优化不同的访问方式。
跳表相比平衡树的主要优势是:
- 实现简单,不需要旋转、变色等复杂平衡操作;
- 定位起点后可以沿链表连续遍历,适合范围查询;
- 通过
span容易实现排名和按排名查找; - 支持正序、倒序以及批量范围删除;
- 节点层高按概率生成,空间分配比较灵活。
一句话概括:
跳表并不是在时间复杂度上全面优于平衡树,而是以概率平衡换取了更简单的实现,并且天然适合 Redis 有序集合频繁进行的范围遍历和排名查询。
补充来说,平衡树通常可以保证最坏 O(log N),而跳表的 O(log N) 是期望复杂度,极端情况下可能退化为 O(N)。
推荐阅读
阅读导航
上一章:Redis 基础知识
下一章:Redis 缓存



