
Redis 持久化
Redis 持久化
Redis主要通过两种方法实现持久化,一种是RDB持久化,一种是AOF 持久化,下面详细说一下两种持久化机制
1. 说一下 RDB 持久化
工作原理
因为Redis整个加载都在内存中,所以我们可以通过RDB持久化将内容中的数据保存到内存中去,避免数据丢失。
RDB 持久化可以手动执行,也可以定期自动执行。不过AOF 的更新频率更高,当开启AOF持久化时,会优先使用AOF文件来还原持久化。
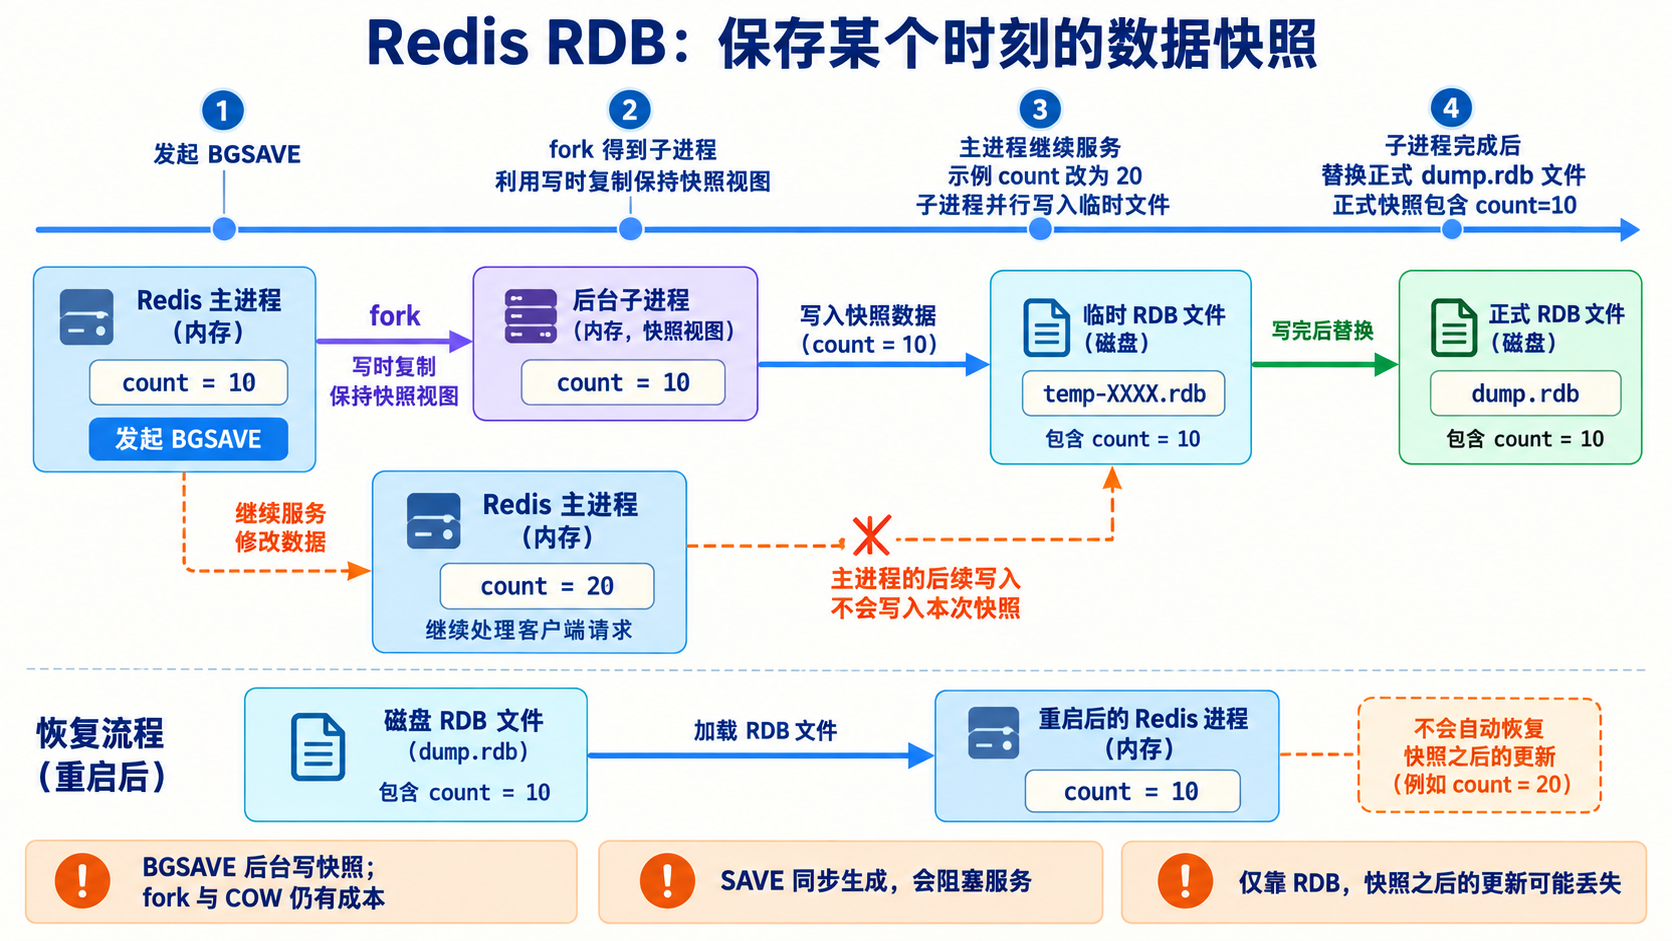
RDB 持久化是 Redis 用于数据备份和恢复的一种机制。
会在特定的时间点将 Redis 内存中的数据集快照(snapshot)保存到磁盘上的一个二进制文件中。
这个二进制文件包含了 Redis 数据库在某个时刻的完整数据状态,包括所有的键值对、数据库结构等信息。
RDB 持久化的触发方式
自动触发
定时策略:Redis 可以通过配置文件(redis.conf)中的设置来定时生成 RDB 文件。
例如,可以设置每隔一定时间(如 900 秒,即 15 分钟),如果数据集至少有 1 个键发生了改变,就会自动执行一次 RDB 操作。
这种定时策略能够在一定程度上平衡数据备份的频率和性能开销。如果数据变更频繁,频繁的 RDB 操作可能会消耗较多的系统资源;而如果间隔时间过长,可能会导致数据丢失的风险增加。
主从同步触发
在 Redis 主从架构中,当从服务器连接到主服务器时,主服务器会执行一次 BGSAVE 命令来生成 RDB 文件,用于将数据同步给从服务器。这确保了从服务器能够获取主服务器的完整数据集,以便进行数据复制和备份。
手动触发
可以使用 SAVE 或 BGSAVE 命令手动触发 RDB 持久化。
SAVE 命令会阻塞 Redis 服务器,在保存 RDB 文件的过程中,服务器不能处理其他客户端的请求,直到 RDB 文件保存完成。
而 BGSAVE 命令则是在后台异步执行 RDB 保存操作,不会阻塞服务器的正常服务。
不过,BGSAVE 命令在执行时会派生一个子进程来进行数据快照的生成,这会占用一定的系统资源,如 CPU 和内存。
2. 说一下 RDB 文件的保存过程?
当触发 RDB 持久化后,Redis 会采用一种类似于写时复制(Copy - on - Write,COW)的技术来创建数据集的快照。
Redis 会 fork 一个子进程,这个子进程会共享父进程(即正在运行的 Redis 服务器进程)的内存数据空间。
然后,子进程开始遍历内存中的数据,将其写入到 RDB 文件中。
在这个过程中,如果父进程中的数据发生了修改,这些修改的数据所在的内存页会被复制一份,父进程在新的内存页上进行修改,而子进程仍然使用原来的内存数据来生成 RDB 文件。
这样就确保了 RDB 文件中保存的数据是某个时间点的完整快照,不会受到后续数据修改的影响。
3. 说一下 RDB 持久化的优缺点
优点
文件紧凑、恢复速度快:RDB 文件是一个经过压缩的二进制文件,它的体积相对较小,占用的磁盘空间较少。
而且在恢复数据时,Redis 可以直接加载这个二进制文件,将数据快速地恢复到内存中,恢复速度比AOF要快。
例如,当需要重启 Redis 服务器或者从备份中恢复数据时,使用 RDB 文件可以在较短的时间内使 Redis 重新上线并提供服务。
适合大规模数据备份:对于大型的 Redis 数据集,RDB 持久化是一种比较合适的备份方式。
它可以定期对整个数据集进行快照保存,能够有效地备份大量的数据。而且由于它的备份过程相对简单,不需要记录每一个数据操作,所以在处理大规模数据时效率较高
缺点
数据丢失风险:由于 RDB 是定时备份或者在特定条件下才备份,可能会存在数据丢失的情况
内存消耗大(BGSAVE 方式):当使用 BGSAVE 命令触发 RDB 持久化时,会创建一个子进程来进行数据快照的生成。这个子进程会占用一定的内存,在数据集较大的情况下,可能会对系统的内存资源造成较大的压力。
而且,如果频繁使用 BGSAVE 命令,可能会导致内存资源的浪费和性能下降。
4. 说一下 RDB 文件结构?
RDB 文件主要包含以下结构:
**REDIS **:判断是否为 REDIS 文件,指示位
db_version :版本号
database :数据
EOF:代表正文部分结束
check_sum :校验和
下面我们继续来看 databases 内含有哪些字段:
每个非空数据库在RDB文件中都可以保存为:
SELECTDB: 表示将要读一个数据库,指示位
db_number:代表数据库的索引。
key_value_pairs :存储的内容
继续拆解一下 key_value_pairs 存储了哪些字段?
EXPIRETIME_MS,是一个1字节的常量,告诉程序下一个内容是unix的毫秒,指示位
ms,毫秒为单位的unix时间戳,8 字节长的带符号整数,具体数字
TYPE:是一个常量,记录键值对的类型,占 1 字节空间,类型即 redis 的基础数据编码。
key:是字符串对象,保存的是键的对象。
value:对象根据 type 变化,保存的是值的对象,不同类型的 value 还可以进一步拆解
5. 说一下 AOF 的持久化机制
什么是 AOF?
AOF,全称 Append Only File,是 Redis 提供的一种持久化机制。
Redis 会将执行成功、会修改数据的命令追加记录到 AOF 文件中。当 Redis 重启时,通过重新执行 AOF 中的命令恢复数据。
例如执行:
SET user:1001 "程序厨"
INCR article:1001:view_count
AOF 会按照 RESP 协议格式记录这些写命令。Redis 重启时重新执行它们,恢复出原来的数据状态。
AOF 主要解决 Redis 数据保存在内存中、进程退出或服务器宕机后数据无法恢复的问题。
为什么说 AOF 是写后日志?
AOF 采用写后日志,也就是先执行命令、修改内存中的数据,再将写命令追加到 AOF。
基本流程是:
客户端发送写命令
        ↓
Redis 校验并执行命令
        ↓
修改内存数据
        ↓
命令写入 AOF 缓冲区
        ↓
写入操作系统页缓存
        ↓
根据 appendfsync 策略刷入磁盘
        ↓
向客户端返回结果
采用写后日志有两个主要好处:
- 命令执行成功后才记录,不需要记录语法错误或执行失败的命令;
- 直接记录写命令,不需要在执行前额外生成复杂的日志内容。
但“写后日志不会影响写操作”这个说法并不准确。AOF 仍然需要执行文件写入和 fsync,不同刷盘策略会对写请求性能产生不同程度的影响。
特别是 appendfsync always,Redis需要等待数据刷盘后再返回结果,写延迟会明显增加。
AOF 的完整写入过程
AOF 写入可以分为三个阶段:
1. 命令追加到 AOF 缓冲区
写命令执行成功后,Redis 将命令按照 RESP 格式追加到 AOF 缓冲区中。
先写入缓冲区可以减少频繁执行文件系统调用的开销。
2. 写入操作系统页缓存
Redis 会调用 write(),将 AOF 缓冲区中的数据写入操作系统内核的页缓存。
此时数据已经交给操作系统,但不一定真正写入磁盘。进程崩溃时,操作系统页缓存中的数据可能仍然存在;如果服务器断电或操作系统崩溃,没有完成刷盘的数据仍可能丢失。
3. 执行 fsync
fsync 用于要求操作系统将文件数据尽可能同步到持久化存储。
appendfsync 配置决定 Redis 什么时候执行 fsync,也决定了性能与数据可靠性之间的权衡。
AOF 的三种刷盘策略
| 配置 | 刷盘方式 | 优点 | 缺点 |
|---|---|---|---|
always | 每批新写命令追加后执行 fsync,再返回响应 | 数据安全性最高,故障时丢失数据最少 | 每次都需要等待磁盘刷盘,写入性能和延迟受磁盘影响较大 |
everysec | 后台线程通常每秒执行一次 fsync | 性能与可靠性比较均衡,也是常用配置 | 故障时通常可能丢失最近约 1 秒的数据 |
no | Redis 只执行 write(),不主动执行 fsync,由操作系统决定刷盘时机 | 性能较好,Redis主动刷盘开销较小 | 数据丢失窗口更大,具体时间取决于操作系统配置 |
配置示例:
appendonly yes
appendfsync everysec
需要强调的是,这三种策略的主要区别是 fsync 时机,而不是只有某一种策略才会写 AOF 文件。
appendfsync always
appendfsync always
Redis 会在返回写请求结果之前执行刷盘,可靠性最高,但请求延迟会直接受到磁盘性能影响。
Redis 可能将同一批次的多个写命令合并后执行一次 fsync,但总体性能开销仍然较大。
即使使用 always,也不能脱离磁盘硬件、文件系统和备份机制宣称绝对不会丢失数据。
appendfsync everysec
appendfsync everysec
Redis 通常通过后台线程每秒执行一次 fsync。主线程不需要让每个请求都等待刷盘,因此性能通常明显优于 always。
如果机器断电或操作系统崩溃,通常可能丢失最近约一秒的数据。在磁盘严重阻塞等极端情况下,实际影响还需要结合系统行为判断。
这是性能和数据安全性之间比较均衡的选择,也是常见配置。
appendfsync no
appendfsync no
Redis 仍会通过 write() 将数据交给操作系统,但不主动执行 fsync,由操作系统决定什么时候真正写入磁盘。
这种方式性能较好,但发生断电或操作系统崩溃时,可能丢失较多数据,具体丢失窗口取决于操作系统的刷盘策略,不能假设为固定时间。
AOF 为什么需要重写?
随着写命令不断执行,AOF 文件会持续增长。
例如,一个计数器执行了多次修改:
INCR counter
INCR counter
INCR counter
...
假设计数器最终结果为 100,恢复数据时并不一定需要重新执行 100 次 INCR,只需要一条能够恢复当前状态的命令:
SET counter 100
AOF 重写就是根据当前内存中的最终数据状态,生成一份更紧凑的 AOF,而不是简单读取旧 AOF 并删除重复命令。
它主要解决以下问题:
- AOF 文件不断增大;
- 占用磁盘空间越来越多;
- Redis 重启时命令回放时间过长;
- AOF 备份和传输成本增加。
AOF 重写过程
可以通过以下命令手动触发后台重写:
BGREWRITEAOF
也可以根据 AOF 文件大小和增长比例自动触发。
Redis 7.0 之后使用多段 AOF 机制,主要包含:
- BASE 文件:保存重写时的数据基础状态,可以使用 RDB 或 AOF 格式;
- INCR 文件:保存基础文件生成后新增的写命令;
- Manifest 文件:记录当前有效的 BASE 和 INCR 文件。
重写过程可以简化为:
- Redis 创建子进程;
- 子进程根据当前内存数据生成新的 BASE 文件;
- 主进程继续处理客户端请求;
- 重写期间的新命令写入新的 INCR 文件;
- BASE 和 INCR 准备完成后,原子更新 Manifest;
- 新 AOF 文件组生效,旧文件随后清理。
开始重写
   ├── 子进程:生成新的 BASE
   └── 主进程:继续处理请求并写入 INCR
                         ↓
                原子切换 Manifest
                         ↓
                 新 AOF 文件组生效
这种方式避免了重写期间停止处理客户端请求。
但 AOF 重写并不是完全没有影响:
fork()可能造成短暂延迟;- 写时复制会增加内存占用;
- 重写会产生磁盘 I/O;
- 写入量较大时,INCR 文件也可能快速增长;
- 内存或磁盘空间不足可能导致重写失败。
如果重写失败,旧 AOF 仍然保留,不会因为一次重写失败就直接丢失已有持久化文件。
Redis 如何通过 AOF 恢复数据?
Redis 启动时,如果启用了 AOF,就会加载有效的 AOF 文件,并按照顺序重放其中的写命令,从而重建内存数据。
Redis 7.0 之后会根据 Manifest 加载:
BASE 文件
    ↓
按照顺序加载 INCR 文件
    ↓
恢复完整数据状态
如果同时启用了 RDB 和 AOF,Redis 启动恢复时通常优先使用 AOF,因为 AOF 一般保存的数据更加完整。
如果 AOF 尾部因为异常宕机出现不完整命令,可以根据配置和损坏程度进行截断恢复,也可以使用 redis-check-aof 等工具检查和修复。但在修复前应先备份原始文件,避免进一步扩大数据损失。
AOF 的优点
- 相比周期性 RDB 快照,通常能够提供更小的数据丢失窗口;
- 文件采用追加写,顺序 I/O 对磁盘相对友好;
- 可以根据业务选择不同的
fsync策略; - 支持后台重写,压缩冗余命令;
- AOF 内容基于 Redis 协议,具有一定可读性;
- Redis 7.0 之后的多段 AOF 更利于管理重写期间的增量数据。
AOF 的缺点
- AOF 文件通常比对应的 RDB 文件更大;
- 启动时需要加载并恢复数据,恢复速度通常比 RDB 慢;
fsync会带来磁盘 I/O 和延迟开销;- AOF 重写需要额外的 CPU、内存和磁盘资源;
fork()和写时复制可能引起延迟或内存压力;- 磁盘写满、文件系统异常可能导致持久化失败,甚至影响后续写入;
- AOF 会忠实记录误操作,例如执行
DEL或FLUSHALL后,这些操作也会被持久化,因此 AOF 不能代替独立备份。
面试总结
AOF 是一种写后日志持久化机制。Redis 先执行写命令并修改内存数据,再将执行成功的命令追加到 AOF 缓冲区,写入操作系统页缓存,最后按照 appendfsync 策略决定何时刷入磁盘。
AOF 有三种刷盘策略:
always:每批写命令都刷盘,可靠性高但性能开销大;everysec:通常每秒刷盘一次,性能和可靠性比较均衡;no:由操作系统决定刷盘时机,性能较好但数据丢失风险更高。
随着日志增长,Redis 会通过 AOF 重写,根据当前内存数据生成更紧凑的文件。Redis 7.0 之后采用 BASE、INCR 和 Manifest 组成的多段 AOF。Redis 重启时加载 BASE,再按顺序加载增量文件,从而恢复数据。
参考:Redis Persistence、BGREWRITEAOF、Redis Latency Diagnosis
6. 说一下什么是 AOF 重写?
AOF 重写是指 Redis 根据当前内存中的最终数据状态,生成一份新的、更加紧凑的 AOF 文件,以替换包含大量冗余命令的旧 AOF 文件。
它主要解决以下问题:
- AOF 文件随着写操作不断增长;
- 大量历史命令已经没有恢复价值;
- AOF 占用磁盘空间过大;
- Redis 重启时加载和恢复数据的时间过长;
- AOF 文件备份和传输成本增加。
为什么需要 AOF 重写?
AOF 会记录修改数据的命令。对同一个 Key反复修改时,旧命令仍然保留在 AOF 中。
例如:
SET counter 1
INCR counter
INCR counter
INCR counter
假设 counter 最终结果是 4,恢复当前状态并不需要重新执行全部历史命令,只需要保存等价的最终状态:
SET counter 4
再例如:
SET user:1001 "A"
SET user:1001 "B"
SET user:1001 "C"
前两次写入已经被后面的值覆盖,重写后只需要保留能够恢复当前状态的内容:
SET user:1001 "C"
因此,AOF 重写不是简单地压缩旧文件,也不是遍历旧 AOF 并删除重复命令,而是直接读取 Redis 当前的内存数据,生成一份能够恢复当前数据状态的紧凑表示。
严格来说,它生成的是等价且更紧凑的数据表示,不一定是数学意义上的“最小指令集”。
如何触发 AOF 重写?
可以通过两种方式触发。
手动触发
BGREWRITEAOF
该命令会让 Redis 在后台启动 AOF 重写。
自动触发
Redis 可以根据以下配置判断是否需要自动重写:
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb
其含义是:
- 当前 AOF 文件需要达到一定的最小大小;
- 当前 AOF 相比上一次重写后的大小,增长比例达到指定阈值;
- 两个条件同时满足后,Redis 才考虑自动触发重写。
具体阈值应根据数据量、写入速度、磁盘空间和延迟要求进行调整。
Redis 7.0 之后的 AOF 重写流程
Redis 7.0 之后采用多段 AOF 机制,主要由以下文件组成:
- BASE 文件:保存某个时间点的基础数据,可以采用 RDB 或 AOF 格式;
- INCR 文件:保存 BASE 生成之后的新写命令;
- Manifest 文件:记录当前应该加载哪些 BASE 和 INCR 文件。
重写过程如下:
- Redis 主进程创建子进程;
- 子进程读取 fork 时刻的内存数据,生成新的 BASE 文件;
- 主进程继续处理客户端请求;
- 重写期间产生的新写命令记录到新的 INCR 文件;
- BASE 文件生成完成后,Redis 生成新的 Manifest;
- 通过原子方式切换 Manifest,使新文件组生效;
- 旧的 AOF 文件随后被清理。
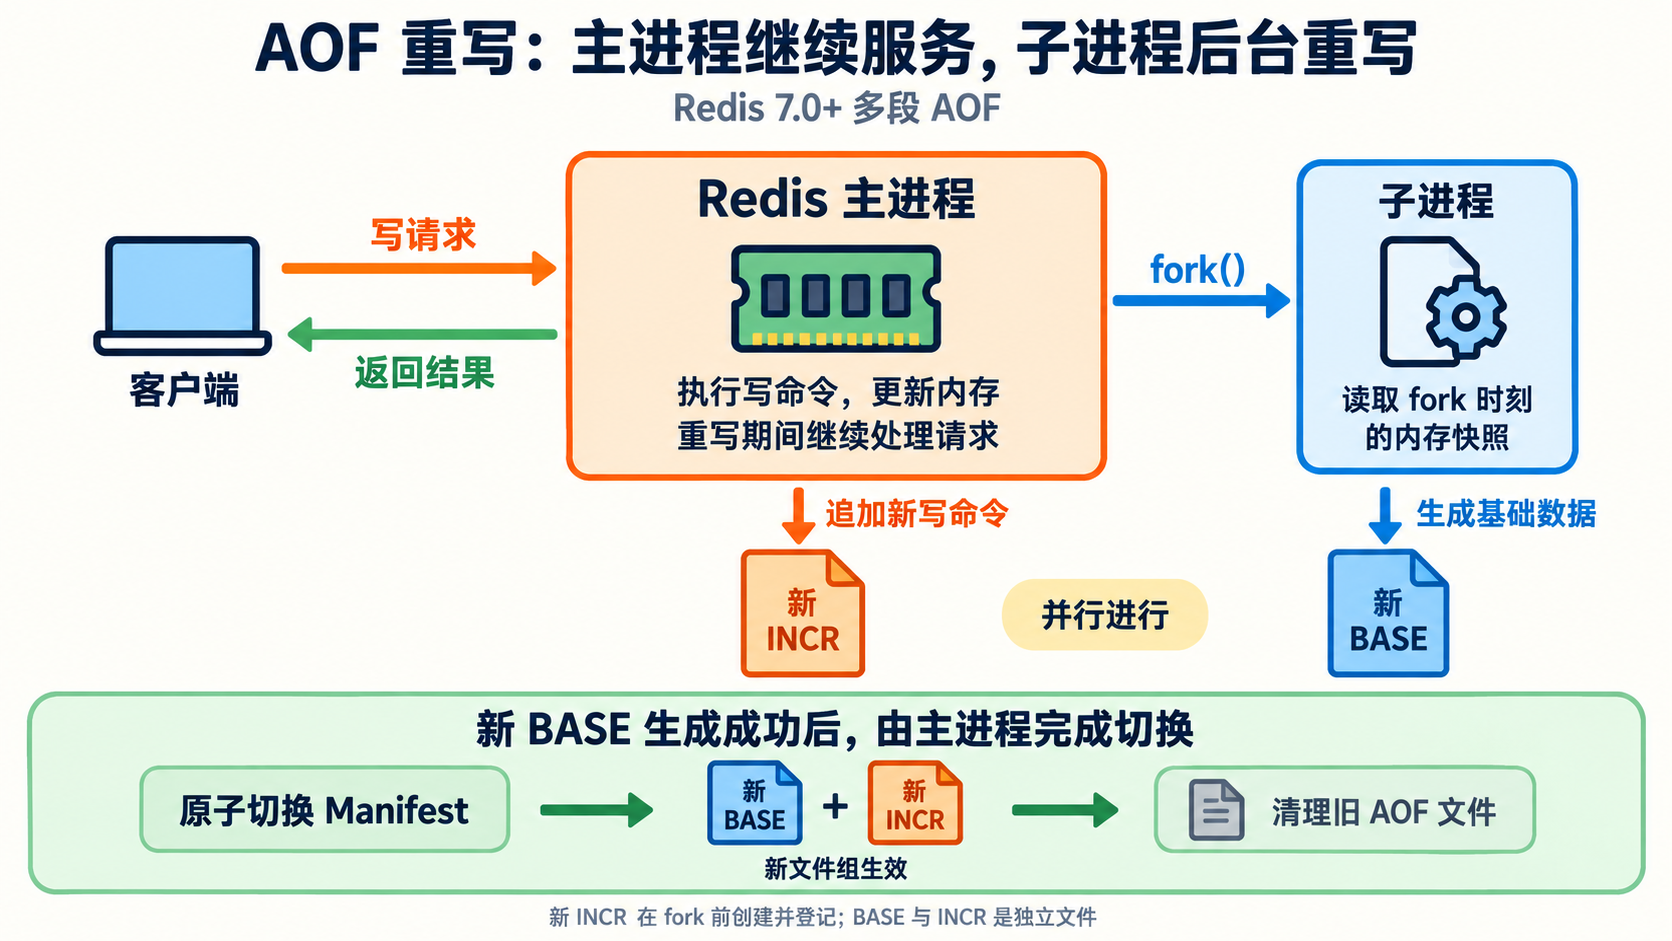
这种设计保证了重写期间 Redis 仍然可以正常处理读写请求,也不会遗漏重写期间新增的数据。
AOF 重写会阻塞 Redis 吗?
AOF 重写的大部分工作由子进程完成,因此不会让 Redis 在整个重写期间停止服务,但它并不是完全没有影响。
可能产生的开销包括:
fork()子进程时可能出现短暂延迟;- 重写期间发生大量写操作,会触发写时复制,增加内存占用;
- 子进程生成 BASE 文件会消耗 CPU 和磁盘 I/O;
- 主进程还需要继续写入 INCR 文件;
- 新旧文件短时间共存,需要额外磁盘空间;
- 磁盘性能不足时,可能影响正常 AOF 写入延迟。
因此,应避免在内存、磁盘空间不足或业务高峰期频繁执行 AOF 重写。
AOF 重写失败会怎样?
AOF 重写采用生成新文件后再切换的方式。
如果重写失败:
- 原有 AOF 文件不会立即被替换;
- Redis 仍然可以继续使用旧 AOF;
- 已有持久化数据不会因为一次重写失败而直接丢失;
- 应检查磁盘空间、权限、内存和持久化状态。
可以通过以下命令查看相关状态:
INFO persistence
重点关注:
aof_rewrite_in_progress
aof_rewrite_scheduled
aof_last_bgrewrite_status
aof_current_size
aof_base_size
具体字段可能随 Redis 版本发生变化。
AOF 重写的优点
- 删除大量冗余历史操作;
- 减少 AOF 占用的磁盘空间;
- 缩短 Redis 重启时的数据恢复时间;
- 降低备份和传输成本;
- 重写期间仍然可以继续处理客户端请求;
- 重写失败时不会直接破坏旧 AOF。
AOF 重写的缺点
fork()可能造成短暂延迟;- 写时复制可能增加内存占用;
- 消耗 CPU 和磁盘 I/O;
- 新旧文件并存时需要额外磁盘空间;
- 写入频繁时,重写期间的 INCR 文件仍可能快速增长;
- 重写主要改善文件体积和恢复速度,并不意味着正常读写性能一定会明显提升。
面试总结
AOF 重写是 Redis 为了解决 AOF 文件持续增长问题,根据当前内存中的最终数据状态,重新生成一份等价但更加紧凑的持久化文件。
AOF 重写不会读取旧 AOF 并逐条合并,而是根据当前数据直接生成新的基础状态。例如,多次执行 INCR 后,可以用一条能够恢复最终值的命令代替大量历史操作。
Redis 7.0 之后采用 BASE、INCR 和 Manifest 组成的多段 AOF。重写时,子进程负责生成新的 BASE 文件,主进程继续处理请求并将新增写操作保存到 INCR 文件,最后原子切换 Manifest。
AOF 重写可以减少磁盘占用并缩短恢复时间,但会带来 fork()、写时复制、CPU、内存和磁盘 I/O 开销。
参考:Redis Persistence、BGREWRITEAOF
7. AOF 重写时,如何保证新写操作不丢失?
先说一下为什么 AOF 重写期间可能丢失新写操作?
AOF 重写的子进程只能看到执行 fork() 时刻的内存数据。
在子进程生成新 AOF 的过程中,主进程仍然要继续处理客户端请求。如果客户端又执行了新的写命令,这些命令不会自动出现在子进程根据旧内存快照生成的文件中。
因此,Redis 需要额外记录重写期间产生的增量写操作,解决以下问题:
重写开始时的数据状态 + 重写期间新增的写操作 = 重写完成时的完整数据状态
这段话有点绕,意思就是,你重写期间,仍存在新的写操作
Redis 7.0 之前和 Redis 7.0 之后采用了不同的实现方式。
Redis 7.0 之后:多段 AOF
Redis 7.0 之后采用多段 AOF,主要包含:
- BASE 文件:保存重写开始时的基础数据;
- INCR 文件:保存 BASE 生成期间产生的新写命令;
- Manifest 文件:记录恢复数据时应该加载哪些 BASE 和 INCR 文件。
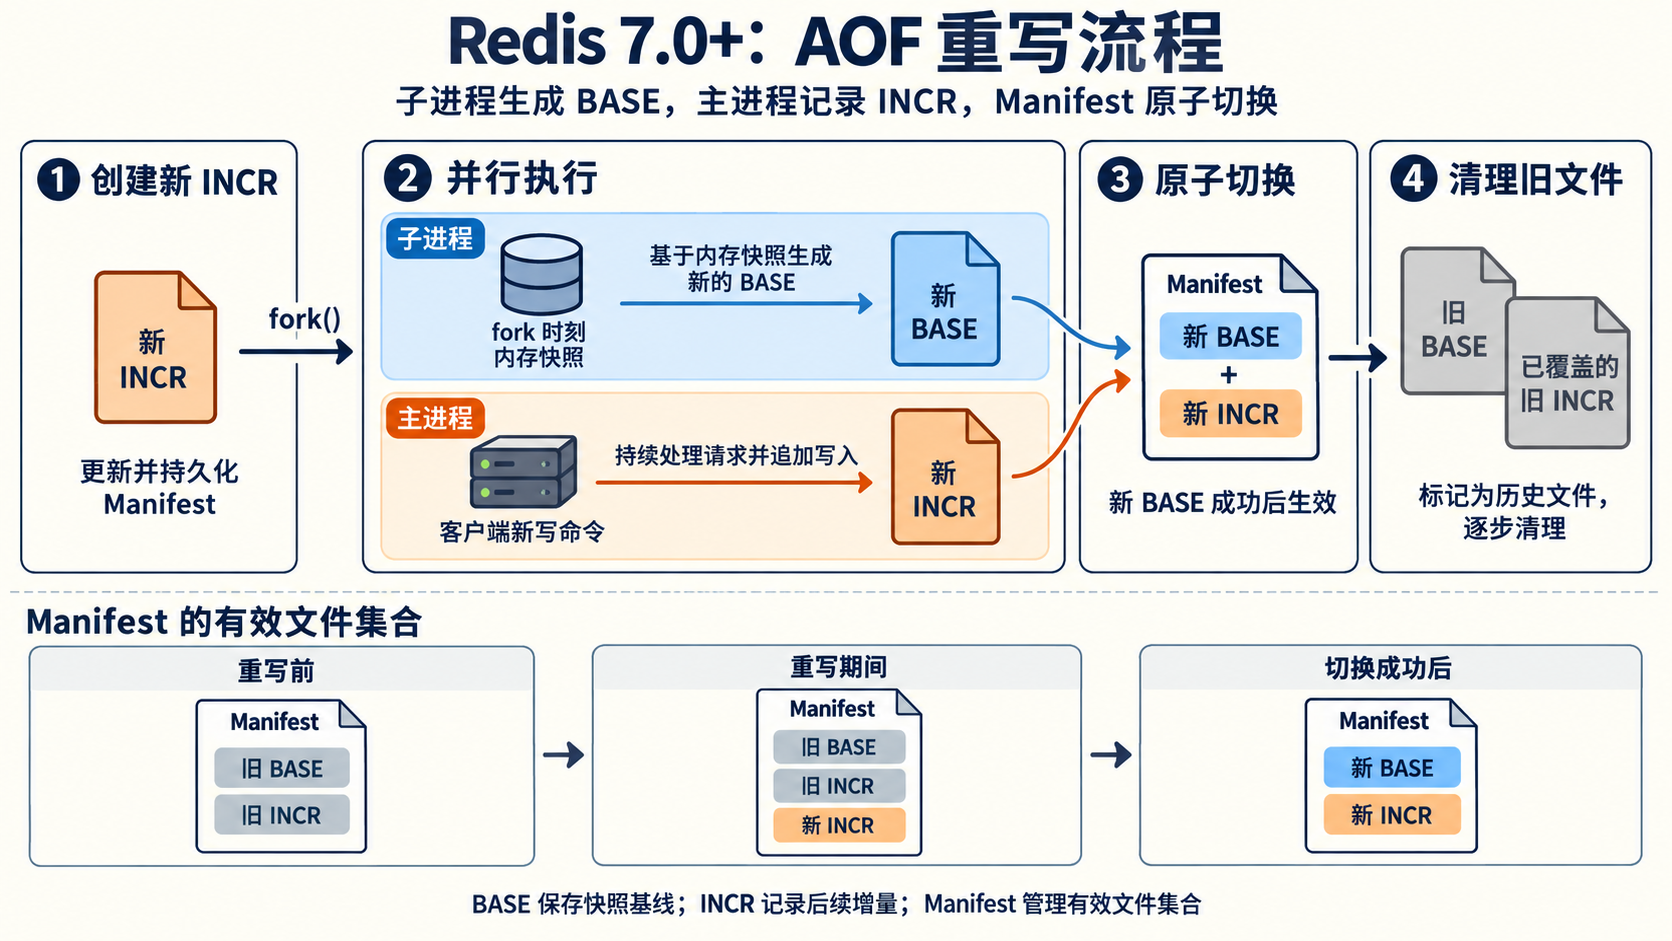
重写过程
开始重写时,主进程会打开一个新的 INCR 文件,后续写命令直接追加到该文件中。
同时,Redis 会持久化更新 Manifest,使新的 INCR 文件成为有效 AOF 文件集合的一部分。
旧 BASE + 旧 INCR
          ↓
       开始重写
          ↓
创建新的 INCR,并更新 Manifest
子进程生成新的 BASE
Redis 通过 fork() 创建子进程。子进程根据 fork 时刻的内存数据生成新的 BASE 文件。
子进程:内存快照 → 新 BASE
主进程继续记录新写命令
重写期间,主进程继续正常处理客户端请求,新产生的写命令追加到新的 INCR 文件:
主进程:客户端新写入 → 新 INCR
这样,子进程生成 BASE 与主进程记录增量写入可以同时进行。
原子切换 Manifest
新的 BASE 生成成功后,Redis 生成新的 Manifest,使其指向:
新 BASE + 新 INCR
然后通过原子替换的方式让新 Manifest 生效。
最后,旧的 BASE 和已经被新 BASE 覆盖的 INCR 文件会被标记为历史文件并逐步清理。
完整流程可以表示为:
重写失败或宕机会怎样?
在新 BASE 和 Manifest 完成切换之前,旧的有效 AOF 文件不会直接被覆盖。
如果重写失败:
- 旧 BASE 和旧 INCR 仍然有效;
- 重写期间产生的新写命令已经记录在新的 INCR 中;
- Redis 可以继续使用旧的文件集合;
- 下一次可以重新执行 AOF 重写。
如果新 BASE 生成成功,则通过 Manifest 原子切换到:
新 BASE + 新 INCR
这种“先生成新文件,再原子切换”的方式可以避免半成品 BASE 直接替换有效 AOF。
不过,新写操作最终是否已经真正落盘,仍然取决于 appendfsync 策略:
always:每批写命令刷盘,可靠性最高;everysec:通常可能丢失最近约一秒的数据;no:由操作系统决定刷盘时间,丢失窗口更大。
因此,多段 AOF 保证的是重写过程中没有逻辑上的写入缺口,并不代表脱离刷盘策略后可以绝对零丢失。
Redis 7.0 之前:AOF 重写缓冲区
Redis 7.0 之前使用的是经典的单文件 AOF 和 AOF 重写缓冲区。
重写期间,每个新写命令会同时写入:
- 当前正在使用的旧 AOF;
- AOF 重写缓冲区。
并不是只写入重写缓冲区。
客户端新写命令
       ├→ 旧 AOF 文件
       └→ AOF 重写缓冲区
完整过程如下:
- Redis 创建子进程;
- 子进程根据 fork 时刻的内存数据生成临时 AOF;
- 主进程继续处理请求;
- 重写期间的新命令同时追加到旧 AOF和重写缓冲区;
- 子进程完成后,主进程将重写缓冲区中的命令追加到临时 AOF;
- 通过原子重命名,用新 AOF 替换旧 AOF。
子进程:生成临时新 AOF
主进程:新命令 → 旧 AOF + 重写缓冲区
                         ↓
       将重写缓冲区追加到临时新 AOF
                         ↓
                原子替换旧 AOF
如果重写过程中 Redis 发生故障,旧 AOF 仍然存在,可以用于恢复;如果重写成功,新 AOF 则包含基础数据和重写期间的新增写操作。
面试总结
AOF 重写的子进程只能看到 fork 时刻的数据,因此 Redis 必须额外记录重写期间的新增写操作。
Redis 7.0 之后采用多段 AOF:
- 子进程生成新的 BASE 文件;
- 主进程将重写期间的新写命令追加到新的 INCR 文件;
- 重写成功后,原子更新 Manifest,使其指向“新 BASE + 新 INCR”;
- 如果重写失败,旧文件和已经纳入 Manifest 的增量文件仍可继续使用。
Redis 7.0 之前则使用 AOF 重写缓冲区。新命令会同时写入旧 AOF 和重写缓冲区,子进程完成后,再将缓冲区追加到临时新 AOF,最后原子替换旧文件。
无论哪种机制,最终的数据持久性仍然受到 appendfsync 策略影响。
参考:Redis Persistence、Redis 7.2 AOF Implementation
8. 同时开启 RDB 和 AOF 时,Redis 重启优先使用哪种方式恢复?
先说RDB 和 AOF 恢复是什么?
Redis 的数据主要保存在内存中,重启后需要通过持久化文件重新构建内存数据。
- RDB:保存某个时间点的数据快照;
- AOF:记录数据发生变化的写命令,重启时通过加载并回放这些内容恢复数据。
两者都是为了解决 Redis 重启后数据恢复的问题,但数据完整性、恢复速度和性能开销不同。
Redis 会优先加载 AOF
当 RDB 和 AOF 同时开启,并且 AOF 文件有效时,Redis 重启会优先使用 AOF 恢复数据,而不会先加载 RDB 再合并 AOF。
Redis 启动
   ↓
是否启用 AOF?
   ├── 是:加载 AOF
   └── 否:加载 RDB
相关配置示例:
appendonly yes
save 3600 1
虽然同时配置了 AOF 和 RDB,但重启恢复时优先选择 AOF。
为什么优先使用 AOF?
AOF 通常比 RDB 保存的数据更加完整。
假设 Redis 每隔五分钟生成一次 RDB:
10:00:生成 RDB
10:01:写入数据 A
10:02:写入数据 B
10:03:Redis 宕机
使用 RDB 恢复时,可能只能恢复到 10:00 的状态,之后的数据 A 和 B 可能丢失。
AOF 会持续记录写操作,其数据丢失窗口取决于 appendfsync 策略:
always:每批写命令刷盘,数据丢失风险最低,但性能开销较大;everysec:通常可能丢失最近约一秒的数据;no:由操作系统决定刷盘时机,数据丢失窗口可能更大。
因此,不能笼统地说 AOF 最多只丢失一秒数据,只有使用 appendfsync everysec 时,才通常具有约一秒的数据丢失窗口。
Redis 7.0 之后如何恢复 AOF?
Redis 7.0 之后采用多段 AOF,主要包括:
- BASE 文件:保存基础数据状态;
- INCR 文件:保存 BASE 之后产生的增量写操作;
- Manifest 文件:记录有效文件及其加载顺序。
重启时按照 Manifest 加载:
BASE
  ↓
INCR 1
  ↓
INCR 2
  ↓
恢复最终数据状态
BASE 文件可能采用 RDB 格式,例如:
appendonly.aof.2.base.rdb
虽然它的内容是 RDB 格式,但它属于多段 AOF 的 BASE 文件,整个恢复过程仍然是 AOF 恢复流程,不能将其理解为 Redis 改成了优先加载普通 dump.rdb。
AOF 损坏后会自动改用 RDB 吗?
通常不会。
“如果 AOF 不存在或损坏,Redis 就自动使用 RDB 兜底”不是一个可靠的恢复规则。
AOF 尾部不完整
如果 Redis 在写入 AOF 时突然宕机,最后一条命令可能只写了一部分。
较新的 Redis 在启用以下配置时,可以丢弃尾部不完整的命令并继续启动:
aof-load-truncated yes
Redis 会打印警告,并恢复到最后一条完整命令对应的状态。
AOF 中间损坏
如果 AOF 中间出现非法内容或严重损坏,Redis 通常会拒绝启动,而不是自动加载 RDB。
此时应:
- 先备份原始 AOF 文件;
- 使用
redis-check-aof检查损坏位置; - 评估能否手动修复;
- 必要时使用
redis-check-aof --fix; - 如果决定改用 RDB,应由运维人员明确选择并验证恢复点。
例如:
redis-check-aof appendonly.aof.manifest
具体参数需要根据 Redis 版本以及单文件、多段 AOF 格式确定。
自动修复可能丢弃损坏位置之后的数据,因此不能在没有备份和评估的情况下直接执行。
为什么不自动降级到 RDB?
如果 Redis 发现 AOF 损坏后自动加载 RDB,虽然可能成功启动,但 RDB 很可能是更早的快照。
这样会产生两个风险:
- 运维人员不知道 Redis 已经恢复到了更旧的数据;
- 服务继续接受写入后,会让后续数据恢复更加困难。
因此,遇到严重的 AOF 加载错误时停止启动,让管理员明确选择恢复方案,通常比静默加载旧 RDB 更安全。
同样,如果启用了 AOF,但预期中的 AOF 文件丢失,也不能依赖 Redis 自动选择 RDB。切换恢复方式时应明确检查配置、文件路径和恢复结果。
同时开启 RDB 和 AOF 的意义
同时开启两种持久化,并不意味着 Redis 启动时会将两份数据合并。
通常可以这样理解:
- AOF 用于日常重启恢复,追求较小的数据丢失窗口;
- RDB 用于定期快照、备份和灾难恢复;
- 出现 AOF 严重损坏时,可以由管理员评估是否使用 RDB 恢复。
AOF 也不能代替独立备份。误执行 DEL 或 FLUSHALL 后,这些操作同样可能被写入 AOF。
面试总结
同时开启 RDB 和 AOF 时,Redis 重启会优先使用 AOF 恢复,因为 AOF 通常记录了比 RDB 更新、更完整的数据。
Redis 不会先加载 RDB 再合并 AOF。Redis 7.0 之后会根据 Manifest 依次加载多段 AOF 中的 BASE 和 INCR 文件,即使 BASE 使用 RDB 格式,它也仍属于 AOF 恢复流程。
需要注意,AOF 损坏时 Redis 通常不会自动改用普通 RDB:
- 尾部截断可以根据
aof-load-truncated配置进行容错; - 中间损坏通常会导致启动失败,需要检查和修复;
- 如果决定使用 RDB 恢复,应由管理员明确操作并验证数据恢复点。
阅读导航
上一章:Redis 集群
下一章:Redis 分布式



