
第三章 指针、引用与内存基础
第三章 指针、引用与内存基础
1. 野指针和悬空指针有什么区别?如何避免?
问题分析
这道题不只是让你罗列名词,而是考查能否从地址语义、对象生命周期与所有权做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:野指针通常指从未被初始化为有效地址的指针;
- 再讲机制:围绕“两类无效指针 → 常见形成方式与预防”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 客户端一面
问题讲解
一、两类无效指针
野指针通常指从未被初始化为有效地址的指针;悬空指针曾经指向有效对象,但对象已经析构、释放,或容器操作使原地址失效。二者一旦解引用都可能触发未定义行为,设为 nullptr 只能避免某个变量继续误用,不能修复其他地址副本。
二、常见形成方式与预防
返回局部变量地址、释放后继续访问、保存临时对象引用、vector 扩容后继续使用旧迭代器,都会产生悬空。优先使用局部对象、容器和 RAII;用智能指针表达所有权,用引用或裸指针表达短期借用;让借用者的寿命短于所有者,并遵守容器失效规则。调试时可使用 AddressSanitizer,但工具不能替代生命周期设计。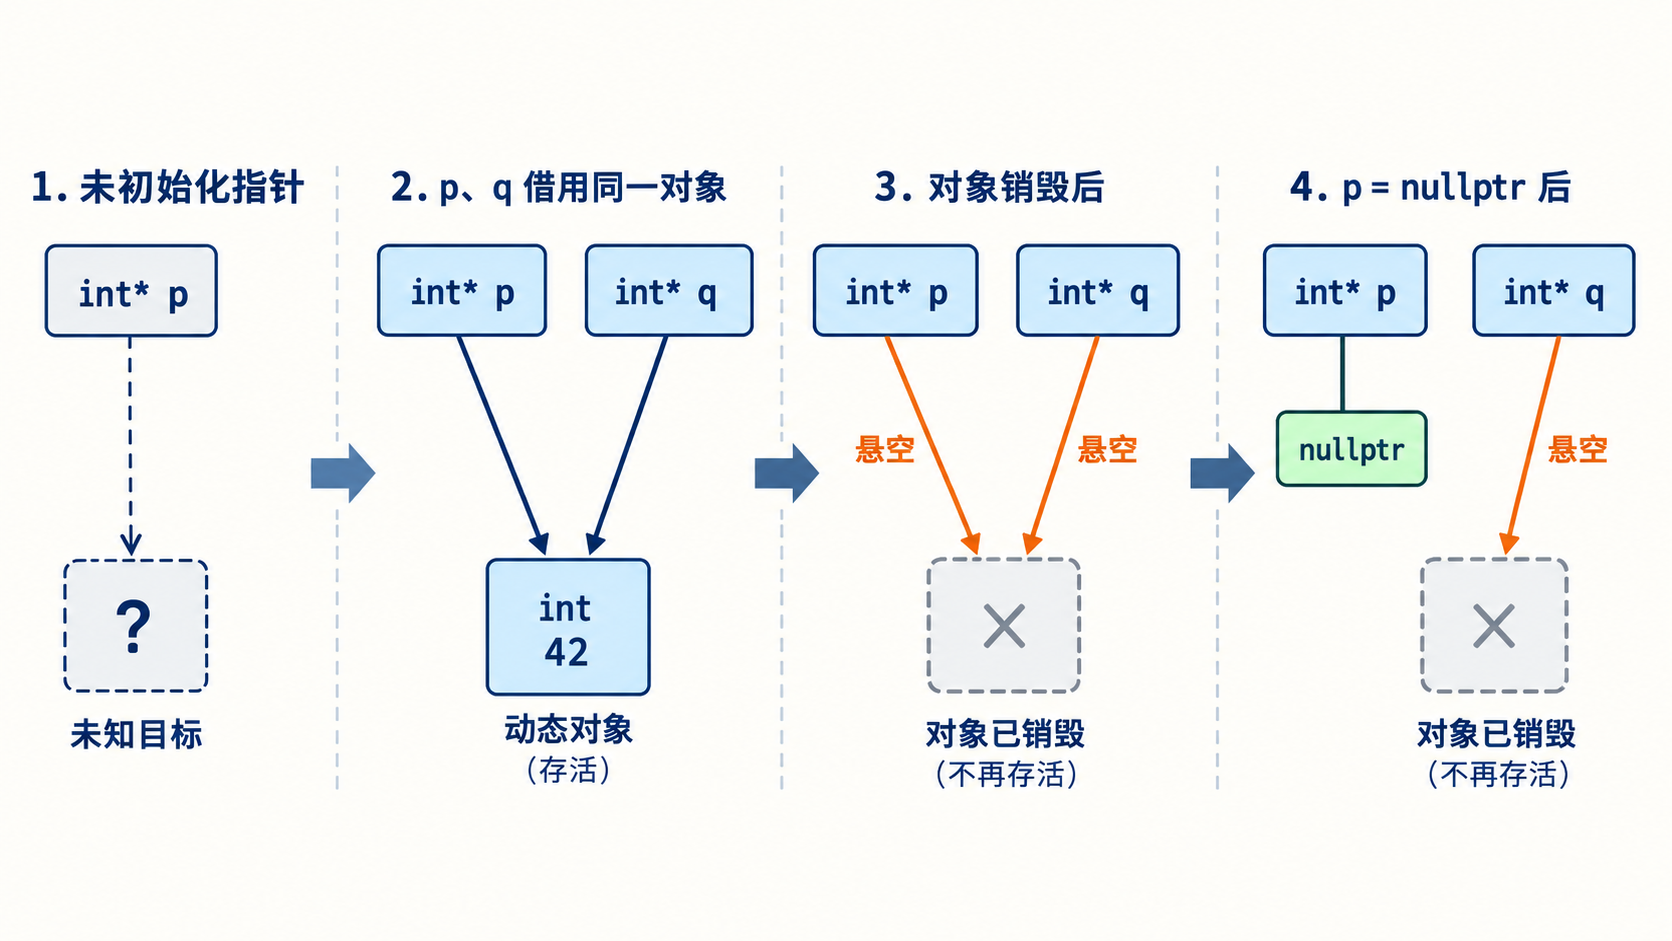
三、常见错误
- 认为
delete p; p = nullptr;能让所有指向该对象的指针都失效为可检测状态。 - 只检查指针是否非空,却不检查其所指对象是否仍存活。
- 返回局部变量的指针或引用。
- 认为释放后的内存仍保留原值,所以读取是安全的。
回答自检
- 野指针与悬空指针的来源差异。
- 为什么非空不代表有效。
- 所有权和借用如何约束生命周期。
- 常见容器操作为何会使地址失效。
- 工具检测与设计预防各自的作用。
面试官可能追问的问题
- 空指针和悬空指针有什么区别? 空指针明确“不指向对象”,悬空指针的地址值看似存在但对象已不存在。
- 引用会悬空吗? 会,引用也不延长一般对象的生命周期。
- 如何发现 use-after-free? 开启 ASan、编写生命周期测试,并检查所有权和容器失效点。
2. 指针和引用有什么区别?分别适合什么场景?
问题分析
这道题不只是让你罗列名词,而是考查能否从地址语义、对象生命周期与所有权做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:指针可以复制、比较是否相等、与空指针比较,也可以在同一数组(或其尾后位置)内做加减和相减。
- 再讲机制:围绕“指针允许哪些基本运算? → 语义差异 → 边界与选择”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
补充:指针允许哪些基本运算?
指针可以复制、比较是否相等、与空指针比较,也可以在同一数组(或其尾后位置)内做加减和相减。指针加一移动的是一个元素,而不是一个字节;两个指针相减只有在指向同一数组对象时才有定义。对空指针、已释放指针或不属于同一数组的指针做解引用、加减或相减都可能产生未定义行为。
一、语义差异
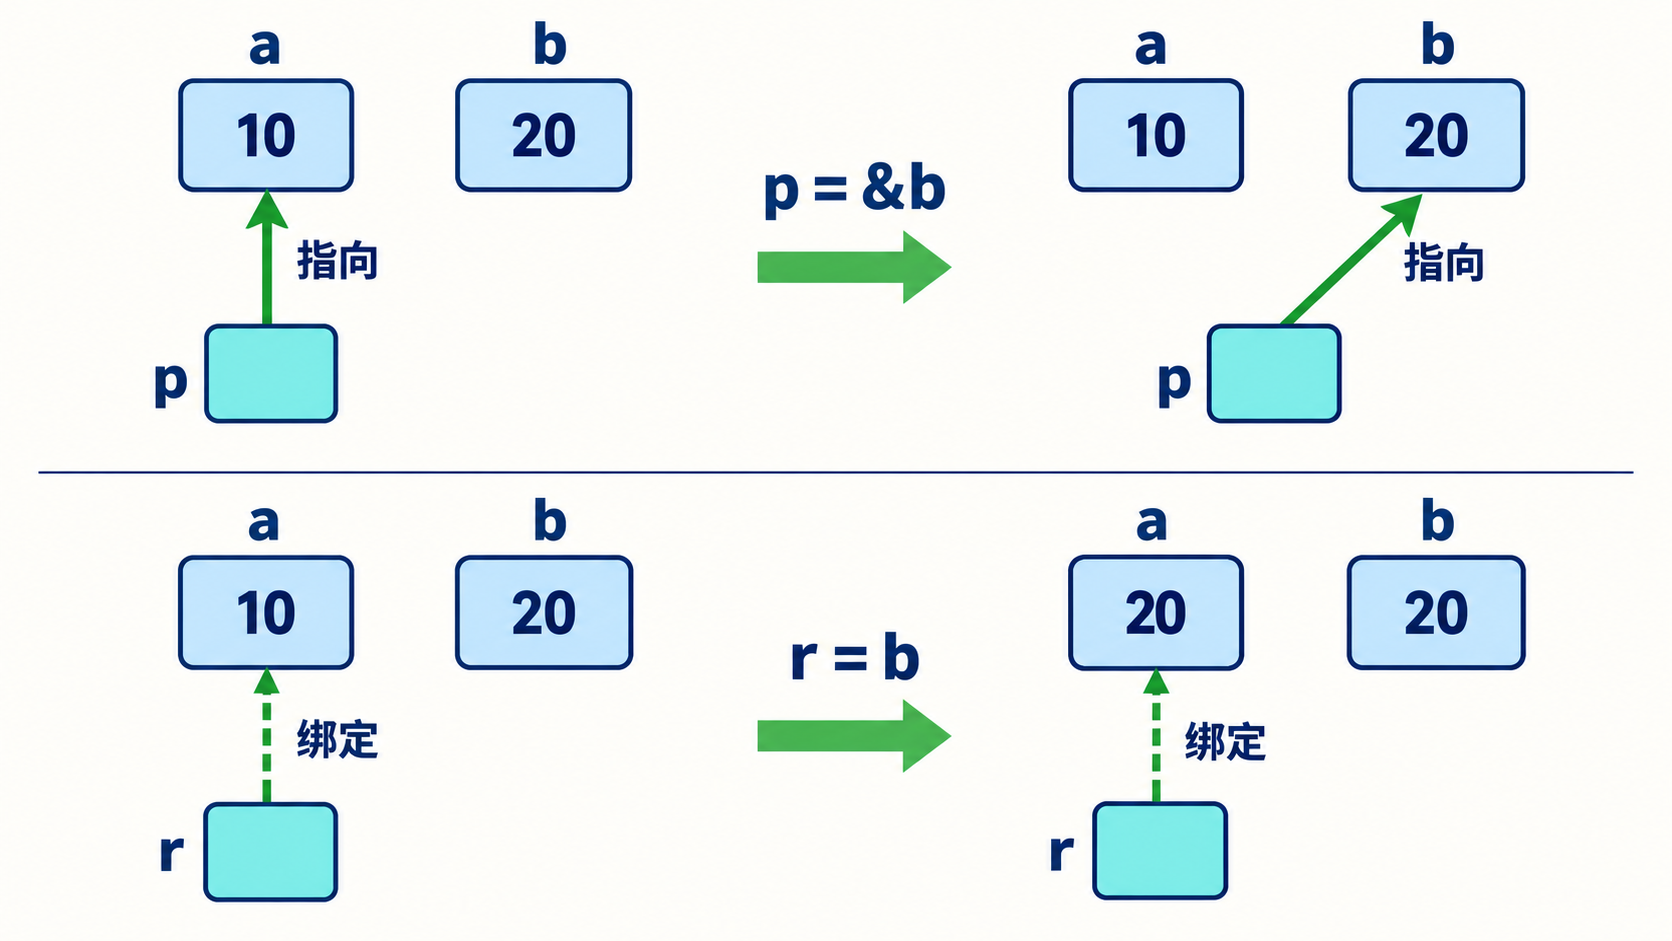
引用在初始化时绑定到对象,之后不能改为绑定另一个对象;普通对象指针保存地址,可以改指向,也可以是 nullptr。通过引用访问使用对象语法,通过指针访问必须显式解引用。两者都不自动拥有对象,也都可能悬空。
| 维度 | T& | T* |
|---|---|---|
| 是否必须初始化 | 是 | 变量可暂未指向对象 |
| 是否可为空 | 语言语义上不可为空 | 可以为 nullptr |
| 能否改指向 | 不能重新绑定 | 可以 |
| 访问语法 | 与对象相同 | *p、p->x |
| 常见含义 | 必须存在的借用 | 可选借用、数组遍历、底层接口 |
二、边界与选择
引用的底层表示由实现决定,不能把“引用一定就是常量指针”当作标准保证。右值引用 T&& 主要参与值类别、移动和转发,不表示“可空引用”。涉及所有权时应使用值对象或智能指针,而不是让裸指针承担含糊的释放责任。
三、常见错误
- 认为引用永远不会悬空。
- 用指针表示必选参数,却又忘记空值检查。
- 认为传指针不是值传递;地址值本身仍被复制。
- 用裸指针表达共享所有权。
回答自检
- 引用的绑定语义和指针的地址语义。
- 可空性如何影响接口选择。
- 指针与引用都不等于所有权。
- 两者为什么都可能悬空。
- 标准语义与底层实现的区别。
面试官可能追问的问题
- 引用能否放入标准容器? 引用不是对象类型,
std::vector<T&>不满足其元素要求,不能直接存引用。可存std::reference_wrapper<T>来表达借用,但被引用对象仍须存活;不同容器和操作对可赋值性的要求并不相同。 - 什么时候返回指针而非引用? “找不到”可自然表示为
nullptr时;也可使用optional<reference_wrapper<T>>。 - 引用是否占对象大小? 作为成员通常需要某种表示,但标准不规定其具体大小。
3. 什么是 void*?为什么不应把它当作通用安全指针?
问题分析
这道题考查能否从可观察现象追溯到地址语义、对象生命周期与所有权中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
void*可以保存任意对象指针转换得到的地址,常用于 C API、内存分配器和回调上下文。 - 再讲机制:围绕“能力与限制 → 如何安全使用”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节基础架构一面
问题讲解
一、能力与限制
void* 可以保存任意对象指针转换得到的地址,常用于 C API、内存分配器和回调上下文。因为 void 没有大小和对象布局,不能直接解引用或做标准意义上的对象步进;恢复时必须显式转换为正确类型。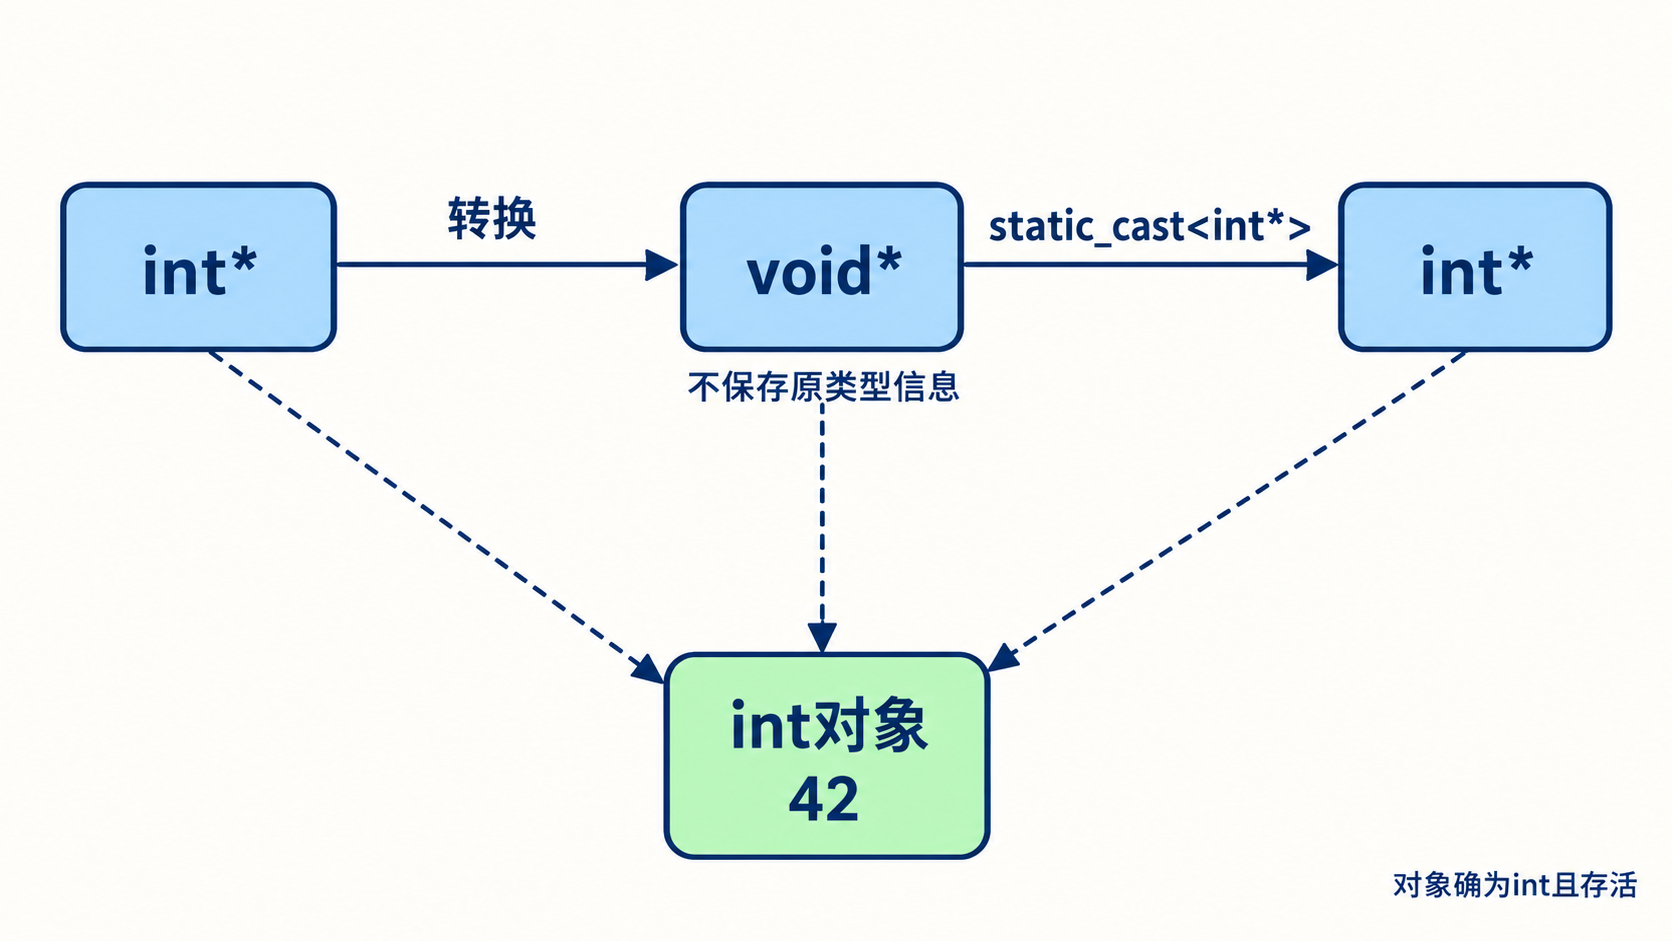
二、如何安全使用
C++ 中优先使用模板、虚函数、std::variant、std::any 或带类型的回调。必须跨 C 边界时,把 void* 当作不拥有对象的上下文句柄:明确真实类型、生命周期、线程规则和对应销毁函数。malloc 返回 void*,在 C++ 中不能隐式转换为其他对象指针。
三、常见错误
- 认为
void*能记录原始类型并自动恢复。 - 对
void*直接解引用或做指针算术。 - 把栈对象地址传给异步 C 回调,函数返回后继续使用。
- 用
reinterpret_cast掩盖对象类型或对齐不匹配。
回答自检
void*能保存什么、丢失什么。- 为什么不能直接解引用。
- C 回调上下文如何约束生命周期。
- 类型安全替代方案各自适用的场景。
面试官可能追问的问题
- 函数指针能否无条件转为
void*? 标准不保证对象指针与函数指针可相互转换。 std::any比void*多什么? 它记录所存值的类型并管理其生命周期,错误取值可被检测。void*是否拥有对象? 类型本身不表达所有权,必须由接口协议说明。
4. const int*、int* const 和 const int* const 如何区分?
问题分析
这道题考查能否把地址语义、对象生命周期与所有权转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
char*既能读也能写字符; - 再讲机制:围绕“字符指针的四种组合 → 从变量名向外读”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯音视频一面
问题讲解
补充:字符指针的四种组合
char* 既能读也能写字符;const char* 只能通过当前指针读取;char* const 不能改指针指向但能改字符;const char* const 两层都不能改。字符串字面量具有静态存储期且不能修改,应该用 const char* 或 std::string_view 接收。
一、从变量名向外读
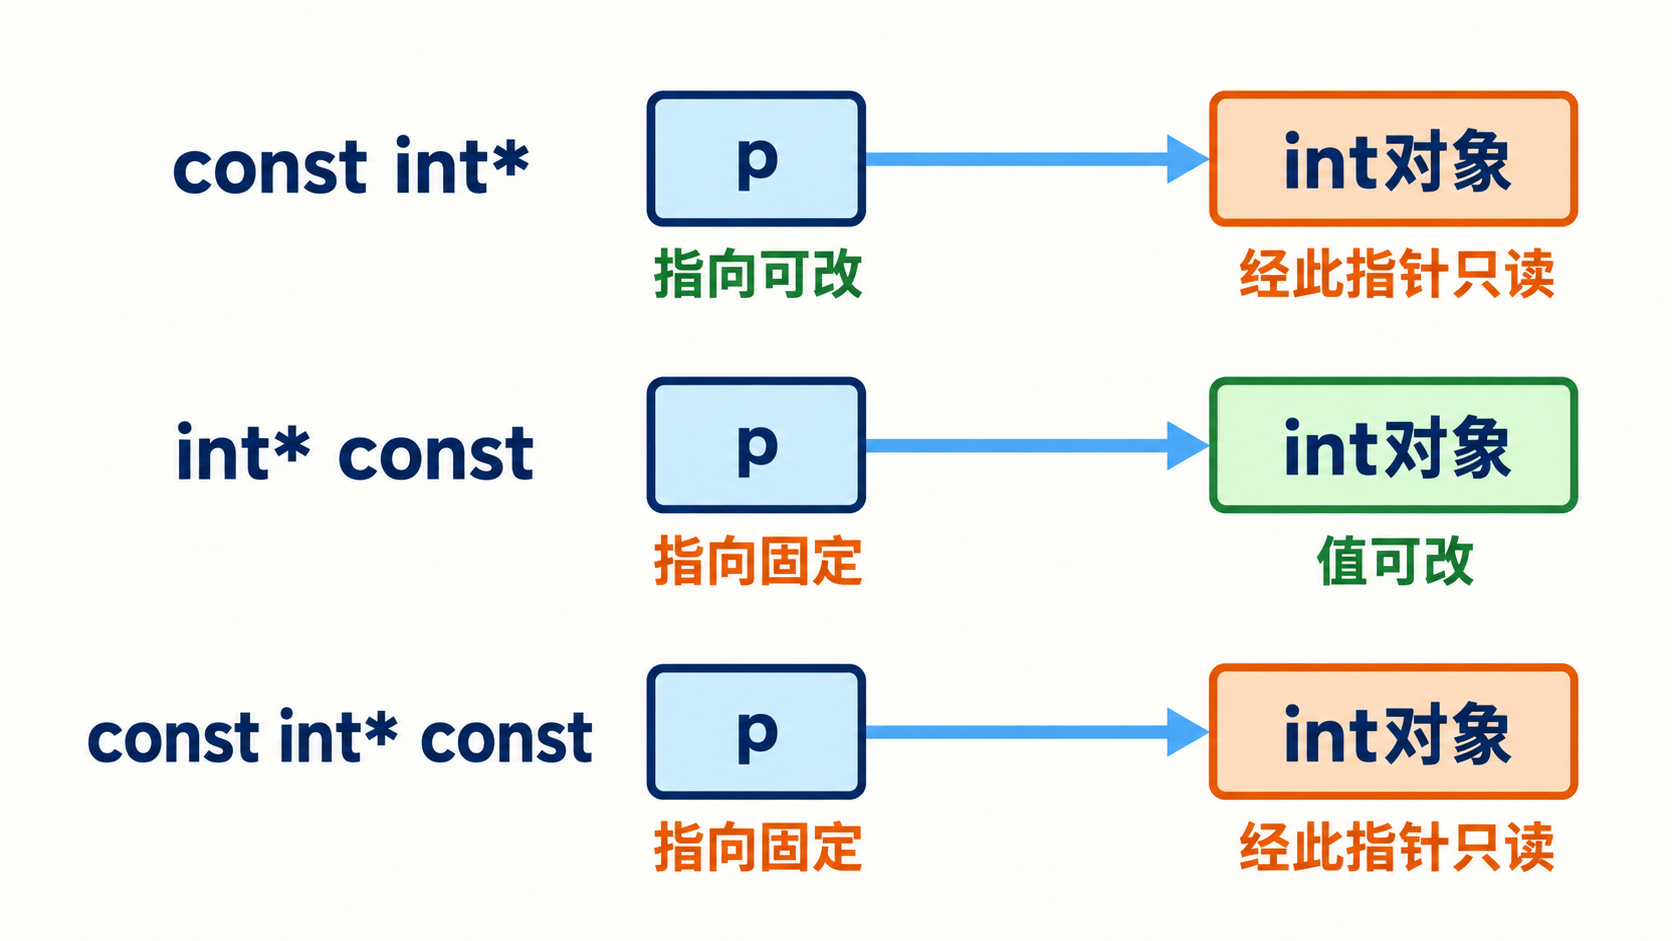
const int* p 是指向常量整数的指针:可以改变 p,不能通过 p 修改整数。int* const p 是常量指针:必须初始化,不能改变指向,但能修改所指整数。const int* const p 两者都限制。
指针自身的 const 是顶层 const;所指类型的 const 是底层 const。把 int* 转成 const int* 是增加只读限制,通常安全;反向移除 const 需要显式转换,若原对象确实是 const,再写入就是未定义行为。
下面的完整示例把“修改指向”和“修改所指对象”分别落到可编译语句上。被注释的语句若解除注释,应产生编译错误,这正是类型系统提供的保护。
#include <iostream>

int main() {
    int first = 10;
    int second = 20;

    const int* points_to_const = &first;
    points_to_const = &second;       // 可以改指向
    // *points_to_const = 30;        // 错:不能通过它修改对象

    int* const const_pointer = &first;
    *const_pointer = 30;             // 可以修改所指对象
    // const_pointer = &second;      // 错:不能改指向

    const int* const both_const = &second;
    std::cout << *points_to_const << ' '
              << *const_pointer << ' '
              << *both_const << '\n';
}
二、常见错误
- 靠“const 在星号左边还是右边”死记,却遇到别名后判断失败。
- 认为
const int*指向的对象本身一定是 const;它只限制通过该路径修改。 - 用
const_cast修改原本声明为 const 的对象。 - 忘记常量指针必须初始化。
回答自检
- 三种声明分别限制哪一层。
- 顶层 const 与底层 const。
- 增加和移除 const 的安全边界。
- 类型别名为何容易让位置记忆法失效。
面试官可能追问的问题
const成员函数限制什么? 限制通过this修改非mutable成员,并使this指向 const 对象。typedef int* P; const P是什么? 是int* const,const 修饰别名整体。- 为什么接口常接受
const T*? 表明函数借用对象但不通过该指针修改它。
5. nullptr、NULL 和整数 0 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从地址语义、对象生命周期与所有权做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:整数常量
0可以作为空指针常量,但它本质仍是整数。 - 再讲机制:围绕“为什么引入
nullptr→ 工程规则”说明规则如何生效,把关键对象、时机或状态变化串起来。 - 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度 C++ 一面
问题讲解
一、为什么引入 nullptr
整数常量 0 可以作为空指针常量,但它本质仍是整数。NULL 通常是实现定义的宏,常展开为 0 或类似整数表达式,因此遇到 f(int) 与 f(char*) 重载时可能选中整数版本。nullptr 的类型是 std::nullptr_t,可转换为任意对象或函数指针,但不会隐式转换为普通整数。
二、工程规则
C++11 以后统一使用 nullptr 表达空指针。模板中它也保留明确类型,有助于重载决议和泛型转发。检查指针时可写 if (p) 或 p != nullptr,不应使用无关的哨兵地址。
三、常见错误
- 认为
NULL一定是(void*)0;那是常见 C 写法,C++ 中通常不是。 - 用
0同时表达数字零和空指针,使重载含糊。 - 认为
nullptr是关键字形式的地址 0;它表示空指针值,具体位模式不由语言保证。 - 对已悬空指针与
nullptr比较,以为可以检测生命周期。
回答自检
- 三者的类型差异。
nullptr如何改善重载决议。- 空指针值与机器位模式的区别。
- 为什么现代 C++ 不再推荐
NULL。
面试官可能追问的问题
sizeof(nullptr)是多少? 等于sizeof(std::nullptr_t),具体值由实现决定。- 能否把
nullptr赋给bool? 可在布尔上下文使用,直接初始化bool也可得到 false。 - 空指针的机器表示是否全零? 标准不作普遍保证。
6. 函数指针和成员函数指针有什么区别?如何用于回调?
问题分析
这道题不只是让你罗列名词,而是考查能否从地址语义、对象生命周期与所有权做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:普通函数指针只需保存可调用代码入口,例如
int (*)(int)。 - 再讲机制:围绕“两类调用目标 → 回调如何选择”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:小鹏 C++ 开发一面
问题讲解
一、两类调用目标
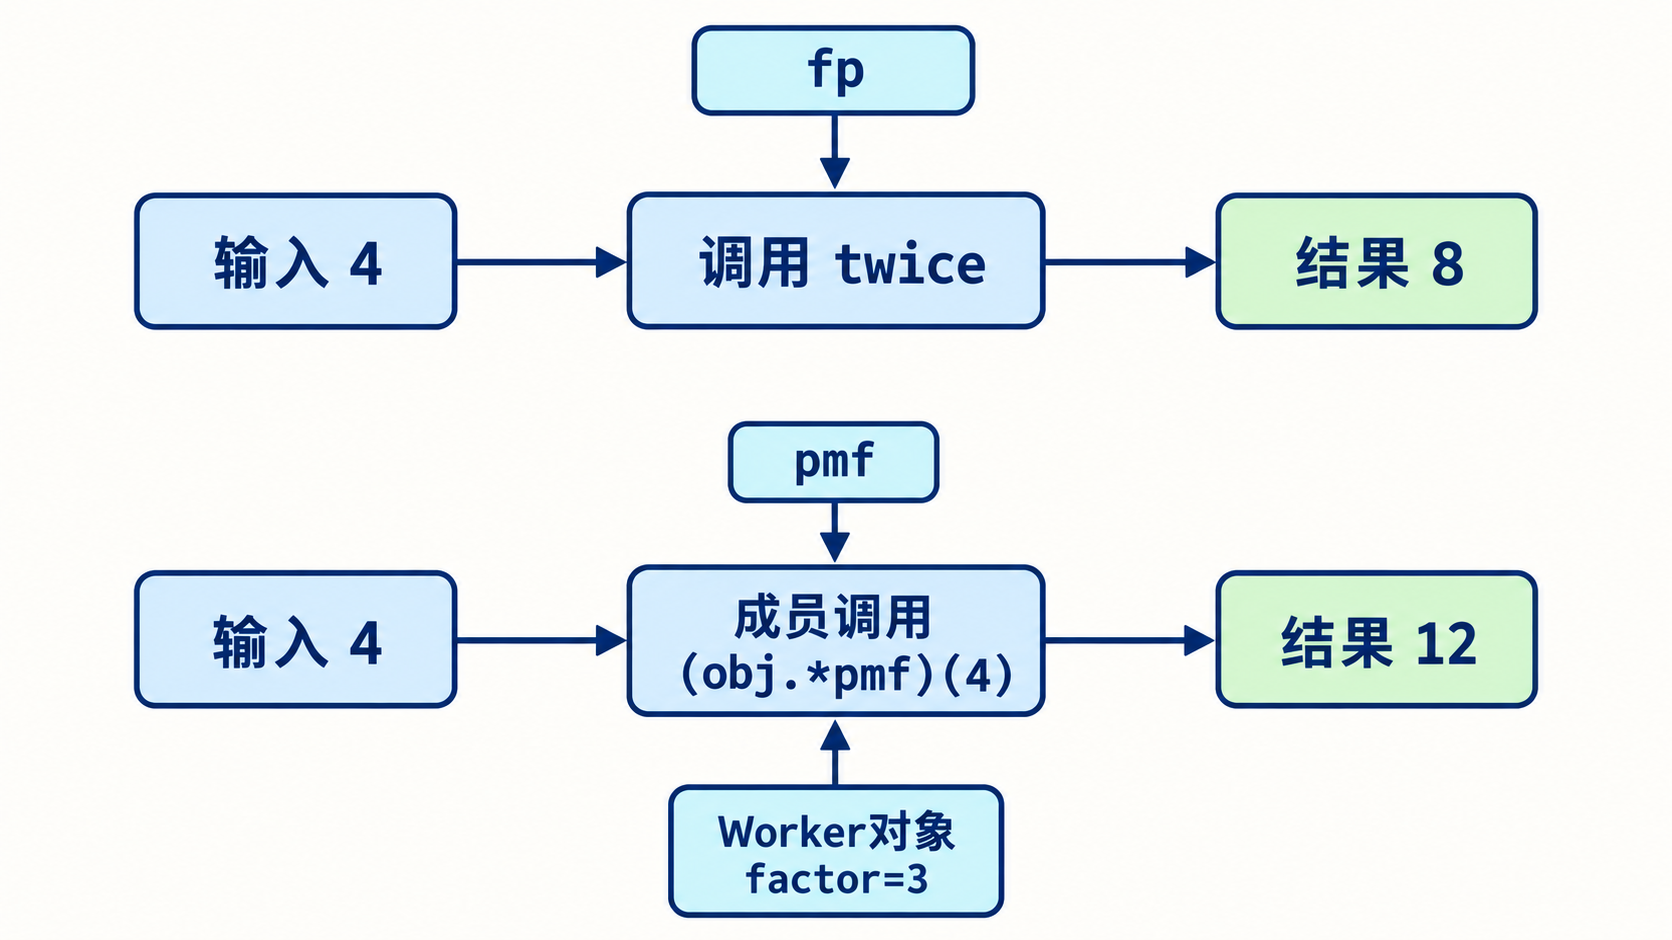
普通函数指针只需保存可调用代码入口,例如 int (*)(int)。非静态成员函数隐含 this,其指针类型包含所属类,例如 int (Worker::*)(int) const,调用时必须同时提供对象:(obj.*pmf)(x) 或 (ptr->*pmf)(x)。其大小和表示由 ABI 决定,不保证等同普通地址。
二、回调如何选择
C API 常用“函数指针 + void* 上下文”。纯 C++ 接口更常用模板接收任意可调用对象,或在需要统一存储时用 std::function。Lambda 可以捕获对象状态,但异步回调必须特别处理捕获对象的生命周期。
#include <functional>
#include <iostream>

class Worker {
public:
    int scale(int x) const { return factor_ * x; }
private:
    int factor_ = 3;
};

int twice(int x) { return x * 2; }

int main() {
    int (*fp)(int) = &twice;
    int (Worker::*pmf)(int) const = &Worker::scale;
    Worker worker;
    std::function<int(int)> callback = [&worker](int x) { return worker.scale(x); };
    std::cout << fp(4) << ' ' << (worker.*pmf)(4) << ' ' << callback(4) << '\n';
}
三、常见错误
- 把非静态成员函数指针强转为普通函数指针。
- 异步 Lambda 按引用捕获局部对象,任务执行时对象已销毁。
- 所有回调都使用
std::function,忽略类型擦除和潜在分配成本。 - 忘记成员函数的
const、noexcept等也属于类型的一部分。
回答自检
- 两类指针的类型和调用语法。
- 成员函数为什么需要对象。
- C 回调上下文的作用。
- 模板、Lambda 和
std::function的选择。 - 异步回调的生命周期风险。
面试官可能追问的问题
- 静态成员函数能否作 C 回调? 没有
this,通常可像普通函数使用,但仍应核对调用约定。 - 模板回调和
std::function如何选? 模板利于内联且无固定擦除成本;std::function适合统一存储和运行期替换。 std::invoke有什么用? 用统一语法调用函数、成员函数指针和其他可调用对象。
7. new/delete 和 malloc/free 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从地址语义、对象生命周期与所有权做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
malloc按字节申请原始存储,返回void*,不调用构造函数; - 再讲机制:围绕“核心区别 → 选择与边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:阿里云 C++ 一面
问题讲解
一、核心区别
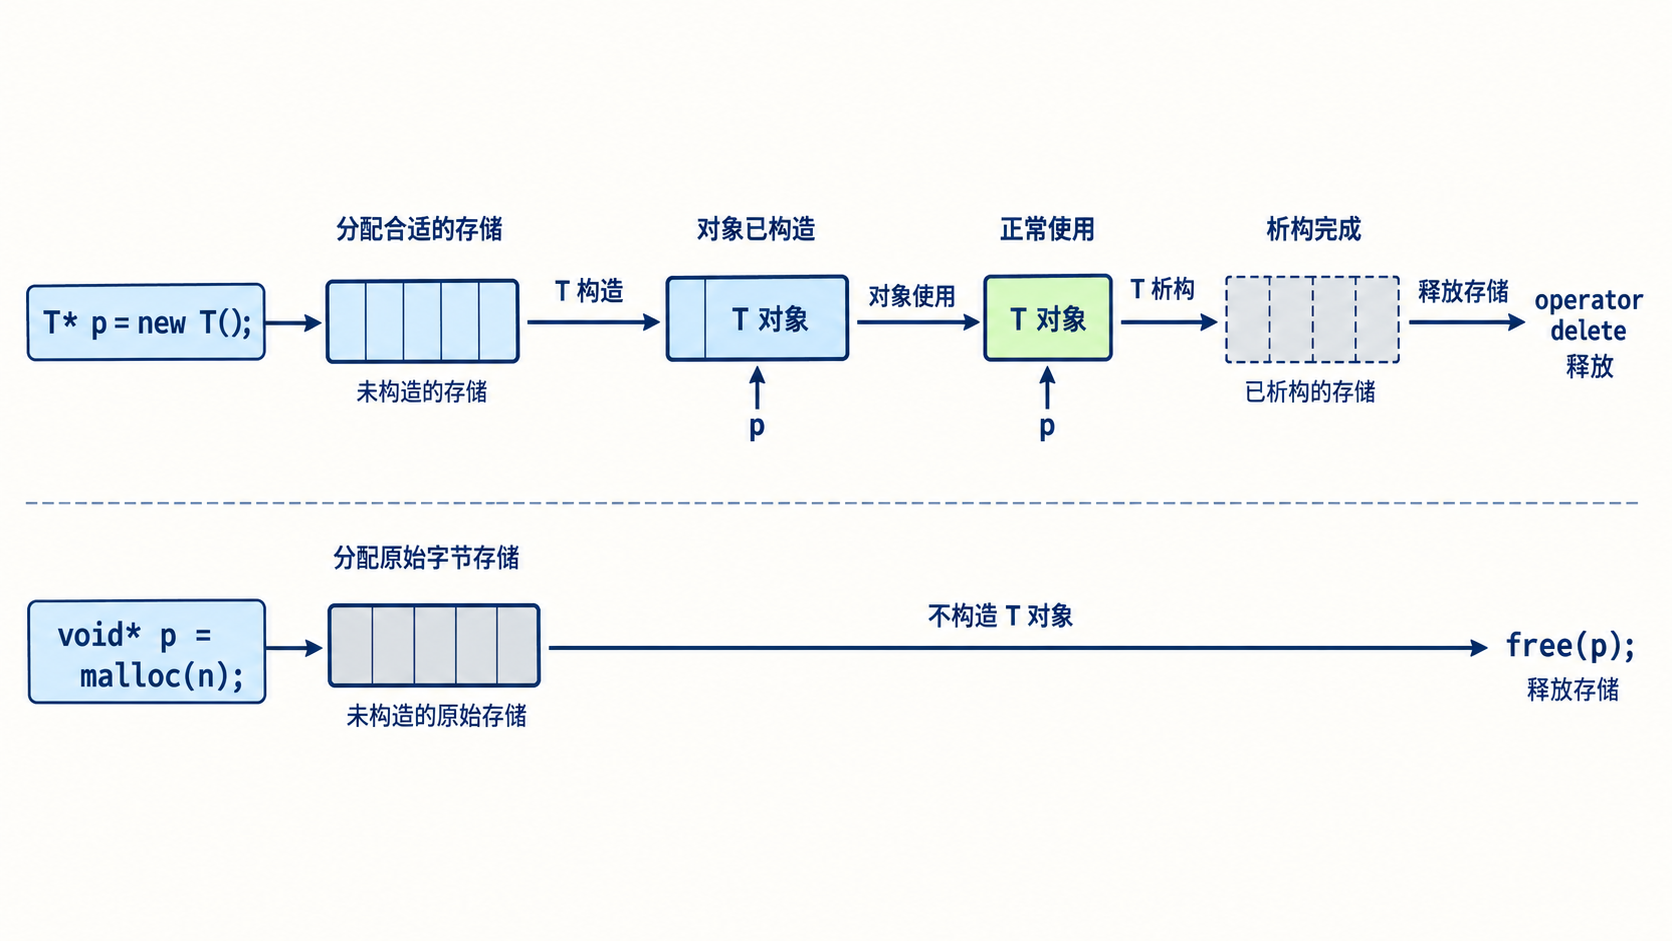
malloc 按字节申请原始存储,返回 void*,不调用构造函数;free 归还该存储,不调用析构函数。new T(args...) 同时取得适当存储并构造 T,返回带类型的指针;delete 先析构对象再释放匹配存储。普通 new 失败默认抛出 std::bad_alloc,malloc 失败返回空指针。
| 维度 | new/delete | malloc/free |
|---|---|---|
| 对象构造/析构 | 会 | 不会 |
| 返回类型 | T* | void* |
| 大小计算 | 由类型完成 | 调用者传字节数 |
| 失败方式 | 默认抛异常 | 返回 nullptr |
| 自定义机制 | operator new/delete | 分配器实现 |
二、选择与边界
现代 C++ 业务代码通常不应直接使用二者:优先容器、局部对象和 make_unique。malloc 适合 C 接口或特殊分配器,但若要在原始存储中创建对象,例如 C++17 中为非平凡类准备大小和对齐都合适的存储,再用 placement new 构造,最后显式析构并由原分配接口释放;C++20 才提供 std::construct_at。绝不能交叉配对。new (std::nothrow) 只把相应分配失败变成空指针,构造函数抛出的异常仍会传播,不能省略异常边界。参见new 表达式。
三、常见错误
malloc后把字节当成已经构造的非平凡对象。new得到的地址交给free,或malloc地址交给delete。- 认为
new就等于malloc + 构造的标准规定;底层分配机制可定制。 - 手写
new/delete,在异常路径遗漏释放。
回答自检
- 原始存储与对象生命周期的区别。
- 两套 API 的构造、类型和失败语义。
- 为什么不能混用释放函数。
- 为什么现代 C++ 优先 RAII 封装。
面试官可能追问的问题
operator new和 new 表达式一样吗? 前者只负责取得存储,new 表达式还构造对象。- 如何让 new 不抛异常? 使用
new (std::nothrow) T,失败返回空指针。 - 能否重载
operator new? 可以按类或全局定制,但必须遵守配对和异常规则。
8. 什么是内存泄漏?如何定位和预防?
问题分析
这道题考查能否把地址语义、对象生命周期与所有权转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:内存泄漏是程序失去释放某块动态存储的能力,或在应释放时长期保留它。
- 再讲机制:围绕“泄漏的本质 → 定位与预防”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:快手 C++ 后端一面
问题讲解
一、泄漏的本质
内存泄漏是程序失去释放某块动态存储的能力,或在应释放时长期保留它。进程退出时操作系统会回收虚拟地址空间,但长期服务在运行期间仍可能耗尽内存。RSS 增长也不一定都是泄漏,分配器缓存、文件页缓存和仍可达的业务缓存都要区分。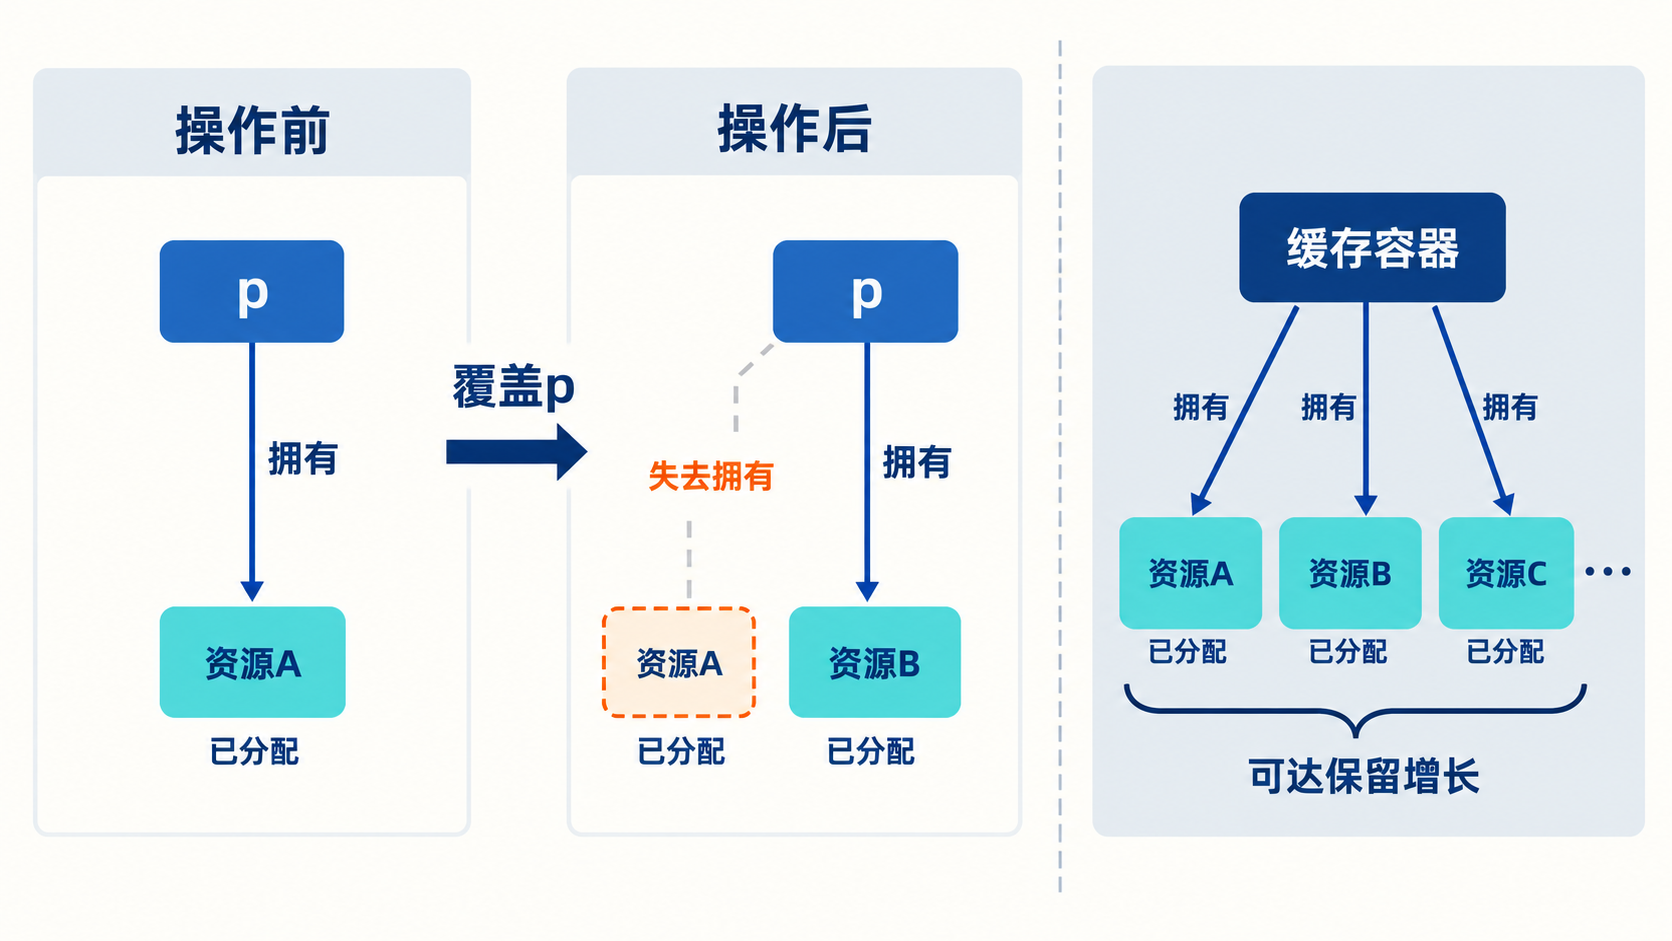
二、定位与预防
先观察增长是否可重复,再按请求、缓存或对象类型缩小范围。开发和测试可用 AddressSanitizer/LeakSanitizer,生产环境可采集堆剖析和对象计数。设计上优先值语义、容器、unique_ptr 和 RAII;共享所有权需审查环,缓存必须有容量或过期策略。
三、常见错误
- 认为进程退出会回收,所以服务中的泄漏可以忽略。
- 看到 RSS 不下降就断言泄漏;分配器可能保留空闲页。
- 用更多
shared_ptr“解决”泄漏,反而制造循环引用。 - 只修正常路径,忽略异常和提前返回。
回答自检
- 泄漏与一般内存增长的区别。
- 地址丢失和长期持有两类原因。
- RAII 为什么覆盖异常路径。
- 工具定位的基本流程。
- 共享所有权和缓存的特殊风险。
面试官可能追问的问题
- 可达内存会不会是逻辑泄漏? 会,例如无上限缓存仍持有对象。
- 循环引用如何处理? 明确拥有方向,把观察或反向边改为
weak_ptr。 - 泄漏和越界哪个更危险? 都严重;越界会立即破坏内存安全,泄漏会持续消耗资源。
9. 为什么 new[] 必须与 delete[] 配对?
问题分析
这道题考查能否从可观察现象追溯到地址语义、对象生命周期与所有权中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
new T[n]创建 n 个T对象,需要在释放时逐个调用析构函数,再用匹配的数组释放机制归还存储。 - 再讲机制:围绕“配对规则 → 更好的选择”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后台一面
问题讲解
一、配对规则
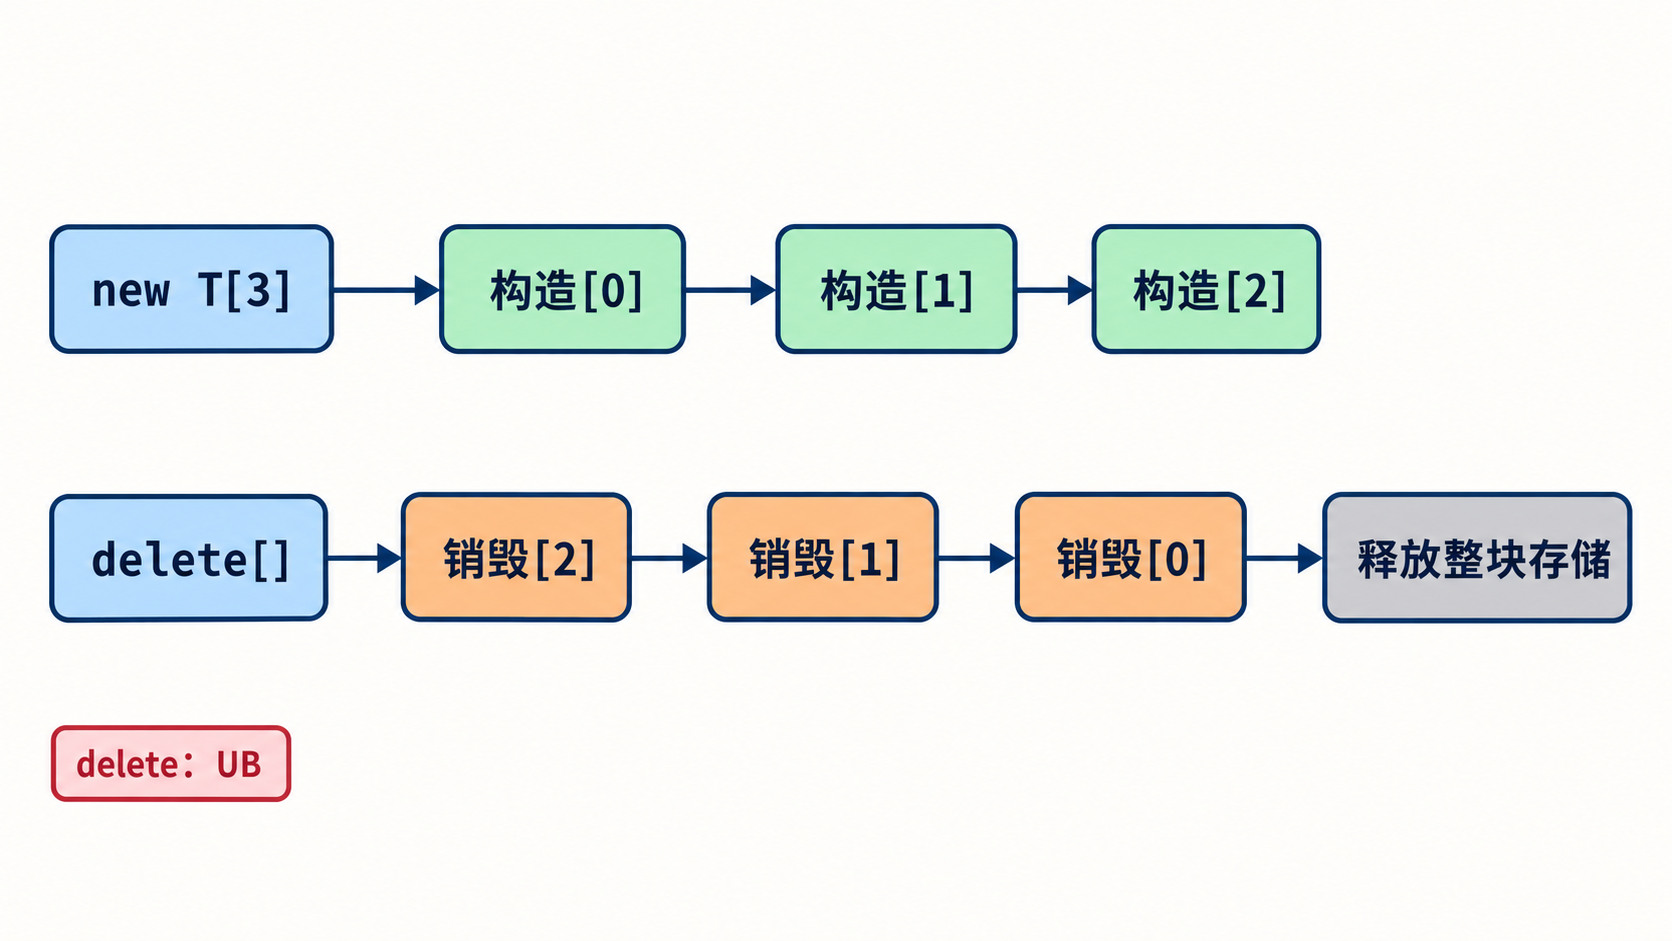
new T[n] 创建 n 个 T 对象,需要在释放时逐个调用析构函数,再用匹配的数组释放机制归还存储。delete[] p 表达这一语义;用普通 delete p 释放数组是未定义行为,即使 T 是 int、某次运行似乎正常也不合法。
实现可能在分配块附近保存元素数量等信息,但这种 cookie 的位置和存在都不是可依赖的标准接口。若数组构造中途抛异常,语言运行时会析构已经构造成功的元素并释放存储。
二、更好的选择
固定长度优先 std::array<T, N>,运行期长度优先 std::vector<T>;必须动态独占数组时可用 std::unique_ptr<T[]>,它会使用 delete[]。容器还能记录长度并提供迭代接口。
三、常见错误
- 用
delete释放new[],因为元素是平凡类型就认为安全。 - 忘记数组指针本身不记录可查询长度。
- 对数组中间元素的地址调用
delete[]。 - 使用
shared_ptr<T>管理数组却配置错误删除器;C++17 可使用数组特化但仍需谨慎。
回答自检
- 数组 new 创建的是多个对象。
- 为什么释放形式必须匹配。
- 数组元数据为何不能由用户依赖。
- 构造中途失败如何清理。
- 标准容器如何减少配对错误。
面试官可能追问的问题
delete[] nullptr是否安全? 是,不执行任何操作。- 析构顺序是什么? 数组元素按构造的逆序析构。
- 为什么推荐 vector? 它把长度、容量、构造和释放统一封装。
10. 栈、堆、静态存储区和线程局部存储分别保存什么?
问题分析
这道题考查能否用地址语义、对象生命周期与所有权解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:C++ 标准主要规定自动、静态、线程和动态存储期。
- 再讲机制:围绕“四类存储期 → 重要边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团基础架构一面
问题讲解
一、四类存储期
C++ 标准主要规定自动、静态、线程和动态存储期。局部非静态对象通常具有自动存储期,进入作用域构造、离开时析构,常由实现放在调用栈上;动态对象由 new 表达式创建,直到显式释放或所有者析构;全局、命名空间变量和静态局部对象具有静态存储期;thread_local 对象每个线程一份,在线程生命周期内存在。
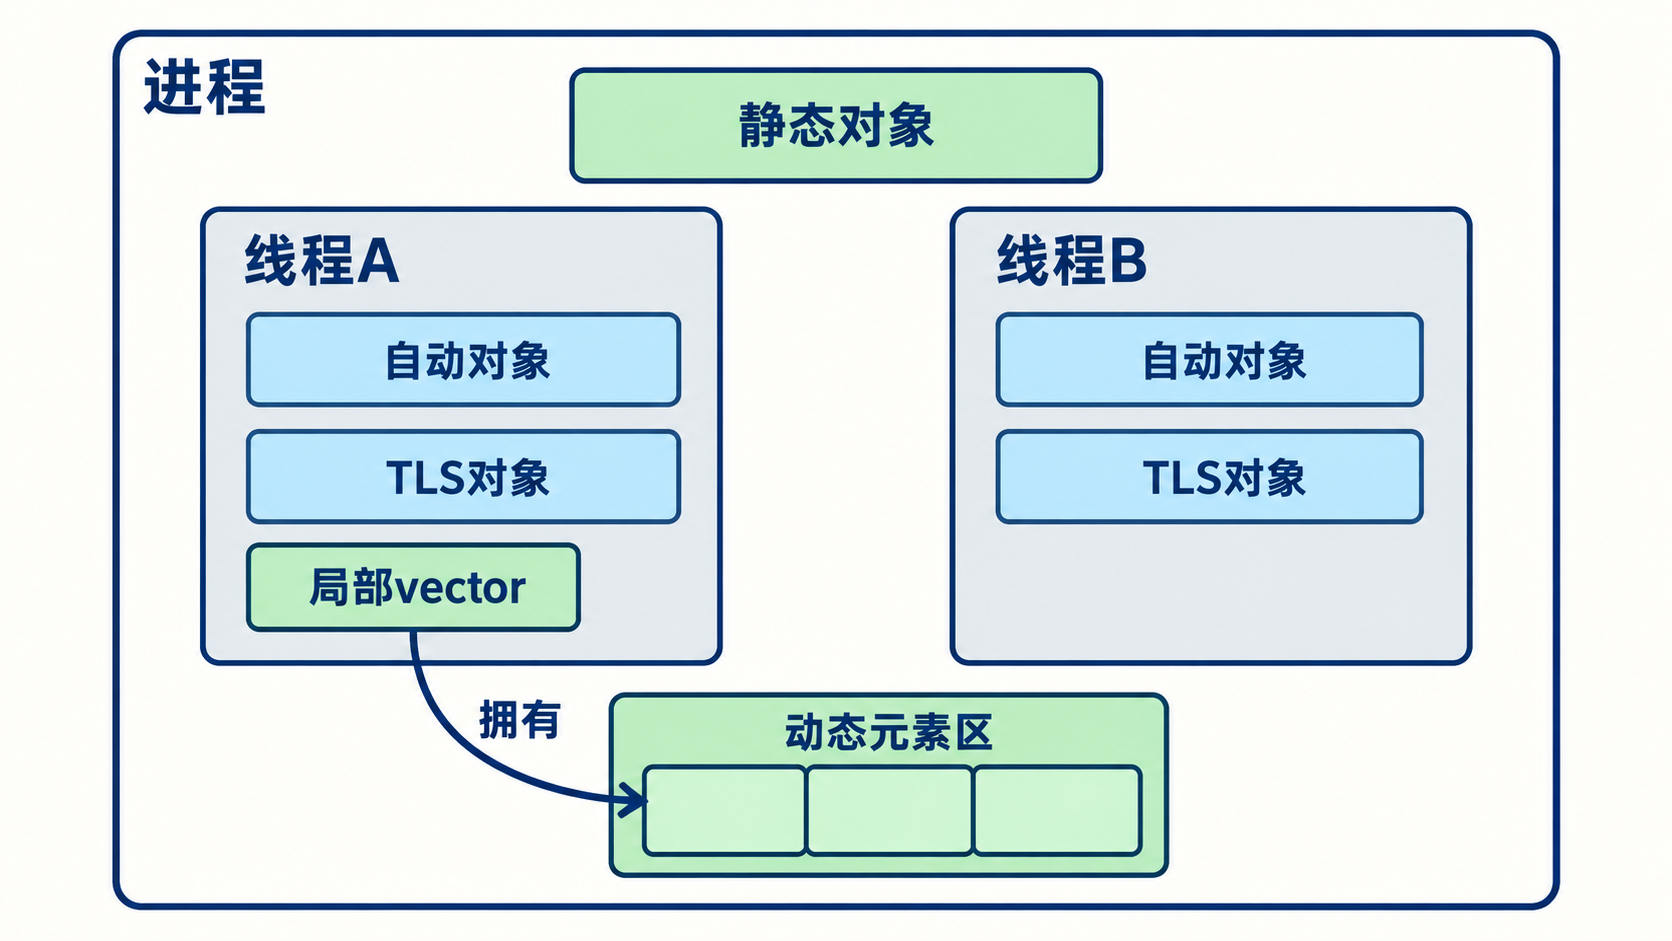
图为存储期语义关系,不规定对象必须采用某种栈、堆地址布局。
二、重要边界
“栈变量/堆变量”是常见实现说法,不等同语言的完整分类。对象本身和它管理的存储也可能不同:一个位于栈上的 vector 对象通常管理动态存储。静态局部变量从 C++11 起要求线程安全初始化,但其内容的后续并发访问仍需同步。
三、常见错误
- 认为
new创建的指针变量也在堆上;指针变量自身有自己的存储期。 - 认为堆对象一定比栈对象慢,而不分析分配和访问模式。
- 返回自动局部对象的引用。
- 认为
thread_local自动解决线程之间的数据合并和同步。
回答自检
- 四类存储期及其生命周期。
- 语言存储期与常见地址空间布局的区别。
- 对象和它管理的内存可能位于不同区域。
- 静态局部初始化的线程安全边界。
thread_local的每线程实例语义。
面试官可能追问的问题
- 静态局部对象何时初始化? 首次控制流经过声明时初始化,失败可在下次重试。
- 全局对象析构顺序可靠吗? 同一翻译单元有顺序,跨翻译单元初始化/析构依赖需谨慎。
vector放在哪里? vector 控制对象按声明位置存放,其元素通常在动态存储中。
11. C++ 中的内存池技术如何工作?
问题分析
这道题考查能否从可观察现象追溯到地址语义、对象生命周期与所有权中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:频繁申请和释放小对象时,通用分配器需要维护元数据、处理线程竞争,还可能造成碎片。
- 再讲机制:围绕“内存池解决什么问题? → 常见实现 → 一个可执行的固定块示例”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合地址语义、对象生命周期与所有权说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:阿里云 C++ 后端二面(编辑化整理)
问题讲解
一、内存池解决什么问题?
频繁申请和释放小对象时,通用分配器需要维护元数据、处理线程竞争,还可能造成碎片。内存池提前申请较大的内存块,再按固定大小或分级大小切出对象,释放时把槽位放回空闲链表。它优化的是分配路径和局部性,不会自动修复生命周期错误。
二、常见实现
| 类型 | 组织方式 | 适用场景 | 主要边界 |
|---|---|---|---|
| 固定块池 | 一个池只服务一种大小 | 高频同型小对象 | 大小不匹配会浪费空间 |
| 分级池 | 多个 size class | 尺寸分布较稳定 | 分类和内部碎片更复杂 |
| 单调资源 | 只增长,整体释放 | 临时图、请求批次 | 不能单独回收对象 |
| 线程本地池 | 每线程维护空闲链表 | 低竞争分配 | 跨线程释放要转交 |
| 对象存储与对象生命周期要分开看。池只提供原始存储,非平凡类型仍要在取得槽位后构造,在归还前显式析构。池的块销毁前必须保证没有悬空对象。 |
三、一个可执行的固定块示例
#include <cassert>
#include <cstddef>
#include <iostream>
#include <vector>

class IntPool {
 public:
  explicit IntPool(std::size_t count) : storage_(count), used_(count, false) {}

  int* acquire() {
    for (std::size_t i = 0; i < used_.size(); ++i) {
      if (!used_[i]) {
        used_[i] = true;
        return &storage_[i];
      }
    }
    return nullptr;
  }

  bool release(int* pointer) {
    if (pointer == nullptr) return false;
    for (std::size_t i = 0; i < storage_.size(); ++i) {
      if (pointer == &storage_[i]) {
        if (!used_[i]) return false;
        used_[i] = false;
        return true;
      }
    }
    return false;
  }

 private:
  std::vector<int> storage_;
  std::vector<bool> used_;
};

int main() {
  IntPool pool(2);
  int* first = pool.acquire();
  int* second = pool.acquire();
  assert(first != nullptr && second != nullptr);
  int* none = pool.acquire();
  assert(none == nullptr);
  *first = 10;
  if (!pool.release(first) || pool.release(first)) return 1;
  int foreign = 0;
  if (pool.release(&foreign)) return 1;
  int* reused = pool.acquire();
  assert(reused == first);
  std::cout << *reused << '\n';
  if (!pool.release(second) || !pool.release(reused)) return 1;
}
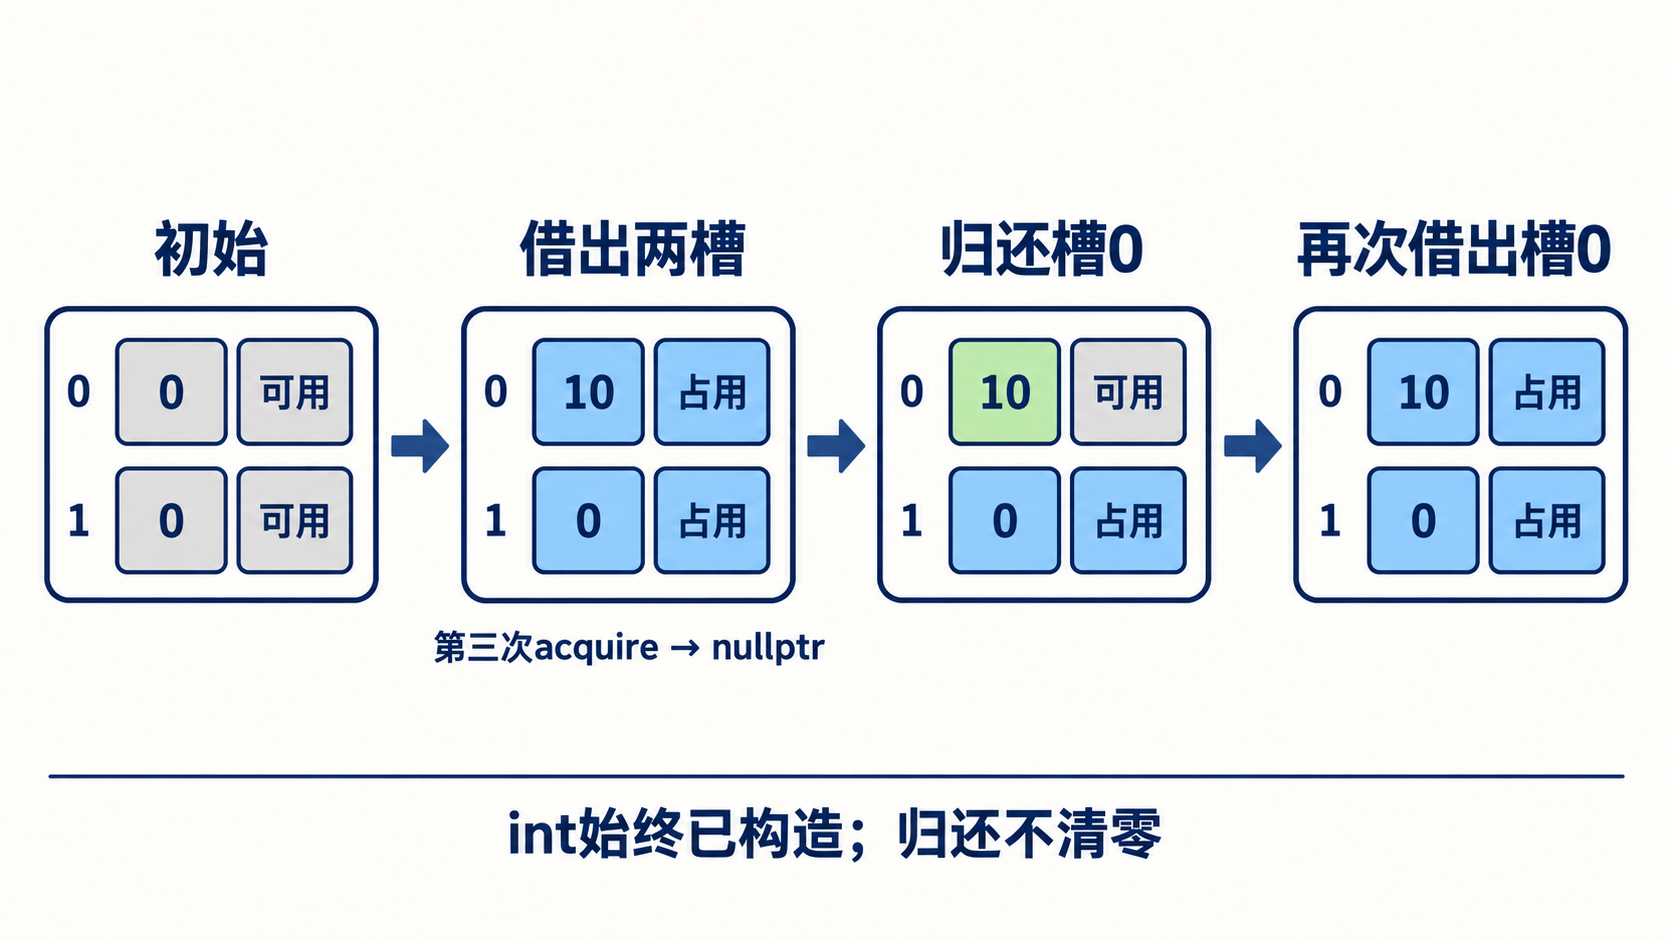
本例的两个 int 在 vector 创建时就已经存在,acquire/release 只切换占用状态,不重新构造、析构或清零。先借出两槽后第三次取得空指针,归还第一槽再取得时保留值 10。池从不改变底层 vector 大小,借用期间地址不会因扩容变化。地址检查不能识别“归还后槽位已被重新借出”的过期借用,应遵守借用协议;生产实现还需考虑代际标识、并发和跨线程释放。
四、常见错误
- 用池分配对象却忘记调用析构函数。
- 让池返回的地址在池销毁后继续使用。
- 把单线程空闲链表直接用于多线程环境。
- 只看单次分配耗时,不测量碎片、峰值内存和尾延迟。
回答自检
- 内存池优化的是哪一段成本。
- 原始存储与对象构造的区别。
- 固定块池、分级池和线程本地池的取舍。
- 为什么池的生命周期必须覆盖所有已分配对象。
面试官可能追问的问题
- 内存池一定比
new快吗? 不一定,必须结合尺寸分布、线程数和分配器实现测量。 - 如何处理不同大小对象? 使用 size class、对象分类池或回退到通用分配器。
- 池是否需要加锁? 共享池需要;线程本地池可减少锁,但跨线程释放要设计转移队列。



