
第九章 迭代器、算法与可调用对象
第九章 迭代器、算法与可调用对象
1. 迭代器有哪些类别?为什么算法会限制迭代器能力?
问题分析
这道题考查能否从可观察现象追溯到迭代器能力、算法契约与复杂度中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:C++17 经典类别包括输入、输出、前向、双向和随机访问迭代器;
- 再讲机制:围绕“能力层次”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后端一面
问题讲解
一、能力层次
C++17 经典类别包括输入、输出、前向、双向和随机访问迭代器;连续迭代器在 C++20 正式成为类别。前向迭代器可多趟遍历,双向增加 --,随机访问增加常数时间跳转、距离和比较。算法要求的是完成工作所需的最低能力,例如 sort 需要随机访问,而 find 只需输入迭代器。
二、常见错误
- 对 list 迭代器做
it + n。 - 认为所有
distance都是 O(1)。 - 混用不同容器的迭代器。
- 把迭代器能力类别与失效规则混为一谈。
回答自检
- 各类别逐级增加的能力。
- 算法为何选择最低要求。
- 能力、复杂度与底层容器的联系。
- 迭代器不必是裸指针。
面试官可能追问的问题
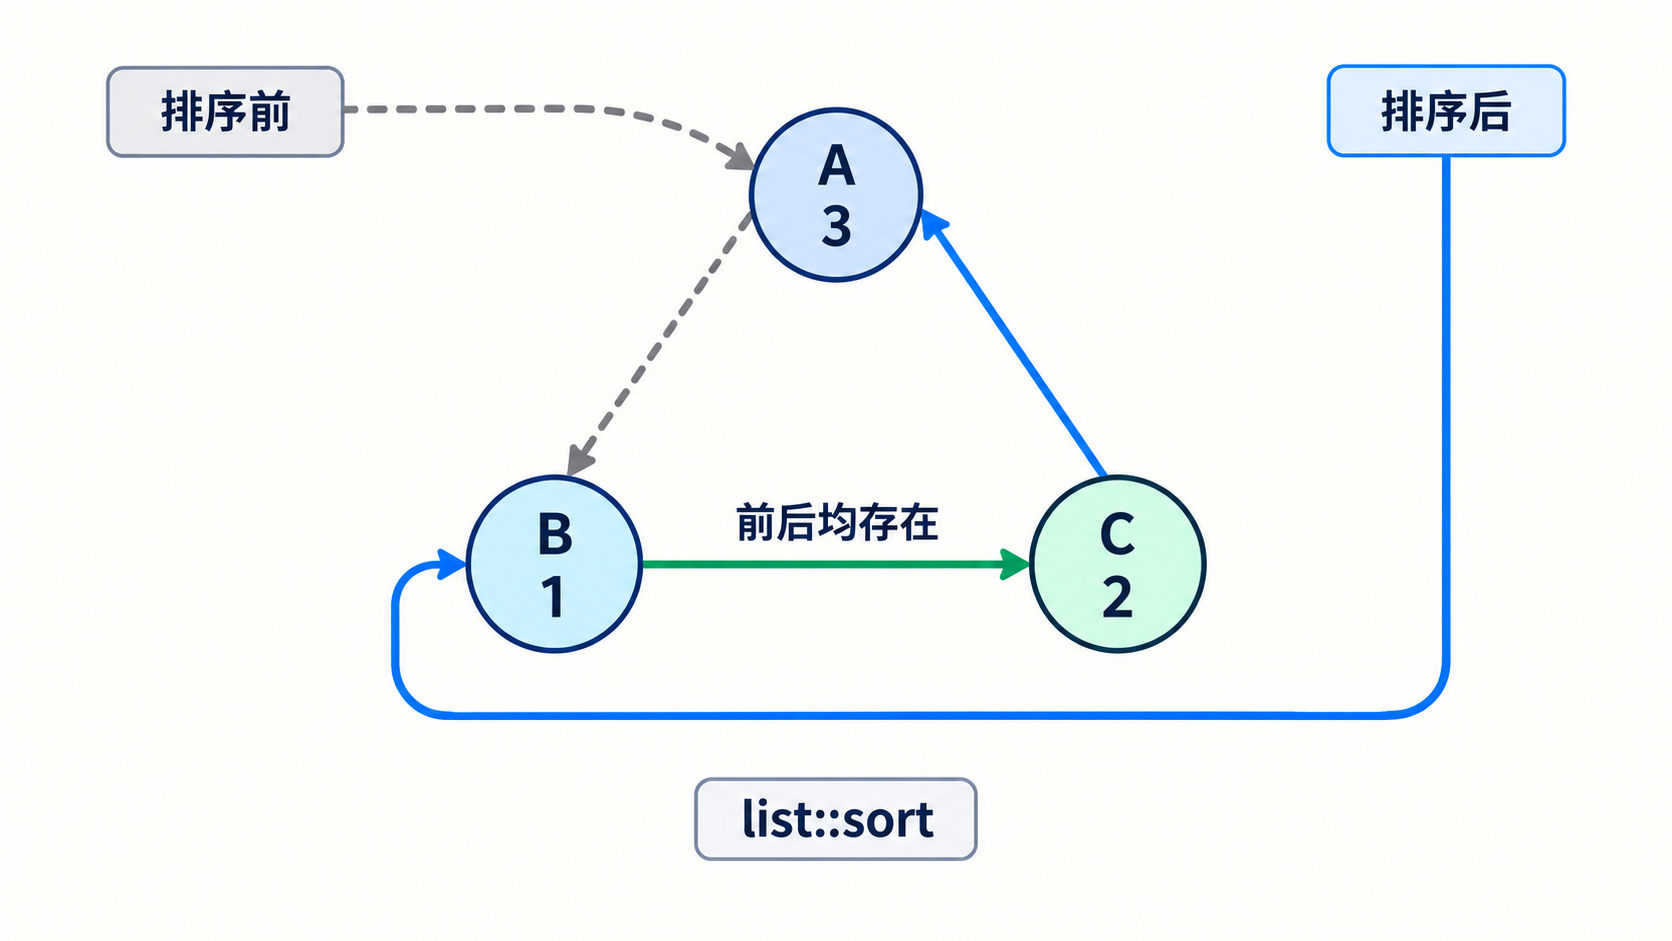
- 为什么 list 不能用 std::sort? 其迭代器不是随机访问,应使用成员
list::sort。 - 前向和输入迭代器差别? 前向迭代器支持多趟遍历和更稳定的值访问。
- 迭代器本质是指针吗? 指针可作为迭代器,但一般迭代器是满足操作契约的类型。
2. sort、stable_sort 和 list::sort 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从迭代器能力、算法契约与复杂度做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
std::sort需要随机访问迭代器,平均/最坏复杂度满足标准要求,不保证等价元素原顺序; - 再讲机制:围绕“三者对比”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
一、三者对比
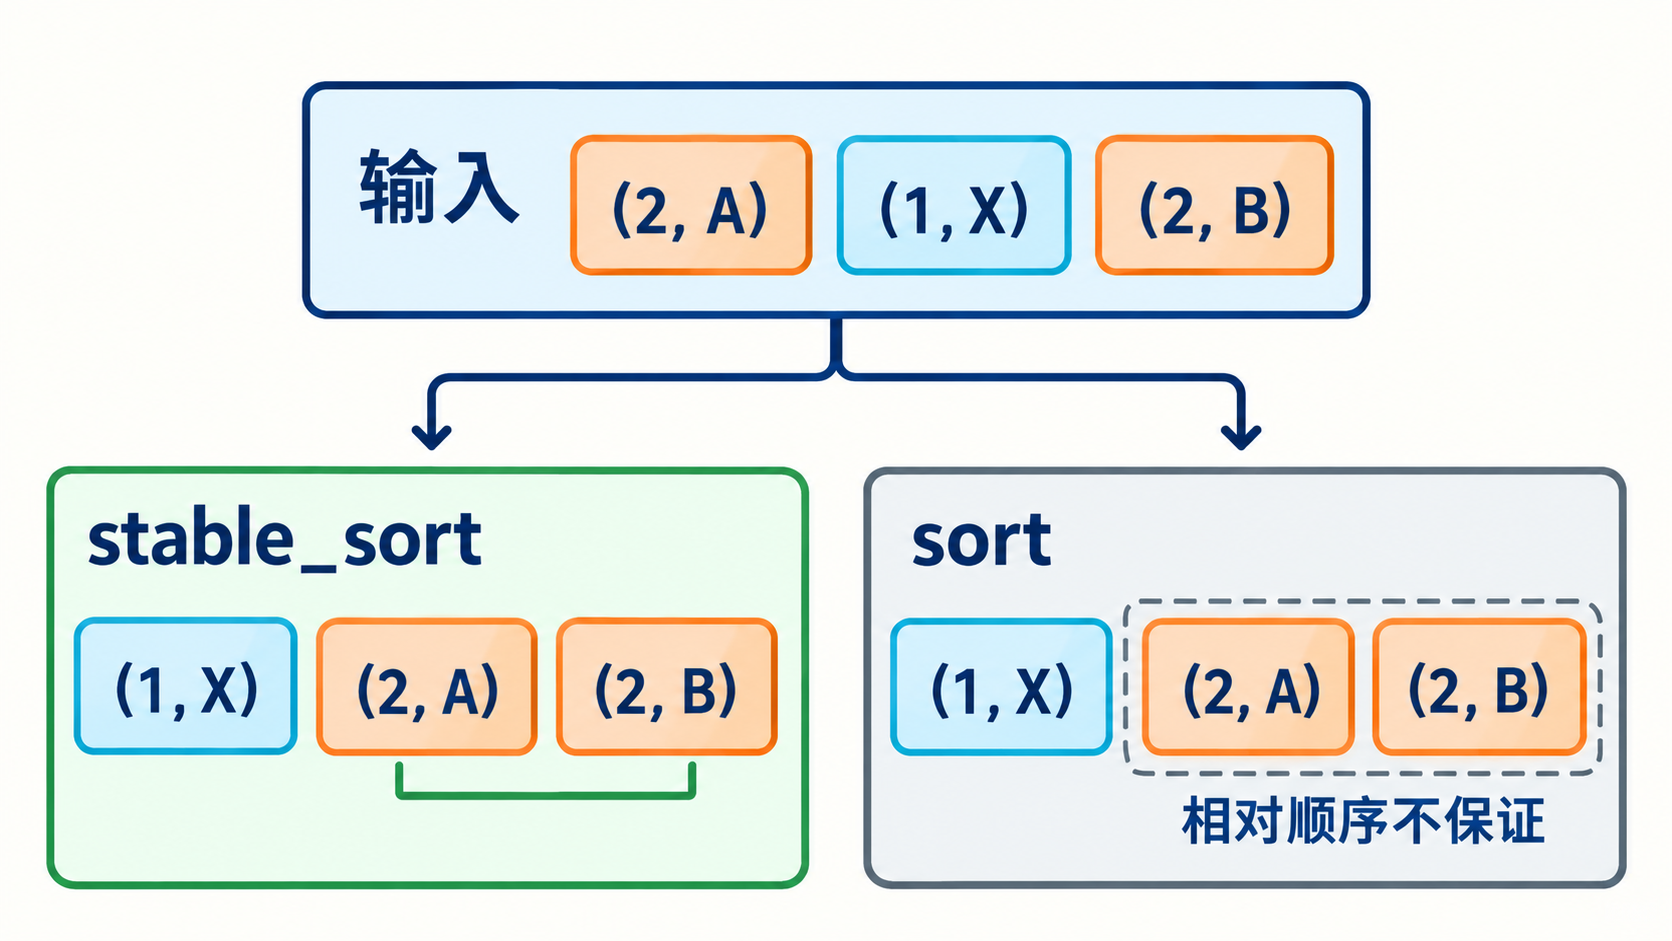
std::sort 需要随机访问迭代器,平均/最坏复杂度满足标准要求,不保证等价元素原顺序;stable_sort 保持等价元素相对顺序,通常需要额外缓冲;list::sort 通过重连节点排序,不要求随机访问,也不会搬移元素对象。
二、常见错误
- 把“稳定”理解为性能稳定。
- 对 list 调用
std::sort。 - 比较器不满足严格弱序。
- 认为 stable_sort 原地且零额外内存。
回答自检
- 稳定性的准确含义。
- 三个接口的迭代器要求。
- list 节点排序的特点。
- 比较器契约的重要性。
面试官可能追问的问题
- 何时需要稳定排序? 先按次要键排好,再按主要键排序且希望保留次要顺序时。
- vector 元素会移动吗? 排序会交换/移动元素,相关位置语义会改变。
- 降序怎么做? 使用满足严格弱序的
std::greater<>或比较器。
3. 关联容器的比较器必须满足什么性质?
问题分析
这道题考查能否用迭代器能力、算法契约与复杂度解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:比较器
comp(a,b)表示 a 严格排在 b 前,必须满足非自反、非对称、传递性,并使“既不小于彼此”的等价关系具有传递性。 - 再讲机制:围绕“严格弱序 → 边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构二面
问题讲解
一、严格弱序
比较器 comp(a,b) 表示 a 严格排在 b 前,必须满足非自反、非对称、传递性,并使“既不小于彼此”的等价关系具有传递性。容器认为 !comp(a,b) && !comp(b,a) 的键等价,不依赖 operator==。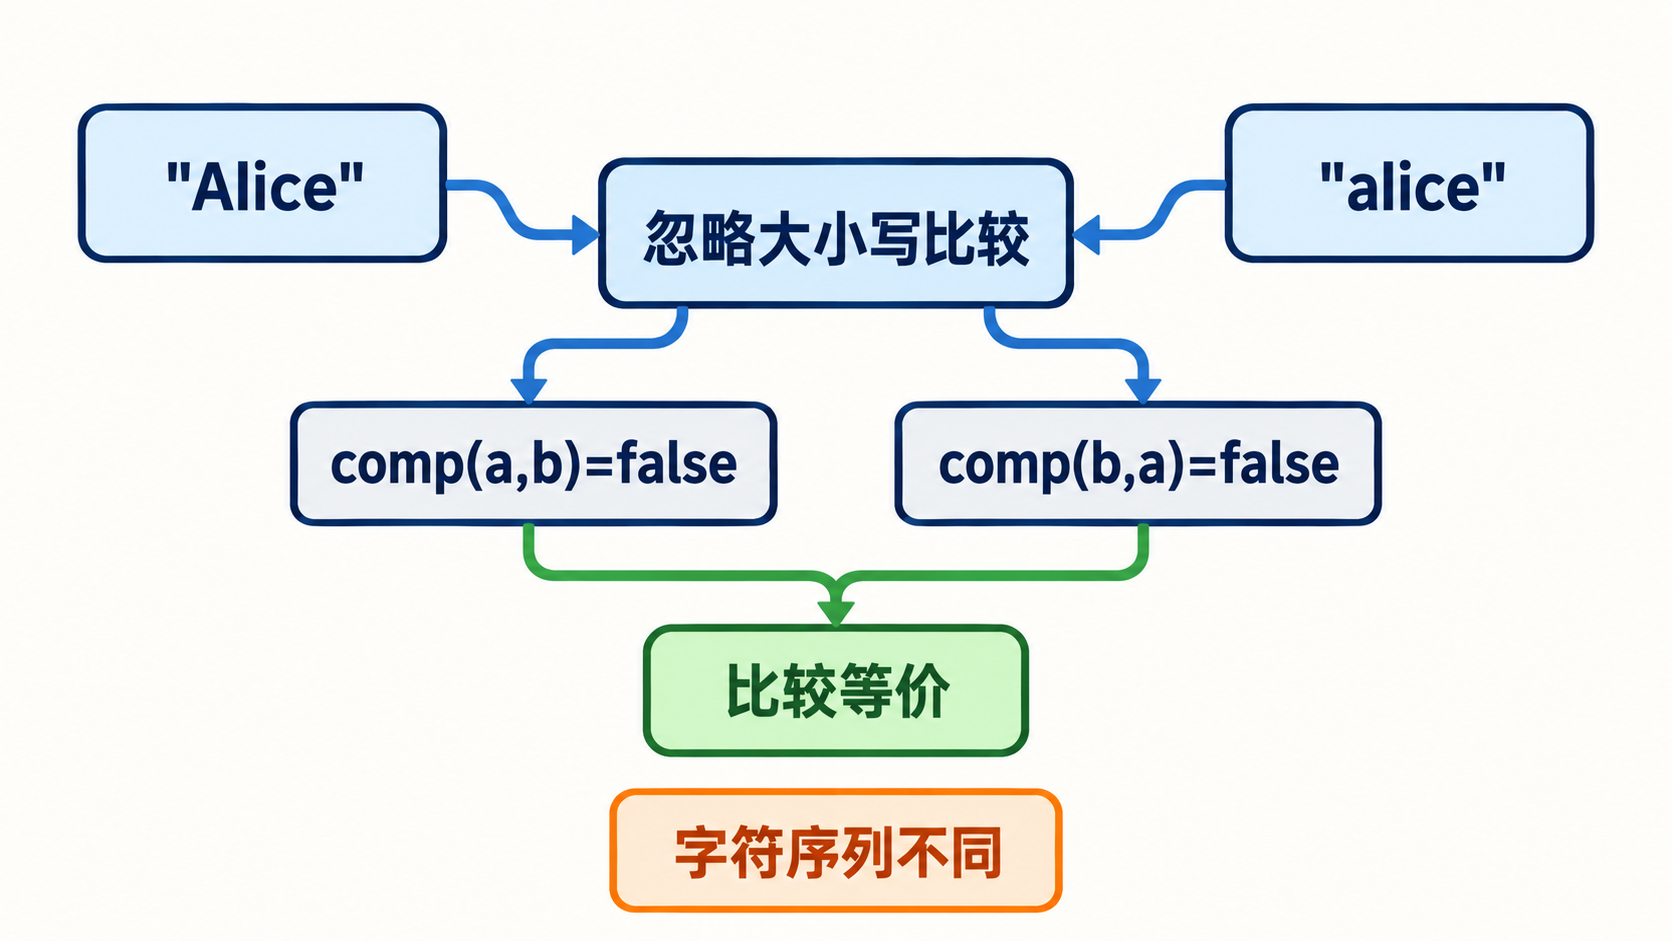
二、边界
使用 <= 往往破坏非自反性;比较器依赖会变化的外部状态,会让树结构与比较规则不一致。浮点 NaN 也会让朴素比较产生难以预期的等价类,应定义业务总序或避免作为键。
三、常见错误
- 比较器返回
a <= b。 - 容器存活期间修改比较器依赖状态。
- 比较可变字段后再偷偷修改键。
- 认为相等键必须
operator==为 true。
回答自检
- 非自反、非对称和传递性。
- 比较等价如何定义。
<=和可变外部状态的风险。- 比较器如何影响唯一键判定。
面试官可能追问的问题
- 为什么 sort 也要求严格弱序? 算法依赖一致排序关系,违反前提会产生未定义行为。
- 如何多字段排序? 使用
std::tie或逐字段比较,确保规则稳定。 - 大小写无关比较会怎样? 大小写不同字符串可能被容器视为等价键。
4. remove 为什么不会真正删除容器元素?
问题分析
这道题考查能否从可观察现象追溯到迭代器能力、算法契约与复杂度中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
std::remove只接收迭代器区间,不知道具体容器,无法调整 size。 - 再讲机制:围绕“两步删除”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度 C++ 一面
问题讲解
一、两步删除
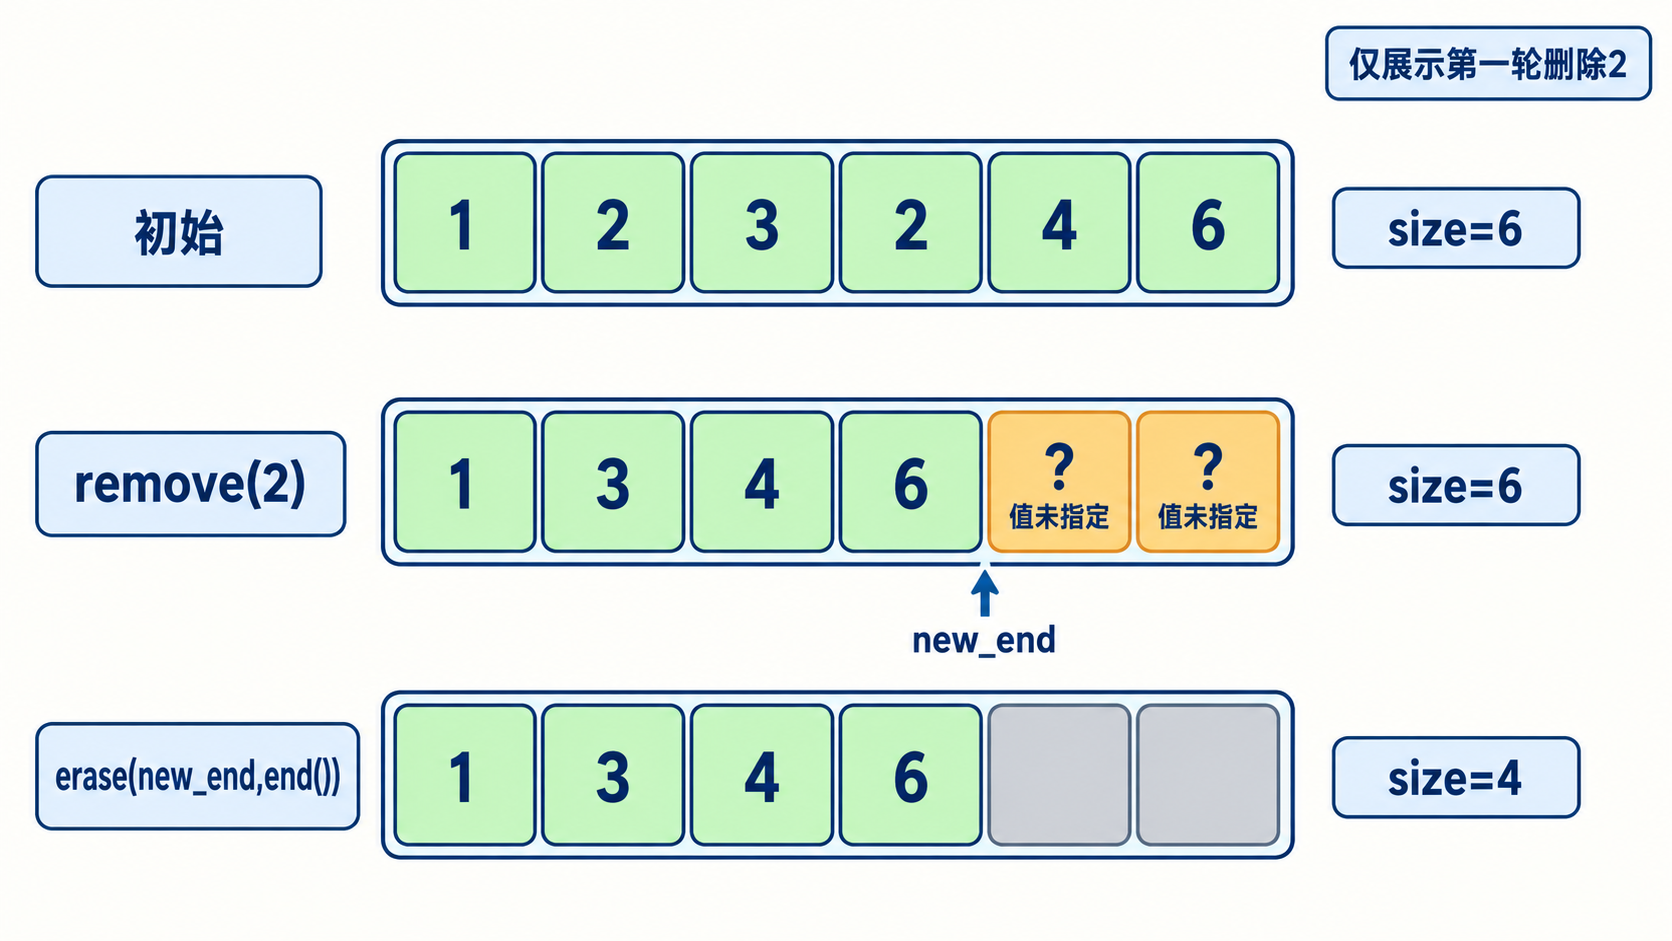
std::remove 只接收迭代器区间,不知道具体容器,无法调整 size。它把应保留元素移动到前部,并返回新的逻辑末尾;尾部仍是有效但值未指定的元素。再调用容器 erase(new_end, end()) 才真正缩短容器。
remove 结束后,容器仍保留原来的物理长度。新逻辑末尾把“有效元素”和“待擦除尾部”分开,只有 erase 才会改变容器的 size。
C++20 提供 std::erase/erase_if 简化常见容器删除,但本资料主线是 C++17。
二、完整可执行示例
必须保存 remove 返回的新逻辑末尾,再把尾部区间交给 erase。这个例子也展示按谓词删除的通用形式。
#include <algorithm>
#include <iostream>
#include <vector>

int main() {
    std::vector<int> values{1, 2, 3, 2, 4, 6};

    const auto new_end = std::remove(values.begin(), values.end(), 2);
    values.erase(new_end, values.end());

    values.erase(
        std::remove_if(values.begin(), values.end(),
                       [](int value) { return value % 2 == 0; }),
        values.end());

    for (int value : values) std::cout << value << ' ';
    std::cout << '\n';
}
三、常见错误
- 只调用 remove,发现 size 没变。
- 使用 remove 返回位置后的元素值。
- 对关联容器使用通用 remove;键不可被搬移赋值。
- erase 后继续使用已失效迭代器。
回答自检
- 算法与容器成员职责的分离。
- 新逻辑末尾的含义。
- erase-remove 的完整步骤。
- 关联容器为何使用自己的 erase。
面试官可能追问的问题
- remove_if 做什么? 按谓词把保留元素压到前部并返回逻辑末尾。
- list 如何删除? 可使用成员
remove/remove_if,直接重连节点。 - 为什么尾部值未指定? 算法通过移动赋值重排,尾部留下 moved-from 或重复内容。
5. find、lower_bound、upper_bound 和 binary_search 如何选择?
问题分析
这道题不只是让你罗列名词,而是考查能否从迭代器能力、算法契约与复杂度做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
find线性查找等于目标的首个元素,不要求有序。 - 再讲机制:围绕“接口语义”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节后端一面
问题讲解
一、接口语义
find 线性查找等于目标的首个元素,不要求有序。对按同一比较器排序的区间,lower_bound 返回第一个“不小于”目标的位置,upper_bound 返回第一个“大于”目标的位置;二者组成等价范围。binary_search 只回答是否存在,不返回位置。
对 map/set 应优先使用成员查找,树能提供 O(log n);通用算法只看到迭代器,可能线性移动。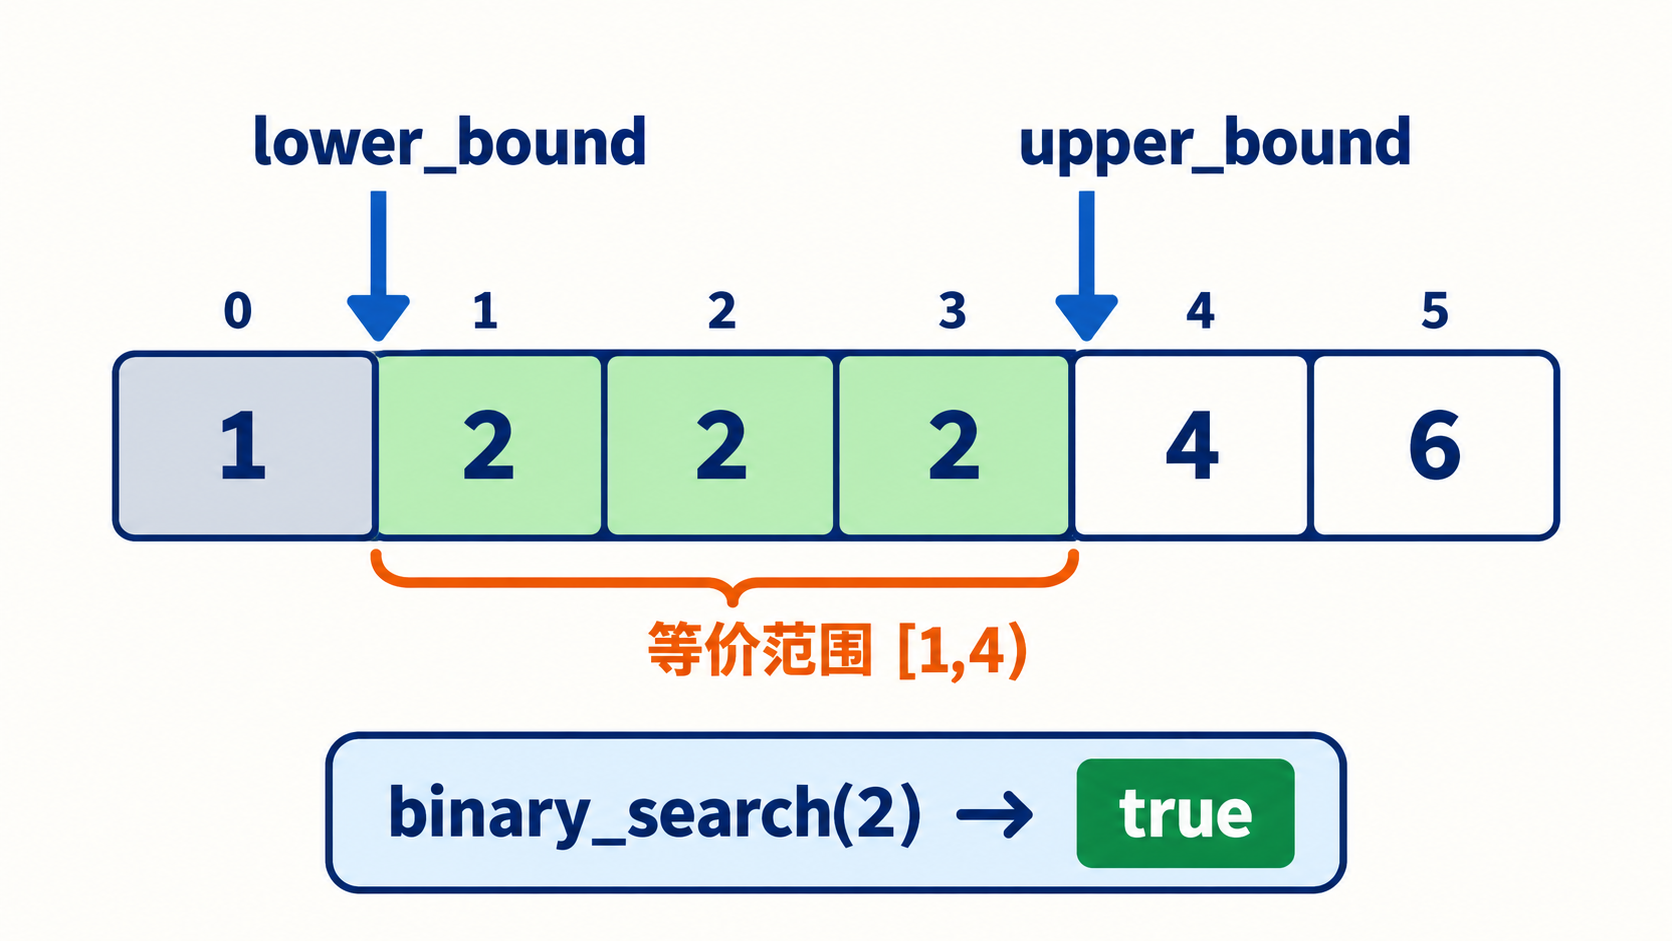
二、常见错误
- 对未排序区间二分。
- 排序和查找使用不一致比较器。
- 用 binary_search 后再做一次 lower_bound 获取位置。
- 对 map 用通用 find 导致线性查找。
回答自检
- 线性查找和二分前提。
- 两个边界的半开区间语义。
- 存在性与位置返回的区别。
- 关联容器成员算法的优势。
面试官可能追问的问题
- 如何统计等价元素个数?
distance(lower_bound, upper_bound),随机访问区间为常数距离计算。 - lower_bound 可作插入位置吗? 是,可保持有序,但 vector 插入仍需搬移。
- 降序区间能二分吗? 可以,必须传相同降序比较器。
6. std::function 的类型擦除解决了什么问题?有什么成本?
问题分析
这道题考查能否用迭代器能力、算法契约与复杂度解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:函数指针只能保存固定签名的普通函数;
- 再讲机制:围绕“
function、bind、Lambda 和回调的关系 → 类型擦除”说明规则如何生效,把关键对象、时机或状态变化串起来。 - 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团客户端二面
问题讲解
补充:function、bind、Lambda 和回调的关系
函数指针只能保存固定签名的普通函数;Lambda 和仿函数各自有独特的闭包类型;std::bind 可以把部分参数预先绑定,但返回类型仍然是实现生成的可调用对象。std::function 做类型擦除,把这些可调用对象放进统一的运行期接口,适合事件表和需要保存、替换回调的边界。热循环若不需要类型擦除,模板参数通常更容易内联。
一、类型擦除
函数指针、Lambda、仿函数和绑定表达式类型各不相同。std::function<R(Args...)> 抹去具体类型,统一提供复制、存储和调用接口,适合事件表、可替换策略和跨非模板边界保存回调。
常见实现对小型可调用对象使用小对象优化,较大对象可能堆分配,但阈值不由标准保证。std::function 在 C++17 要求目标可复制,不能直接保存只可移动 Lambda。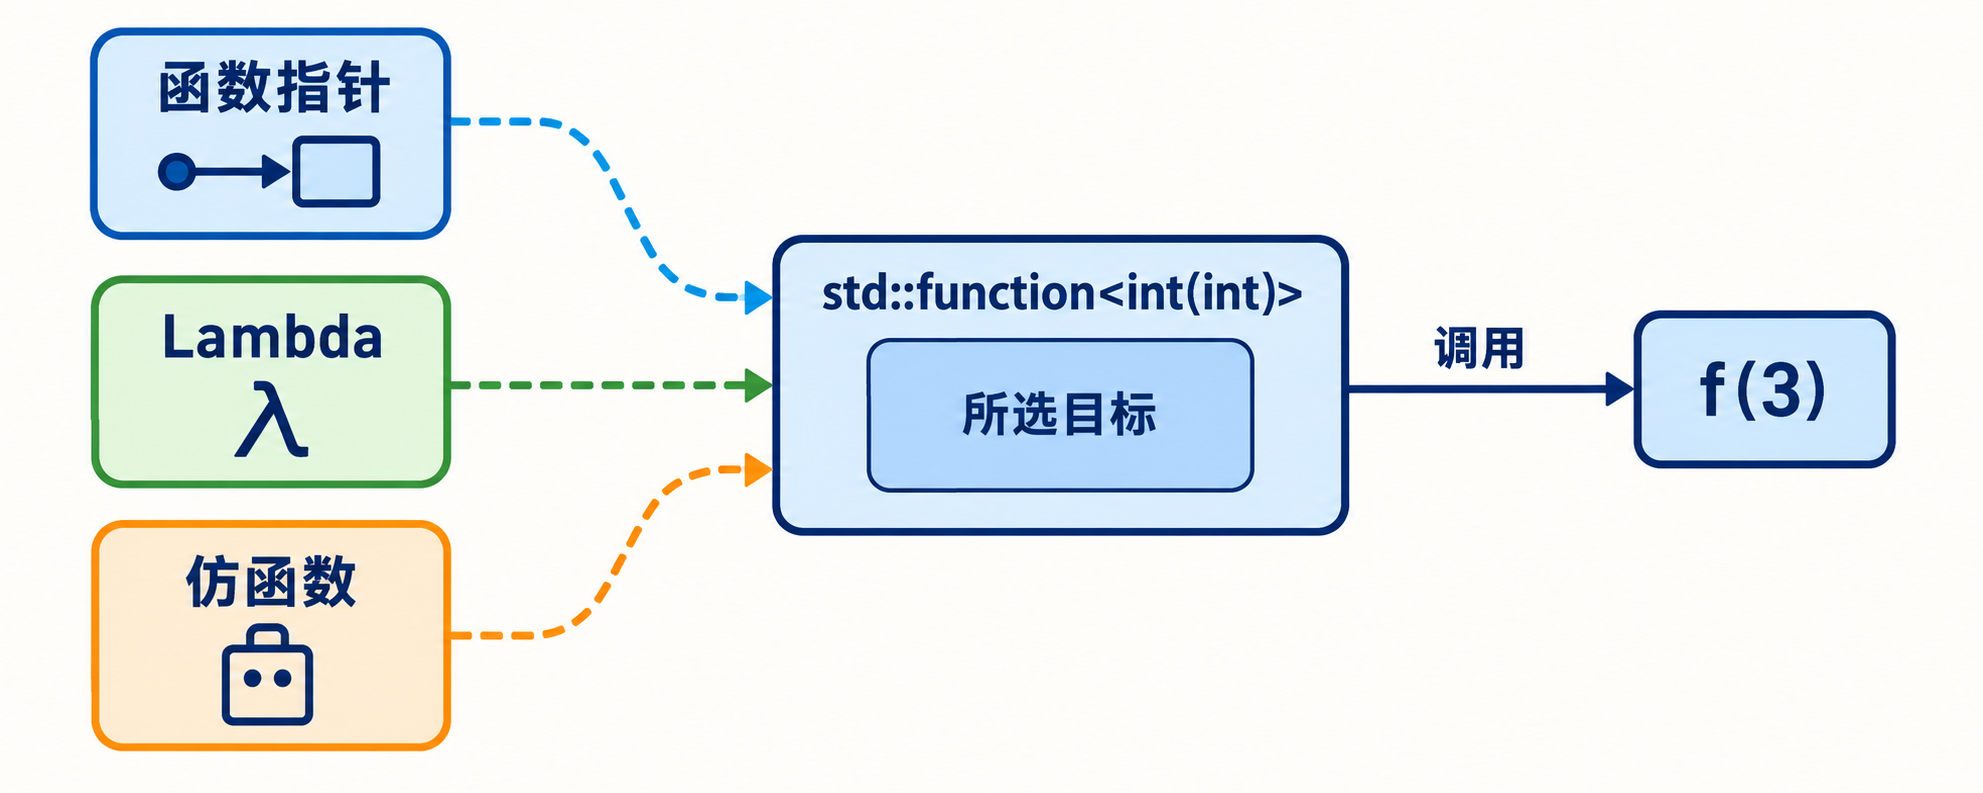
二、常见错误
- 热循环所有回调都用 std::function,不测量成本。
- 调用空 function,触发
bad_function_call。 - Lambda 捕获引用悬空,与类型擦除无关。
- 依赖小对象优化阈值。
回答自检
- 异构可调用对象为何需要统一包装。
- 类型擦除带来的 ABI/接口收益。
- 间接调用、复制和分配成本。
- 生命周期风险仍由捕获语义决定。
面试官可能追问的问题
- 模板参数回调有何优势? 保留具体类型,便于内联且可能无分配。
- 函数指针何时足够? 无捕获、接口简单且只需普通函数入口时。
- 如何检查是否为空? 在调用前使用布尔转换。
7. Lambda 的闭包类型和捕获生命周期如何理解?
问题分析
这道题考查能否把迭代器能力、算法契约与复杂度转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:每个 Lambda 表达式产生唯一、未命名闭包类型;
- 再讲机制:围绕“闭包对象”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯客户端一面
问题讲解
一、闭包对象
每个 Lambda 表达式产生唯一、未命名闭包类型;执行表达式得到闭包对象。按值捕获通常把值存为闭包成员,默认 operator() 为 const;mutable 允许修改闭包内副本。按引用捕获保存引用语义,外部对象必须活到每次调用结束。
捕获 this 只保存指针,不延长对象寿命;异步场景可按值捕获必要数据,或捕获 weak_ptr 并在执行时 lock()。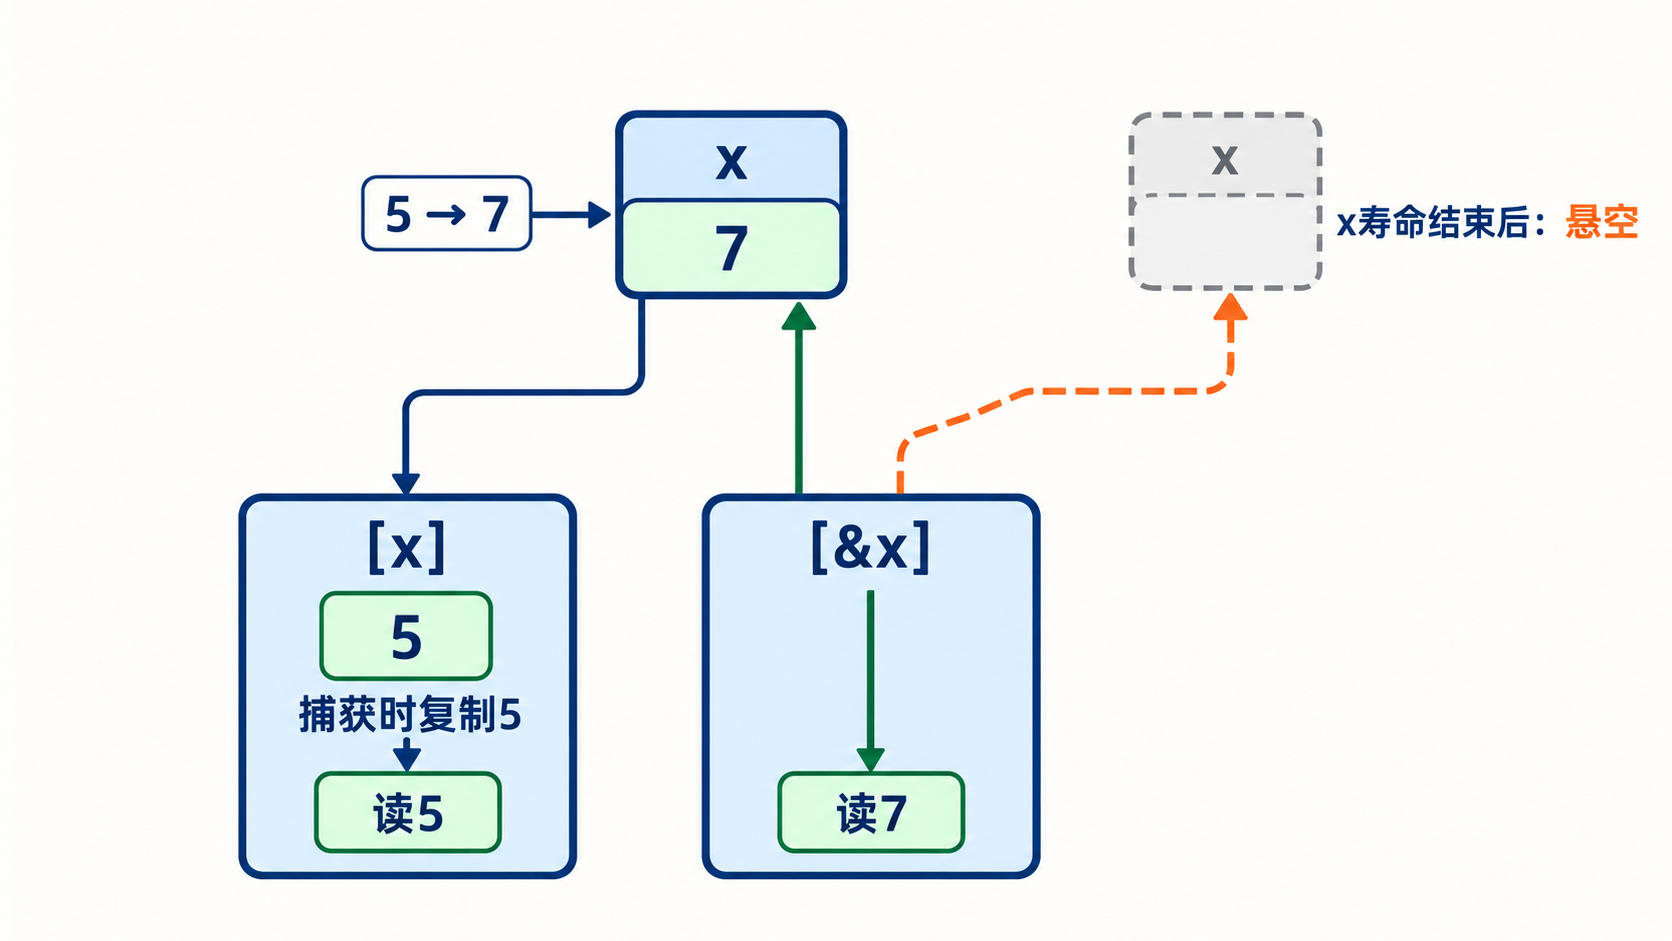
二、常见错误
- 返回按引用捕获局部变量的 Lambda。
- 异步任务隐式
[=]捕获 this 后误以为复制整个对象。 - 用 mutable 认为能修改原外部变量。
- 假设不同位置文本相同的 Lambda 类型相同。
回答自检
- 表达式、闭包类型和闭包对象的关系。
- 值捕获与引用捕获的存储和寿命。
- mutable 修改的是闭包副本。
- 异步捕获 this 的处理方案。
面试官可能追问的问题
- 无捕获 Lambda 能转函数指针吗? 可以转换为匹配签名的函数指针。
- init-capture 有什么用? C++14 可移动对象进闭包,如
[p = std::move(p)]。 - 引用捕获一定危险吗? 同步且闭包不逃逸作用域时很合适。
8. optional、variant 和 any 如何选择?
问题分析
这道题不只是让你罗列名词,而是考查能否从迭代器能力、算法契约与复杂度做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
optional<T>表示“有一个 T 或没有值”; - 再讲机制:围绕“三种模型”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度后端一面
问题讲解
一、三种模型
optional<T> 表示“有一个 T 或没有值”;variant<Ts...> 正常时保存封闭集合中的一种类型,异常情况下可能无值;any 可保存满足可复制等要求的类型,运行期用 any_cast 取出,适合开放扩展但约束最弱。
variant 用 visit 处理各分支,使编译器帮助覆盖类型;any 缺少统一操作契约,频繁 any_cast 往往说明应设计清晰接口。
二、常见错误
- optional 用空字符串或 -1 同时表达缺失。
- 未检查 optional 就
value()。 - variant 用错误索引硬编码分支。
- any 作为全局万能数据袋,失去类型约束。
回答自检
- 三种工具对应的数据模型。
- variant 的封闭集合优势。
- any 的开放性和类型安全成本。
- optional 与错误结果类型的区别。
面试官可能追问的问题
- optional 能否表示错误原因? 不能,只表示有/无;需要原因用 Result/expected 风格。
- variant 是否可能无值? 异常情况下可能
valueless_by_exception。 - any_cast 失败怎样? 值形式抛
bad_any_cast,指针形式返回空。
9. pair、tuple 和结构化绑定如何配合使用?
问题分析
这道题考查能否把迭代器能力、算法契约与复杂度转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
pair<T,U>保存两个值,常用于键值和算法返回; - 再讲机制:围绕“用途”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:小米 C++ 一面
问题讲解
一、用途
pair<T,U> 保存两个值,常用于键值和算法返回;tuple<Ts...> 保存固定数量异构值;C++17 结构化绑定把数组、pair/tuple 或适配的类拆成具名变量,提高读取清晰度。
auto [a,b] = value 通常创建绑定对象的副本;auto& [a,b] 才绑定原对象。长期公共接口返回很多 tuple 字段会失去语义,具名 struct 更适合演进。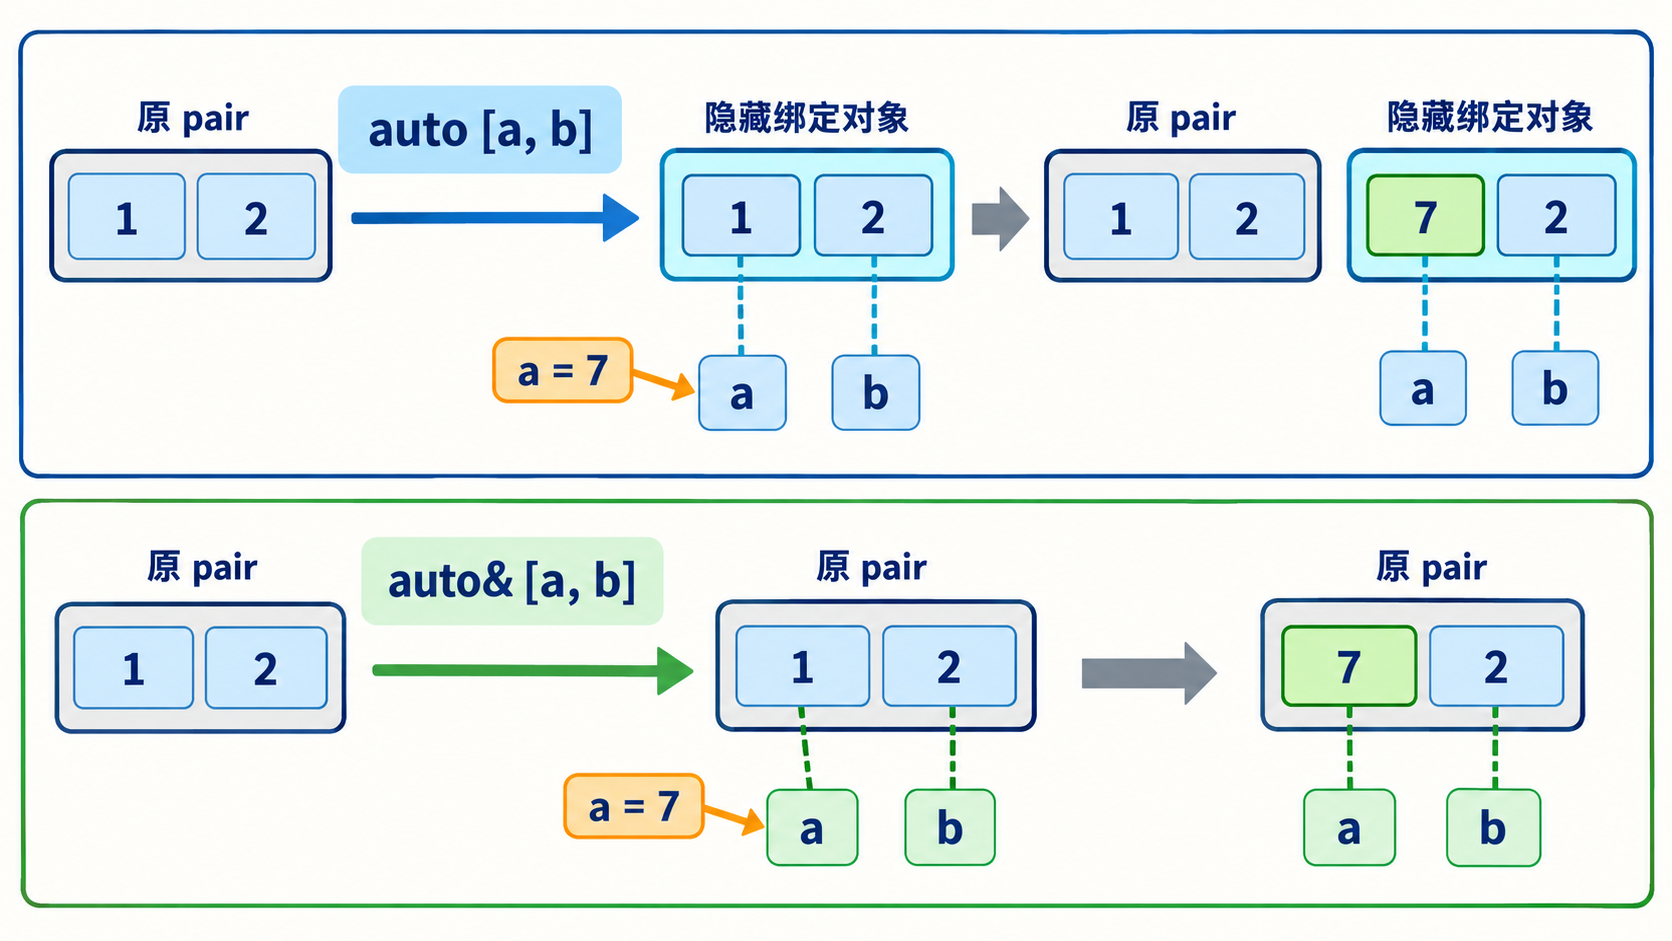
二、常见错误
- 忘记结构化绑定默认可能复制。
- 用
get<0>铺满业务代码,字段意义不清。 - 返回引用 tuple 指向局部对象。
- 修改 map 遍历中的结构化绑定键;键是 const。
回答自检
- pair、tuple、struct 的选择。
- 结构化绑定的值与引用形式。
- 公共接口为什么偏向具名结果类型。
- 与关联容器遍历的配合。
面试官可能追问的问题
- 如何忽略某字段? 可绑定后不使用,或 tie 赋值时用
std::ignore。 - 结构化绑定变量生命周期? 取决于其隐藏绑定对象和引用形式。
- map 遍历怎么写?
for (const auto& [key, value] : map)。
10. 如何使用 transform、accumulate 和 for_each 组织数据处理?
问题分析
这道题考查能否把迭代器能力、算法契约与复杂度转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
transform把输入元素映射为输出序列; - 再讲机制:围绕“三种意图”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团 C++ 后端一面
问题讲解
一、三种意图
transform 把输入元素映射为输出序列;accumulate 按顺序把序列归约为一个结果;for_each 对每个元素执行操作,通常用于不可避免的副作用。选择命名算法能直接表达意图,但复杂状态机用普通循环可能更清晰。
accumulate 的初值决定结果类型,例如对 double 序列使用整数 0 可能每步截断,应写 0.0。归约操作若有副作用或不满足结合性,不适合随意改为并行算法。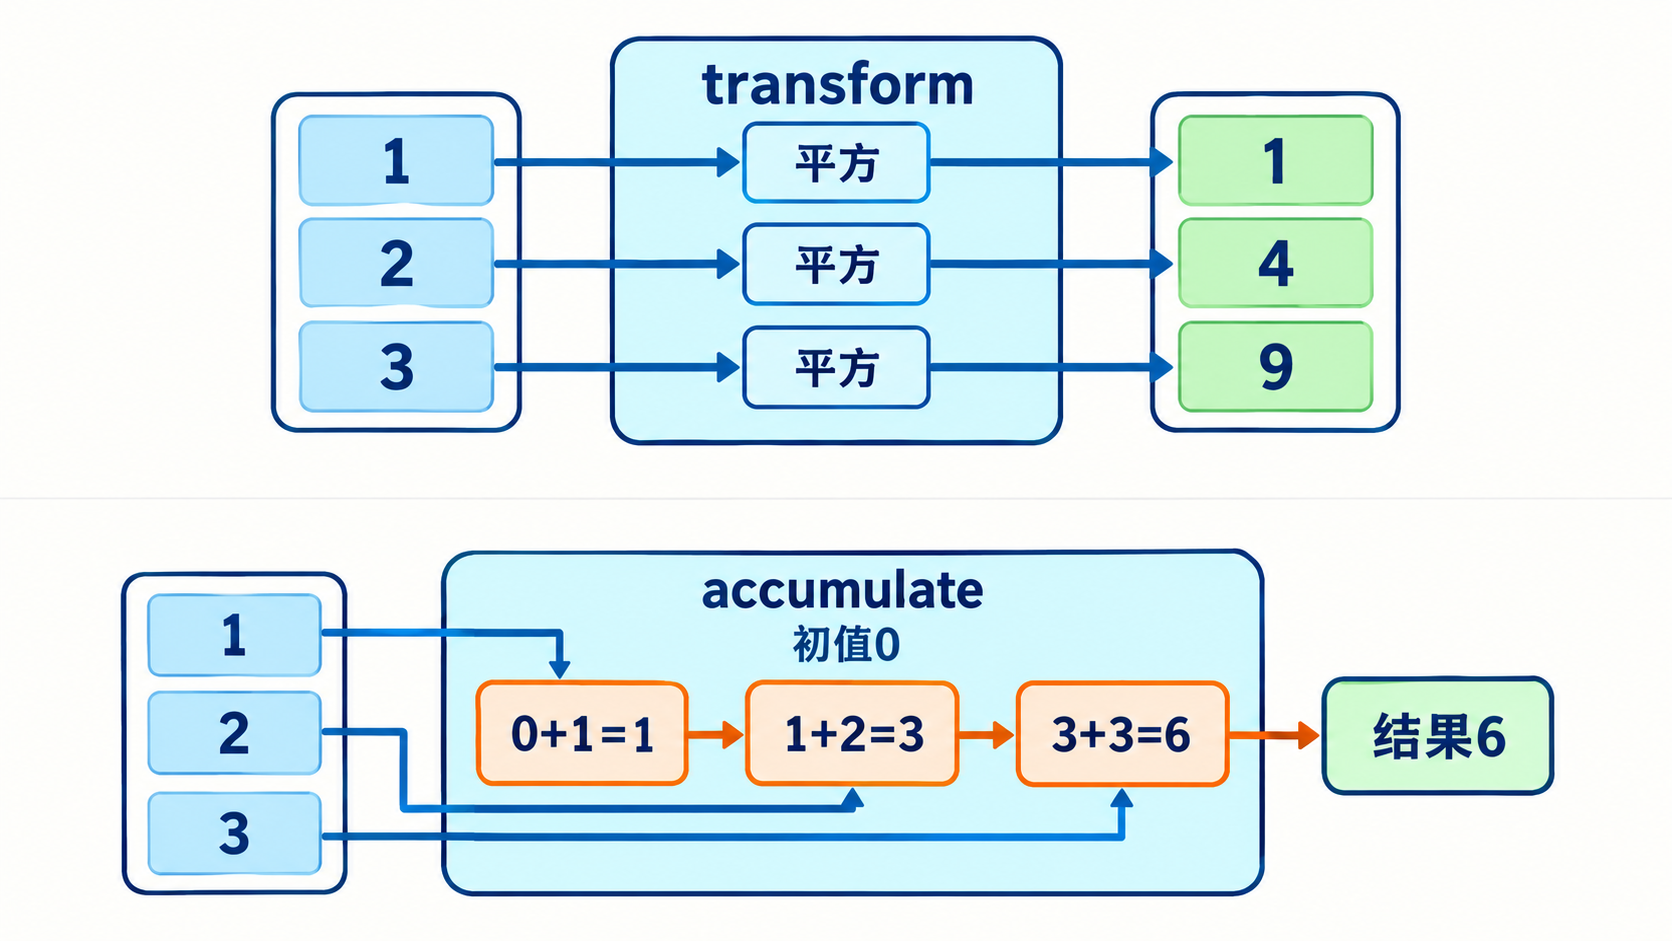
二、常见错误
- transform 输出容器未 resize,也未用 back_inserter。
- accumulate 初值类型错误。
- 在算法 Lambda 中隐藏复杂共享状态。
- 为追求“函数式”把清晰循环拆得难以调试。
回答自检
- 映射、归约和副作用的差异。
- 输出迭代器和容量要求。
- 初值如何决定归约类型。
- 算法与普通循环的可读性权衡。
面试官可能追问的问题
- transform 能原地吗? 一元 transform 可让输出起点等于输入起点,但仍需满足重叠规则。
- accumulate 与 reduce 区别? reduce 可重排结合顺序并支持并行策略,对操作性质要求更高。
- 什么时候用普通循环? 需要 break/continue、多状态控制或错误处理时通常更清楚。
11. C++20 Ranges 是什么?如何组合视图和算法?
问题分析
这道题考查能否把迭代器能力、算法契约与复杂度转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:传统算法需要把
begin和end分开传入,多个算法串联时容易产生临时容器和迭代器样板。 - 再讲机制:围绕“Ranges 解决什么问题? → C++20 示例 → 边界与选择”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合迭代器能力、算法契约与复杂度说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:微软 C++ 开发一面(编辑化整理)
问题讲解
一、Ranges 解决什么问题?
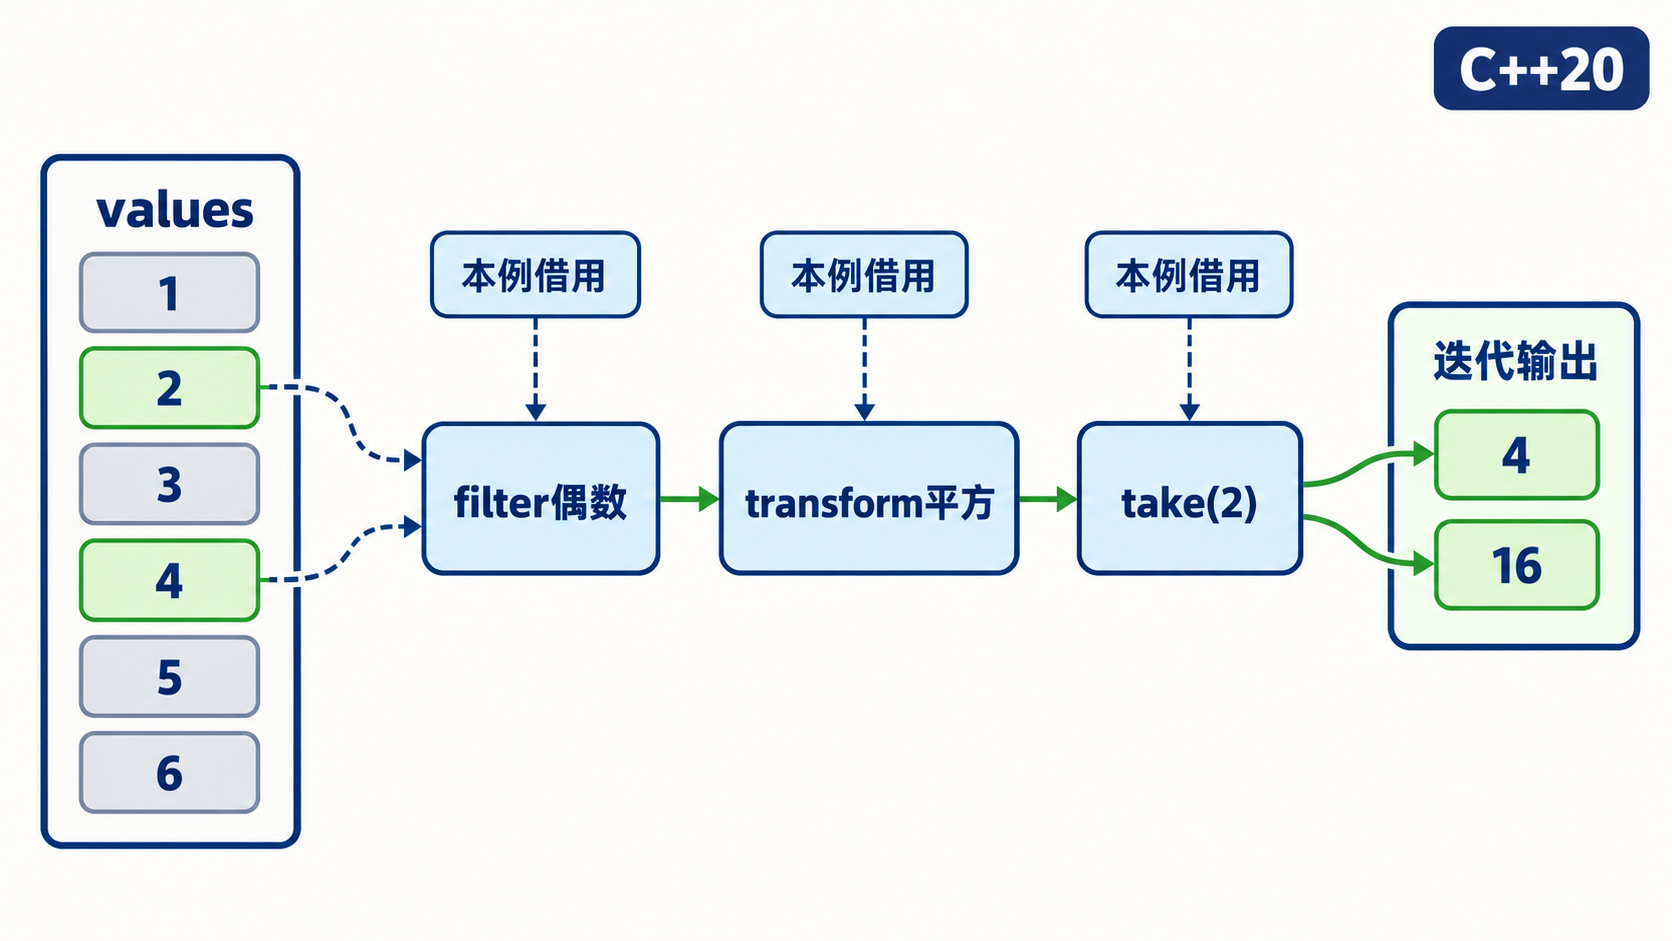
传统算法需要把 begin 和 end 分开传入,多个算法串联时容易产生临时容器和迭代器样板。Ranges 用 range 表示一段可遍历对象,views 则提供惰性变换,让过滤、映射和截取可以组合起来,真正迭代时才计算。
二、C++20 示例
#include <iostream>
#include <ranges>
#include <vector>

int main() {
    const std::vector<int> values{1, 2, 3, 4, 5, 6};
    auto result = values
        | std::views::filter([](int value) { return value % 2 == 0; })
        | std::views::transform([](int value) { return value * value; })
        | std::views::take(2);
    for (int value : result) std::cout << value << ' ';
}
三、边界与选择
本例从存活的左值 vector 借用元素,保存 result 时须保证源仍存活。view 不统一等于“不拥有”:支持相应标准缺陷修正的实现还可用 owning_view 接管可移动范围。判断临时范围安全性应看具体适配器和所有权,不能把所有临时输入都判成悬空。参见owning_view。惰性计算适合流水线和避免中间容器,但重复遍历可能重复计算;需要稳定结果或跨生命周期保存时,应物化到 vector 等拥有型容器。
| 方式 | 特点 | 适用场景 |
|---|---|---|
| 普通算法 | 迭代器显式,兼容 C++17 | 旧工具链、复杂控制流 |
| Views 管道 | 惰性组合、少临时对象 | 只读数据处理流水线 |
| 物化容器 | 拥有结果、生命周期独立 | 缓存、跨线程或长期保存 |
四、常见错误
- 认为 view 会复制数据并延长源容器生命周期。
- 返回借用已经销毁的局部或临时容器的 view,却没有检查所有权。
- 把惰性计算误认为只执行一次。
回答自检
- range、view 和算法的分工。
- 惰性计算带来的收益与生命周期风险。
- 什么时候保留 view,什么时候物化结果。
面试官可能追问的问题
- Ranges 能否完全替代 STL 算法? 不能,很多传统算法仍然适合直接使用。
- view 为什么适合减少拷贝? 它通常只保存迭代和变换状态,不立即生成中间容器。
- C++17 如何模拟? 可用迭代器、算法、Lambda 或范围库,但没有标准
views管道。



