
第十章 并发编程基础
第十章 并发编程基础
1. 类型特征 is_trivially_copyable 有什么用途?
问题分析
这道题考查能否用共享状态、同步关系与线程生命周期解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
std::is_trivially_copyable_v<T>表示 T 的对象表示可在标准规定条件下通过memcpy/memmove复制到另一个同类型对象并恢复值。 - 再讲机制:围绕“它描述什么”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构二面
问题讲解
一、它描述什么
std::is_trivially_copyable_v<T> 表示 T 的对象表示可在标准规定条件下通过 memcpy/memmove 复制到另一个同类型对象并恢复值。它常用于底层容器、共享内存布局检查和优化分支,但不代表类型没有构造函数、没有填充或可以直接跨机器序列化。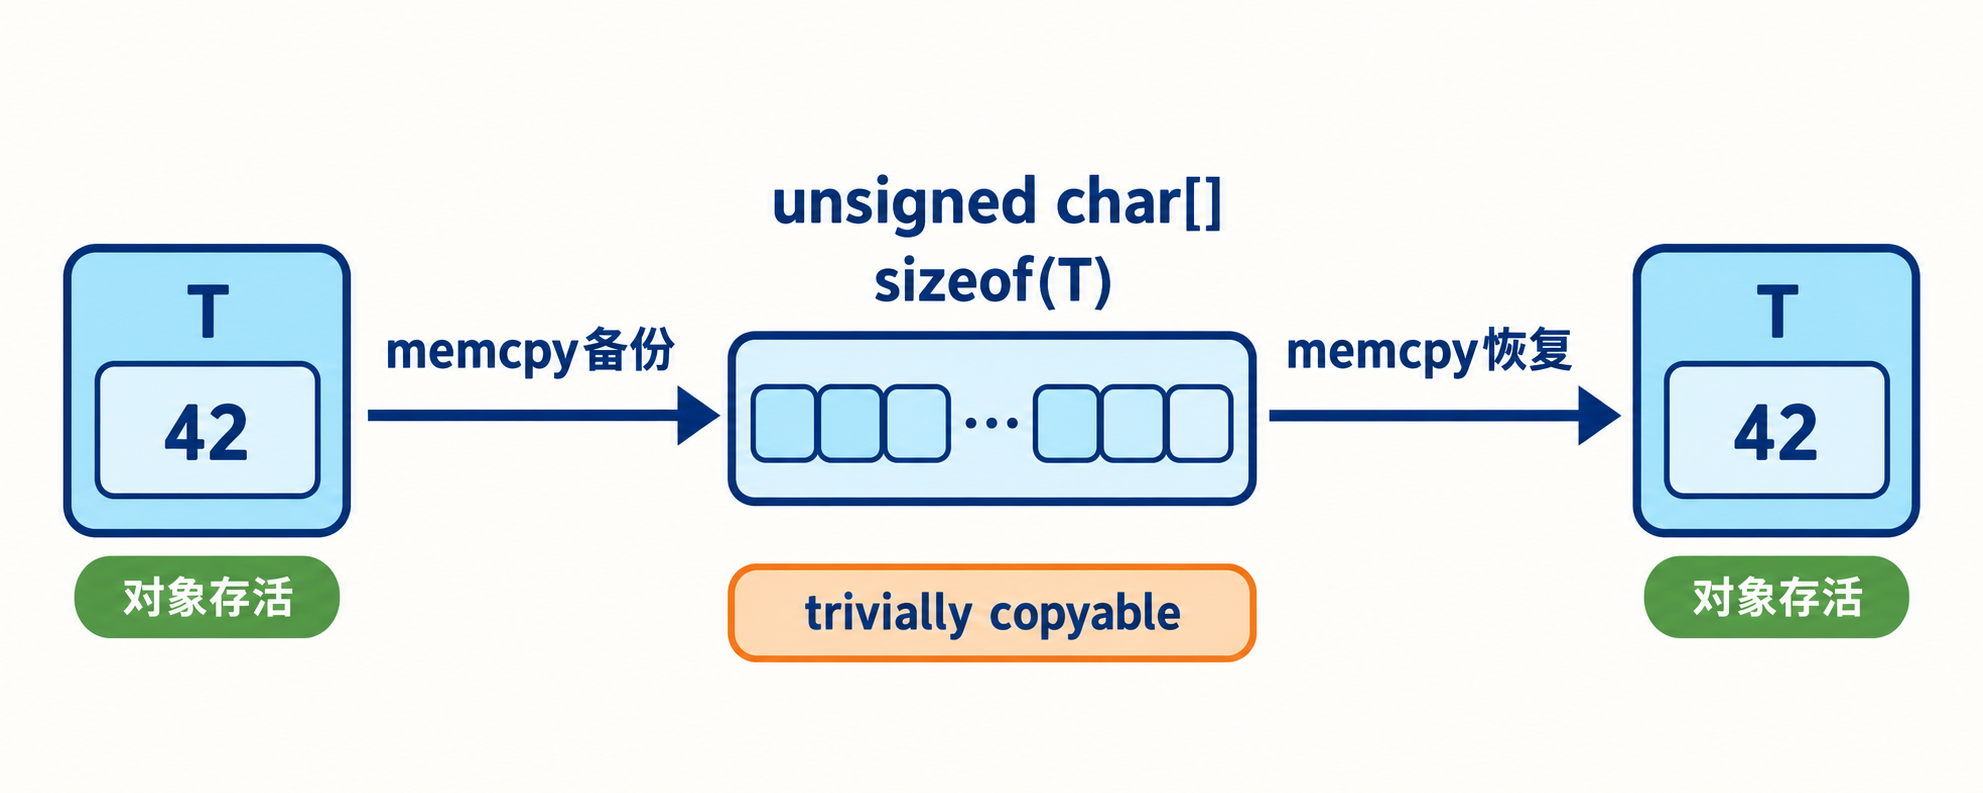
二、常见错误
- 把该特征等同于“POD”或标准布局。
- 直接把含指针类型写入文件并跨进程恢复。
- 比较对象所有字节判断相等,忽略填充字节。
- 对重叠区间使用 memcpy 而非 memmove。
回答自检
- 类型特征允许的字节复制语义。
- 它与 POD、标准布局的区别。
- 填充、指针和端序为何仍危险。
- 优化条件与持久化协议的分界。
面试官可能追问的问题
- trivial 与 trivially copyable 一样吗? 不一样,是不同类型性质。
- 能否直接网络传输? 不能据此保证端序、布局和版本兼容。
- 标准布局有什么用? 约束成员布局和互操作性质,关注点不同。
2. 如何创建 std::thread?join 和 detach 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:构造
std::thread会启动新执行线程; - 再讲机制:围绕“线程生命周期”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
一、线程生命周期
构造 std::thread 会启动新执行线程;join() 阻塞等待它结束并回收关联资源;detach() 让线程独立运行,thread 对象不再代表它。一个 joinable 的 std::thread 析构会调用 std::terminate,所以每条控制路径都必须 join 或 detach。
detach 不等于后台任务管理:被引用对象、日志系统和进程可能先结束。C++17 常用 RAII thread guard;C++20 jthread 在析构时请求停止并 join。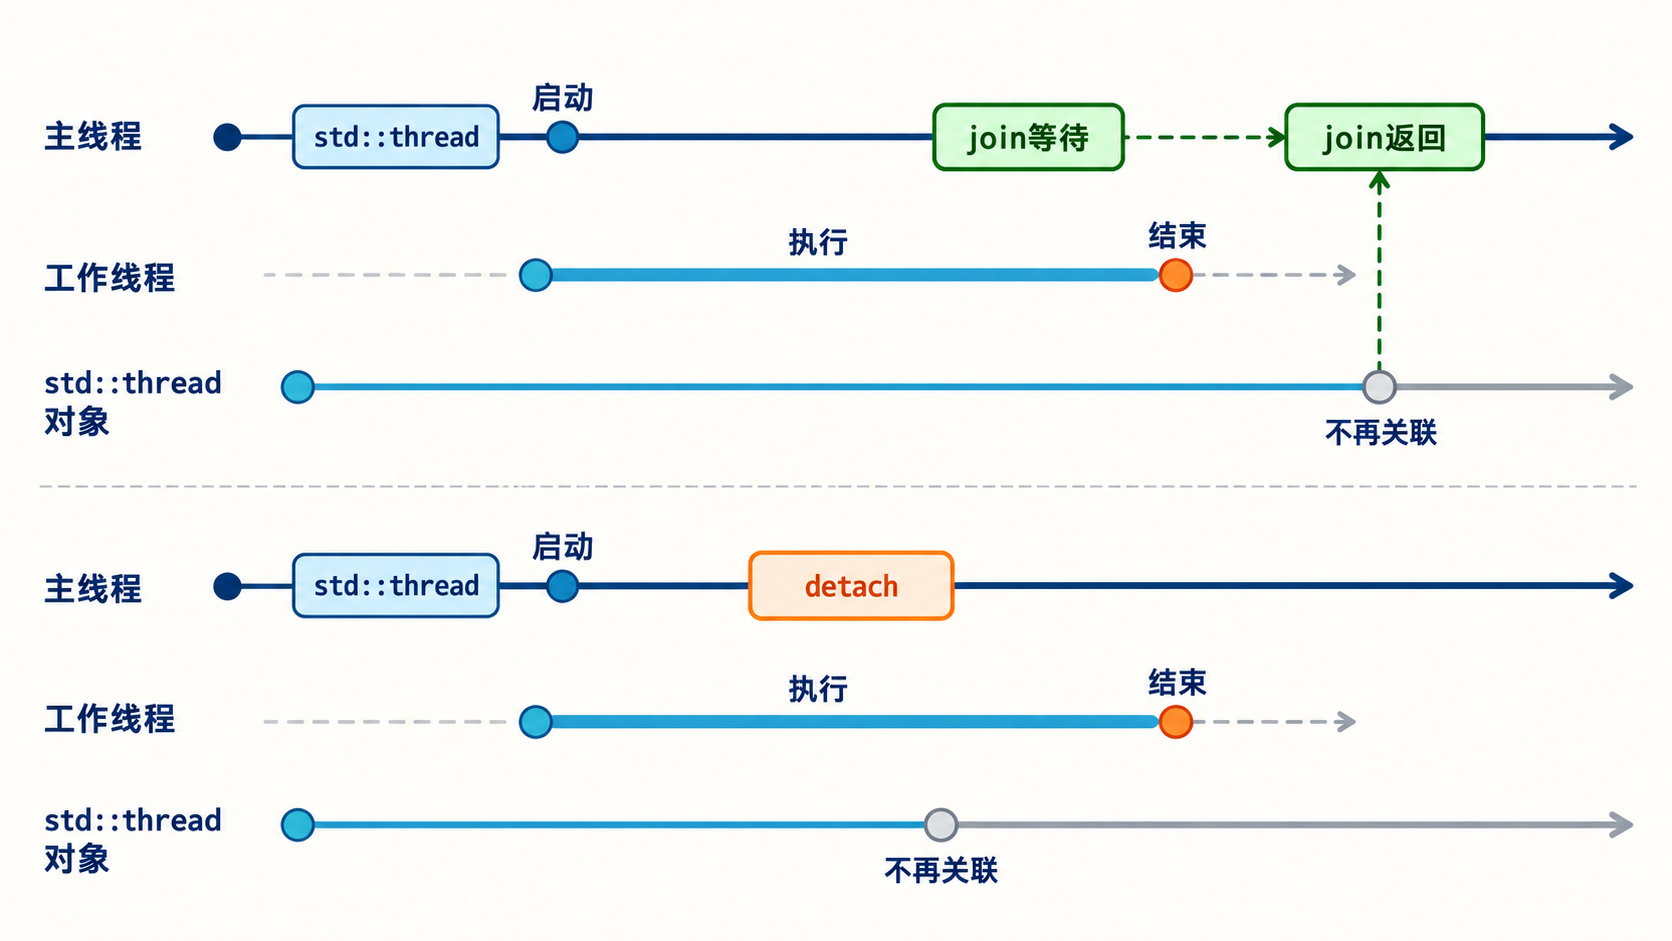
二、常见错误
- 在线程中按引用使用已离开作用域的局部变量。
- 异常路径跳过 join。
- 对同一 thread 重复 join。
- 用 detach 逃避线程所有权设计。
回答自检
- joinable 状态机。
- join 与 detach 的资源和同步差异。
- thread 析构终止规则。
- 参数捕获和线程对象的双重生命周期。
面试官可能追问的问题
- 如何传引用参数? 使用
std::ref,并确保寿命覆盖线程。 - join 是否同步内存? 线程完成同步于成功 join 返回,可观察其完成前写入。
- thread 能复制吗? 不能,但可移动所有权。
3. 数据竞争和竞态条件有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:数据竞争是不同线程并发访问同一内存位置,至少一个为写,且没有 happens-before 关系,也不是适当原子访问;
- 再讲机制:围绕“定义”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度基础架构一面
问题讲解
一、定义
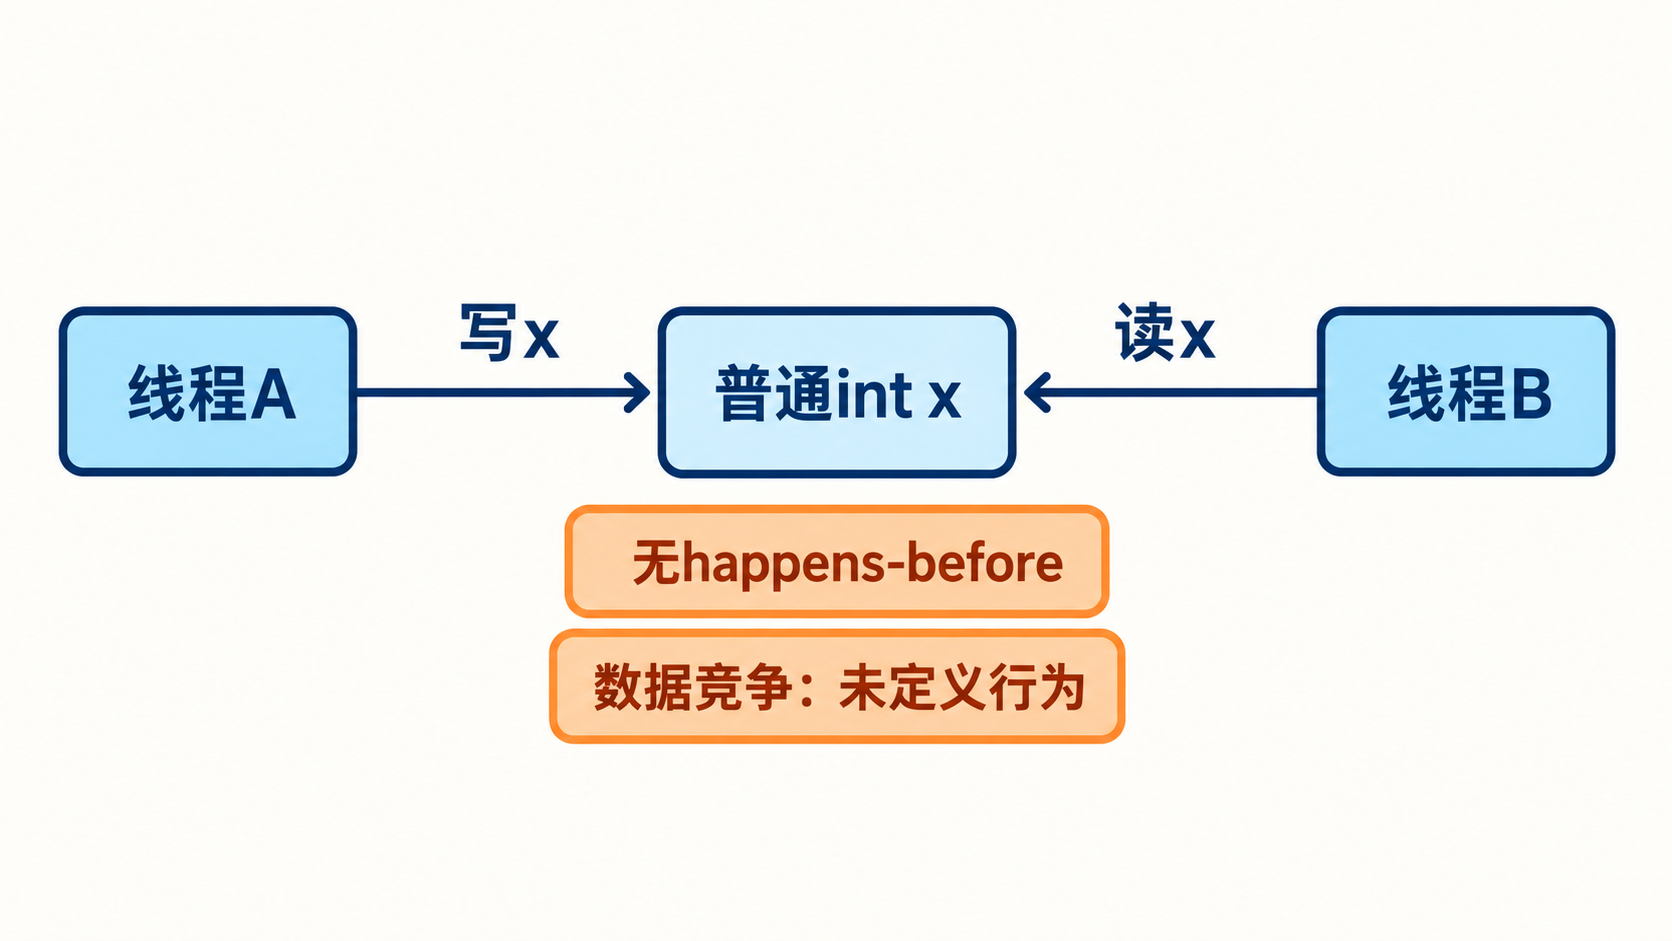
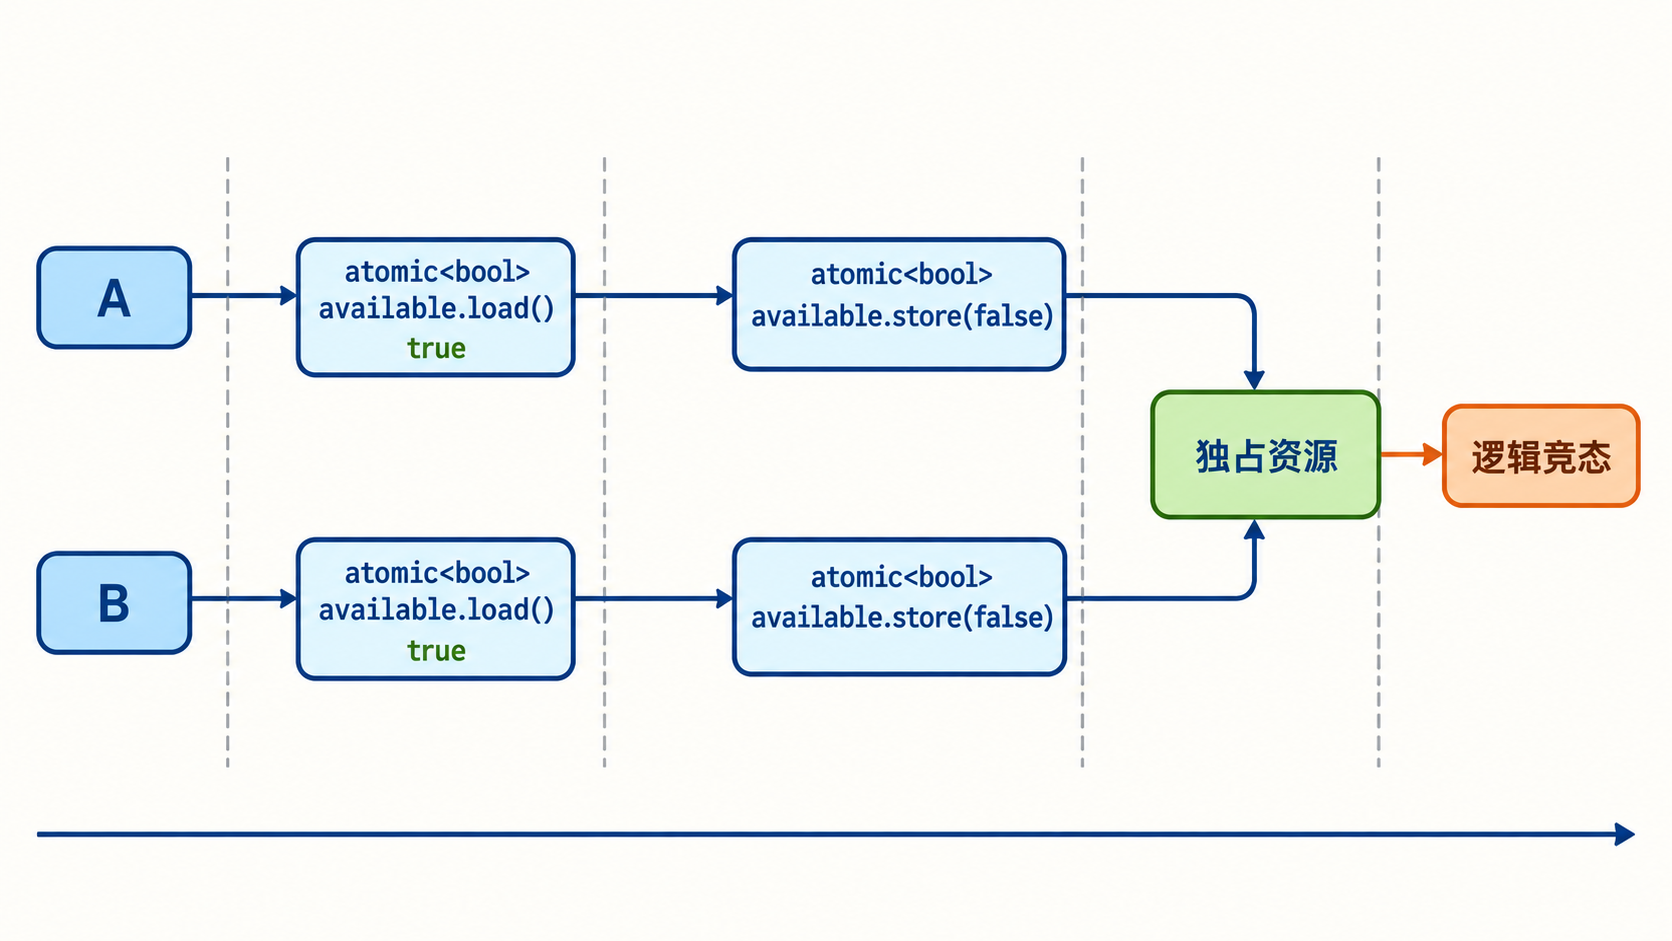
数据竞争是不同线程并发访问同一内存位置,至少一个为写,且没有 happens-before 关系,也不是适当原子访问;C++ 中会导致未定义行为。竞态条件更广:程序结果依赖不可控时序,即使每次访问都有锁或原子,也可能存在“检查后执行”的逻辑竞态。
二、常见错误
- 认为 int 读写在硬件上原子就没有数据竞争。
- 每个函数内部加锁,却跨两个调用做 check-then-act。
- 用 volatile 代替线程同步。
- 测试未复现就认为并发正确。
回答自检
- 数据竞争的三个条件。
- happens-before 的作用。
- 逻辑竞态为何可在无数据竞争时存在。
- volatile 不是同步工具。
面试官可能追问的问题
- 只读共享是否安全? 对象构造完成并安全发布后,多线程只读通常可行。
- 原子能消除所有竞态吗? 只能保证相应原子操作,跨多个变量的不变式仍可能竞态。
- TSan 能做什么? 动态检测许多数据竞争,但不能证明所有逻辑竞态不存在。
4. mutex、lock_guard、unique_lock 和 scoped_lock 如何选择?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
mutex是互斥原语; - 再讲机制:围绕“职责关系”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后端一面
问题讲解
一、职责关系
mutex 是互斥原语;通常不手工 lock/unlock,而用守卫。lock_guard 最轻量,构造加锁、析构解锁;unique_lock 支持延迟加锁、暂时解锁、移动和条件变量;scoped_lock(C++17)可一次管理一个或多个互斥量,多锁时使用无死锁算法。
锁应保护不变式而非单个变量,临界区尽量短,但不能把需要原子一致的操作拆开。不要持锁调用未知外部代码。
二、常见错误
- 手工 lock 后异常路径未 unlock。
- 为缩短临界区破坏复合不变式。
- 多把锁在不同路径采用不同顺序。
- 把 recursive_mutex 当作设计问题的默认修复。
回答自检
- mutex 与锁守卫的职责分工。
- 三类守卫的功能差异。
- 锁保护的是不变式。
- 多锁顺序与外部调用风险。
面试官可能追问的问题
- 条件变量为何要求 unique_lock? wait 需要原子地解锁、休眠和重新加锁。
- scoped_lock 一把锁可以吗? 可以。
- mutex 是否可复制? 不可复制,通常作为共享状态成员。
5. 死锁形成需要哪些条件?如何预防?
问题分析
这道题考查能否把共享状态、同步关系与线程生命周期转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:经典条件是互斥、占有并等待、不可剥夺、循环等待。
- 再讲机制:围绕“四个必要条件”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团基础架构一面
问题讲解
一、四个必要条件
经典条件是互斥、占有并等待、不可剥夺、循环等待。四者同时成立才可能死锁;工程上通常通过打破循环等待最实际:规定全局锁顺序,或用 std::lock/scoped_lock 同时获取多锁。
减少嵌套锁、复制数据后在锁外执行慢操作、使用超时和取消可改善活性,但 try_lock 失败重试若无退避可能产生活锁。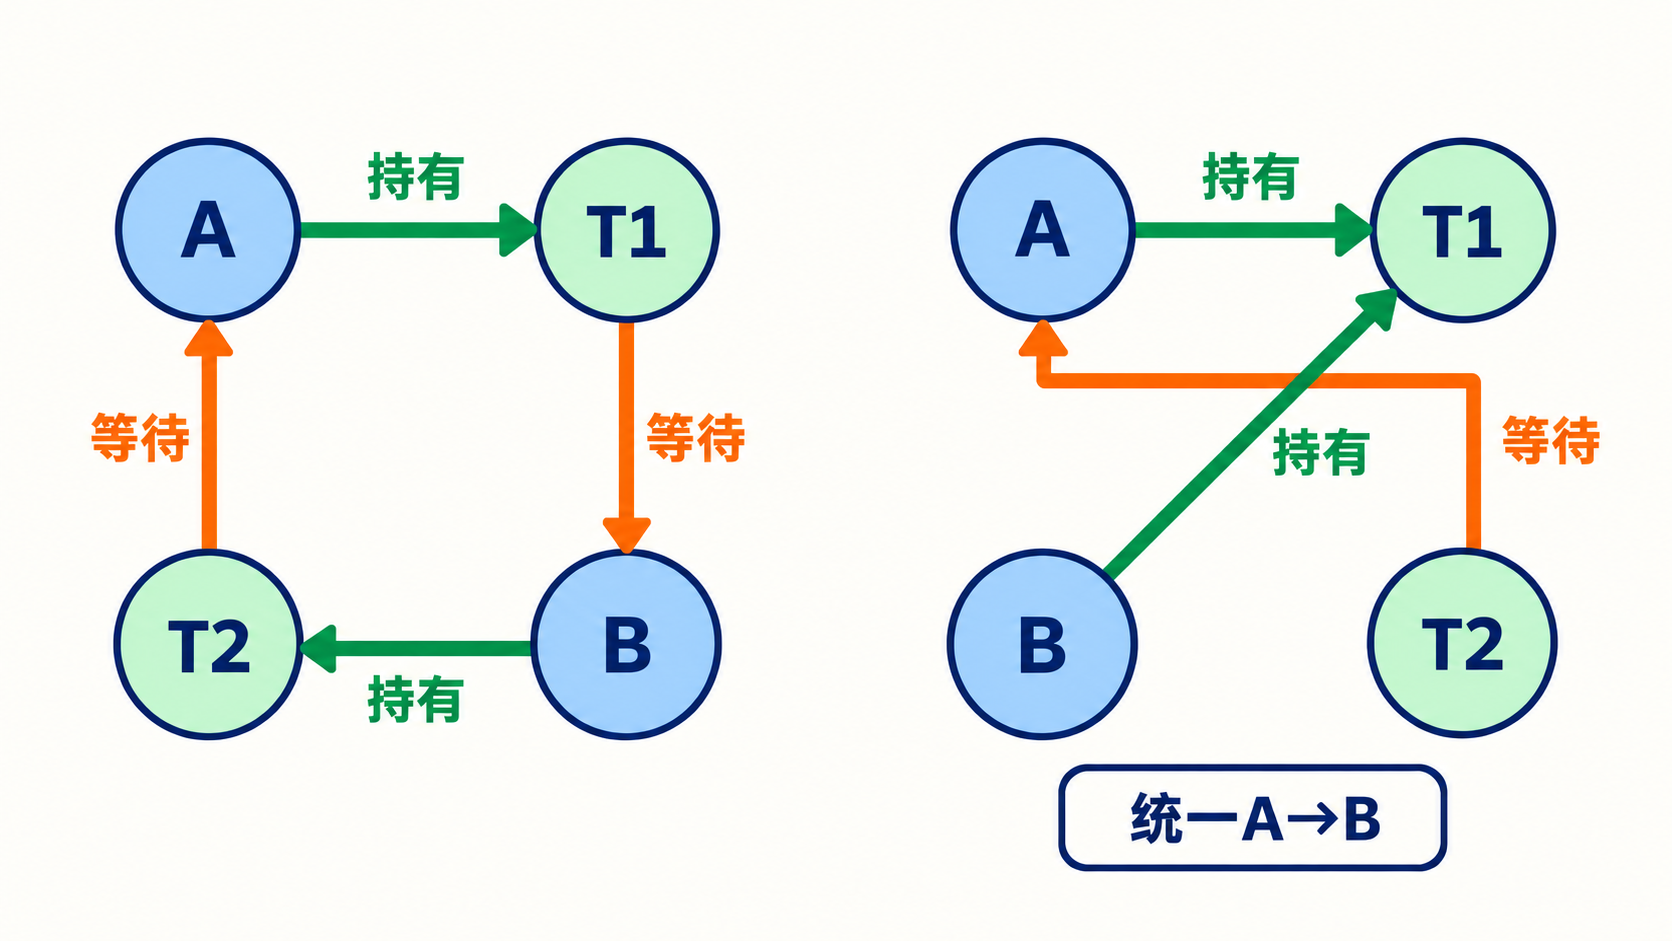
二、常见错误
- 认为只有两把锁才会死锁;单 mutex 非递归重入也可能自锁。
- 每个函数锁顺序正确,却忽略回调间接获取其他锁。
- 使用 recursive_mutex 隐藏层级混乱。
- 把活锁或饥饿都称为死锁。
回答自检
- 四个必要条件。
- 锁顺序如何打破等待环。
- scoped_lock 的作用。
- 死锁、活锁、饥饿的区别。
面试官可能追问的问题
- 活锁是什么? 线程都在行动和退让,但没有工作进展。
- 饥饿是什么? 某线程长期得不到资源,其他线程仍在推进。
- 如何定位? 采集所有线程栈和锁等待图,寻找环。
6. 条件变量为什么必须循环检查谓词?
问题分析
这道题考查能否从可观察现象追溯到共享状态、同步关系与线程生命周期中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:条件变量让线程在条件未满足时原子地释放锁并休眠,醒来后重新加锁。
- 再讲机制:围绕“正确等待模型”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯后台一面
问题讲解
一、正确等待模型
条件变量让线程在条件未满足时原子地释放锁并休眠,醒来后重新加锁。虚假唤醒、多个消费者竞争以及通知先于真正获得锁,都意味着醒来不等于条件成立,必须在同一互斥量保护下循环检查谓词。
关键点不是收到通知,而是线程重新持有 mutex 后再次确认谓词;谓词不成立就必须继续等待。
推荐 cv.wait(lock, predicate),语义等价于 while 循环。修改共享状态时要持同一锁;通知可在解锁前后,选择需结合竞争与状态可见性。
二、完整可执行示例
谓词同时处理“队列中有任务”和“生产者已经结束”两个状态。即使发生虚假唤醒,消费者也只有在谓词成立后才离开 wait。
#include <condition_variable>
#include <iostream>
#include <mutex>
#include <queue>
#include <thread>

int main() {
    std::mutex mutex;
    std::condition_variable ready;
    std::queue<int> tasks;
    bool finished = false;

    std::thread consumer([&] {
        std::unique_lock<std::mutex> lock(mutex);
        ready.wait(lock, [&] { return !tasks.empty() || finished; });
        if (!tasks.empty()) {
            const int task = tasks.front();
            tasks.pop();
            lock.unlock();
            std::cout << "consume " << task << '\n';
        }
    });

    {
        std::lock_guard<std::mutex> lock(mutex);
        tasks.push(42);
        finished = true;
    }
    ready.notify_one();
    consumer.join();
}

三、常见错误
- 用 if 只检查一次。
- 把通知当成会被永久保存的消息。
- 修改谓词状态时不持锁。
- 谓词捕获已失效对象。
回答自检
- 条件变量与共享谓词的关系。
- 解锁、休眠、重加锁的原子步骤。
- 为什么必须 while 检查。
- 通知不等于条件成立。
面试官可能追问的问题
- 虚假唤醒是什么? 没有对应业务通知也可能从 wait 返回。
- notify_one 还是 all? 一个任务只需一个等待者时 one;所有等待者都需重新判断时 all。
- wait 期间锁是什么状态? 休眠前释放,返回前重新持有。
7. 原子变量和互斥锁分别适合什么场景?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:原子适合单个计数器、标志或可用单个原子状态表达的协议;
- 再讲机制:围绕“选择原则”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度基础架构一面
问题讲解
一、选择原则
原子适合单个计数器、标志或可用单个原子状态表达的协议;单次 fetch_add 或成功的比较交换等读改写操作不可分割;独立的 load、计算、store 并不会自动合并成原子事务。是否发布其他数据还取决于内存序。互斥锁适合多个字段共同维护不变式、容器修改和较长临界区,它让一段操作整体排他。
原子不等于无锁,也不一定比 mutex 快;复杂 lock-free 算法还涉及 ABA、内存回收和进度保证。先正确建模,再基于测量优化。
左侧假设两个余额分别为原子字段,讨论业务不变式而不是普通变量的数据竞争;右侧所有读写遵守同一互斥锁。
二、常见错误
- 把多个 atomic 字段组合后认为整体一致。
- 用 atomic 自旋等待长任务。
- 认为
is_lock_free在所有平台固定。 - 混合原子与非原子访问同一对象。
回答自检
- 单状态与复合不变式的分界。
- 原子性不等于事务性。
- lock-free 与 atomic 的区别。
- 正确性证明优先于性能猜测。
面试官可能追问的问题
- atomic<int> 一定 lock-free 吗? 不保证,可查询
is_lock_free()。 - 计数器一定 relaxed 吗? 仅统计且不发布其他数据时常可用,需按协议证明。
- 锁一定会进内核吗? 无竞争快路径常在用户态,竞争时才可能休眠。
8. relaxed、acquire/release 和 seq_cst 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
relaxed只保证该原子对象操作不可分割及其修改顺序,不建立其他普通数据的同步。 - 再讲机制:围绕“三档语义”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构二面
问题讲解
一、三档语义
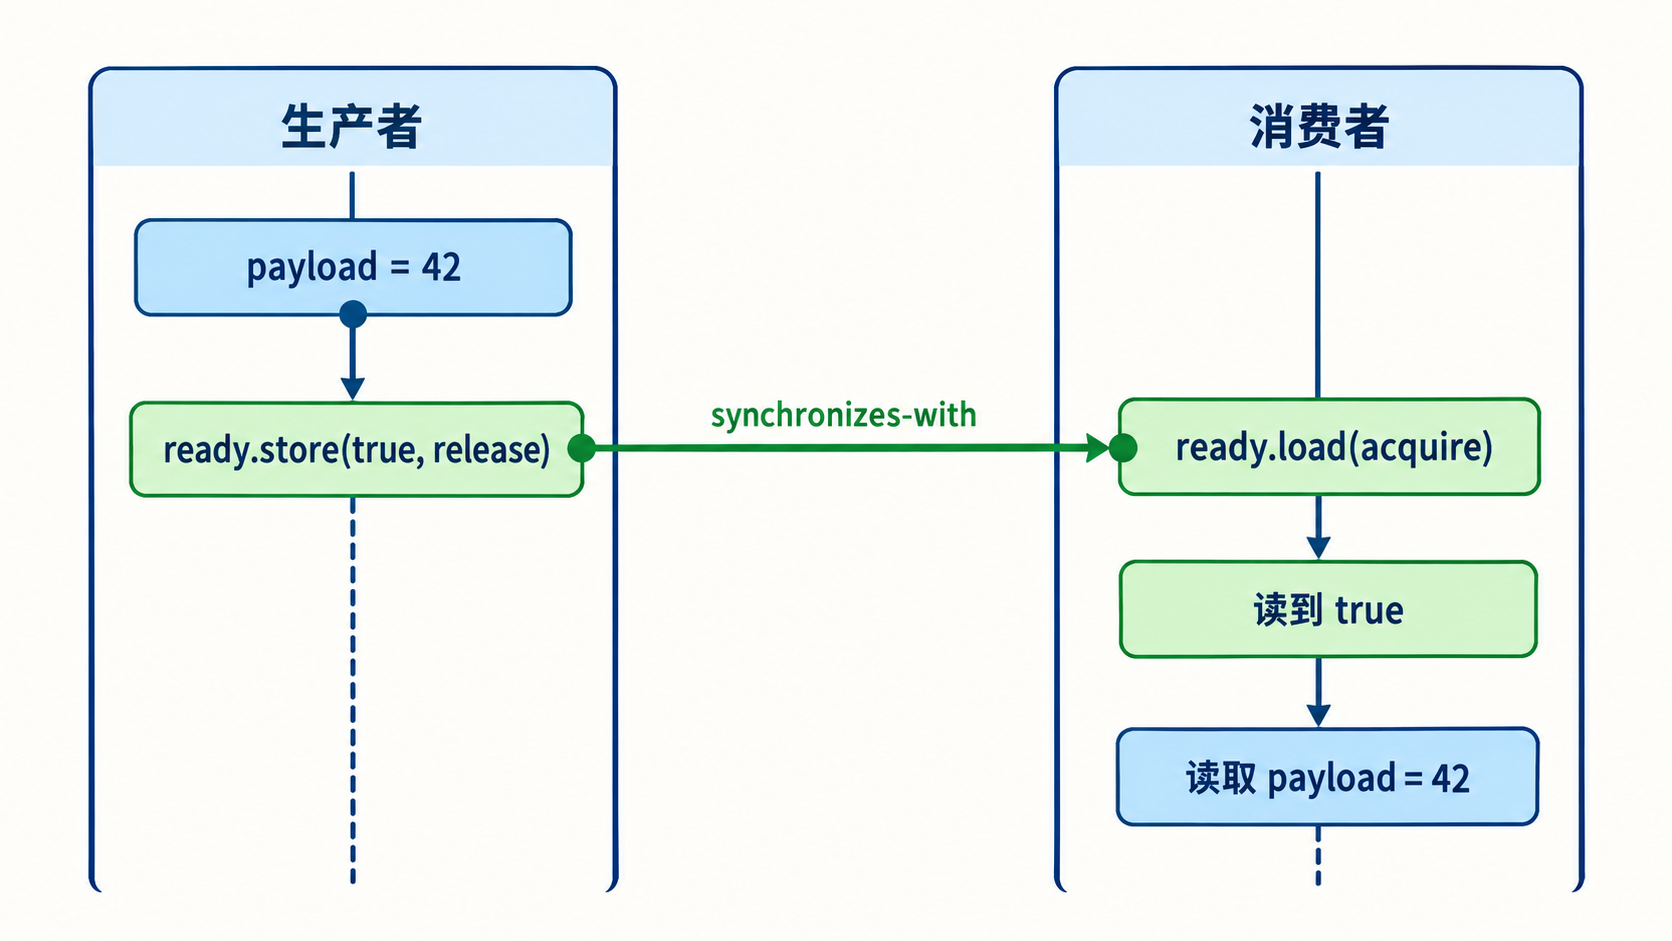
relaxed 只保证该原子对象操作不可分割及其修改顺序,不建立其他普通数据的同步。release 写与读取到该值的 acquire 读形成 synchronizes-with,使 release 前操作 happens-before acquire 后操作。seq_cst 还对相应顺序一致原子操作和栅栏规定单一全序,受标准中的顺序约束;不能理解成所有普通内存访问都进入一条全局队列。
release/acquire 不会把所有操作“全局排队”。它建立的是一条发布链:消费者 acquire 读到对应发布值后,才能看到该次发布之前写入的普通数据。
内存序必须针对整个通信协议证明。默认 seq_cst 正确后再优化;在不明确硬件和编译器重排时贸然 relaxed 很危险。
二、完整可执行示例
生产者先写普通数据,再用 release 发布标志;消费者只有在 acquire 读到该标志后才访问普通数据。同步关系保护的是这条完整通信链,而不是“让某个变量刷新缓存”。
#include <atomic>
#include <iostream>
#include <thread>

int main() {
    int payload = 0;
    std::atomic<bool> ready{false};

    std::thread producer([&] {
        payload = 42;
        ready.store(true, std::memory_order_release);
    });

    std::thread consumer([&] {
        while (!ready.load(std::memory_order_acquire)) {
            std::this_thread::yield();
        }
        std::cout << payload << '\n';
    });

    producer.join();
    consumer.join();
}
三、常见错误
- 认为 relaxed 什么都不保证。
- acquire 读取了旧值仍声称与某次 release 同步。
- 只给生产者 release,却让消费者普通读取标志。
- 为性能把所有操作降为 relaxed。
回答自检
- 原子性与可见性顺序的区别。
- release/acquire 成对生效的条件。
- happens-before 对普通数据的保护。
- seq_cst 的全局顺序语义。
面试官可能追问的问题
- acquire 能放在 store 上吗? 普通 store 不接受纯 acquire;不同原子操作允许的内存序不同。
- mutex 与内存序有何关系? 正确解锁/加锁也建立同步关系。
- 为什么 seq_cst 易推理? 增加统一全局顺序约束。
9. 线程池由哪些部分组成?为什么需要任务队列和背压?
问题分析
这道题考查能否从可观察现象追溯到共享状态、同步关系与线程生命周期中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:线程池通常包含固定或可调工作线程、受同步保护的任务队列、条件变量、提交接口、停止状态和结果/异常传播机制。
- 再讲机制:围绕“核心组件”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后台二面
问题讲解
一、核心组件
线程池通常包含固定或可调工作线程、受同步保护的任务队列、条件变量、提交接口、停止状态和结果/异常传播机制。提交者入队并通知,工作线程等待、取任务、在锁外执行,再继续循环。
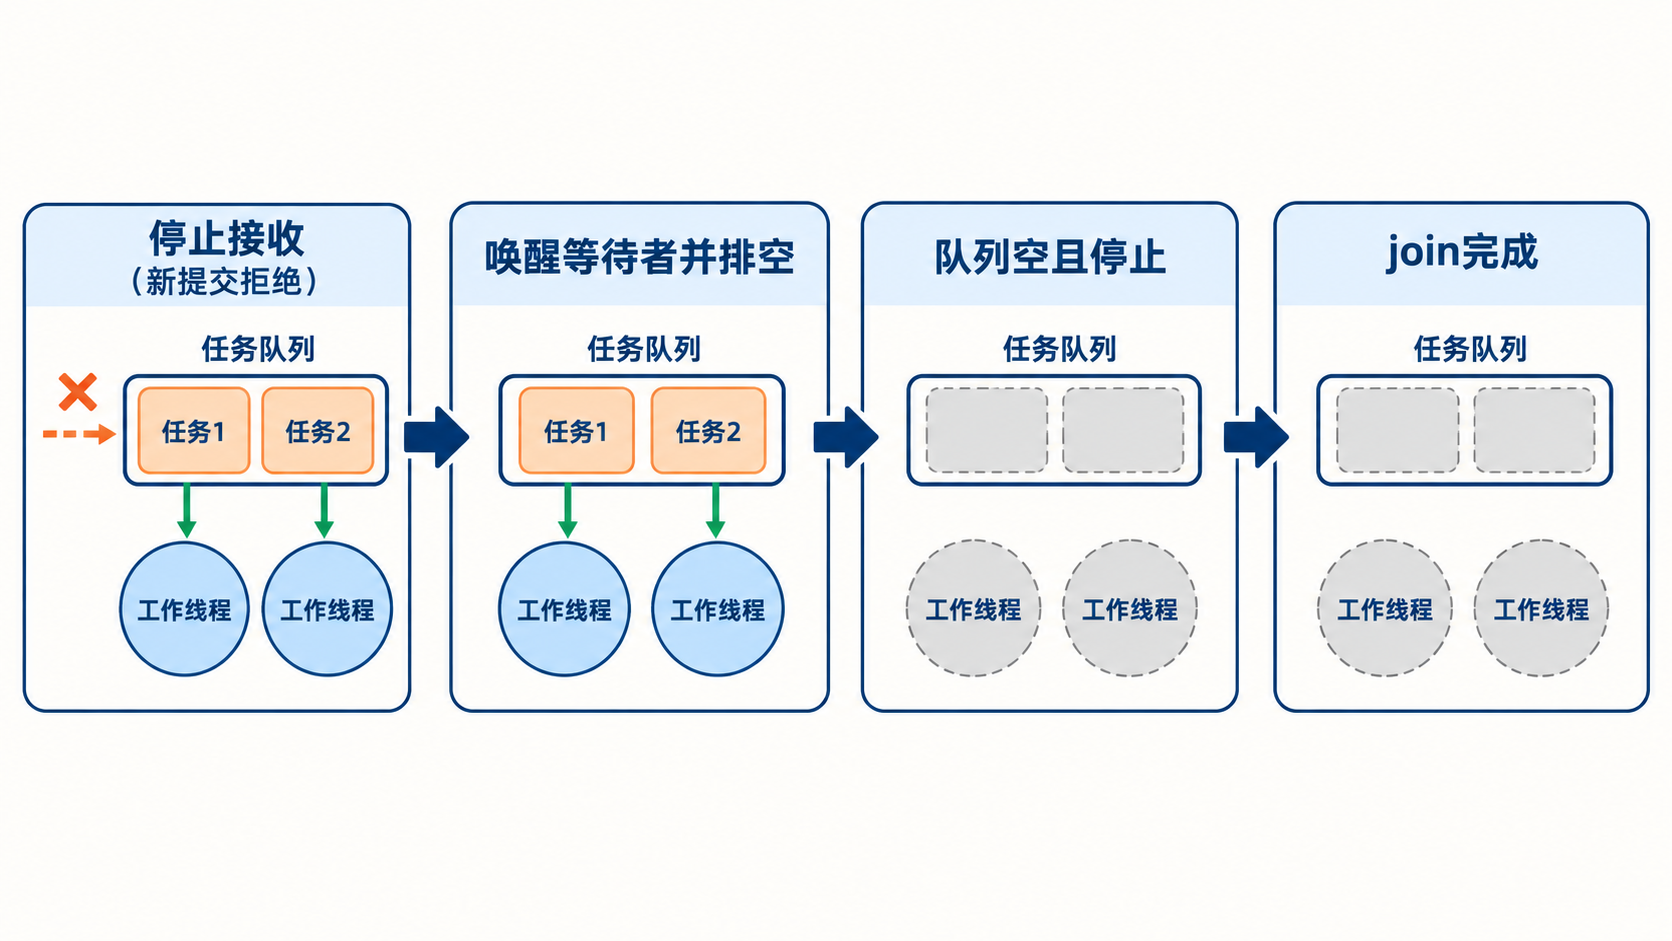
无界队列在生产速度长期高于消费速度时会耗尽内存并放大延迟。背压用有界队列和明确策略让过载向上游传播。关闭时要定义停止接收、排空还是取消、唤醒等待线程和 join 的顺序。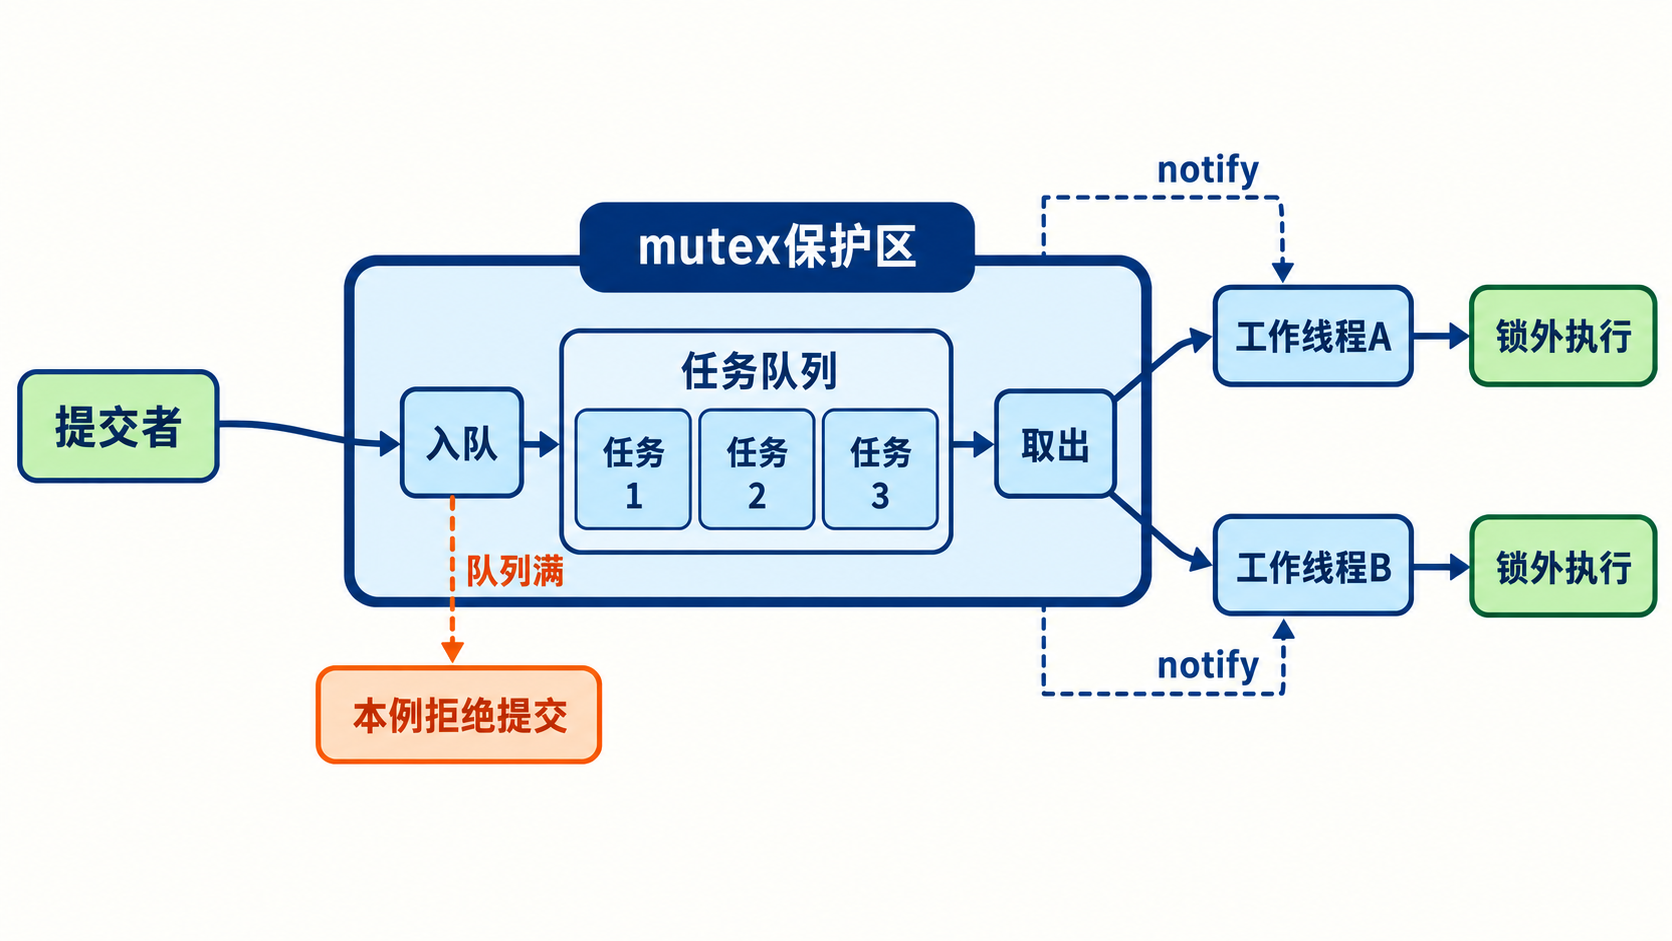
二、常见错误
- 队列无上限。
- 持队列锁执行用户任务。
- 任务异常逃出工作线程导致 terminate。
- 析构时未阻止新提交或未唤醒线程。
回答自检
- 线程、队列、通知和停止状态的协作。
- 为什么任务必须锁外执行。
- 背压如何保护延迟和内存。
- 关闭与异常传播协议。
面试官可能追问的问题
- 线程数如何选? CPU 密集接近可用核心数;I/O 密集需结合阻塞比例和测量。
- 任务如何返回结果? 用 packaged_task/future 或回调通道。
- 如何防任务互相等待死锁? 避免池内同步等待同池任务,或设计工作窃取/依赖调度。
10. future、promise、packaged_task 和 async 有什么关系?
问题分析
这道题不只是让你罗列名词,而是考查能否从共享状态、同步关系与线程生命周期做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
future<T>是结果消费者,通常只能 get 一次; - 再讲机制:围绕“共享状态模型”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节 C++ 后端二面
问题讲解
一、共享状态模型
future<T> 是结果消费者,通常只能 get 一次;promise<T> 是显式生产者,可设置值或异常;packaged_task 包装可调用对象,执行时把返回值/异常写入共享状态;async 是更高层入口,创建并返回 future,执行策略可能是异步线程或延迟执行。
默认 async 策略由实现选择;要明确并发可指定 std::launch::async。未履行 promise 就销毁会让 future 收到 broken_promise。shared_future 可供多个消费者读取。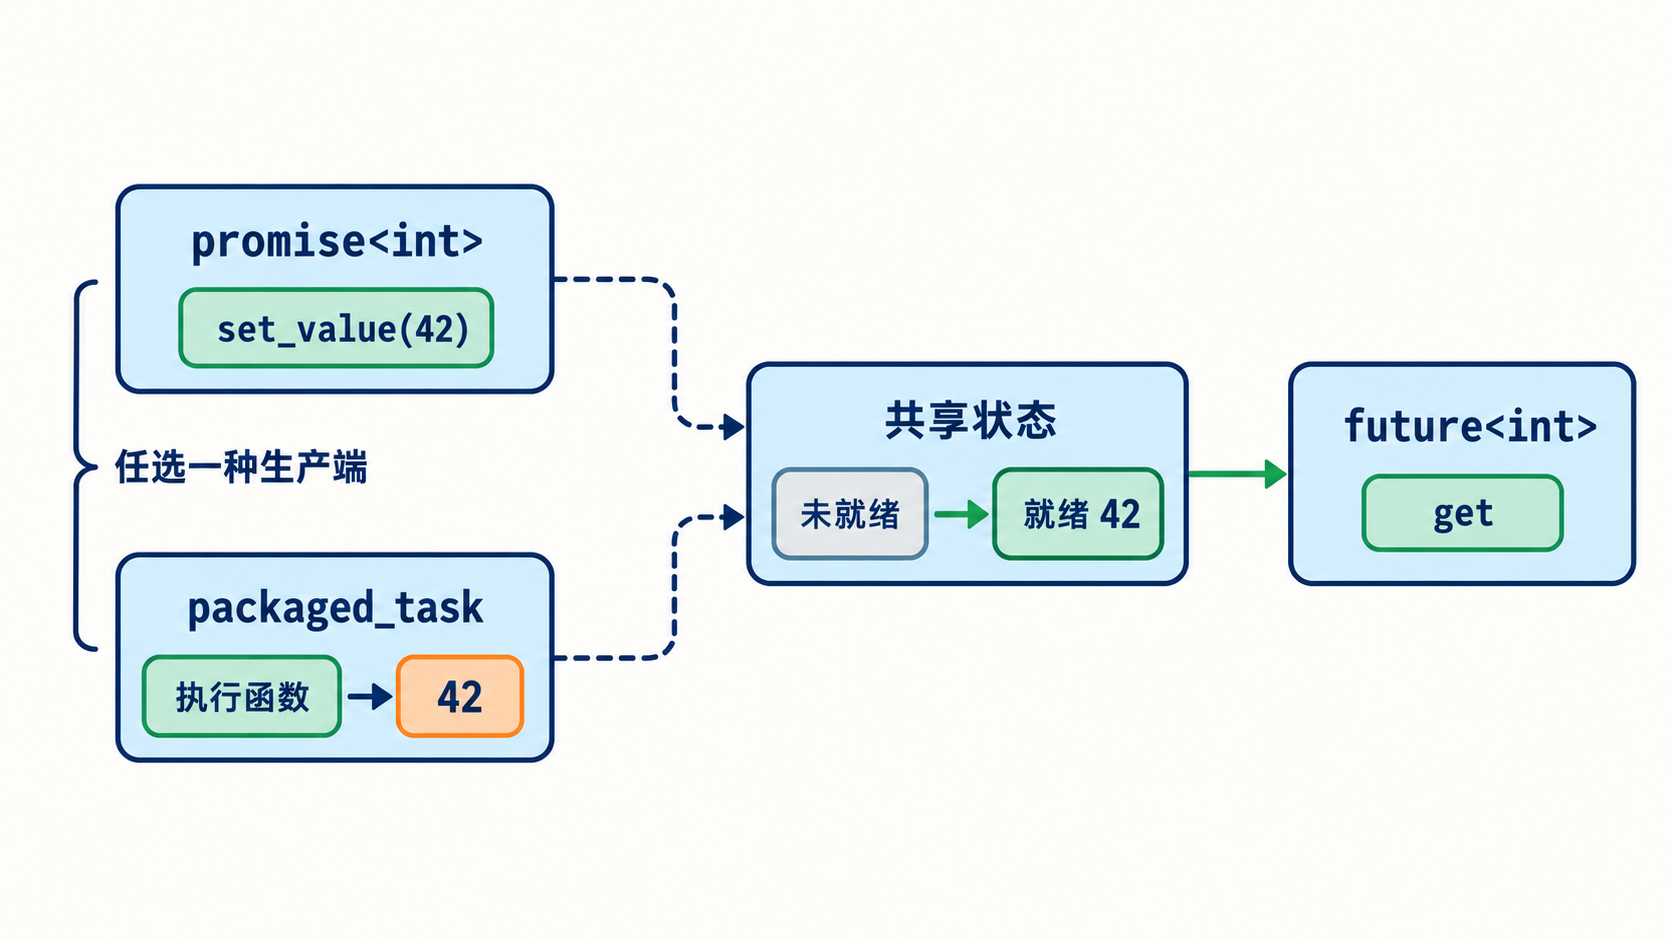
二、常见错误
- 对同一 future 多次 get。
- 认为默认 async 必然新建线程。
- 忘记保存某些 async 返回 future,导致生命周期与等待行为意外。
- 在线程中吞掉异常,未通过共享状态传播。
回答自检
- 共享状态连接生产者与消费者。
- 四个设施各自的抽象层级。
- 值和异常如何传播。
- async 执行策略与生命周期边界。
面试官可能追问的问题
- promise 和 packaged_task 区别? promise 手动产生结果,packaged_task 从函数调用自动产生。
- future 析构会等待吗? 某些由 async 产生的 future 有特殊等待行为,不能泛化到所有 future。
- 如何多个消费者读取? 转成
shared_future。
11. 什么场景适合线程,什么场景适合协程?
问题分析
这道题考查能否用共享状态、同步关系与线程生命周期解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:线程是操作系统调度的执行单位,拥有独立栈和寄存器上下文,适合利用多核并行执行 CPU 任务,也能承载阻塞式系统调用。
- 再讲机制:围绕“先看并发单位 → 选型比较”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节基础架构二面(编辑化整理)
问题讲解
一、先看并发单位
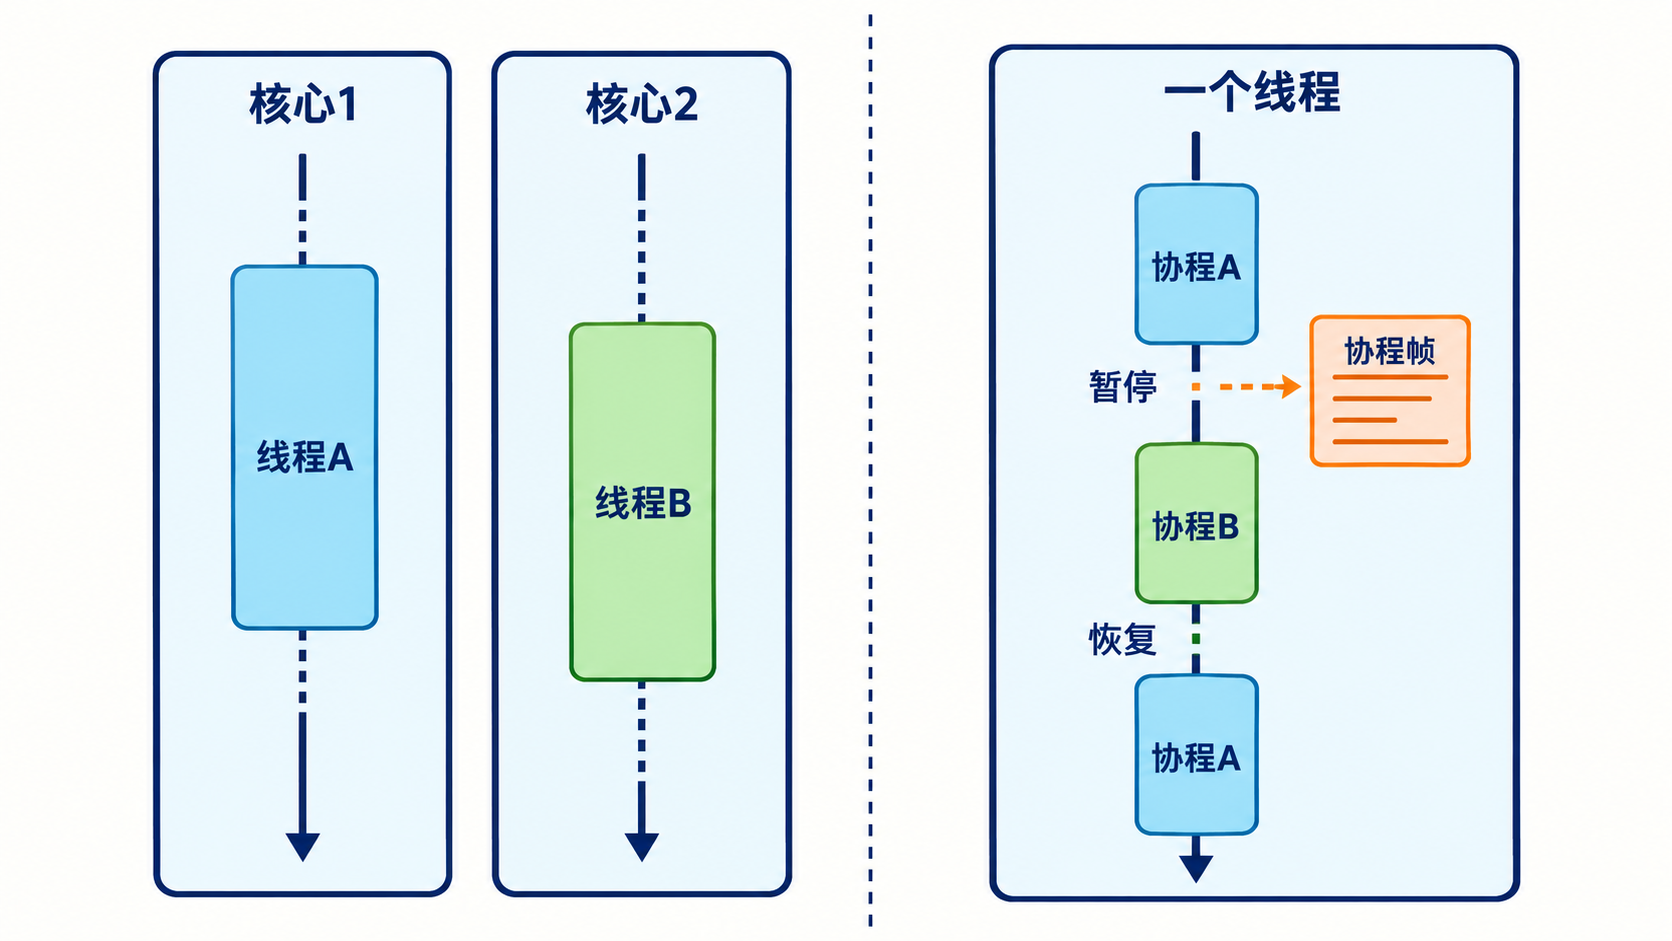
线程是操作系统调度的执行单位,拥有独立栈和寄存器上下文,适合利用多核并行执行 CPU 任务,也能承载阻塞式系统调用。协程是用户态保存的暂停点,通常由线程或事件循环恢复,适合大量 I/O 任务和需要顺序写法的异步流程。
二、选型比较
| 维度 | 线程 | 协程 |
|---|---|---|
| 调度者 | 操作系统 | 用户态框架/事件循环 |
| 切换成本 | 通常较高 | 通常较低,但依赖实现 |
| 并行能力 | 可跨核并行 | 单线程协程本身不等于并行 |
| 阻塞风险 | 阻塞一个线程 | 阻塞事件循环会拖住一批任务 |
| 适合任务 | CPU、阻塞调用 | 高并发 I/O、状态机流程 |
三、常见错误
- 把协程说成天然并行。
- 在事件循环协程中调用长时间阻塞的同步 API。
- 创建无上限线程,忽略栈空间、调度和队列背压。
回答自检
- 线程与协程的调度边界。
- I/O 等待、CPU 计算和阻塞调用对选型的影响。
- 协程不等于并行,以及事件循环阻塞的风险。
面试官可能追问的问题
- 协程能否跑在多个线程? 可以由调度器把不同协程分配到多个线程,但共享状态仍需同步。
- CPU 密集任务是否不能用协程? 可以组织流程,但不能靠协程本身获得多核并行,仍需线程或进程。
- 线程池和协程能一起用吗? 常见组合是协程负责 I/O 编排,线程池承载少量阻塞或 CPU 工作。
12. C++20 协程是什么?如何理解它的暂停和恢复?
问题分析
这道题考查能否把共享状态、同步关系与线程生命周期转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:C++20 协程函数包含
co_await、co_yield或co_return时,会被编译器转换为状态机。 - 再讲机制:围绕“协程的核心机制 → 与线程的关系”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合共享状态、同步关系与线程生命周期说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构二面(编辑化整理)
问题讲解
一、协程的核心机制
C++20 协程函数包含 co_await、co_yield 或 co_return 时,会被编译器转换为状态机。返回对象、initial_suspend 和 awaiter 决定首次执行与暂停时机。co_await 不一定挂起:await_ready 可直接完成,await_suspend 的结果也可能使其继续;真正暂停后,恢复由具体库协议安排,标准不自动创建调度器。参见co_await 规则。

二、与线程的关系
协程帧保存跨暂停点需要的参数、局部状态和 promise 等。到达 co_return 不自动等于帧已释放:final_suspend 可以继续悬挂,由约定的拥有者 destroy;也可能由协议自动释放,不能再次销毁。句柄是访问工具,所有权必须由库明确。标准只提供底层协程机制,不直接提供网络事件循环、任务调度器或通用 Task<T> 类型。因此不同库的返回对象和取消协议不能直接互换。
三、常见错误
- 认为写了
co_await就自动异步,不检查 awaiter 是否真的挂起。 - 协程返回对象销毁后仍使用悬空
coroutine_handle。 - 没有设计取消、异常传播和协程帧释放路径。
回答自检
- 协程如何被理解为可暂停的状态机。
- 协程帧、句柄、awaiter 和调度器的关系。
- 标准协程机制与具体异步库之间的边界。
面试官可能追问的问题
- 协程帧存在哪里? 通常由编译器和返回对象管理,可能动态分配,也可能被优化,不能把某一种布局当成标准保证。
co_yield与co_return区别?co_yield产生中间值并可再次恢复,co_return结束协程。- 协程一定比回调快吗? 不一定,收益主要是控制流可读性和调度模型,仍需测量分配与恢复成本。



