
设备与 I/O 管理校招面试题|操作系统
设备与 I/O 管理校招面试题|操作系统
本章从软硬件分工开始,追踪请求怎样到达设备、完成后怎样通知CPU,以及数据怎样搬运和排队。中断、DMA和缓冲解决的是不同问题,理解各自职责后,才不会把“少等待”“少搬运”和“立即运行”混成一件事。
以下流程是通用职责模型;Linux实例就近注明,历史I/O通道另行区分。时间线只作明确假设下的计算,不是实际设备测量,本次也不执行系统或硬件实验。
1. 设备控制器和设备驱动程序有什么区别?
设备控制器是负责与设备交互的硬件,设备驱动程序是让操作系统使用该硬件的软件。CPU执行驱动代码,驱动组织命令并访问控制器提供的接口,控制器再完成具体硬件操作。
同一个读请求,分成软件与硬件职责
应用说“读取这段内容”,通常通过操作系统接口发起请求,而不是自己直接访问磁盘寄存器。内核相关服务把需求交给驱动,驱动根据设备协议准备命令,例如目标位置、缓冲和长度,并向控制器提交。
控制器提供命令、状态等接口,协调设备执行实际读写,完成后给出结果或错误。接口可能使用寄存器、命令队列等形式,具体取决于设备。驱动则解释返回状态,把成功、失败和实际完成情况转换成上层能处理的结果。
比如设备返回读失败,控制器负责报告硬件状态,驱动按协议识别错误并采取允许的重试或结束处理,上层再决定如何告知应用。驱动不能靠改一个成功标志,把没有读到的内容变成真实数据。控制器也不会自动理解应用的全部文件路径与业务含义。
为什么要有设备相关软件
不同设备的命令格式、地址能力和错误语义不同,驱动把这些差异封装起来,避免每个应用都重复理解硬件。更上层还能提供一致的读取、写入或网络接口。控制器与CPU的职责见OSTEP:I/O设备。
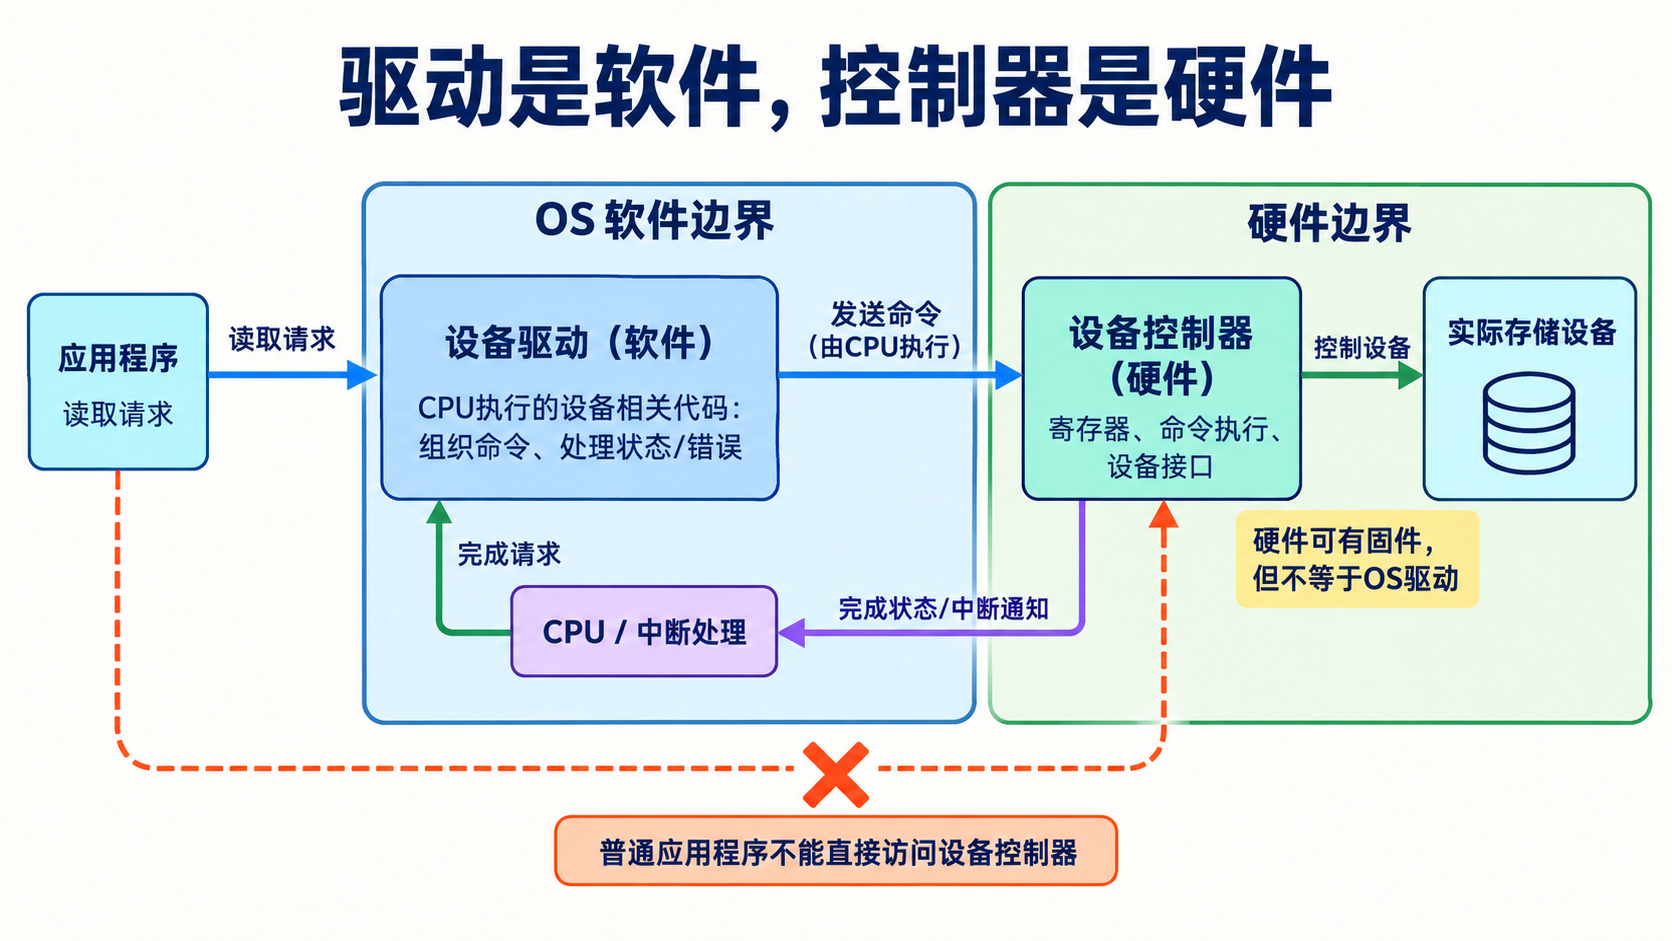
将命令、状态返回与实际设备操作分开,明确软硬件边界。
两个常见误解
驱动不是一块额外芯片,也不是与CPU并列的另一个软件处理器;它的代码由CPU执行。控制器可能带固件,但固件不等于操作系统驱动。驱动运行位置也依系统设计而异,可以有内核驱动或受控的用户态驱动,不能把所有平台都限定成同一种形式。普通应用一般通过受保护接口使用设备,不代表不存在经过授权的特殊直接访问方式。
面试回答
控制器是硬件,提供命令、状态等接口并协调设备操作;驱动是CPU执行的设备相关软件,负责组织请求、提交命令、解释完成状态和错误,并对接操作系统上层。这样应用不必了解每种设备的寄存器和协议。控制器固件不等于OS驱动,驱动也不是独立芯片;运行在内核还是受控用户态取决于系统设计,普通应用通常不直接控制硬件。
2. I/O 软件有哪些层次?I/O 子系统提供哪些能力?
I/O软件通常按职责分层:应用表达需求,通用接口检查和组织请求,设备无关服务提供共享管理,驱动处理具体协议,硬件完成传输。分层目的是复用公共能力,把设备差异限制在合适的位置,而不是要求每个系统固定有五次函数调用。
请求向下转化,结果向上返回
以应用读文件为例,应用或库接口表达“从这个对象读多少字节”;系统调用与通用接口进入操作系统,检查参数和访问资格,找到请求对象;文件系统和其他相关服务定位所需内容,并可能使用缓存。若需要设备操作,驱动将通用需求转换为具体命令,控制器与设备执行后,上层再取得完成结果。
这个模型里的主要职责可按下表理解:
| 层次 | 负责回答的问题 |
|---|---|
| 应用、库接口 | 程序需要什么操作,怎样使用返回结果 |
| 系统调用、通用接口 | 请求是否允许,参数和对象如何解释 |
| 设备无关服务 | 如何命名、保护、排队、缓冲与协调共享 |
| 设备相关驱动 | 该设备接受什么命令,状态与错误如何处理 |
| 控制器、设备 | 如何实际操作和传输 |
共性服务为什么不能都塞进驱动
多个请求竞争一台设备,需要排队;设备速度与程序速度不匹配,需要缓冲;多个进程访问同一对象,需要保护与协调。若每个驱动各自随意实现全部规则,系统很难提供一致接口,也容易重复工作。
因此上层提供通用管理,驱动仍处理硬件特有的命令、状态与恢复。错误也可能跨层传播:驱动识别某种设备失败,上层把它转成读操作错误,应用才决定重试或退出。Linux中VFS就是通用文件接口与具体文件系统之间的一种抽象,见Linux VFS文档。
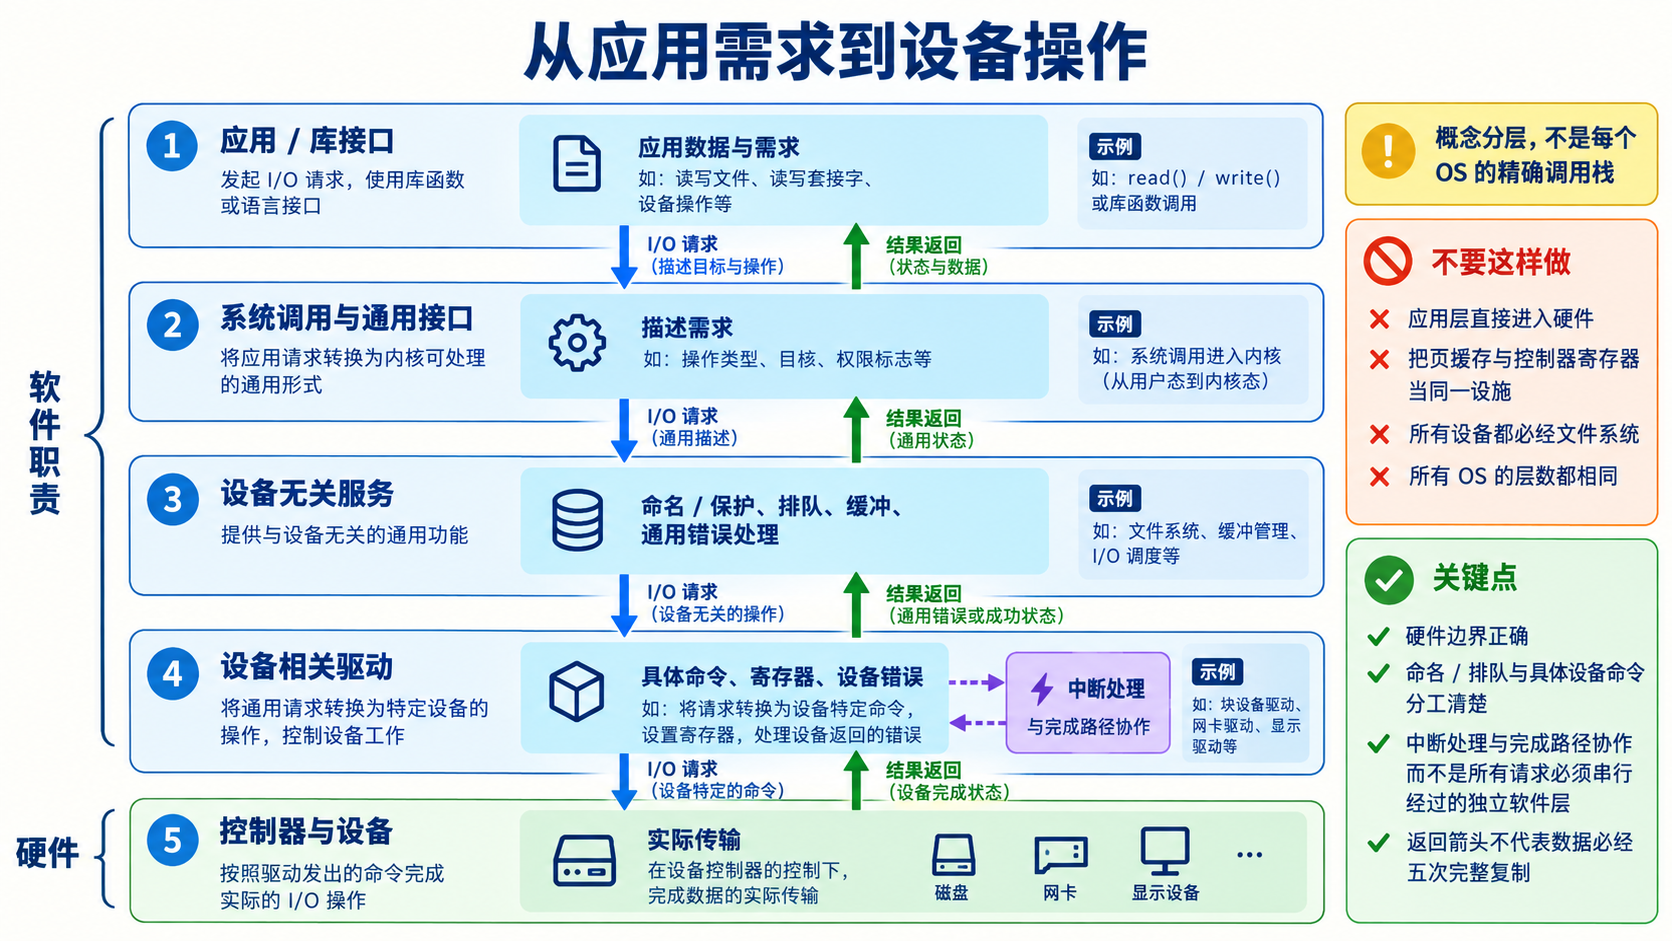
沿请求与返回两个方向展示职责,不把每层都画成一次数据复制。
分层是概念模型。读命中缓存可能不进入设备驱动,网络或其他设备路径也不一定先经过文件系统。中断处理与完成路径合作,并非所有请求都要按顺序经过一个额外的“中断层”。返回箭头代表结果传递,也不意味着数据在每层都完整复制一遍。
面试回答
I/O可按应用与库、系统调用及通用接口、设备无关服务、驱动、控制器与设备划分职责。上层表达需求并检查访问,通用服务负责命名、保护、排队、缓冲和共享,驱动处理具体命令与错误,硬件执行实际操作。分层让公共能力复用、设备差异封装,但它不是所有OS相同的精确调用栈;缓存命中可能不访问硬件,也不是所有设备都经过文件系统。
3. 中断处理的一般过程是什么?
中断让CPU在设备等事件需要处理时进入相应处理流程,不必一直循环询问设备。CPU响应时保护必要执行状态、进入内核识别和处理事件,随后恢复执行或进入允许的调度路径;设备完成并不意味着等待进程立即运行。
等待设备期间,CPU可以做别的工作
假设进程P发起阻塞磁盘读,数据尚未准备好,P进入等待状态。调度器让CPU运行Q,设备同时执行读请求。这里设备工作与Q运行可以重叠,CPU并不是一直原地等磁盘。
设备完成后产生通知,经中断控制机制送达CPU。在响应条件满足时,CPU转入内核,保护Q继续执行所需的现场,例如有关寄存器与返回位置。内核识别事件来源,调用相关处理逻辑,检查设备状态并进行必要确认或应答。
完成请求与调度进程是两件事
处理程序根据状态完成请求,必要工作可以延后;P获得结果条件后,从等待变成就绪。这表示它可以被调度,不是已经占用CPU。中断返回可以继续执行Q;在之后的合适调度点,调度器才可能选择P,P恢复后使用读取结果。
所以“设备完成→P就绪→P运行”是三个不同阶段。也存在中断返回前进行调度检查的实现,但不能把每次中断必然切换到被唤醒进程当成规则。Linux中断的通用框架见Linux IRQ文档。
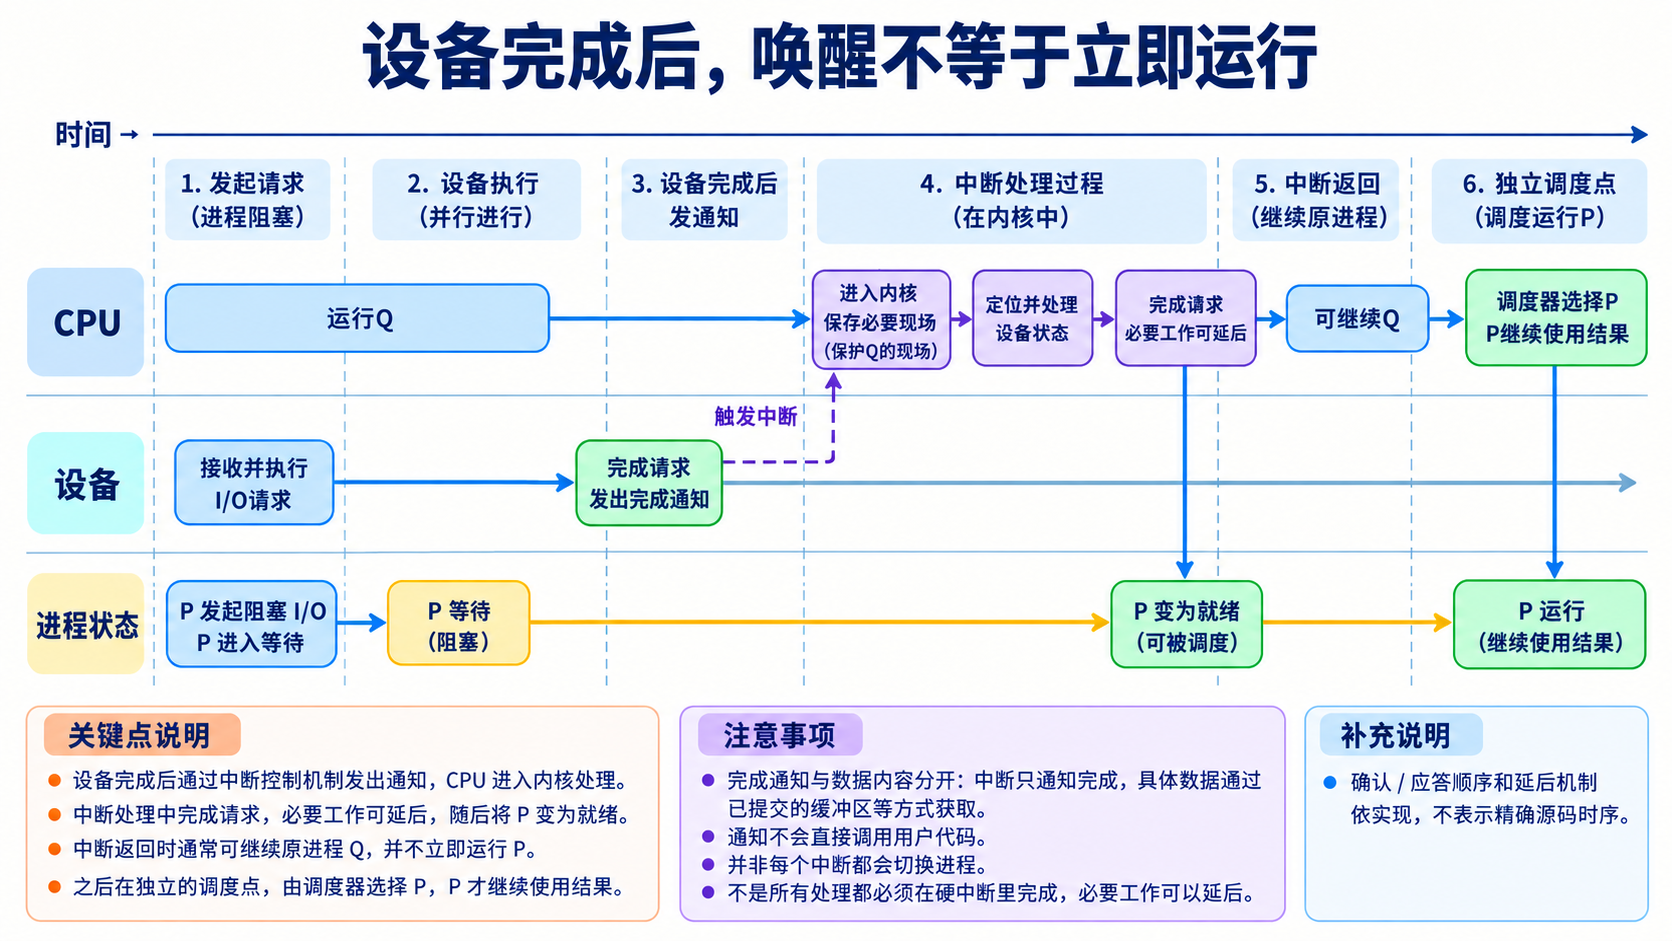
用CPU、设备与进程状态泳道跟踪P等待、Q执行和P后续恢复。
短处理与延后工作各有位置
中断上下文有特殊约束,不能随意按普通线程方式阻塞。内核常把需要快速完成的确认、状态收集与可延后工作分开,具体使用什么机制取决于系统。屏蔽、优先级、共享中断等也影响处理;确认和读取状态的精确顺序依设备协议,不宜把教学步骤当成所有硬件唯一源码时序。
设备中断不会直接调用应用的普通用户函数。数据搬运是否已经通过DMA完成,则是另一个维度,不能把“有中断”理解成“所有字节由中断处理函数搬运”。
面试回答
设备中断通知CPU处理事件,CPU响应时保存必要现场并进入内核,识别来源、处理状态和必要应答,完成请求或安排延后工作,再恢复执行或检查调度。等待I/O的进程被唤醒只是变为就绪,是否立即运行由调度决定;一次中断不必发生进程切换。确认顺序和处理拆分依实现,中断也不是直接执行用户回调或必然搬运全部数据。
4. 常见 I/O 控制方式有哪些?DMA 如何降低 CPU 负担?
教材常介绍程序查询、中断驱动、DMA和I/O通道。理解时要拆成两个问题:“怎样知道设备状态”和“谁搬数据”。轮询与中断主要回答通知方式,CPU搬运与DMA主要回答数据路径,实际可以组合。
不忙等与不逐字搬运不是同一收益
程序查询的典型教学组合是CPU反复检查状态,设备就绪后由CPU经设备接口搬数据。这类由CPU指令承担的设备数据搬运常称PIO(Programmed I/O)。它简单,但等待期间持续占用CPU;不过实际轮询也可用于特定低延迟或批处理场景,不能断言轮询永远错误。
中断驱动的CPU搬运组合,允许发请求后先做其他工作,设备通知后CPU再处理传输。它减少持续询问,却并不自动减少每个字节由CPU读写接口的工作。
DMA(Direct Memory Access,直接内存访问)让设备或控制器侧能力在设备与RAM之间完成传输,CPU不必执行每个数据单位的搬运指令。完成可以用中断,也可以按设备与软件设计采用轮询。历史I/O通道则是能执行I/O控制程序的专用处理机制,比单纯搬运承担更多控制职责,不等同于普通驱动函数。基本区别见OSTEP:I/O设备。
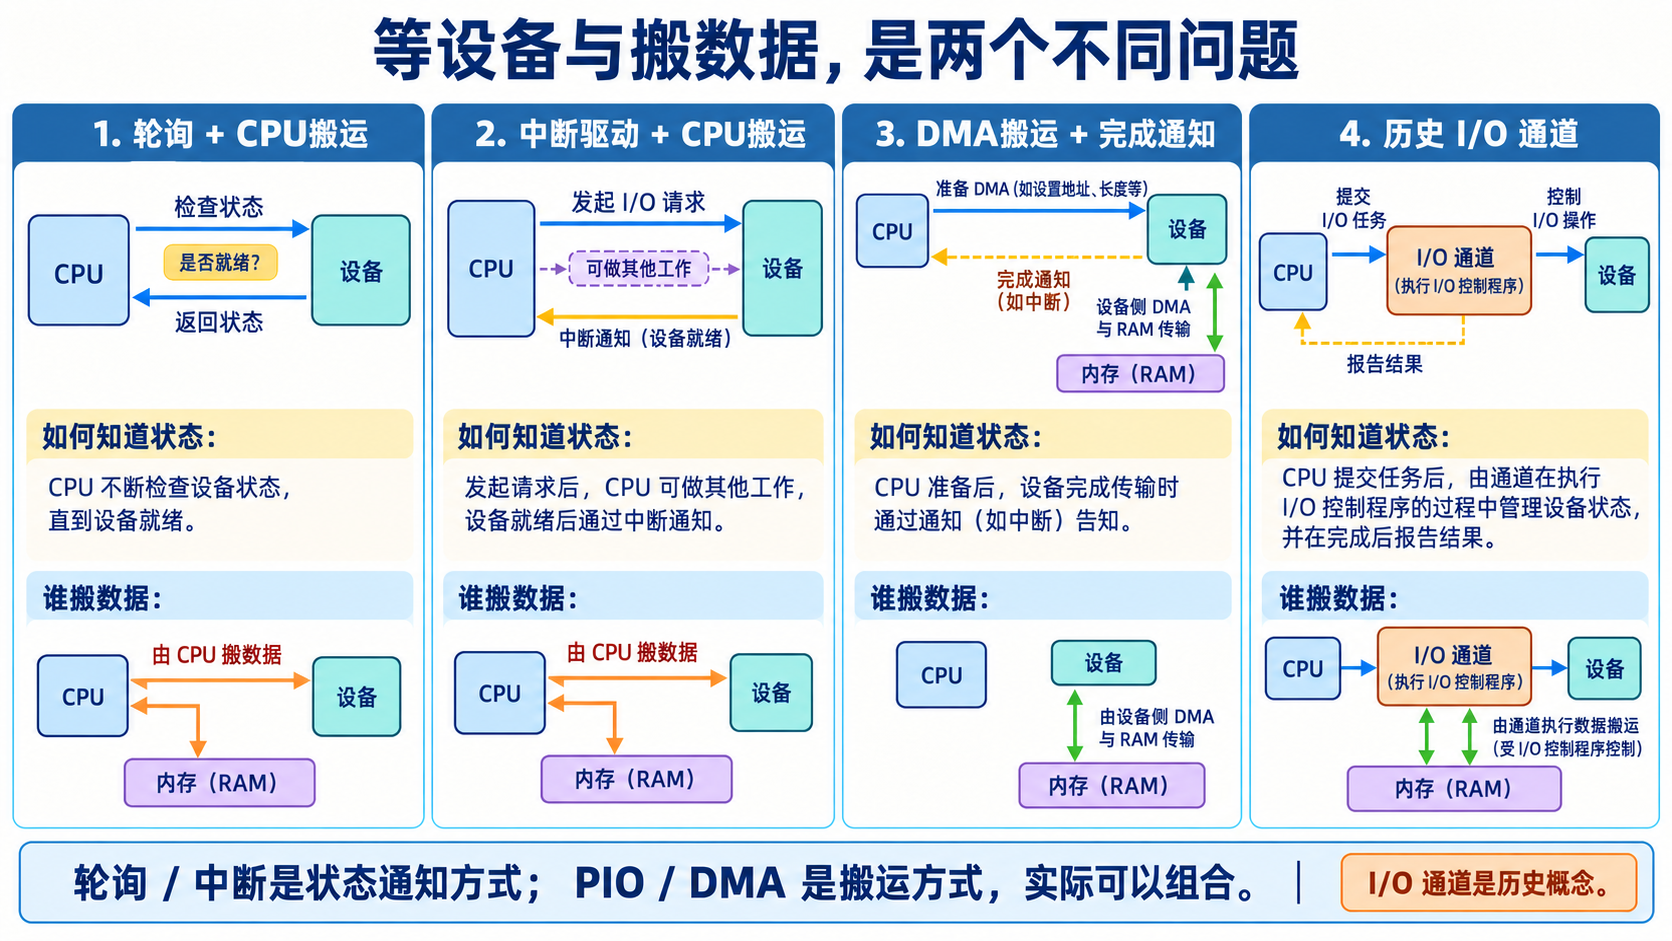
按通知和搬运两条轴展示常见组合,另列历史通道。
跟踪一次DMA读到内核缓冲
CPU执行驱动,先准备可用于DMA的RAM缓冲,建立设备需要的映射,设置描述符、地址、长度和方向,再启动传输。设备按约定将数据写入缓冲,主数据流不需要先经过CPU寄存器逐字中转。
传输完成后,驱动仍要获知状态、检查错误、进行平台与映射要求的同步或收尾,并把结果交给上层。缓冲在设备使用期间不能随意释放或重用,否则设备可能写到错误对象。这解释了DMA减少什么:主要减少持续参与搬运的CPU指令,不是减少CPU管理责任到零。
设备使用的DMA地址也不是应用随意给出的虚拟指针。有的平台经IOMMU映射,有的平台存在其他地址关系;应使用平台DMA接口。DMA不经CPU的普通虚拟地址转换路径,不能直接拿进程页表图替代设备地址映射。地址与同步边界见Linux DMA指南。
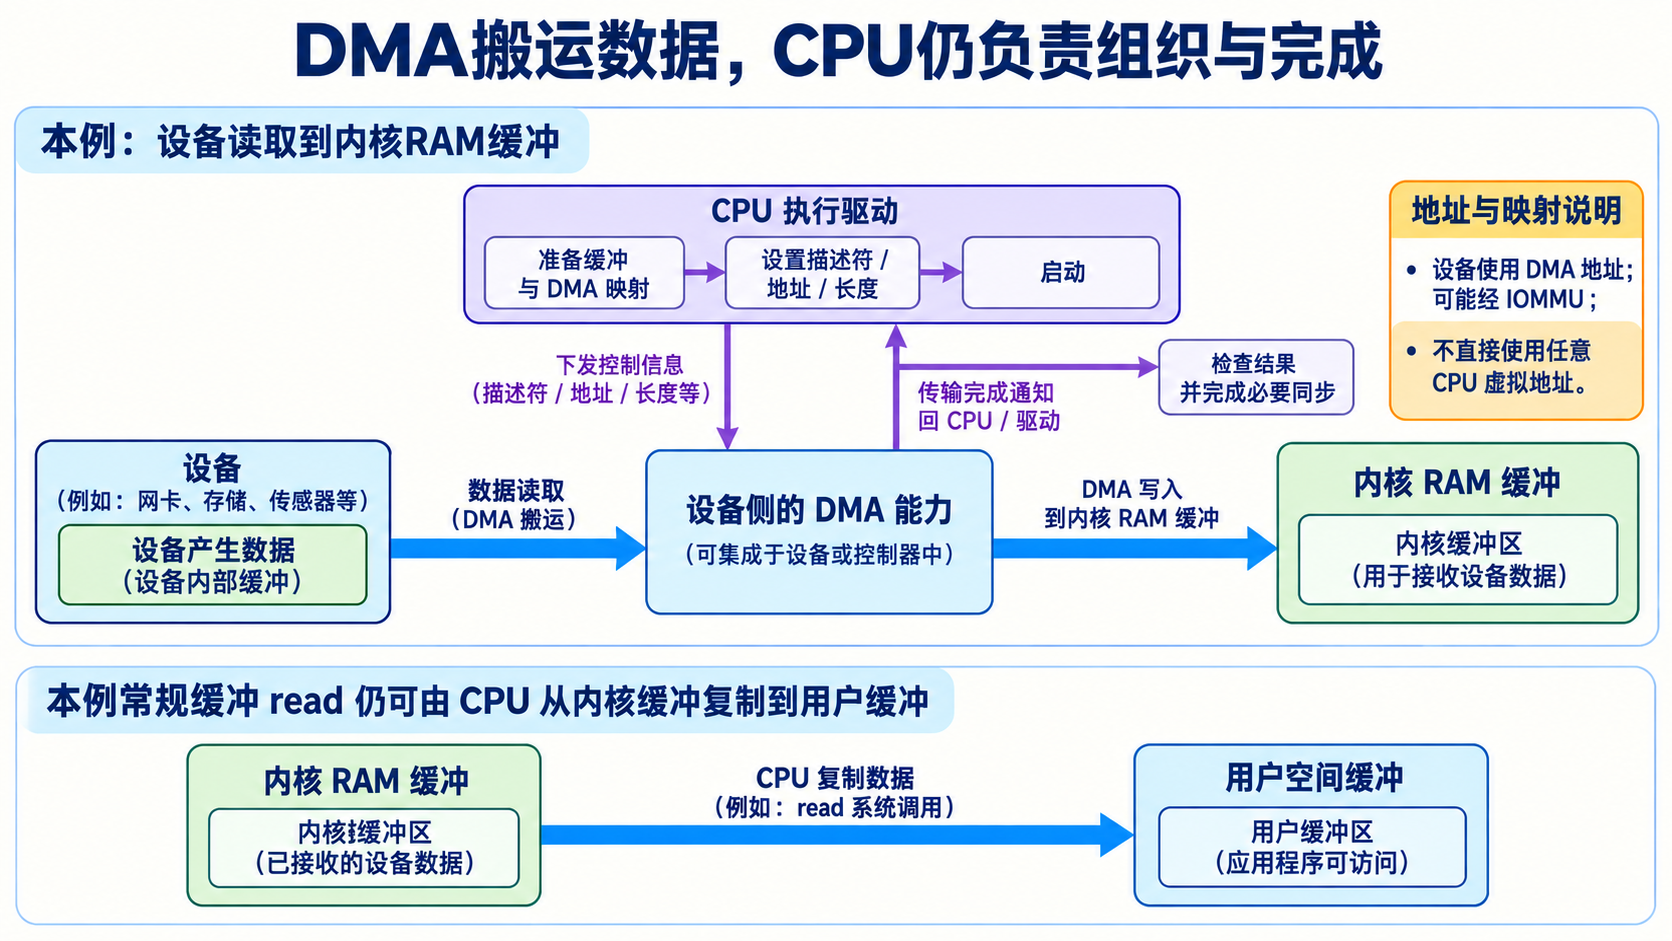
用粗线画设备到RAM的数据,用细线画CPU控制与完成处理。
DMA为什么不自动等于零拷贝
如果读的是常规缓冲文件,DMA可能只负责设备到内核RAM缓冲,随后CPU仍把内容复制给用户缓冲。DMA也不自动解决所有平台的缓存一致性问题。减轻搬运、减少忙等、减少内存复制是不同优化,不能仅凭“用了DMA”就宣称全都实现,或给出固定性能倍数。
面试回答
常见教材方式有程序查询、中断驱动、DMA及历史I/O通道。轮询和中断解决状态通知,PIO或DMA解决谁搬数据,两者可以组合。DMA让设备侧能力与RAM传输,减少CPU逐数据单位搬运;CPU仍需准备缓冲和映射、设置命令、处理完成及同步。设备地址不等于任意CPU虚拟指针,常规读取还可能复制到用户缓冲,所以DMA不自动代表零CPU或零拷贝。
5. 单缓冲、双缓冲和环形缓冲有什么区别?
缓冲在数据生产者与消费者之间暂存内容,缓解速度和处理粒度不匹配。单缓冲只有一份可用暂存区,双缓冲可交替使用两份,环形缓冲则用多个槽位构成循环队列。可重叠多少,取决于占用规则与生产、消费速度。
用明确占用条件比较三块数据
假设每块设备I/O用2 ms,CPU处理用3 ms;处理期间独占对应缓冲,忽略复制和协调成本。单缓冲填完才能处理,处理完才能覆写:第一块填0~2、处理2~5,第二块填5~7、处理7~10,第三块填10~12、处理12~15,总计15 ms。
双缓冲A、B交替:A填块1在0~2,CPU处理2~5;此时B可在2~4填块2。4 ms时A仍在处理,B已有未消费内容,两缓冲都不能覆写,所以设备等待4~5。
5 ms时CPU开始处理B,持续到8;A已空闲,在5~7填块3,等到8才由CPU处理,持续到11。三块在11 ms完成,而不是7.5 ms。CPU处理段不重叠,设备仍有等待。
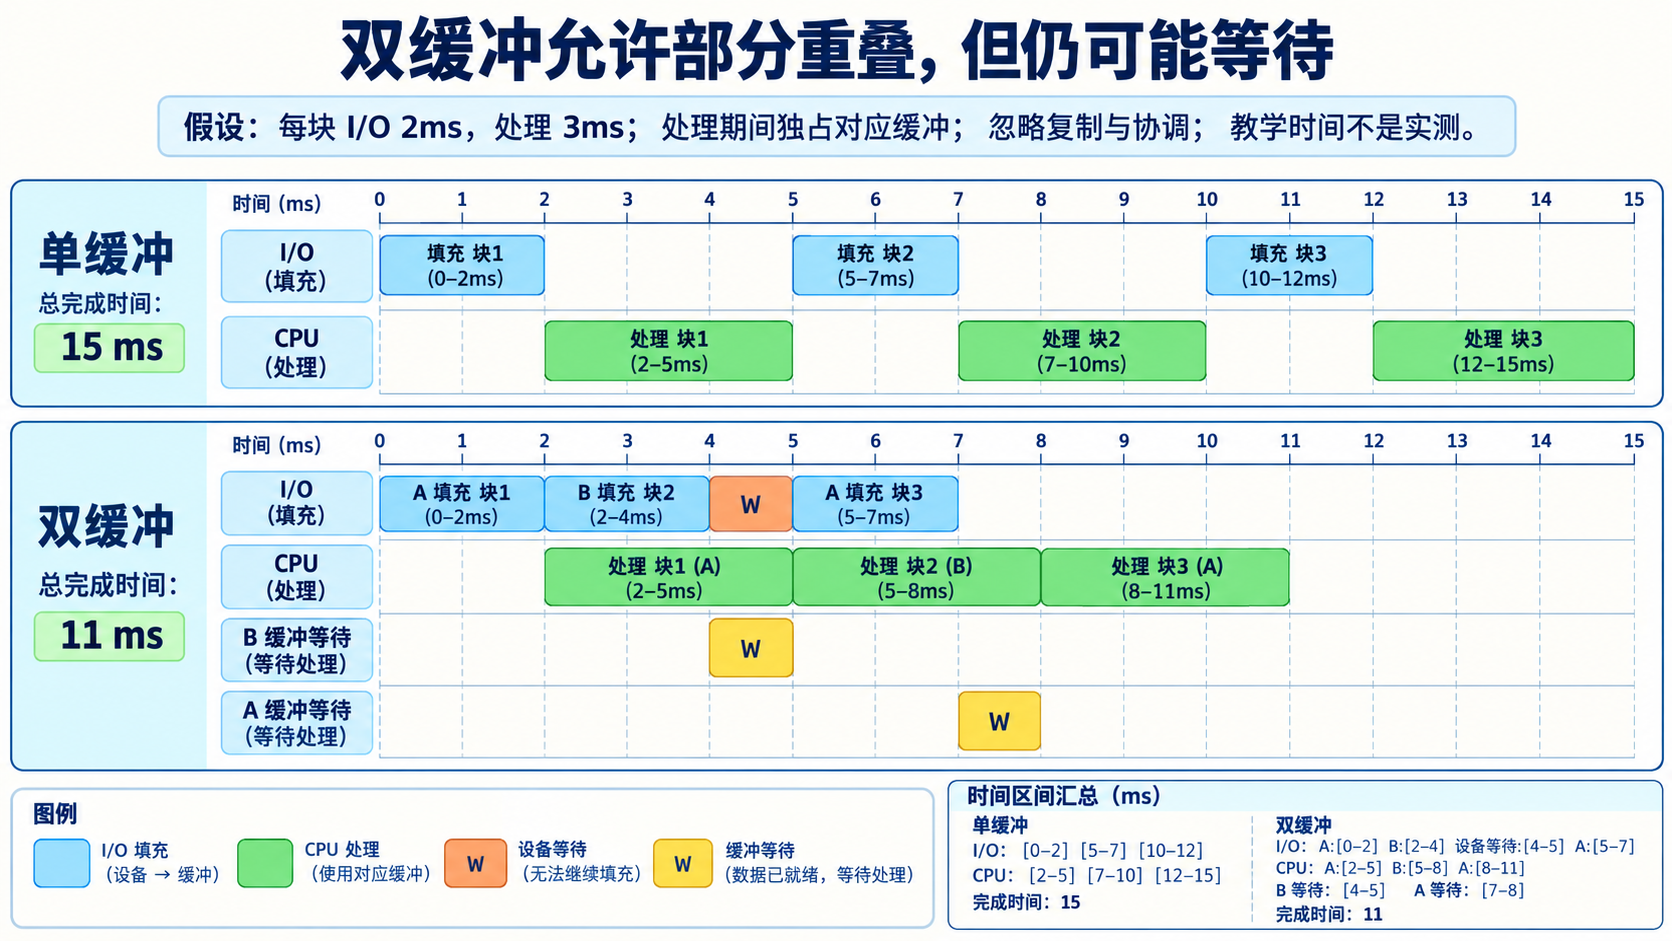
按同一0~15 ms尺度检查I/O、处理与缓冲占用。
这个结果只属于上述独占模型。如果单缓冲读满后立即复制到其他区域,原缓冲可较早释放,重叠情况会不同。双缓冲也不保证两倍性能:长期吞吐受更慢阶段约束,缓冲只暂时吸收速度差,不会让慢消费者凭空加速。
多个槽位怎样循环使用
设环形缓冲有4槽,索引0~3,head指下一读取位置,tail指下一写入位置,另存count。初始槽1为B、槽2为C,其余空,head=1、tail=3、count=2。
生产D写入槽3,tail按取模回到0,count增为3;消费B读槽1,head移到2,count减为2。剩余队列顺序是C、D,回绕改变的是位置索引,不是把内容再复制一遍。
本例count=0为空,count=4为满,满时生产者等待,不能覆写未读数据。只看head等于tail可能区分不了空与满,所以还需count、保留空槽或其他约定;不同设计不能混用容量规则。
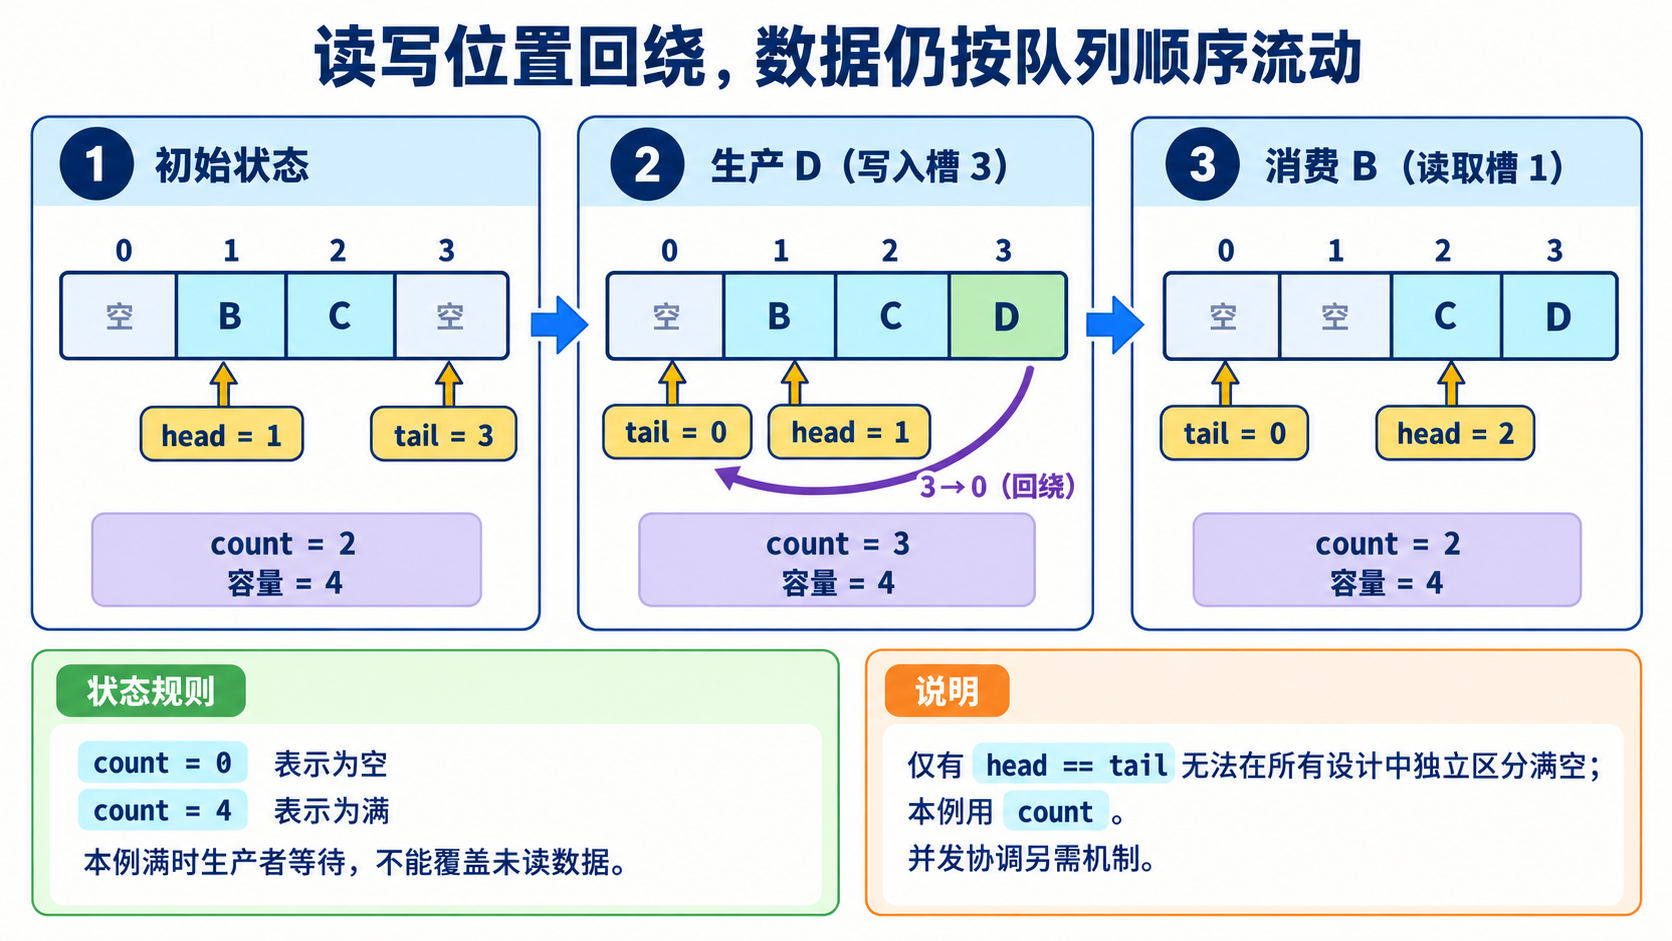
对齐三个状态的槽内容、head、tail与count。
数据结构还需要并发协调
环形数组不自动线程安全。若生产与消费并发执行,槽内容可见性、索引更新、等待和唤醒需要正确同步;锁、信号量或满足条件的原子协议都是可能方案。用有界队列协调生产消费的原理见OSTEP:信号量。本题不提供有竞争的代码,也不把上述顺序推演冒充并发实测。
面试回答
单缓冲用一个暂存区,双缓冲用两个交替,允许生产和处理部分重叠,但慢阶段仍限制吞吐,不保证两倍性能。环形缓冲用多槽队列和回绕索引,通常明确head下一读、tail下一写,并用计数或其他规则区分满空。满时等待还是丢弃要由策略规定,不能默认覆写未读数据。缓冲占用决定能否重用,并发读写还需同步,环形结构本身不提供线程安全。
6. 什么是假脱机技术?
假脱机技术将任务先保存到中间存储和队列,再由后台服务按规则使用设备,避免每个应用都长期直接占用设备。英文常写作SPOOLing,打印队列是典型例子;它把任务提交与实际设备执行分开。
应用提交完,不必等打印机一直忙完
假设三个应用提交打印任务101、102、103,而实际只有一台打印机。直接让各应用控制设备,会遇到争用,也可能让应用一直等待纸张输出。
假脱机服务先接收任务内容及必要设置,保存为可供后台处理的任务,并记录状态。应用收到“已接收”后可以做其他工作,后台再选择队列里的任务,按打印机协议发送。这里必须先满足系统约定的接收条件,不能仅把一段指针放队列就承诺内容以后一定存在。
队列共享的是使用机会,不是复制设备
按本例FIFO策略,101先打印,102、103等待。101成功后更新状态,再处理102;设备故障时,任务可以进入错误或暂停状态,由实现决定重试和人工处理。不能把第一次提交成功解释成已经打印,更不能假设失败后全部任务自动消失。
多个应用在逻辑上都能提交打印需求,但同一时刻仍只有一台设备的输出能力。队列可以吸收短期提交峰值,持续提交速度超过打印速度时,积压仍会增长,因此需要空间和配额管理。CUPS作为现实打印系统的职责说明见CUPS概览,本例FIFO不是所有打印系统的固定策略。
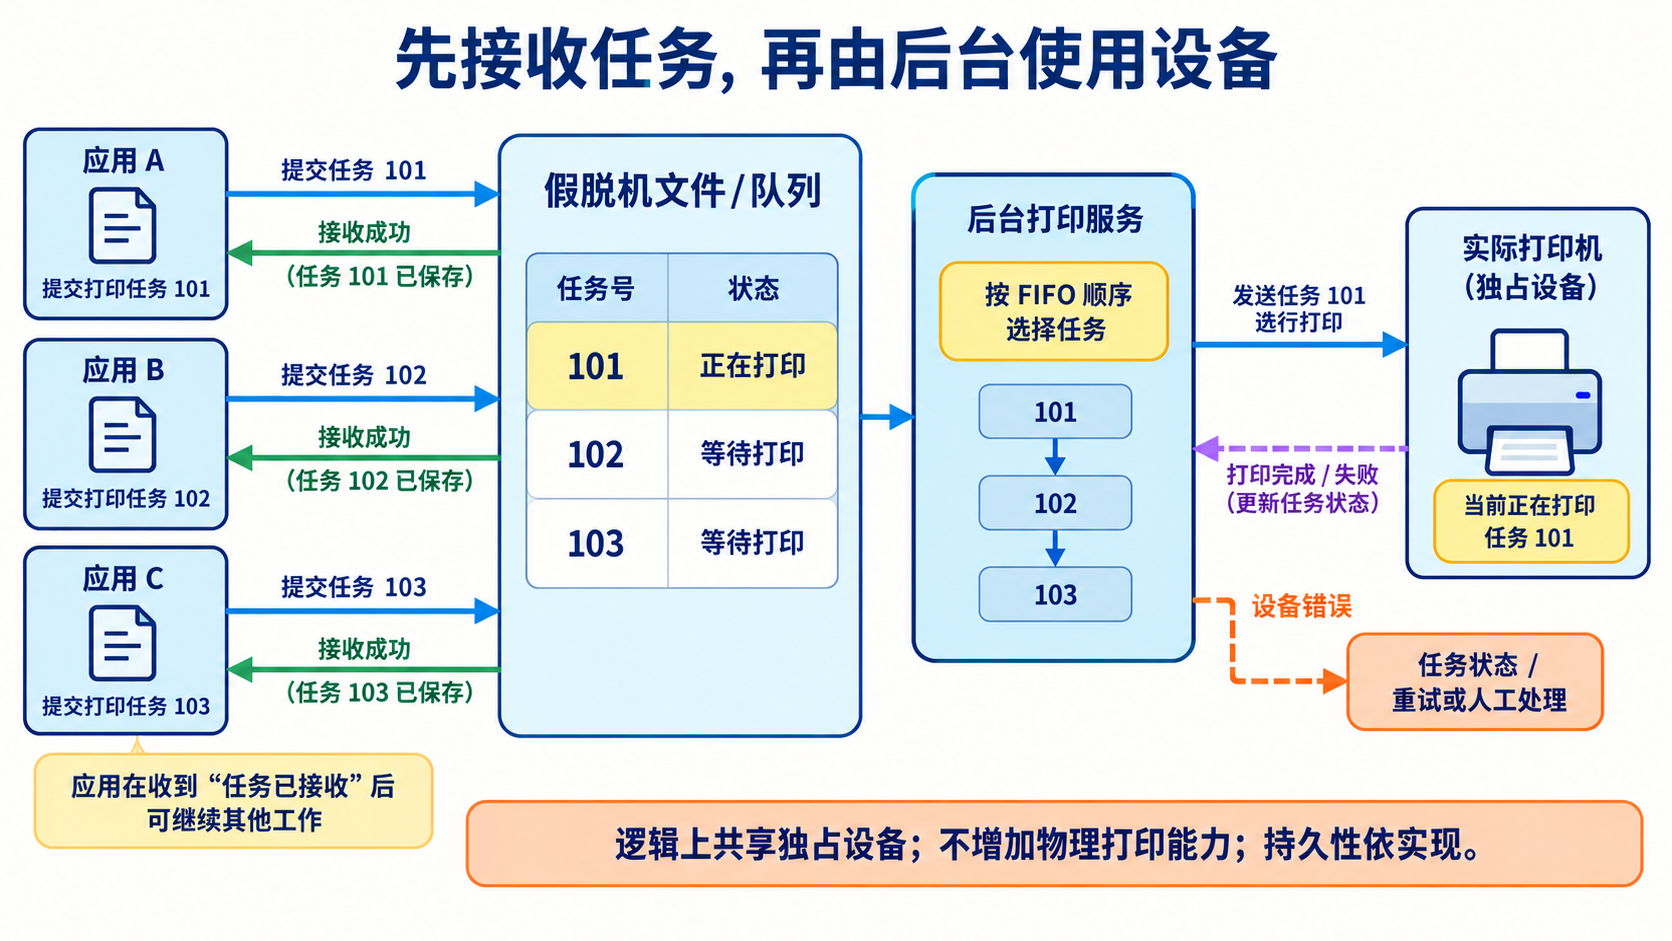
分开任务接收回执与后续打印完成、失败状态。
它为什么不等于普通缓冲
普通缓冲可以只是暂存几块数据,假脱机还组织可独立管理的任务,并由后台调度共享独占设备。它需要处理任务身份、内容、顺序和状态,不能把所有缓存都叫假脱机。
任务能否跨重启保留,取决于是否可靠持久保存及恢复机制;是否允许取消、插队和重试也依实现。权限控制防止查看或操作别人的任务,失败处理避免重复打印或静默丢失。假脱机方便应用与设备解耦,但不自动提供无限队列、绝对持久性或更多物理设备。
面试回答
假脱机先接收并保存任务,通过队列交给后台服务按规则使用设备,典型是多个应用向一台打印机提交任务。应用获得接收回执后可以继续,后台完成后另行更新状态,因此接收成功不等于打印完成。它组织任务和设备共享,不只是普通数据缓冲,也不会增加物理输出能力。顺序、权限、持久性、重试和空间限制都取决于具体实现。
7. 操作系统中的时钟和定时器有什么作用?
时钟帮助系统知道当前时间或经过了多久;定时器让系统在约定时间到达时处理事件。它们服务于时间记录、等待超时、任务唤醒和调度等需求,但“截止时间到了”不等于“用户任务已经执行”。
读取时间与通知到期各有职责
计时系统需要可读取的时间基础,Linux称相关计数设施为时钟源。操作系统利用它获得时间与计算间隔;产生到期通知的事件设施则让CPU知道某个截止时间需要处理。读取一次时间不要求每次都产生一次中断。
定时器由系统组织截止时间和回调或等待条件,硬件事件触发后,内核判断哪些任务到期,再执行相应处理。实现可以采用周期事件,也可以根据下一截止时间设置事件;高精度和动态节拍设计见Linux高精度定时器文档。不能一概说所有机器固定每1 ms中断一次。
等待50 ms,只说明什么时候具备继续条件
独立教学时间线中,单调时间现在为100 ms,线程请求等待50 ms,截止点为150 ms。系统在到期或稍后处理定时事件,把等待线程变为就绪;假设CPU有其他工作,到158 ms调度器才选择它运行。
于是100+50=150是截止时间,而158是本例假设的实际恢复点。两者之间可能有事件处理延迟与调度等待。定时器回调运行的上下文也不等于等待用户线程已经运行,具体处理由接口决定。等待接口对恢复时机的说明见Linux nanosleep手册。

把计时读取、到期通知、变为就绪和调度运行分别定位。
选择时间基础,要看问题是什么
墙上时间表示日期和时刻,用于日志日历时间等,可受校时调整;单调时间适合测量相应的经过间隔,避免日历时间调整导致简单差值异常。也不能说所有单调时钟都把系统休眠时间算进去:Linux的MONOTONIC与BOOTTIME对此不同,见Linux时间读取文档。
系统还用时间支持计费、超时回收和调度判断。需要严格实时保证时,必须额外分析平台、负载与调度条件,不能仅靠普通定时器的“精度”推出用户线程必在截止点运行。本题所有数字只是推演,没有执行真实睡眠或测量延迟。
面试回答
时钟提供时间和间隔读取,定时器在截止时间到达时触发处理,用于等待、超时、唤醒和调度等。读取时间、处理到期事件和运行用户线程是不同职责;到期后线程可能只变就绪,仍需等待调度。墙上时间适合日历记录,单调时间适合相应间隔,但是否包含休眠取决于具体时钟。实现可有动态事件,不保证固定1 ms节拍或精确到点运行。
阅读导航



