
进程、线程与并发控制校招面试题|操作系统
进程、线程与并发控制校招面试题|操作系统
操作系统需要把有限的 CPU 时间分配给许多程序,还要保证它们既能协作,又不会随意破坏彼此的数据。本章依次介绍进程和线程的组织方式、通信方式、调度方法以及同步和死锁问题。
1. 什么是进程?程序和进程有什么联系?
程序是静态的,进程是动态的。
程序通常是存放在磁盘上的可执行代码和相关数据,它本身只是描述“要完成什么操作”,在没有运行之前,不存在当前执行位置、运行状态等信息。
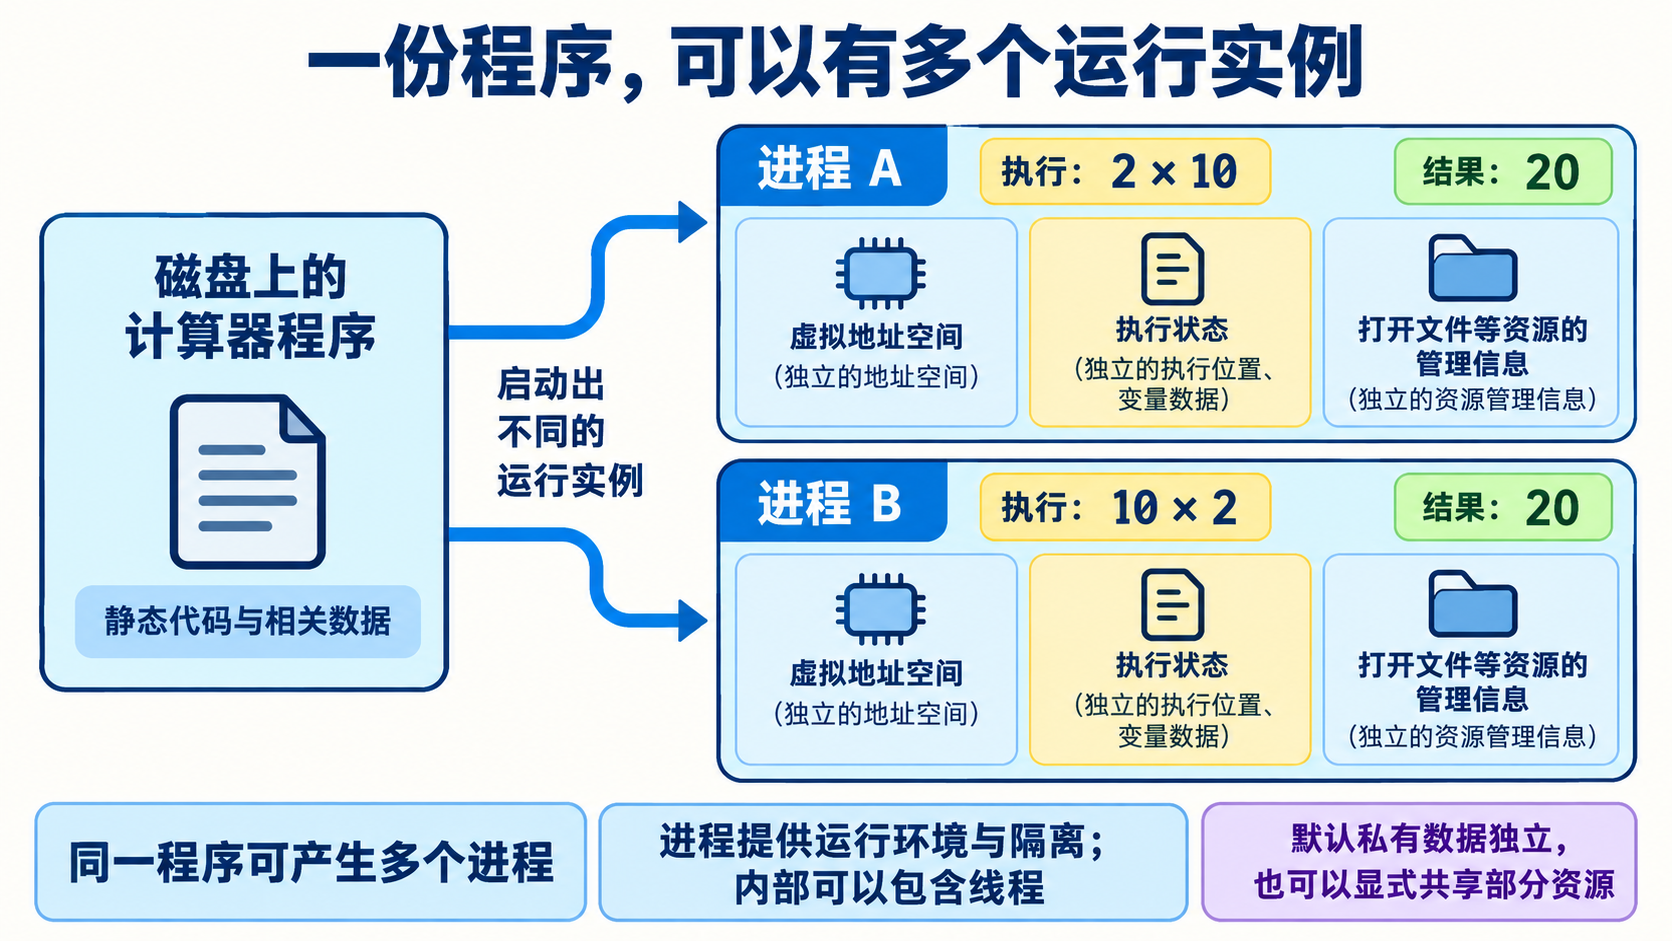
当程序被加载并开始执行后,操作系统会为这次运行创建相应的运行环境,包括虚拟地址空间、执行状态以及打开的文件等资源,这个运行中的实例就称为进程(Process)。
例如,磁盘上只有一份计算器程序,但是可以同时启动两次:
计算器程序
   │
   ├── 进程 A:计算 2 × 10
   │
   └── 进程 B:计算 10 × 2
两个进程执行的程序代码可能,但它们拥有各自独立的运行状态和资源,例如各自的虚拟地址空间、变量数据和打开的文件,因此其中一个进程修改自己的普通变量,通常不会直接影响另一个进程。
从操作系统角度来看,一个进程通常包含:
- 虚拟地址空间:代码、数据、堆、栈以及内存映射等;
- 执行状态:进程当前处于运行、就绪、睡眠等状态;
- 内核管理信息:进程 ID、调度信息、权限等;
- 相关资源:例如打开的文件、Socket 等。
需要注意的是,程序和进程并不是一一对应的关系。
同一个程序可以同时产生多个进程,例如同时打开多个程序实例;而一个应用程序也可能由多个进程共同组成,例如现代浏览器通常包含浏览器主进程、渲染进程等多个进程。
另外,一个进程内部还可以包含多个线程。进程主要承担资源管理和隔离的作用,而线程通常是实际执行和调度的重要单位。
面试回答
程序是存放在磁盘上的静态代码和数据,而进程是程序的一次动态运行实例。
当程序运行时,操作系统会为它建立虚拟地址空间,并维护运行状态、打开文件等资源。同一个程序可以同时运行多次,从而产生多个进程。这些进程虽然执行相同的代码,但通常拥有彼此独立的地址空间和运行状态。
因此可以简单理解为:程序描述“要做什么”,进程表示“程序的一次具体运行”。进程也是操作系统进行资源管理和隔离的重要单位,而一个进程内部还可以包含多个线程。
2. 什么是 PCB?PCB 中保存了哪些信息?
进程运行到一半被暂停后,之后还能从原来的位置继续执行,是因为操作系统保存了管理和恢复这个进程所需要的信息。教材通常把这些信息抽象为 PCB(Process Control Block,进程控制块)。
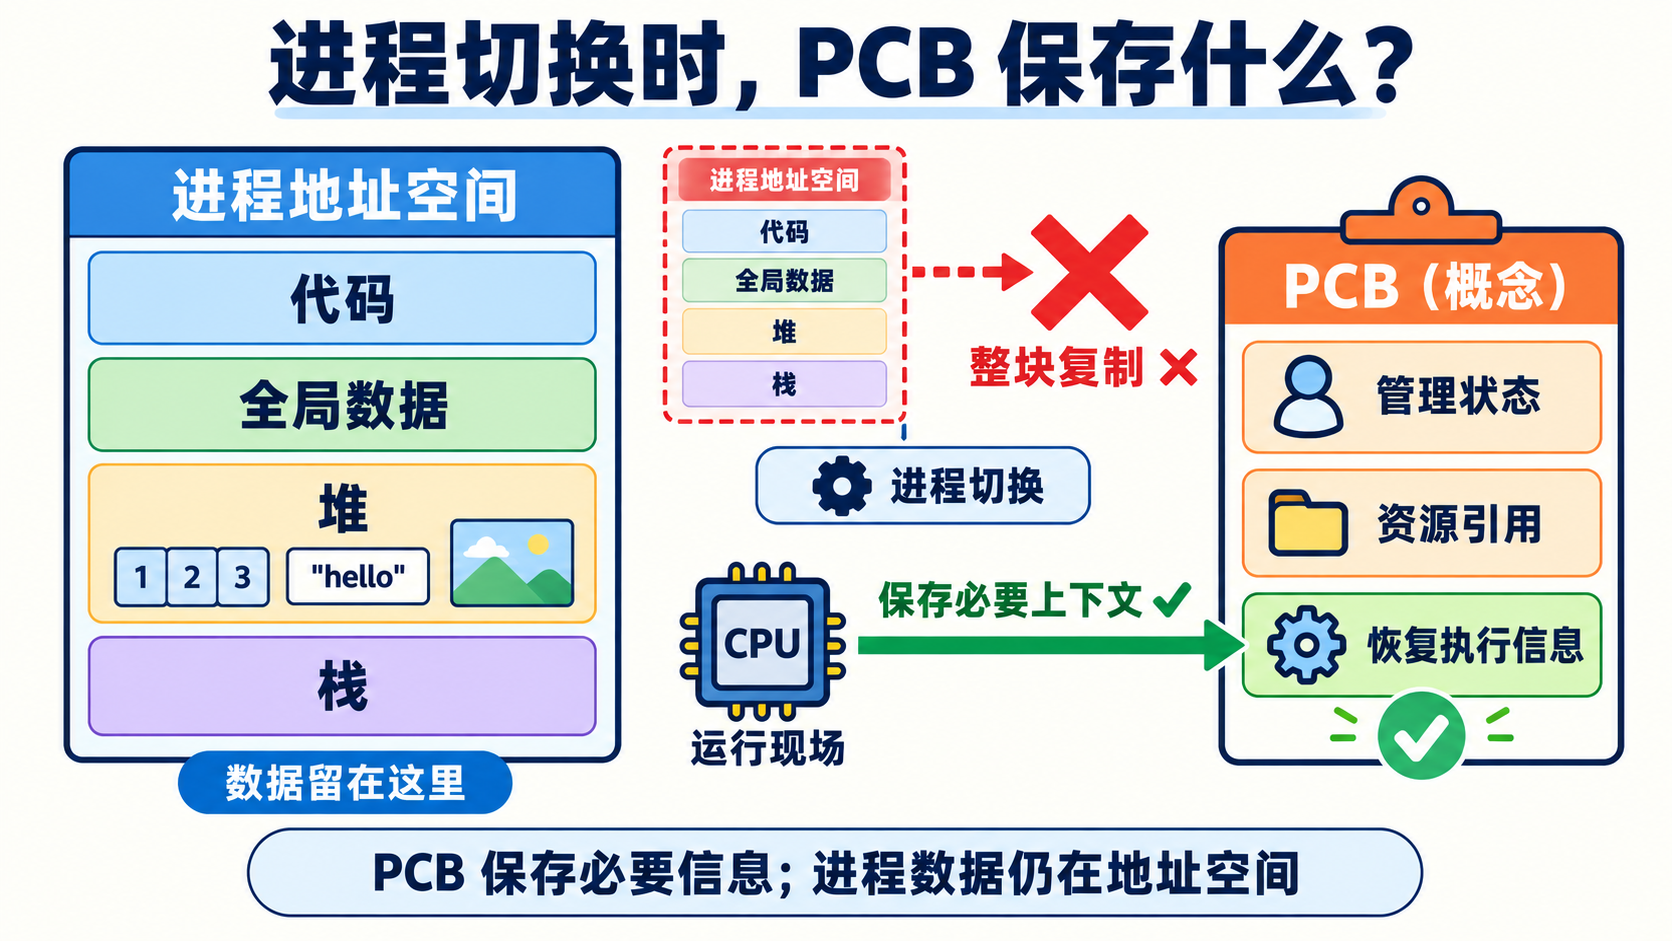
PCB 是操作系统用于描述和管理进程的数据结构,可以理解为进程在内核中的“管理档案”。
PCB 中通常包含以下几类信息:
进程标识信息
例如进程 ID、父进程信息等,用于区分不同进程以及维护进程之间的关系。
进程状态和调度信息
记录进程当前是运行、就绪还是等待状态,以及优先级、调度相关数据等,供操作系统进行进程调度。
CPU 执行现场
包括恢复执行所需要的程序计数器、栈指针以及相关寄存器状态。
例如一个进程执行到:第 50 条指令,被调度出去
操作系统需要保存必要的 CPU 上下文。当这个进程以后重新获得 CPU 时,再恢复这些状态,使它能够从原来的执行位置继续运行。
资源和管理信息
例如与进程地址空间、打开文件、权限凭据等相关的信息或引用,帮助内核找到和管理这个进程所拥有或使用的资源。
需要注意,PCB 并不是进程所有数据的完整副本。
例如进程中的数组、字符串、图片等业务数据仍然存放在进程的地址空间中。发生进程切换时,并不会把整个地址空间复制到 PCB,而是保存进程管理和恢复执行所需的必要信息。
可以简单理解为:
在 Linux 中,教材里的 PCB 并不严格对应某一个单独的数据结构。Linux 使用 task_struct 作为核心的任务描述结构,并结合内核栈以及其他关联结构共同维护任务的状态、调度信息、地址空间和打开文件等信息。
另外,Linux 的 task_struct 更准确地说描述的是一个 task,线程也有自己的 task_struct。同一进程中的多个线程可以共享地址空间、打开文件等部分资源,同时又各自拥有自己的执行状态。
面试回答
PCB,也就是进程控制块,是操作系统用来描述和管理进程的数据结构,可以理解为进程在内核中的管理档案。
它通常保存进程标识、进程状态、调度信息、CPU 执行现场,以及地址空间、打开文件等资源的相关管理信息。这样当一个进程被暂停以后,操作系统之后才能重新调度它,并恢复必要的执行现场,让它从原来的位置继续运行。
需要注意,PCB 并不会保存进程所有的业务数据。代码、堆、栈等仍然位于进程的地址空间中。Linux 中也不是简单用一个结构保存教材里 PCB 的全部内容,而是以 task_struct 为核心,配合其他内核数据结构共同完成这些管理工作。
3. Linux 如何创建进程?
程序保存在磁盘上时,只是一份代码和相关数据。要让它运行,操作系统需要为它建立运行环境:分配进程标识、准备内存与执行状态、记录所使用的资源,并在条件具备后安排它执行。
创建进程,就是建立这样一个可以被系统管理和调度的运行实例。 它让多个任务能够分别保存自己的状态,而不是混在同一个执行流程里。
哪些情况会触发进程创建?
常见场景有以下几种:
- 系统启动服务:启动过程中,系统会建立初始运行环境,并按配置启动日志、网络等服务进程。
- 用户启动程序:例如在终端运行外部命令,或通过桌面启动应用。不过,点击图标也可能只是激活已经运行的程序,不保证每次都创建新进程。
- 已有程序启动子任务:例如服务器创建工作进程,编辑器启动编译器,让不同任务独立执行。
- 定时或批处理任务开始执行:调度程序在时间到达、资源允许等条件满足时启动任务。这并不限于大型机,普通服务器也有这类需求。
这些是创建进程的原因,不代表四套完全独立的创建机制。例如用户输入命令后,通常仍由 Shell 等已有程序调用相应接口,请求内核创建进程。
后台进程也并非“与用户无关”:它仍有运行身份和权限,可以是系统服务,也可以是某个用户启动的后台任务。定时任务服务是后台服务的一种,但不同实现不一定都按固定的一分钟周期检查。
Linux 中,fork 怎样创建子进程?
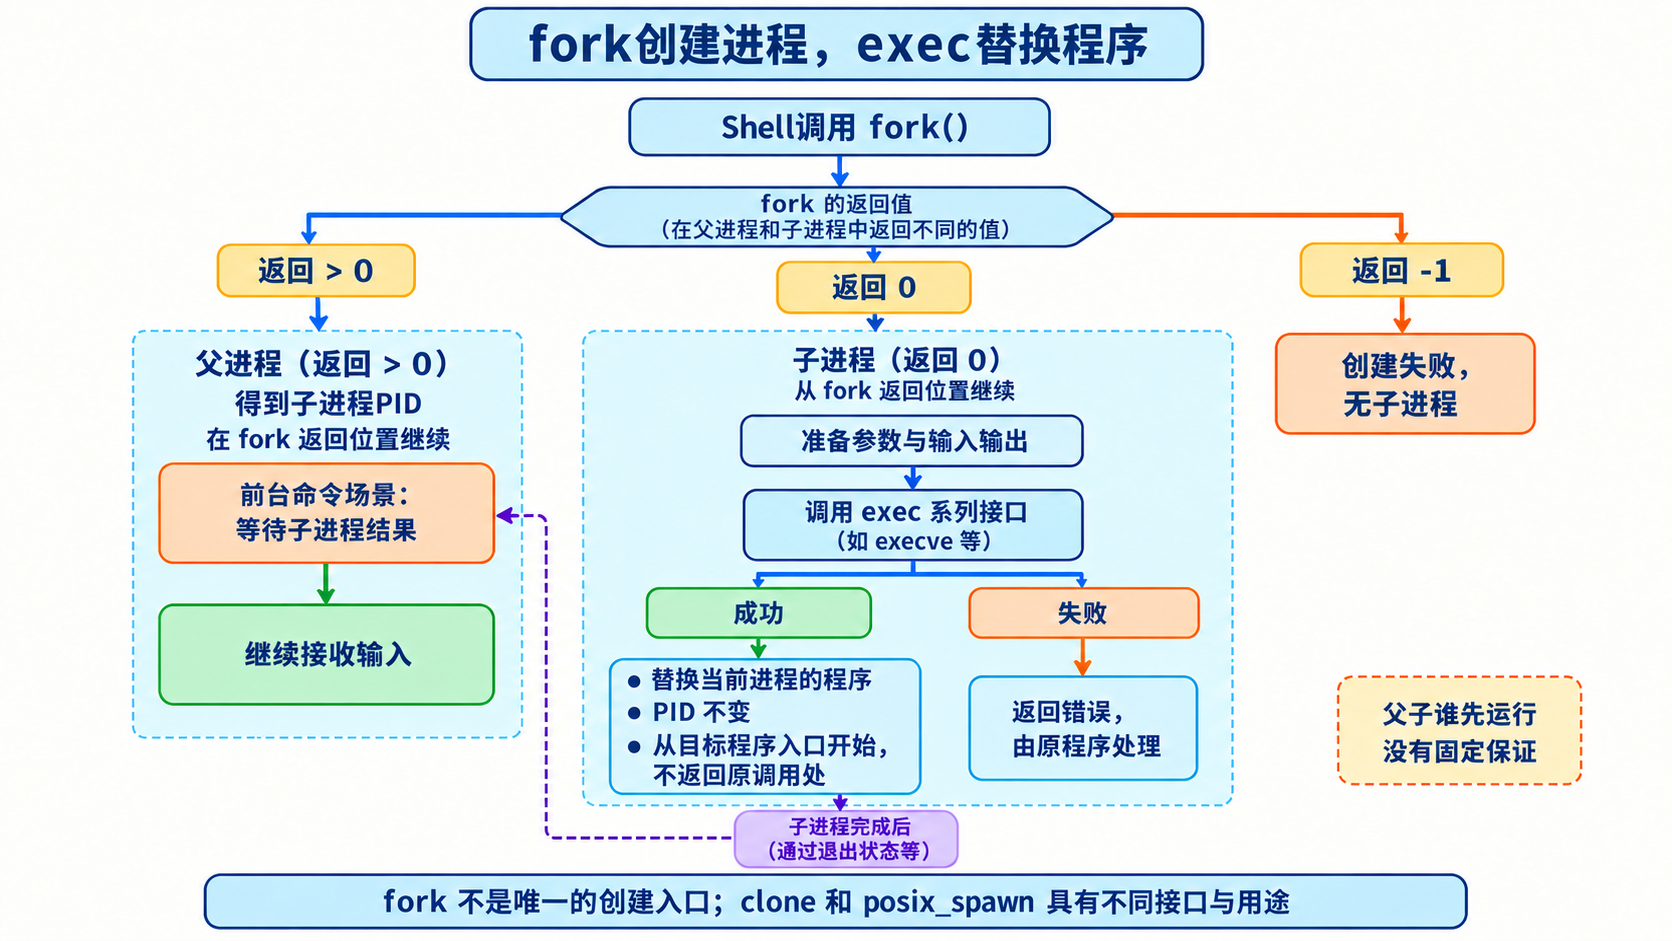
fork 是理解 Linux 进程创建的典型入口。调用它的进程是父进程,新创建的是子进程。
创建成功后,子进程拥有新的 PID,并按规则继承父进程的部分运行环境。父子都从 fork 返回的位置继续,而不是让子进程重新从程序开头运行。
系统通过不同返回值,让程序区分执行路线:
| 返回值 | 当前处于哪条路线 |
|---|---|
| 大于 0 | 父进程,返回值是子进程 PID |
| 等于 0 | 子进程 |
| 等于 -1 | 创建失败,没有子进程产生 |
例如,父进程可以进入“等待任务完成”的分支,子进程进入“执行任务”的分支。二者谁先运行没有固定保证。Linux fork 手册
创建子进程后,怎样运行另一个程序?
以 Shell 启动外部命令为例:
- Shell 调用
fork,创建子进程。 - 子进程准备参数,以及需要的输入输出设置。
- 子进程调用
exec系列接口,把原来的程序内容替换为目标程序。 - 对于前台命令,Shell 通常等待命令结束,再继续接收输入。
这里要分清:fork 创建新进程,exec 替换已有进程执行的程序。 exec 成功后 PID 不变,也不会返回原代码继续执行;失败时才返回错误。
是不是只有 fork 能创建进程?
不是。Linux 还提供 clone 等机制,控制新任务共享哪些资源;POSIX 还提供 posix_spawn 这样的创建并启动程序接口。它们所在的接口层次和适用方式不同,不能把“Unix 只有 fork 能创建进程”作为结论。clone 手册、posix_spawn 手册
面试回答
进程创建是操作系统为新的运行实例准备标识、地址空间、执行状态和资源管理信息的过程,常由系统启动、用户操作、程序创建子任务或作业调度触发。Linux 中典型方式是 fork 创建子进程,再由子进程通过 exec 执行目标程序。父子根据返回值区分执行路线,私有内存可通过写时复制减少立即复制的成本,但显式共享内存和文件资源有不同规则,fork 也不是唯一的创建接口。
4. 什么是写时复制?
写时复制(Copy-On-Write,简称 COW)是一种先共享数据,等需要修改时再按需复制的优化机制。
它主要解决的问题是:如果多方一开始使用的是同一份数据,而且大多数情况下并不会修改,那么就没有必要提前复制多份。可以先让它们共享同一份数据,只有真正需要修改时再进行复制,从而减少不必要的内存占用和数据拷贝。
Linux 的 fork 就采用了这种思路。下面以父子进程的普通私有内存为例来说明。Linux fork 手册
为什么创建子进程时不立即复制全部内存?
fork 后,子进程最初能够看到从父进程继承的数据。最直接的做法,是把相关内存内容复制一份,让父子各用各的。
但子进程可能只读取这些数据,也可能很快通过 exec 换成另一个程序。如果一开始就大量复制,很多复制工作可能白做。
因此,可以先让双方读取同一份底层数据,暂时不复制。
不过,这又带来一个问题:既然共享同一份数据,一个进程修改时,会不会把另一个进程的数据也改掉?
怎样做到先共享,但修改时互不影响?
这里需要区分两件事:
- 虚拟地址空间:每个进程使用的地址及其映射关系。
- 物理内存:实际保存数据的位置。
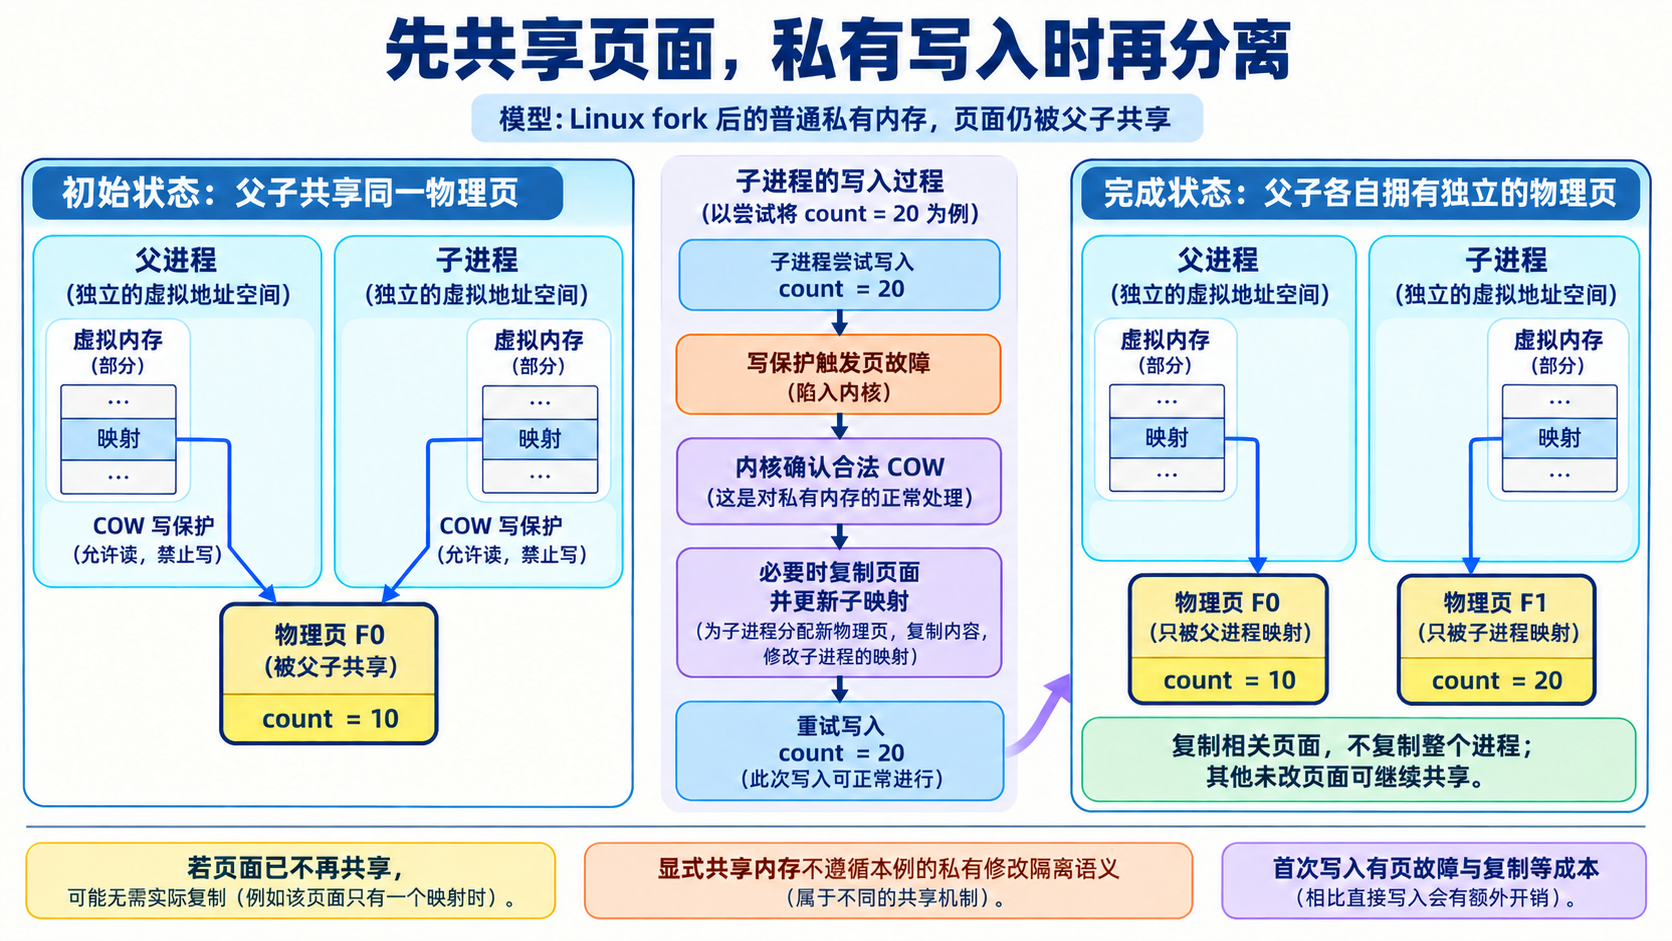
父子进程可以有各自的地址空间,但暂时把相关地址映射到同一块物理内存。就像两份位置记录可以指向同一处存储,记录独立并不要求内容立即复制。
为了避免一方直接改动共同内容,内核会对需要 COW 处理的映射设置写保护:
- 读取时,可以继续访问共享内容。
- 写入时,不能直接修改,必须先由内核处理。
- 内核必要时准备独立副本,改变写入方的映射,再让修改继续。
这样,只读时节省复制,写入时保证私有数据独立,两项目标就能同时实现。
用一次修改看清整个过程
假设父进程中有一个普通私有变量 count = 10,随后调用 fork:
- 父子最初都读到 10。
保存这个变量的物理页可以暂时共享,不必立即复制。 - 子进程尝试执行
count = 20。
CPU 发现对应映射受写保护,触发页故障,把处理交给内核。这里不是程序写错了,而是系统需要先完成 COW。 - 内核为这次私有修改准备独立页面。
在页面仍需与父进程共享的情况下,内核复制原页面内容,让子进程的相关地址指向新页面,并允许写入。 - 子进程继续完成修改。
子进程在新页面上写入 20,父进程仍访问原页面,因此仍读到 10。
最终结果是:双方原本读取相同内容,但子进程的私有修改没有影响父进程。如果先写入的是父进程,也会按相应规则处理,并不是只有子进程能触发 COW。
为什么复制的是页面,而不是一个变量?
上面提到的“页”,是操作系统管理内存映射和保护的单位。常见基础页大小为 4KB,但不同平台和配置可能不同。
写保护通常作用于页面,因此发生 COW 时,通常也是按页处理:
修改一个变量,可能需要复制它所在的整页,但不需要因此复制整个进程的内存。
例如父子共享了很多页面,子进程只修改其中少量页面,就可以只为相关页面建立独立内容,其余继续共享。页表和页故障处理的基本机制可参考 Linux 内核页表文档。
写时复制是不是没有代价?
不是。它只是把复制推迟,并尽量避免不必要的复制。
第一次写入仍共享的私有页面时,可能增加页故障处理、分配和复制开销;如果最终修改了大量页面,仍会消耗额外内存。
还要注意两个边界:
- 如果页面已经不再被其他使用者共享,内核可能直接恢复可写权限,不必实际复制。
- 显式共享内存本来就允许各方观察共同修改,不适用这里的私有数据隔离规则。
因此,不能把 COW 理解为“父子共享所有内存”,也不能说“每次写入都一定复制”。
面试总结
写时复制是一种延迟复制机制,目的是减少不必要的数据搬运和内存占用。
以 Linux fork 为例,父子进程有各自的虚拟地址空间,但部分私有页面可以暂时共享物理内存。系统通过写保护识别写入,必要时复制相关页面并调整映射,再继续修改,使一方的私有写入不影响另一方。
它通常按页处理,不是复制整个进程;首次写入有额外开销,显式共享内存也遵循不同语义。
5. 进程有哪些状态?如何挂起和终止?
一个进程从创建到结束,不会始终占用 CPU。它可能正在执行,也可能等待 CPU,或者等待磁盘、网络等事件。
进程状态就是操作系统对这些情况的记录。
有了状态,系统才能判断哪些任务可以执行、哪些需要继续等待,以及哪些已经结束、需要回收资源。
下面先用一个单线程文件处理程序,理解基本状态及其变化。
进程有哪些基本状态?
在经典五状态模型中,进程分为:
| 状态 | 含义 |
|---|---|
| 新建 | 正在创建,系统准备必要的管理信息和资源 |
| 就绪 | 已具备运行条件,等待获得 CPU |
| 运行 | 正在使用 CPU 执行 |
| 阻塞 | 等待某个条件满足,暂时无法继续 |
| 终止 | 已结束执行,进入资源回收和退出信息处理阶段 |
其中最容易混淆的是就绪和阻塞。
就绪进程是“可以干活,只是还没轮到”;阻塞进程是“还缺少继续干活的条件”。例如数据尚未从磁盘读回来,即使让它获得 CPU,也不能立即继续处理那份数据。
从读取文件看状态怎样变化
假设程序要读取文件,统计其中的单词数量:
- 创建完成,进入就绪态。
系统准备好运行环境,但程序还需要等待 CPU。 - 获得 CPU,进入运行态。
程序开始执行,发起文件读取。 - 数据未准备好,进入阻塞态。
假设本次读取必须等待设备,程序暂时无法继续,系统可以把 CPU 分配给其他任务。 - 数据准备好,回到就绪态。
此时程序可以继续了,但 CPU 可能正在执行其他任务,因此还要等待调度。 - 再次获得 CPU,继续运行。
程序统计单词数量,完成后退出,进入终止阶段。
这里最重要的转换是:
运行 → 等待数据而阻塞 → 数据就绪后被唤醒 → 就绪 → 被调度后运行。
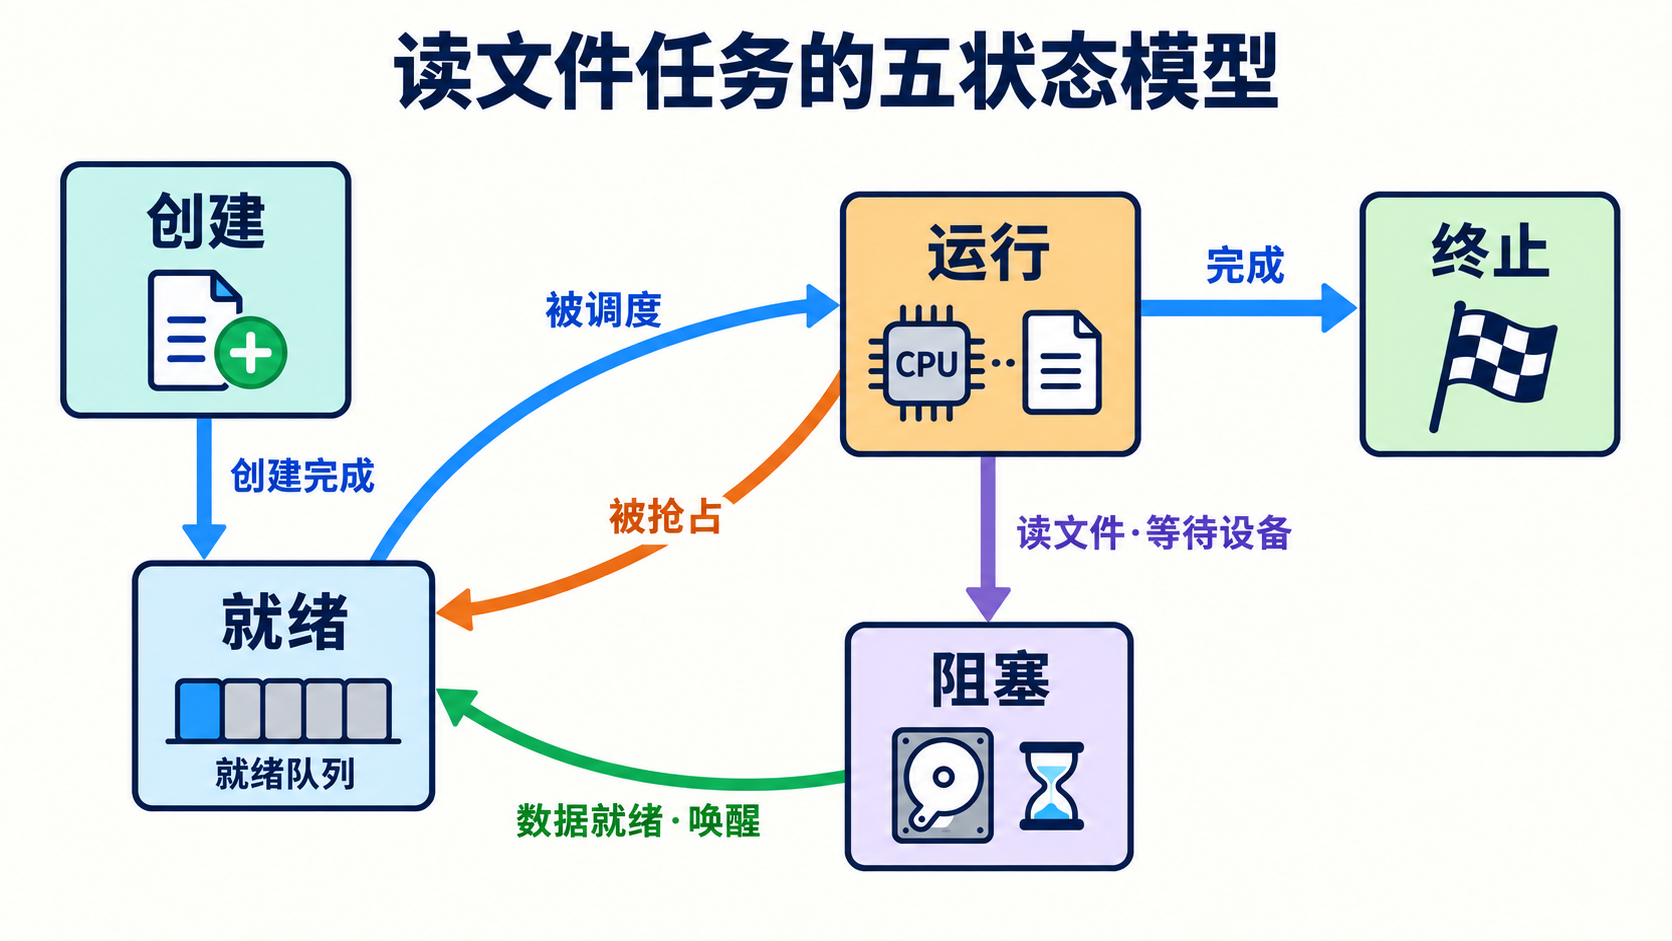
“被唤醒”只意味着重新具备运行资格,不等于立即获得 CPU。
另外,程序还没完成,也没有等待数据,但因为被抢占而失去 CPU,会从运行态回到就绪态。此时它仍然可以继续,只是要把执行机会暂时让给其他任务。
以上是教学模型。现代系统通常调度线程等任务,多线程进程中的不同线程可以处于不同状态,不能把整个进程始终理解成只有一条执行路线。
如果不是等待数据,而是想暂时暂停进程呢?
前面的阻塞,是程序缺少继续执行的条件。但有时程序本来可以工作,用户却希望先暂停它,稍后再继续。这就涉及停止或通常所说的“挂起”。
例如,在 Linux 终端中按下 Ctrl+Z,通常会向前台进程组发送 SIGTSTP,默认行为是停止执行。之后可以通过 Shell 的作业控制恢复它。
常见相关信号有:
SIGTSTP:请求停止,程序可以捕获或忽略。SIGSTOP:不能被捕获、屏蔽或忽略的停止信号。SIGCONT:让已停止的进程继续。
继续并不保证马上运行;如果仍有未满足的等待条件,也不能凭恢复操作就让数据提前到达。Linux 信号手册
因此,两者的区别是:阻塞在等条件,停止在等恢复执行的安排。
挂起是不是把整个进程搬到磁盘?
不能直接这样理解。
经典教材常把挂起与整进程换出结合:为腾出内存,把进程暂时移出内存,并区分“就绪挂起”和“阻塞挂起”。即使原先等待的事件完成,进程也可能仍需解除挂起,才能参与调度。
但 Linux 的停止状态不意味着整个进程被写入磁盘。停止的进程可以仍占用内存;正常运行的进程也可能有部分页面被换出。
所以需要分清:
- 阻塞、停止:讨论任务为什么暂时不执行。
- 换出:讨论内存内容是否暂时转移到外部存储。
它们可能关联,但不是同一件事。
如果不再继续,进程怎样终止?
暂停保留了继续执行的可能,终止则意味着这次运行结束。
进程可能正常完成并退出,也可能因错误主动退出,或者因信号、严重异常等原因被终止。在 Linux 中:
SIGTERM请求进程终止,程序可以安排处理,例如先完成清理。SIGKILL不能被捕获、屏蔽或忽略,程序没有机会执行自己的退出清理逻辑。
因此,kill 的本意是发送信号,并不等于任何一次调用都会立即杀死目标。Linux 信号手册
退出时,内核回收相应运行资源,但通常还会保留少量退出信息,让父进程通过 wait、waitpid 等接口取得结果。子进程已经退出、信息尚未被回收的阶段,就是常说的僵尸状态;它不再执行程序。Linux wait 手册
面试总结
进程的经典基本状态包括新建、就绪、运行、阻塞和终止。就绪表示只等 CPU,阻塞表示还要等待数据或其他条件;条件满足后先回到就绪,获得调度才继续运行。
停止或挂起与阻塞不同,也不应直接等同于内存换出。Linux 可以通过停止和继续信号控制暂停与恢复,通过退出接口或终止信号结束进程。进程退出后,大部分运行资源会回收,但可能暂留退出信息,等待父进程获取。
6. 什么是守护进程、僵尸进程和孤儿进程?
这三个名称描述的不是同一件事:
- 守护进程:主要说明进程承担什么工作,以及如何运行。
- 僵尸进程:说明进程已经退出,但退出信息还没有被回收。
- 孤儿进程:说明进程仍然存活,但原来的父进程已经退出。
要理解后两者,需要先弄清:子进程退出以后,为什么还要和父进程“交接”?
子进程退出后,为什么不立即清除所有信息?
假设一个程序创建子进程,让它压缩文件。子进程结束后,父进程还需要知道:
- 文件是否压缩成功?
- 是否因为磁盘空间不足而失败?
- 是否被某个信号终止?
因此,子进程退出时,操作系统会释放它的大部分资源,但暂时保留退出状态等少量信息,等待父进程通过 wait() 或 waitpid() 获取。
这些函数不只是“等待子进程结束”,还负责收集退出结果,并回收留下的退出记录。如果子进程已经退出,父进程可以直接取得结果。
由此,就能理解僵尸进程为什么会出现。
僵尸进程:已经退出,但还没有完成回收
如果子进程先退出,而父进程尚未收集它的退出结果,子进程通常就会暂时成为僵尸进程。
以上面的压缩任务为例:
- 父进程创建子进程,开始压缩文件。
- 子进程完成工作并退出。
- 操作系统释放它的大部分资源,保留进程 ID、退出状态等信息。
- 父进程调用
wait()或waitpid(),取得结果。 - 剩余退出记录被回收,僵尸状态结束。
僵尸进程不是还在后台运行的进程,而是已经结束、等待“收尾”的进程。 它不会继续执行代码,也不会保留原来的全部内存。
短暂出现僵尸进程是正常现象。问题在于父进程长期不回收,导致退出记录不断积累,占用进程管理资源。
解决重点是让父进程正确回收子进程。对僵尸进程执行 kill -9 没有意义:它已经退出,不能再通过“杀死一次”完成回收。
以上是通常的处理方式;显式设置某些 SIGCHLD 处理选项,也可以让子进程退出时自动回收。Linux wait 手册
孤儿进程:父进程先退出,子进程仍然存活
现在把退出顺序反过来:
- 父进程启动压缩子进程。
- 压缩尚未完成,父进程却先退出了。
- 子进程仍然存活,失去了原来的父进程,因此成为孤儿进程。
成为孤儿本身并不意味着子进程必须退出。 在没有其他终止因素的情况下,它仍然可以继续完成压缩任务。
但它以后退出时,由谁收集结果?
Linux 会为它重新指定父进程:通常由最近的、被设置为 subreaper(子进程收养者) 的存活祖先进程接管;如果没有这样的祖先,则由相应 PID 命名空间中的 PID 1 进程接管。
新的父进程可以通过 wait() 等接口回收它。因此,不能一概说所有孤儿进程都由传统的 init 进程直接收养。Linux subreaper 手册
两者最关键的区别是:
僵尸进程是“自己已经退出,退出结果尚未被收集”;孤儿进程是“原父进程已经退出,自己仍然存活”。
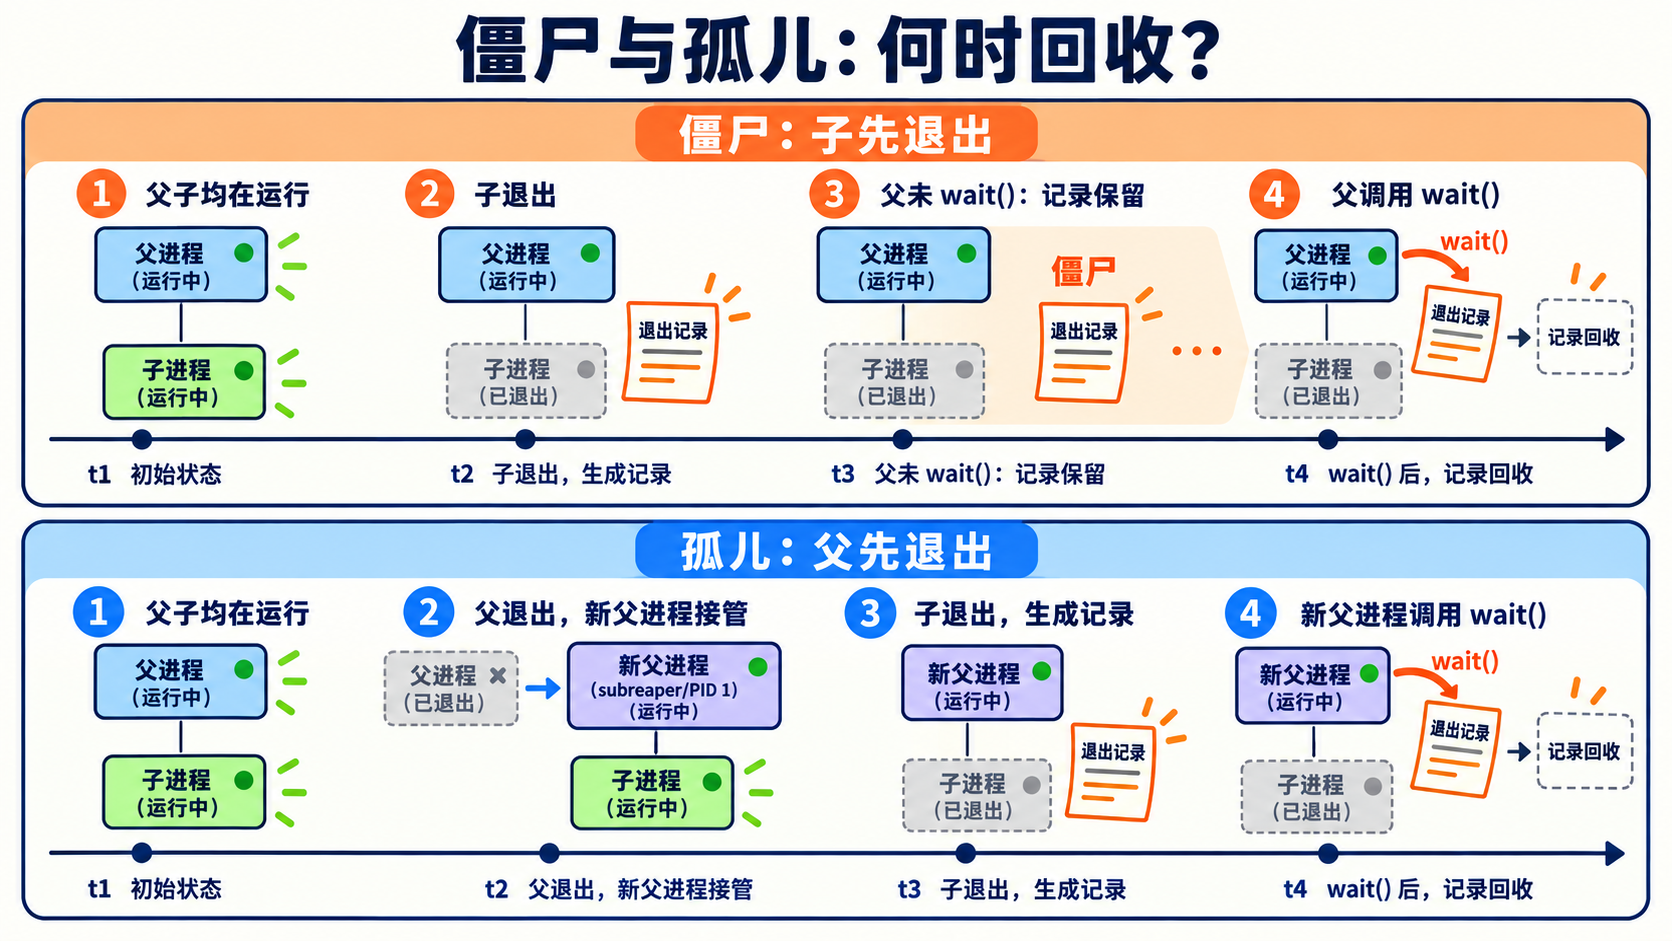
守护进程:在后台提供服务
前面两种情况都与父子进程的退出顺序有关。守护进程则不同,它描述的是一种服务运行方式。
例如,系统需要持续接收日志、监听网络请求或执行定时任务。这些工作不应依赖用户一直打开某个终端,因此通常交给后台服务进程处理。
传统 Unix 守护进程一般脱离控制终端,在后台提供服务。不过,守护进程不一定周期性执行任务:
- 日志服务可以等待日志到来;
- 网络服务可以等待客户端连接;
- 定时任务服务则在指定时间触发工作。
等待期间,进程可以处于阻塞状态,不需要一直占用 CPU。
现代 Linux 中,服务常由 systemd 等服务管理器启动和监管。服务程序可以不自行执行传统的“双重 fork、转入后台”流程,而由管理器负责启动、停止和监控。Linux daemon 手册
另外,“后台运行”不等于“没有所属用户”。守护进程同样具有用户身份和权限,也不必都以 root 身份运行。
面试总结
守护进程是在后台提供服务的进程,传统上通常脱离控制终端,但不一定周期性执行任务,现代系统也可以由服务管理器统一监管。
僵尸进程是已经退出、但退出状态尚未被父进程收集的子进程。它不再执行代码,只保留少量管理信息,通常需要父进程通过 wait() 或 waitpid() 回收。
孤儿进程是原父进程已经退出、自己仍然存活的子进程。Linux 会将它重新交给合适的 subreaper 或 PID 1 进程接管;成为孤儿本身不代表发生错误,也不意味着它必须停止运行。
如果父进程先退出,压缩子进程仍在工作,它就失去了原父进程。在 Linux 中,会由适当的收养者接管,例如 PID 1 或 subreaper。子进程可以继续正常工作,之后由接管者取得退出信息。
7. 进程和线程有什么区别?应该如何选择?
进程是程序的一次运行实例,拥有自己的地址空间、打开的文件等运行资源。
线程则是进程内部的一条执行流程,同一进程中的多个线程可以共享这些资源,分别执行不同任务。
因此,两者不是完全对等的替代品:选择多进程还是多线程,本质上是在决定:把任务放进不同的运行环境,还是让它们在同一个环境中协作。
这会直接影响数据怎样共享、出错后影响谁,以及创建和管理任务需要多少成本。
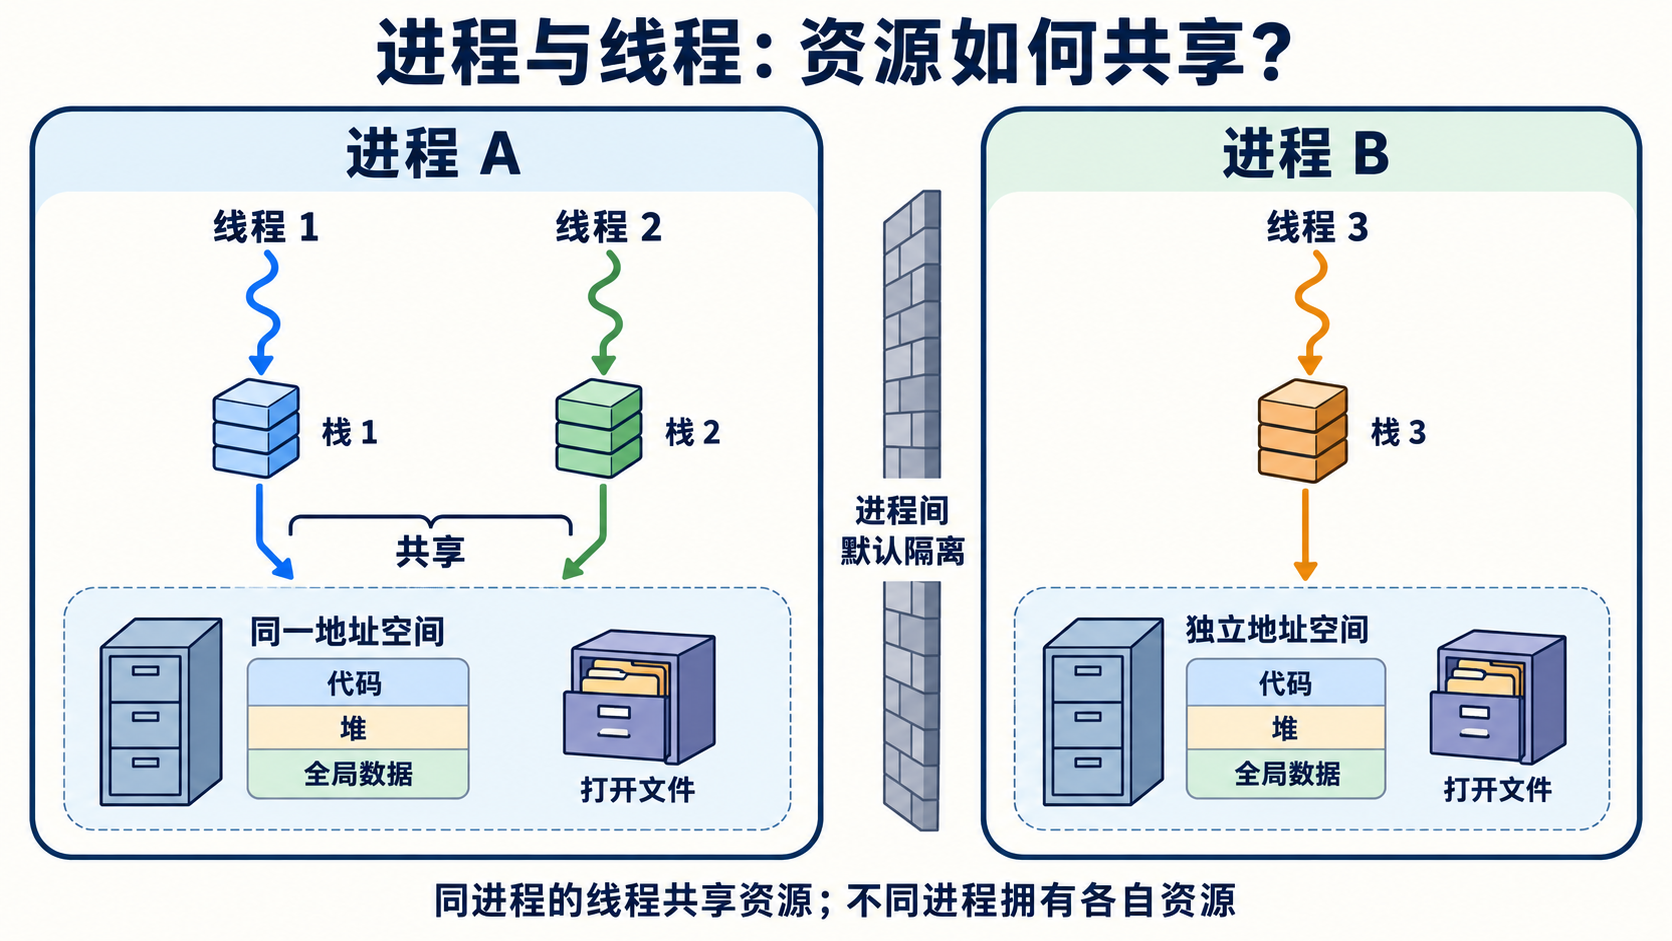
数据共享:进程默认隔离,线程直接共享
假设图片处理服务需要对一张大图进行缩放和颜色分析。
如果使用同一进程中的两个线程,可以先把图片加载到内存,再让两个线程访问这份图片。它们各自保存计算进度,但不必各自保存一份原图。POSIX 线程共享进程的全局数据、堆和打开的文件描述符,同时各有自己的栈。Linux 线程手册
如果使用两个独立进程,一个进程通常不能拿着另一个进程里的内存地址,就直接访问那张图片。因为相同的地址数值,在不同进程中可能对应不同的数据。
它们需要通过管道、Socket 等进程间通信机制(IPC)传递内容,或者显式建立共享内存,让双方访问同一块数据。
即使是通过 fork() 创建的父子进程,普通私有内存也具有独立修改的语义:一方修改自己的内容,不会直接改变另一方的私有数据。Linux fork 手册
这说明:
线程更方便共享数据;进程则默认把数据隔开,需要时再建立共享或通信关系。
但方便共享不等于可以随意修改。如果一个线程正在分析图片,另一个线程同时改动图片内容,就需要锁、只读快照等方式协调。多进程使用共享内存时,同样需要解决这个问题。
故障影响:共享越多,互相影响的可能性越大
继续看图片处理服务。如果缩放程序存在错误,把数据写到了不该写的位置,会发生什么?
- 放在同一进程的线程中:错误可能破坏其他线程正在使用的数据,严重时导致整个进程退出。
- 放在独立进程中:普通内存访问错误通常被限制在这个进程内,主服务可以发现工作进程退出,再启动新的工作进程处理任务。
因此,需要隔离不稳定组件或第三方插件时,独立进程往往更合适。
不过,不能简单记成“线程出错,整个进程一定崩溃”。业务失败、能够正常处理的异常,不一定导致进程退出。真正危险的是内存破坏、导致进程终止的故障等。
进程隔离也不是完整的安全保障。如果插件进程仍有权限删除重要文件,它依然可能造成损害。因此,运行不可信代码时,还需要配合权限控制和资源限制。
创建与切换:线程通常较轻,但不是没有成本
线程通常可以复用所属进程的地址空间和许多资源,不必重新建立一套独立的运行环境,因此创建和管理成本往往较低。
不过,每个线程仍然需要自己的栈和执行状态,也需要参与调度。
切换任务时,系统必须保存当前执行位置、寄存器等状态,再恢复下一个任务:
- 同一进程内的线程切换,通常不需要更换地址空间;
- 不同进程之间的切换,通常还涉及地址空间切换,并可能影响地址转换缓存和数据访问的局部性。
所以,线程“轻”主要是因为复用了更多资源,而不是因为线程不需要调度,或者切换完全没有开销。
这也不代表多线程一定比多进程快。如果多个线程不断争抢同一把锁,大量时间花在等待上,共享的便利反而可能变成性能瓶颈。
主要区别对照
| 比较维度 | 不同进程 | 同一进程内的线程 |
|---|---|---|
| 地址空间 | 默认相互隔离,可显式共享部分内存 | 共享进程地址空间 |
| 数据交换 | 通常需要 IPC 或共享内存 | 可以直接访问共享对象 |
| 执行状态 | 每个进程中的线程分别保存 | 各自拥有执行位置、寄存器状态和栈 |
| 创建与切换 | 通常涉及更多资源管理 | 通常较轻,但仍有管理和调度成本 |
| 故障影响 | 更容易限制在单个进程内 | 内存破坏等问题可能影响整个进程 |
| 独立管理 | 便于分别启动、终止和重启 | 线程结束不必终止进程,但进程终止会结束其中所有线程 |
应该如何选择?
回到图片处理服务,可以按任务之间的关系来决定。
任务可信、需要频繁共享大量数据时,可以优先考虑线程。
例如,经过测试的缩放和颜色分析模块都要读取同一张大图。让它们在进程内协作,可以减少数据传递,也便于复用资源,但要设计好共享数据的访问规则。
任务需要隔离故障、单独重启或限制权限时,可以优先考虑进程。
例如,第三方图片插件可能崩溃或长时间不返回。把它放在独立工作进程中,主服务就更容易监控、终止和替换它。
实际系统也可以同时使用两者:主进程负责接收请求,多个工作进程隔离任务,每个工作进程内部再用线程完成紧密协作的计算。
另外,不能简单把“计算密集型”对应进程、“I/O 密集型”对应线程。多进程和多线程都可以利用多核,具体效果还受语言运行时、任务划分及同步成本影响。
面试总结
进程主要提供资源管理和隔离环境,线程是进程内部的执行流程。同一进程中的线程共享地址空间和文件等资源,但各自保存执行状态;不同进程默认隔离,交换数据通常需要 IPC 或显式共享内存。
线程通常创建和切换成本较低、共享数据方便,但需要处理同步问题,严重错误可能影响整个进程。进程通常管理成本更高,却更便于隔离故障、限制权限和独立重启。
选择时应重点考虑数据共享、故障隔离和管理需求,而不是只比较谁更快;也可以用进程做隔离,再用线程完成进程内部的协作。
日志、定时任务等服务需要长期工作,不依赖用户一直保持交互终端,这类服务进程通常称为守护进程。
传统程序常用 fork、脱离终端等方式进入后台;现代服务管理器也可以直接监管前台运行的服务,不要求都使用双重 fork。守护进程描述用途,与僵尸、孤儿不是一组互斥状态。
8. 什么是线程?为什么需要线程?
线程是进程内的一条执行流程。这里的“执行流程”,可以理解为:按照代码一步步完成任务,并记住自己执行到了哪里。
例如,一个编辑器进程可以包含多个线程:一个负责处理键盘输入和界面更新,另一个负责搜索文档。它们执行不同的工作,但可以共同访问这个进程中的文档数据。
为什么一个进程需要多个线程?
假设编辑器只有一个线程,用户点击“搜索”后,这个线程就开始逐行检查文档。如果搜索持续几秒,并且途中不再处理界面事件,那么这几秒内,用户输入文字、点击按钮,都得不到及时响应。
问题不在于编辑器没有收到操作,而在于:唯一的执行流程忙着搜索,没有机会处理这些操作。
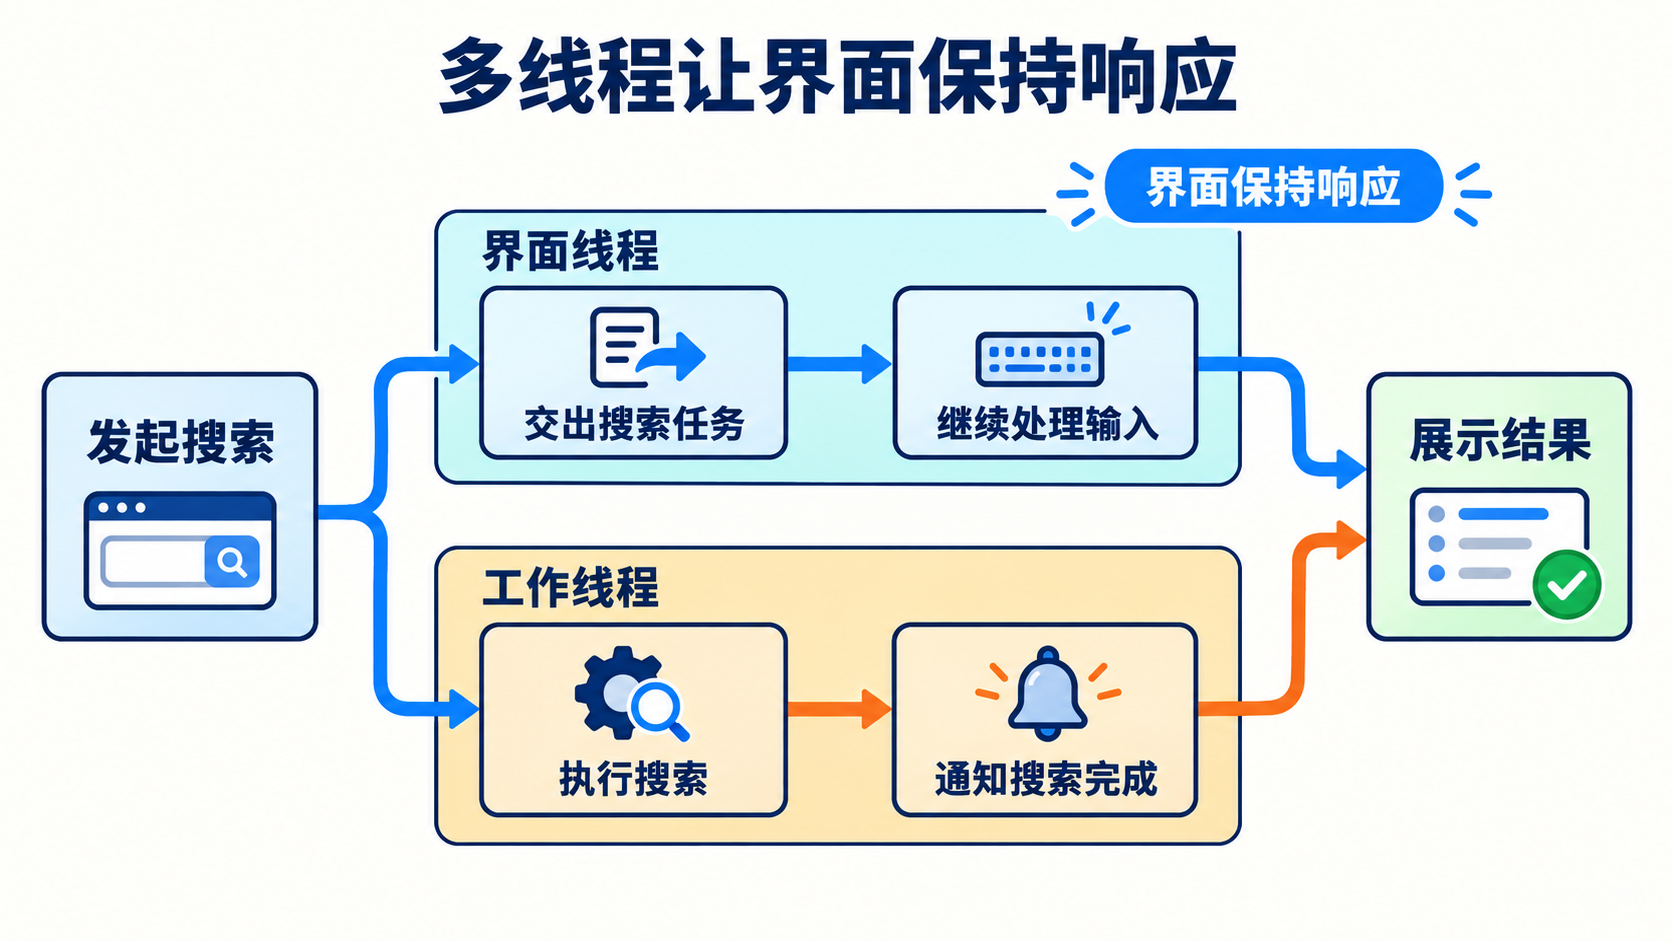
一种解决方法是把工作分给不同线程:
- 界面线程接收搜索请求,将搜索任务交给工作线程。
- 工作线程执行搜索,界面线程继续处理输入和界面事件。
- 搜索完成后,工作线程通知界面线程,由它展示结果。
这样,界面不必等整个搜索结束才能继续响应。当然,界面线程也不能把任务交出去后,立刻停下来等待结果,否则仍然可能卡住。
多线程不是实现响应式程序的唯一方法,但它提供了一种直接的任务组织方式:让不同工作拥有各自的执行进度,不必都挤在一条执行流程中。
多个线程怎样各自执行,又共同使用数据?
把搜索交给另一个线程后,就出现了两个需要同时满足的要求:
- 搜索和界面处理要分别记住自己的执行进度;
- 它们又需要访问同一份文档,而不是各自维护一个完全独立的编辑器。
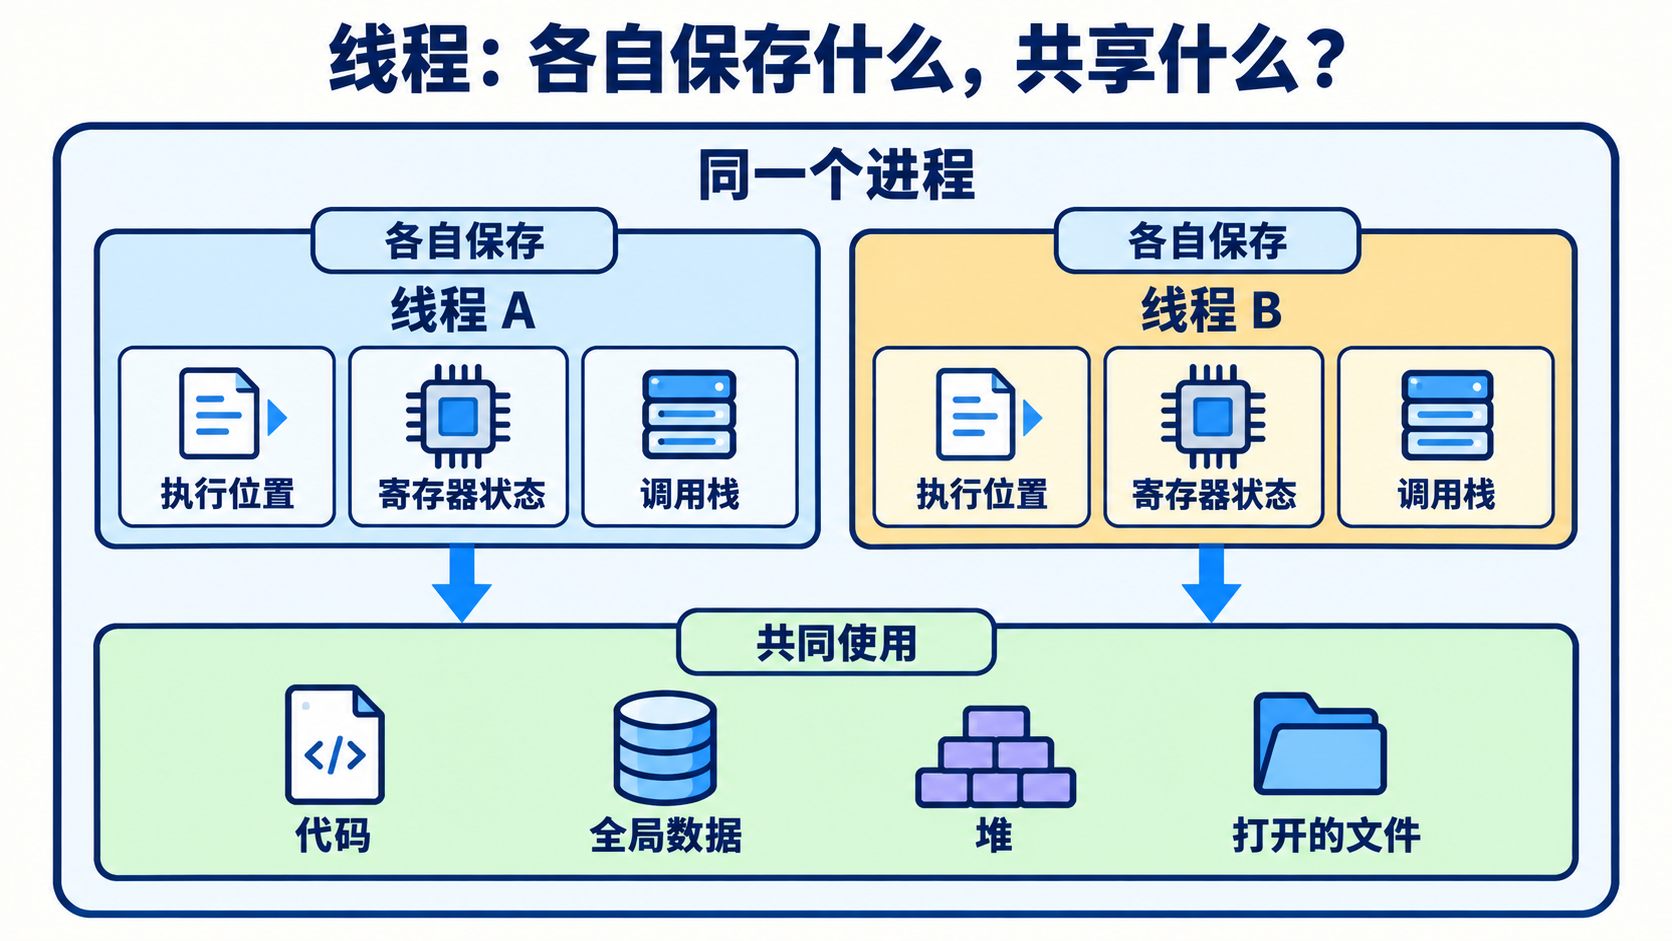
因此,线程的状态分成两部分:执行所需的状态各自保存,进程中的许多资源共同使用。
假设界面线程正在处理一次按键,搜索线程已经查到第 100 行:
- 执行位置不同:一个接下来要更新界面,另一个要检查下一段文字,需要分别记录下一条指令的位置。
- 中间结果不同:搜索位置、临时计算结果等,需要保存在各自的寄存器状态或内存中。
- 函数调用过程不同:一个正在执行输入处理函数,另一个正在执行搜索函数,因此需要各自的调用栈,记录函数调用、返回位置和部分局部数据。
这里的寄存器是 CPU 保存当前计算状态的高速存储位置。当线程被暂停时,系统保存必要状态;再次执行时恢复,让它从原来的位置继续。
与此同时,线程可以共享进程的代码、全局数据、堆中的对象和打开的文件等资源。文档内容就可以放在共同访问的内存中。Linux POSIX 线程手册
需要注意,线程各有自己的调用栈,不代表这些栈受到彼此隔离的内存保护。它们仍位于同一进程的地址空间中,其他线程得到相应地址后,也可能访问其中的数据。
多线程是不是意味着同时执行?
不一定,要看可用的 CPU 执行资源。
在只有一个逻辑 CPU 的情况下,多个线程通常是交替执行:
界面线程处理输入 → 搜索线程检查一段文字 → 界面线程更新显示 → 搜索线程继续搜索
它们在一段时间内共同推进,称为并发,但并不是同一时刻都在执行 CPU 指令。搜索过程中,界面线程有机会获得 CPU,因此可以改善响应性。
当一个线程等待磁盘或网络时,其他可运行线程也可以利用 CPU,而不必跟着等待。
如果有多个 CPU 核心等执行资源,不同线程还可能在同一时刻运行,这才是并行。因此,能够合理拆分的计算任务,也可能通过多线程缩短完成时间。
不过,线程越多并不意味着越快。创建线程、切换执行状态以及协调共享数据,都有成本。

共享方便了协作,也带来了竞争
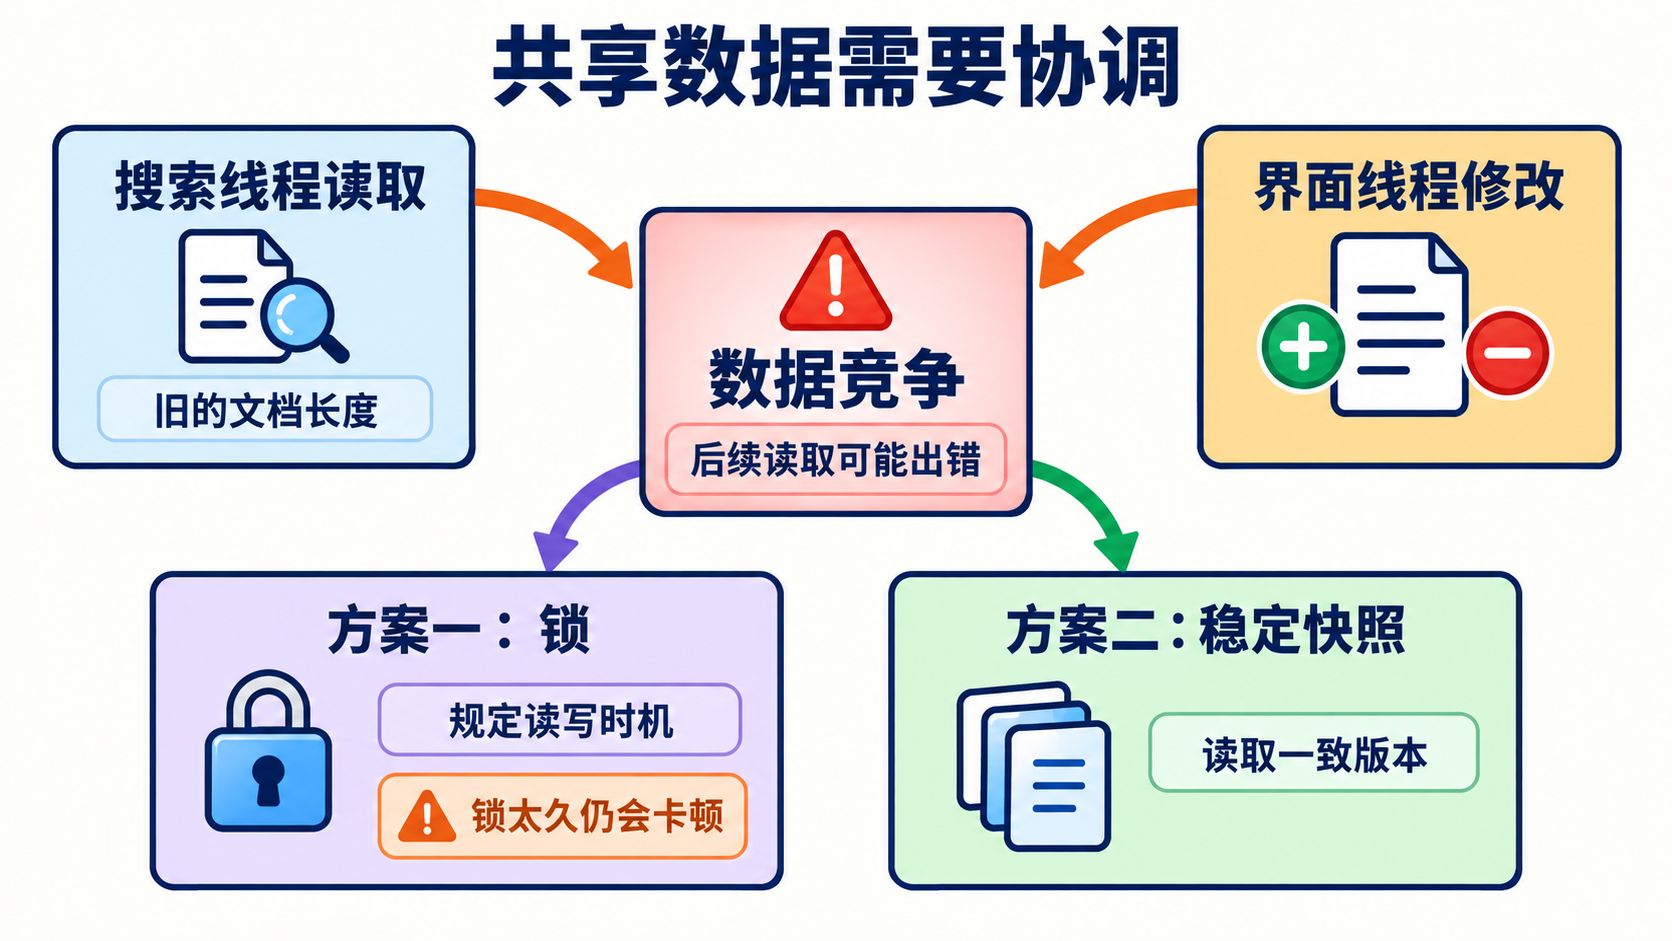
回到编辑器:搜索线程读取文档时,界面线程可能正在插入或删除文字。
如果没有协调,搜索线程可能刚读取旧的文档长度,文档内容就被另一线程改变,后续读取便可能出现错误。
所以,多线程程序不仅要分配任务,还要规定什么时候可以读取,什么时候可以修改。可以使用锁保护相关访问,也可以让搜索线程读取一份稳定的文档快照,具体取决于设计。
锁的范围同样重要:如果搜索线程一直持有界面编辑所需的锁,界面仍可能长时间等待。可见,多线程只是提供了分别推进任务的能力,并不会自动保证程序正确或界面流畅。
面试总结
线程是进程内的执行流程。多个线程共享地址空间、打开文件等资源,但各自保存执行位置、寄存器状态和调用栈,因此能够分别推进不同任务。
使用线程可以改善程序响应性,让其他任务利用 I/O 等待时间,并在多核上并行执行可拆分的计算任务。相比建立多个独立进程,同一进程中的线程也更方便共享数据。
但共享数据会带来竞争,需要正确同步;线程本身也有管理和切换开销,所以多线程不等于一定更快,也不自动保证线程安全。
9. 什么是协程?它和线程有什么区别?
假设一个服务器要处理两个请求:A 需要查询另一个服务,B 只需要读取本地已有的数据。
处理 A 时,请求已经发出,但网络响应还没回来。等待响应不需要 CPU 一直计算。这段时间如果能先处理 B,服务器就能同时推进更多请求。
使用线程可以做到这一点:让 A、B 分别由线程处理。不过,如果有大量请求都在等待网络,每个请求都长期占用一个专门线程,会增加栈空间和线程管理开销。协程提供了另一种组织这些任务的方式。
协程是什么?
协程是一种可以在执行过程中暂停,并在之后从暂停位置继续执行的程序执行单元。
它和线程有些类似,都可以用来执行一段代码,但两者并不在同一个层级。线程通常由操作系统调度,而协程通常运行在线程之上,由程序运行时、事件循环或协程框架负责调度。一个线程中可以先后运行多个协程。
协程最大的特点是:当它遇到暂时无法完成的异步操作时,例如等待网络响应,可以先暂停自己,把当前线程的执行权让出来,让线程去执行其他协程。
这里的“暂停”并不是结束执行。协程会保存当前执行到的位置,以及继续执行所需要的局部状态。等等待的操作完成后,它可以从原来的位置继续执行。
仍以请求 A、B 为例,假设它们都运行在同一个线程中:
- 线程开始运行协程 A,处理请求 A,并发出网络请求。
- 网络响应暂时没有到达,协程 A 登记等待这个结果,然后暂停执行。
- 当前线程没有必要一直等 A,于是转去运行协程 B,继续处理请求 B。
- 当 A 的网络响应到达后,协程 A 重新变成可以运行的状态。
- 之后线程再次运行协程 A 时,A 会从之前暂停的位置继续执行,而不是从头开始。
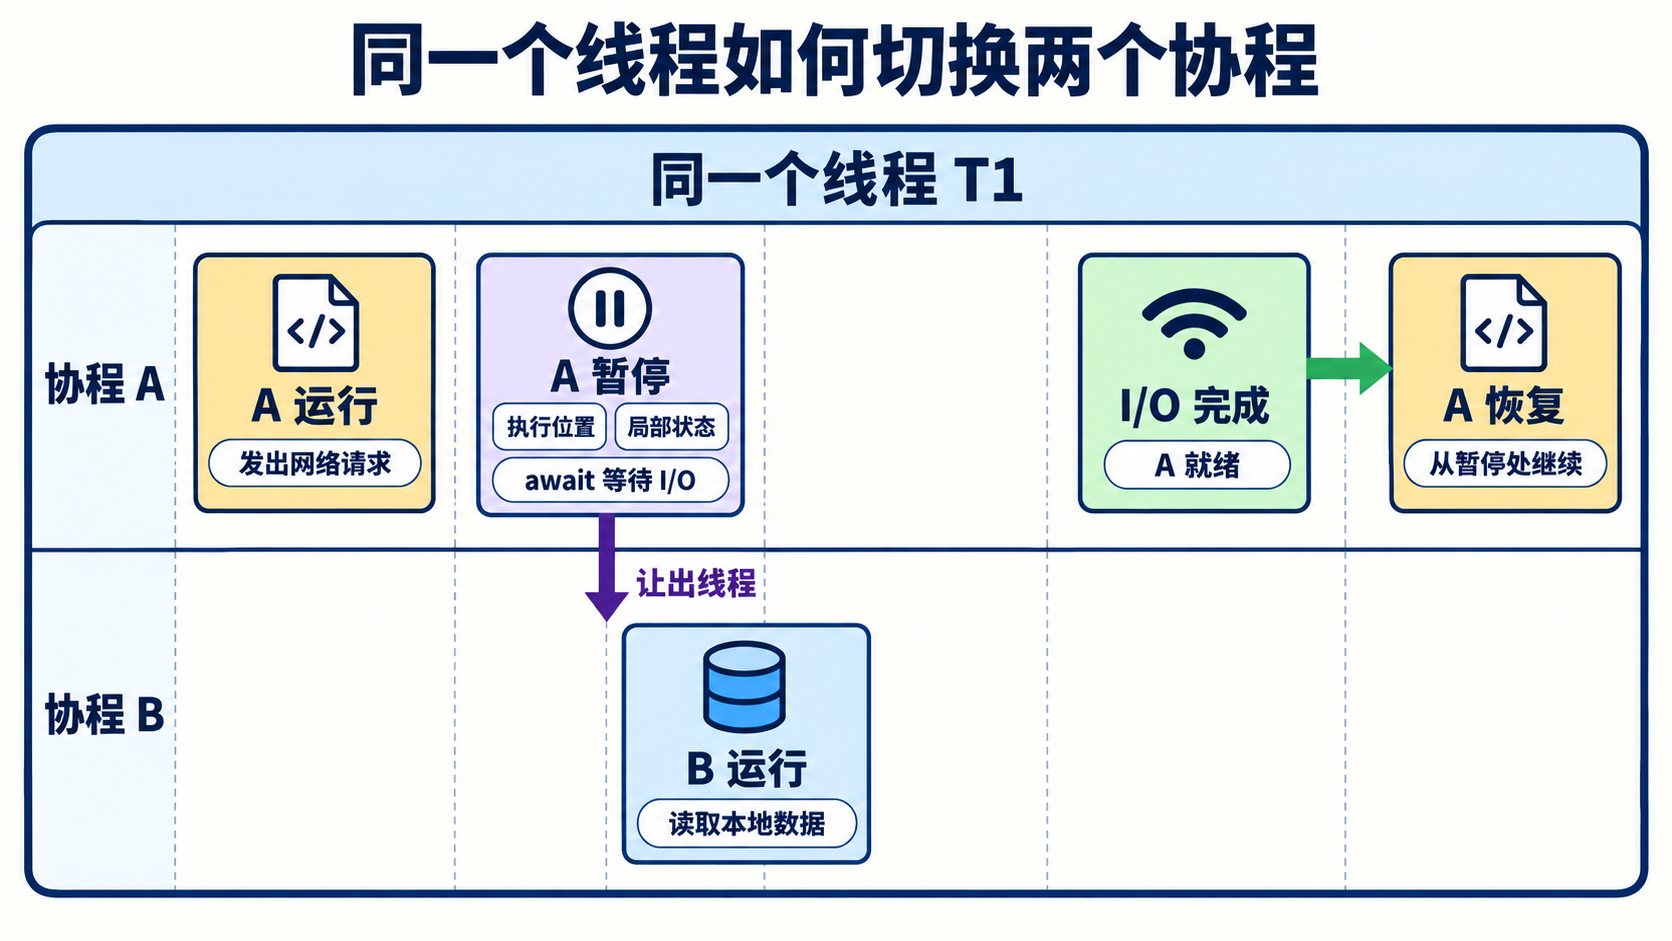
因此,协程解决的核心问题之一就是:
当一个任务正在等待 I/O 时,可以先暂停它,让同一个线程去执行其他任务,从而避免线程被白白占住。
Python 的 asyncio 就是典型例子。一个协程执行到 await 时,如果等待的结果还没有准备好,就会暂停当前协程;事件循环可以继续运行其他协程,等结果就绪后,再恢复原来的协程。
协程和线程有什么区别?
线程和协程都可以让多个任务交替推进,但它们处在不同的层级,调度方式也不同。
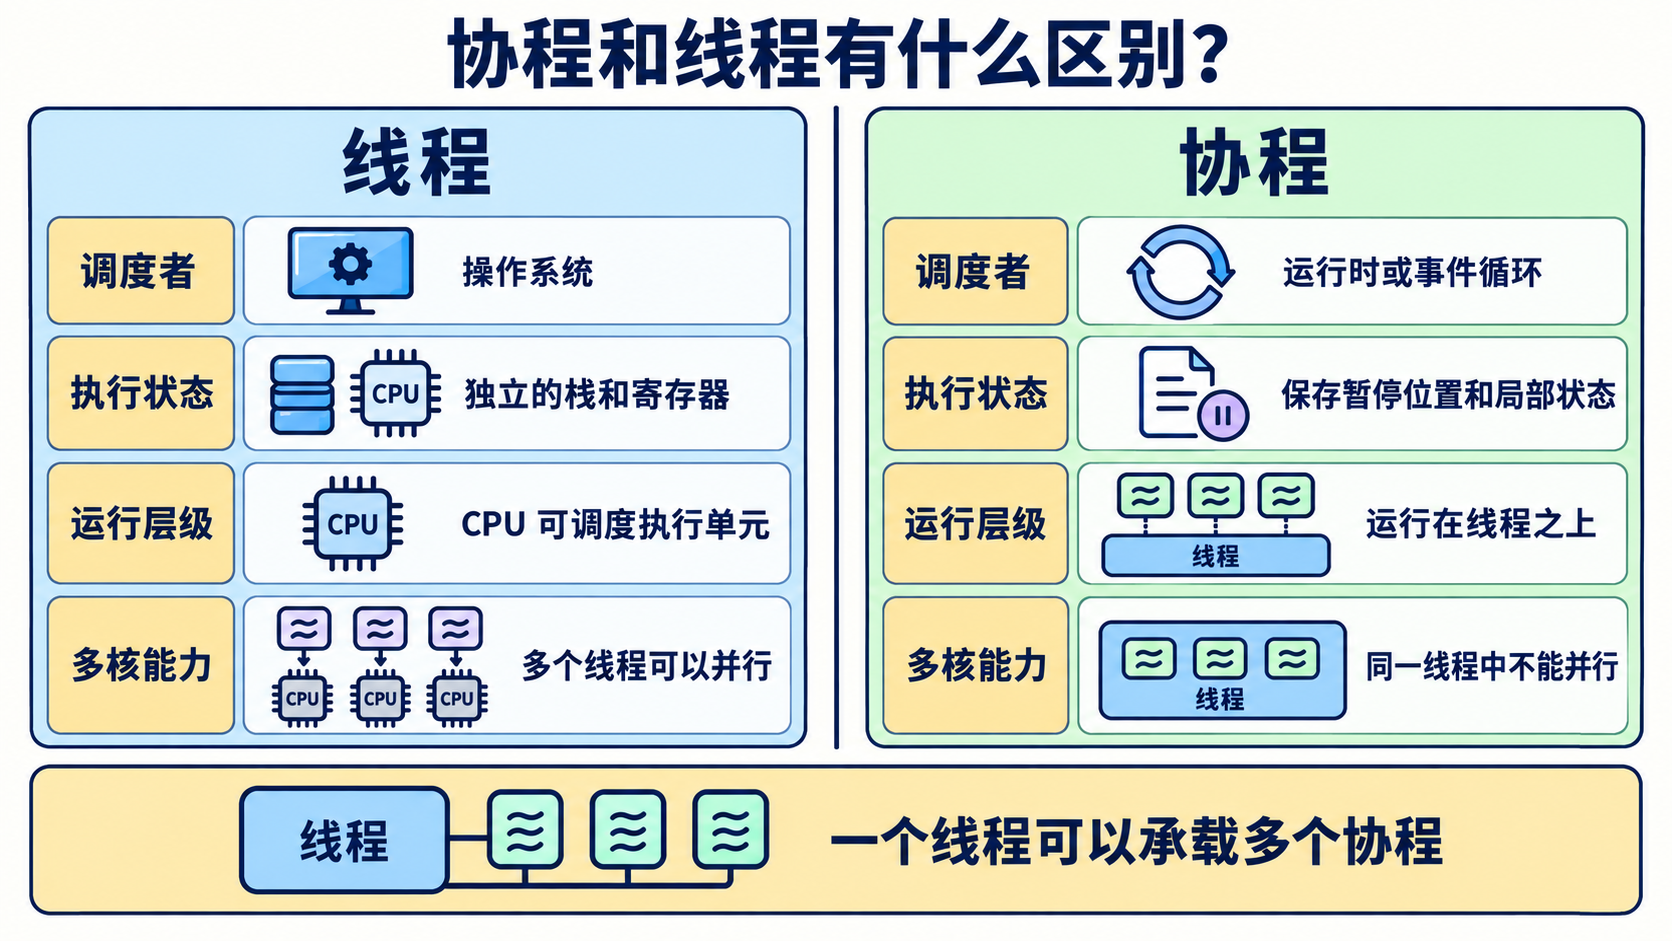
线程由操作系统负责调度。 操作系统可以暂停当前线程,切换到另一个线程继续执行。每个线程都有自己的栈、寄存器等执行状态。同一个进程中的多个线程还可以分别运行在不同的 CPU 核心上,因此能够真正并行执行。
协程通常运行在线程之上,由程序运行时或事件循环负责调度。 在常见的协作式协程模型中,一个协程执行到 await 等等待点时,会主动暂停并让出当前线程的执行权,随后线程可以继续运行其他协程。
因此,一个线程可以承载多个协程。例如协程 A 在等待网络响应时,线程可以先去执行协程 B,而不需要给 A、B 分别准备一个线程。
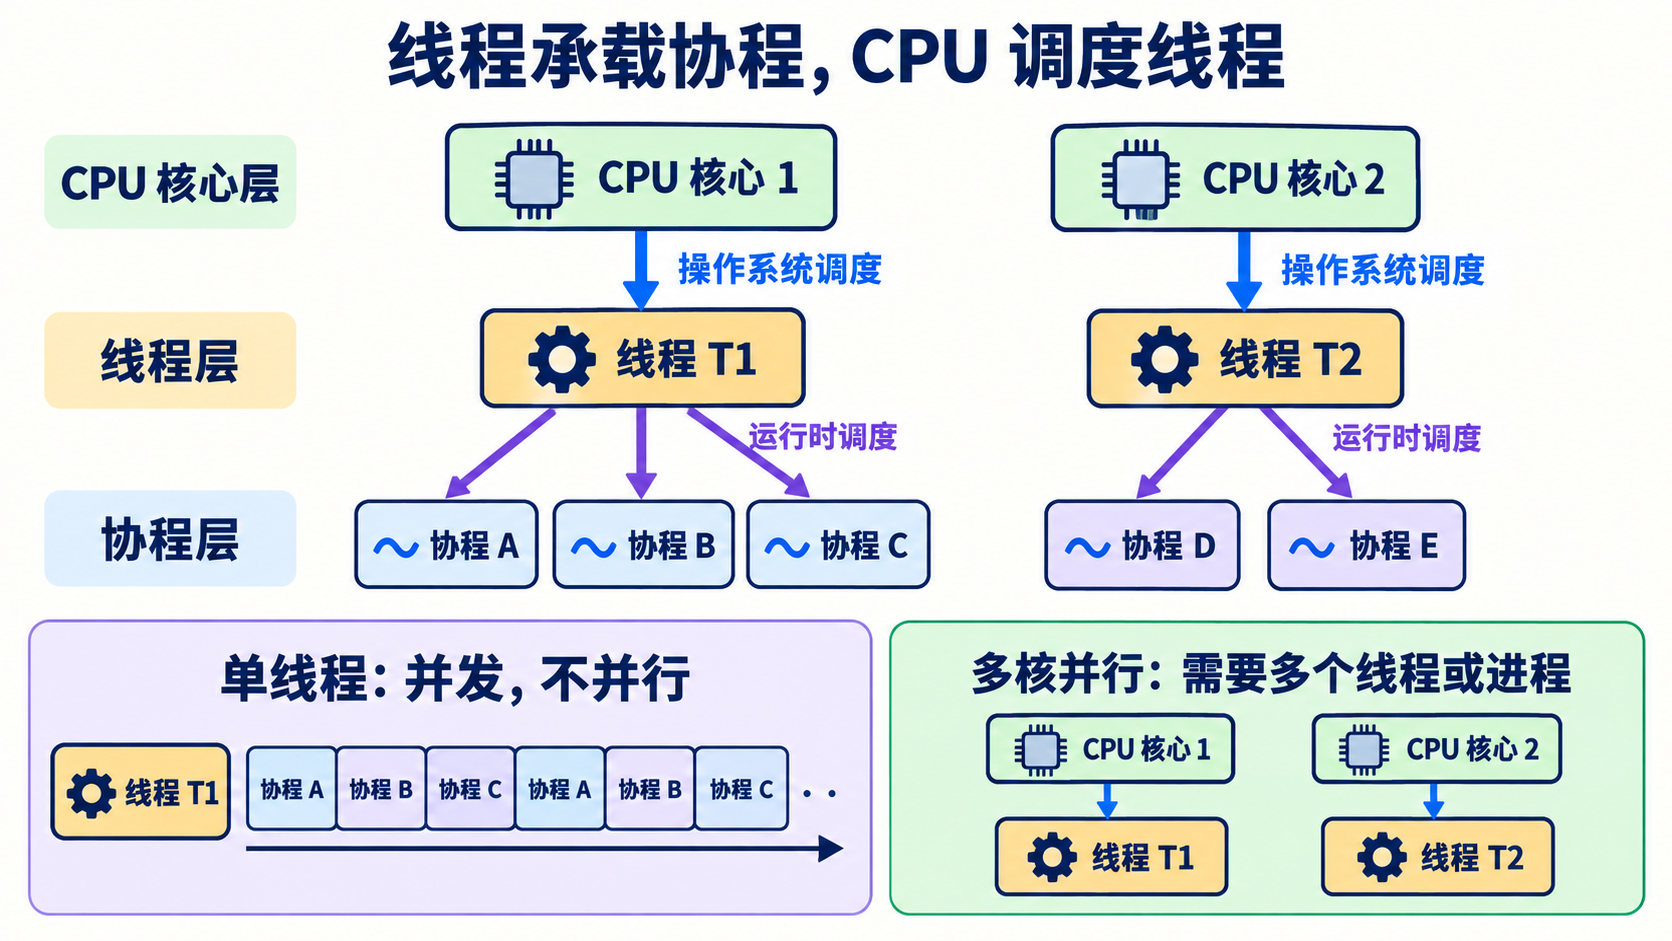
不过需要注意:如果多个协程都运行在同一个线程上,它们只能交替使用 CPU,不能在同一时刻真正并行执行。 如果希望同时利用多个 CPU 核心,仍然需要多个线程、多个进程等执行资源。
所以可以简单理解为:
线程解决的是“CPU 怎么调度执行单元”,协程解决的是“一个线程等待时,怎么继续利用这个线程做其他工作”。
10. 什么是上下文切换?为什么进程切换通常比线程切换开销更大?
假设 CPU 正在执行任务 A,执行到一半时,操作系统决定先让任务 B 运行。之后 A 再次获得 CPU 时,应该从之前暂停的位置继续执行,而不是从头开始。
为了做到这一点,系统必须保存 A 当前的“执行现场”,例如:
- 执行到了哪条指令;
- 当前栈的位置;
- 寄存器中的中间计算结果。
这些让任务以后能够继续执行的状态,就叫作任务的上下文。
操作系统保存任务 A 的上下文,再恢复任务 B 的上下文,让 CPU 转去执行 B,这个过程就叫作上下文切换。
在 Linux 中,更准确地说,调度器调度的是线程。
两个线程既可能属于同一个进程,也可能属于不同进程。
因此,我们平时所说的“进程切换”,本质上通常是从一个进程中的线程切换到另一个进程中的线程。
一次上下文切换发生了什么?
假设线程 A 正在执行代码,此时时间片耗尽,需要切换到线程 B:
- 内核保存线程 A 的执行状态,例如程序计数器、栈指针以及必要的寄存器状态;
- 调度器选择接下来运行的线程 B;
- 内核恢复线程 B 之前保存的执行状态;
- CPU 从线程 B 上次暂停的位置继续运行。
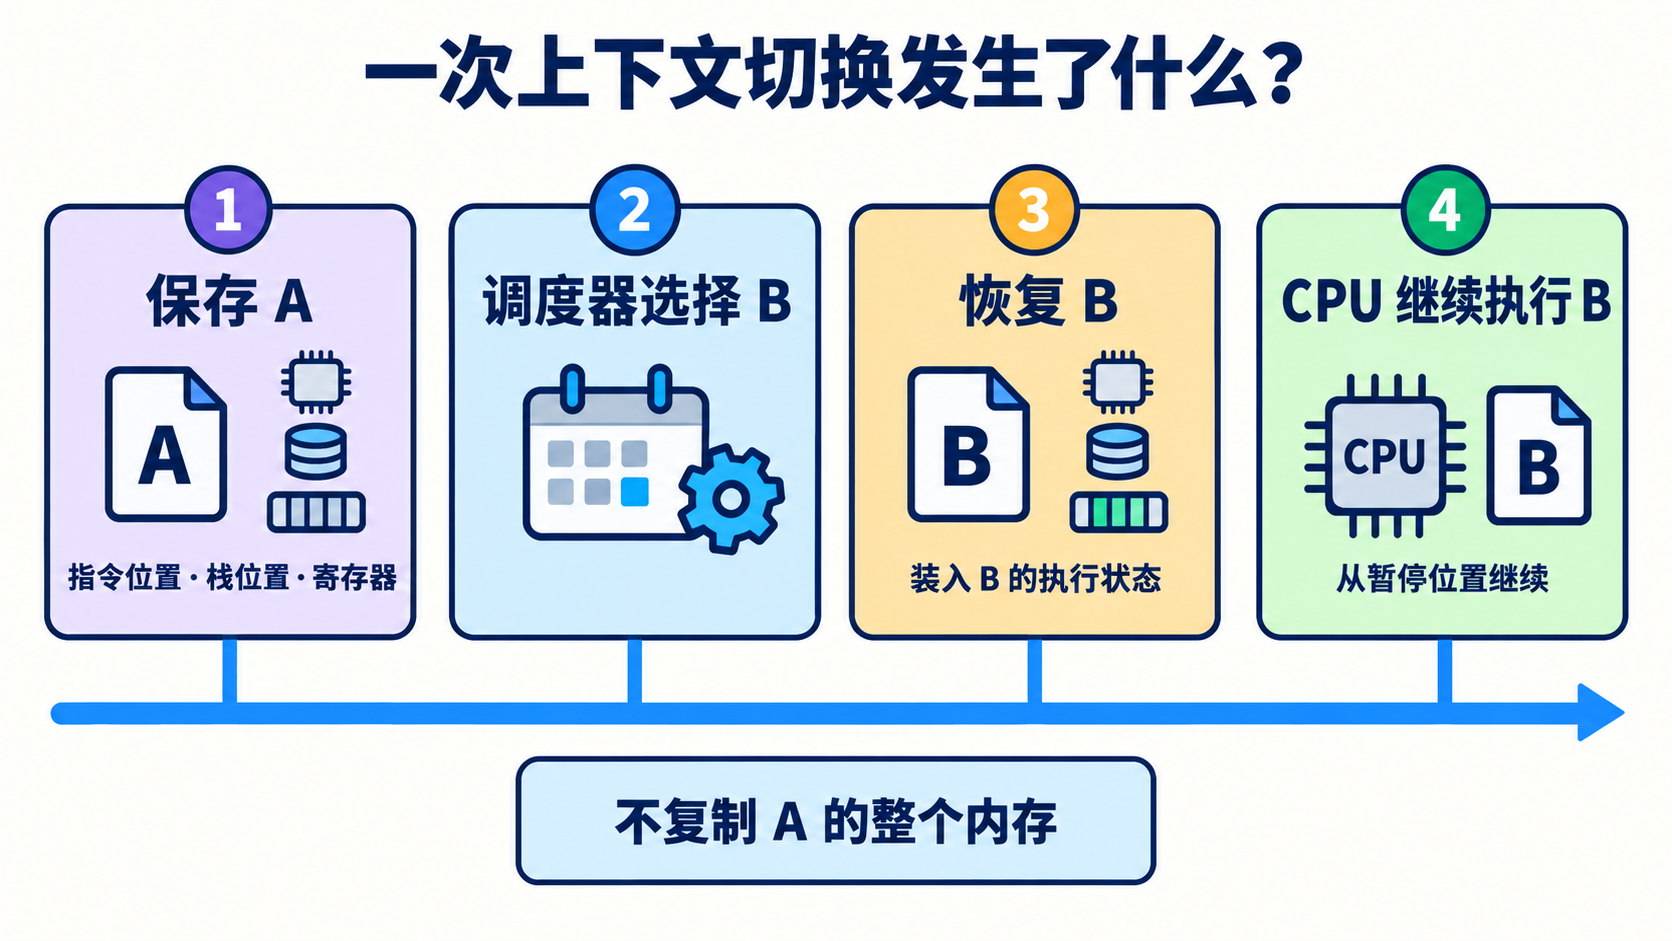
将来再次调度线程 A 时,同样会恢复 A 的状态,让它继续执行。
需要注意的是,上下文切换不会把任务的整个内存复制一遍。代码、堆、栈等数据仍然保存在原来的内存中,系统主要保存的是让任务继续运行所必需的 CPU 执行状态。
具体需要保存哪些状态,与 CPU 架构和操作系统实现有关,但核心通常包括程序计数器、栈指针以及必要的寄存器状态。
为什么会发生上下文切换?
常见情况主要有两类。
一种是任务主动让出 CPU。例如线程执行磁盘或网络 I/O 时,需要等待数据,于是进入阻塞状态,CPU 可以去执行其他线程。这通常属于主动上下文切换。
另一种是线程仍然可以继续运行,但因为时间片耗尽,或者被更高优先级的任务抢占,操作系统暂停它并调度其他线程。这通常属于被动上下文切换。
因此,线程 A 被切走以后,可能进入就绪状态,也可能进入阻塞状态,具体取决于它为什么停止运行。
为什么进程切换通常比线程切换开销更大?
这里更准确的比较应该是:
同一进程内的线程切换,与跨进程的线程切换有什么区别?
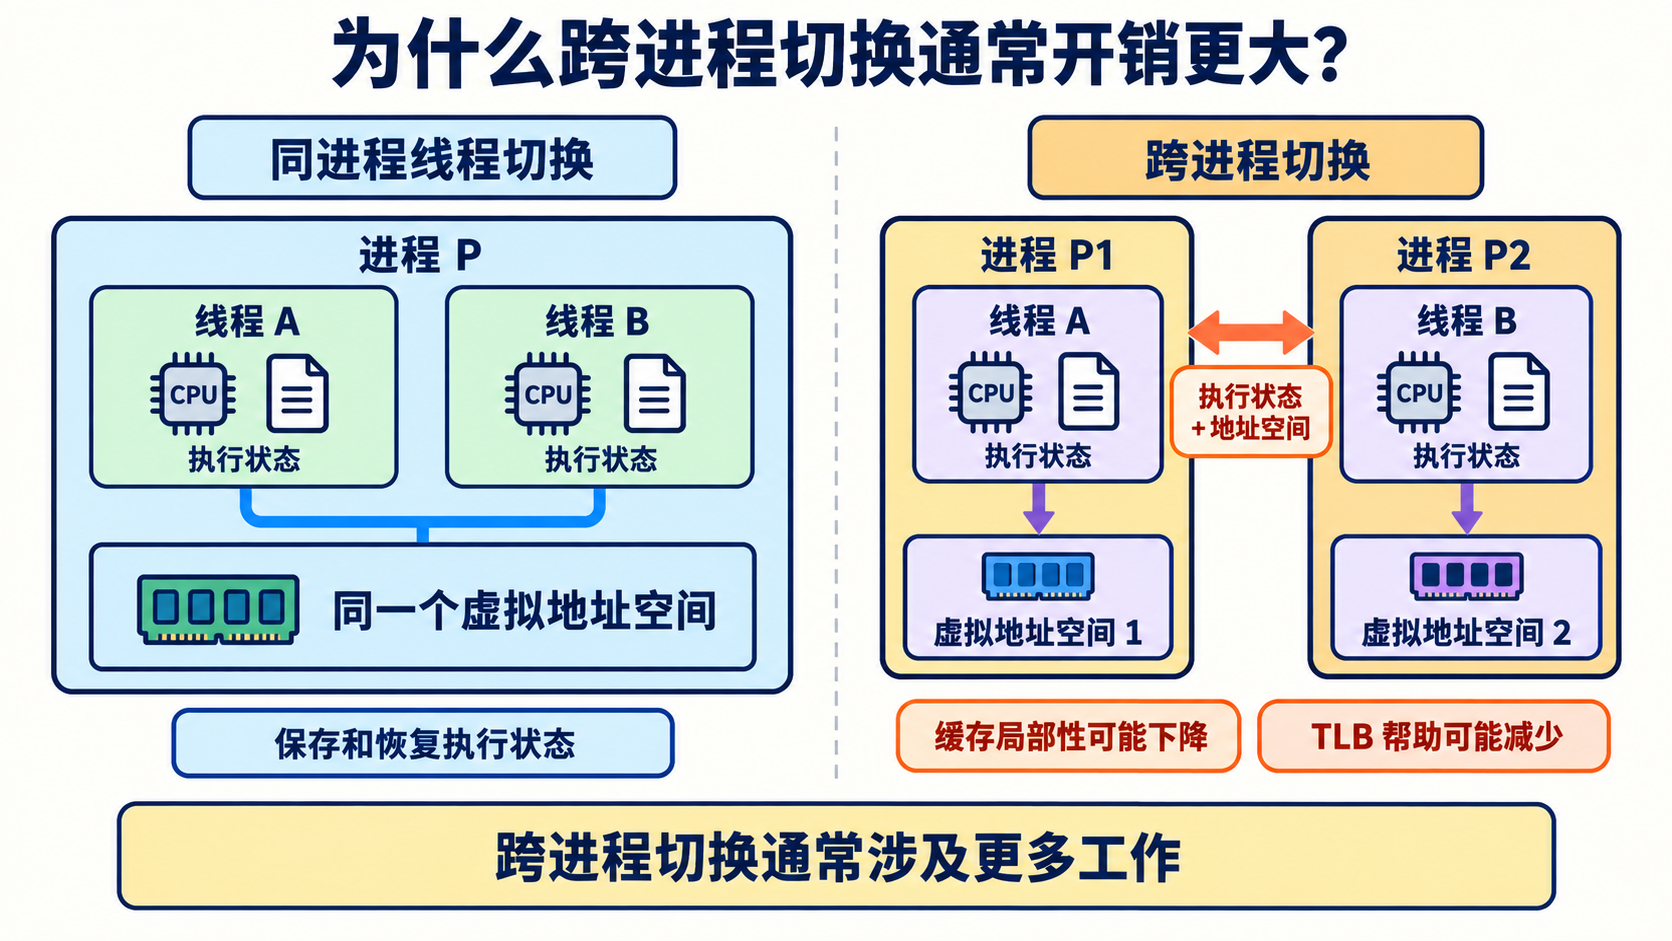
同一个进程中的线程虽然各自拥有独立的栈、寄存器状态和执行位置,但它们通常共享同一个虚拟地址空间。同一进程内线程切换时,主要需要切换线程本身的执行状态。
如果两个线程属于不同进程,它们通常拥有不同的虚拟地址空间。此时除了切换线程执行状态之外,CPU 还需要切换到另一个进程的地址空间。
因此,跨进程切换通常会涉及更多工作。
上下文切换的开销可以分成两部分。
第一部分是直接开销,例如:
- 保存和恢复寄存器状态;
- 执行调度器代码;
- 必要时切换虚拟地址空间。
第二部分是间接开销。
线程或进程切换以后,新任务访问的代码和数据可能和之前完全不同,因此 CPU Cache 中原来的数据可能无法继续利用。
如果发生了地址空间切换,之前缓存的虚拟地址到物理地址的映射也可能无法直接使用,从而产生更多 TLB Miss。
所以,上下文切换真正的成本并不只是“保存几个寄存器”,还可能来自 Cache、TLB 等硬件缓存局部性的下降。
不过需要注意:
- 进程切换并不会必然清空整个 CPU Cache;
- 地址空间切换也不意味着 TLB 一定全部失效;
- 现代处理器可以通过 PCID 等机制保留不同地址空间的部分 TLB 信息;
- 实际切换成本还取决于 CPU 架构、操作系统实现以及任务后续访问的数据。
因此只能说:
跨进程的线程切换通常比同一进程内的线程切换成本更高,而不是任何情况下都一定更慢。
系统调用一定会发生上下文切换吗?
先说结论不一定
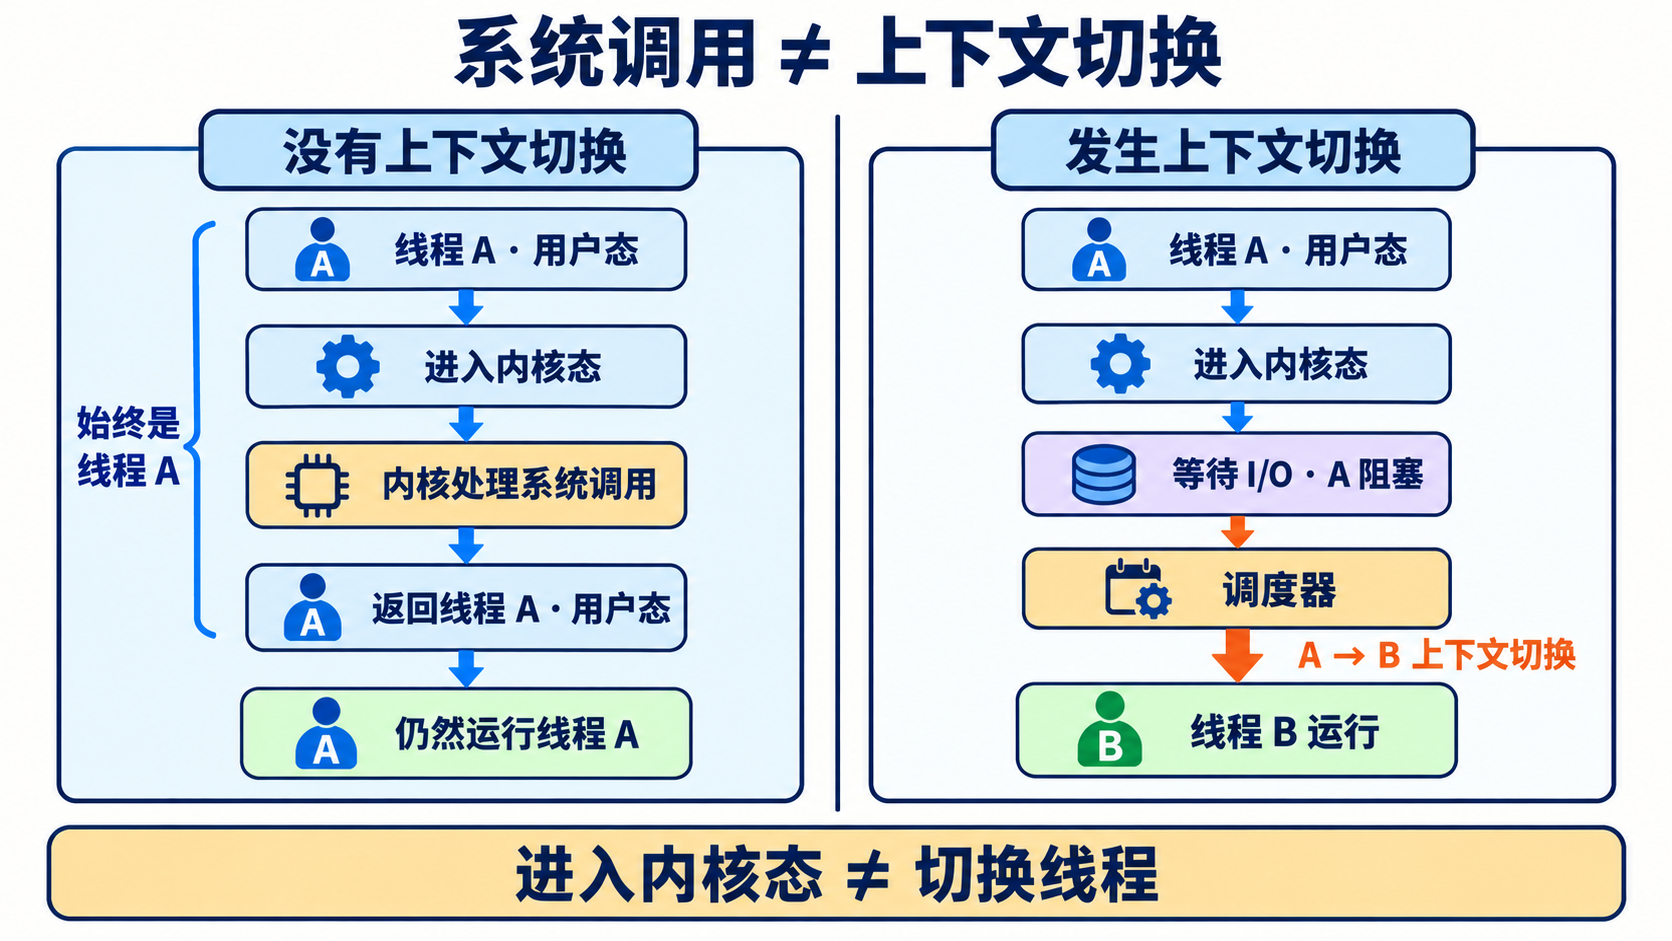
例如线程 A 调用一个系统调用:
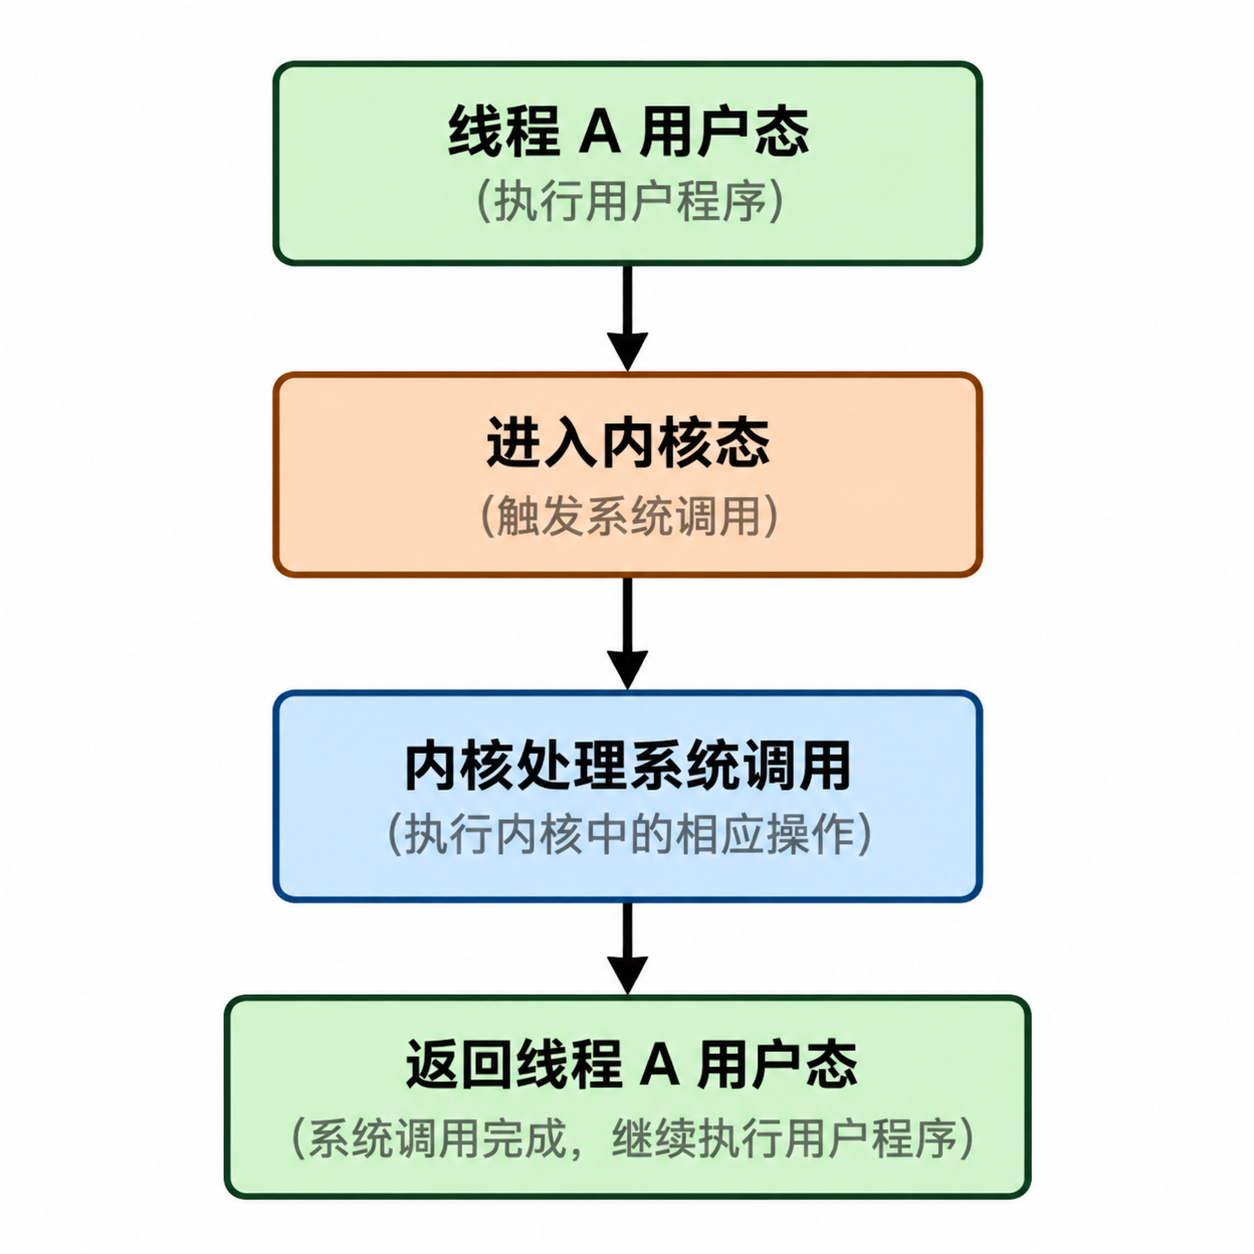
整个过程中虽然 CPU 从用户态进入了内核态,但运行的仍然是线程 A,因此并没有发生线程之间的上下文切换。
如果系统调用需要等待 I/O,线程 A 被阻塞,调度器改为执行线程 B:
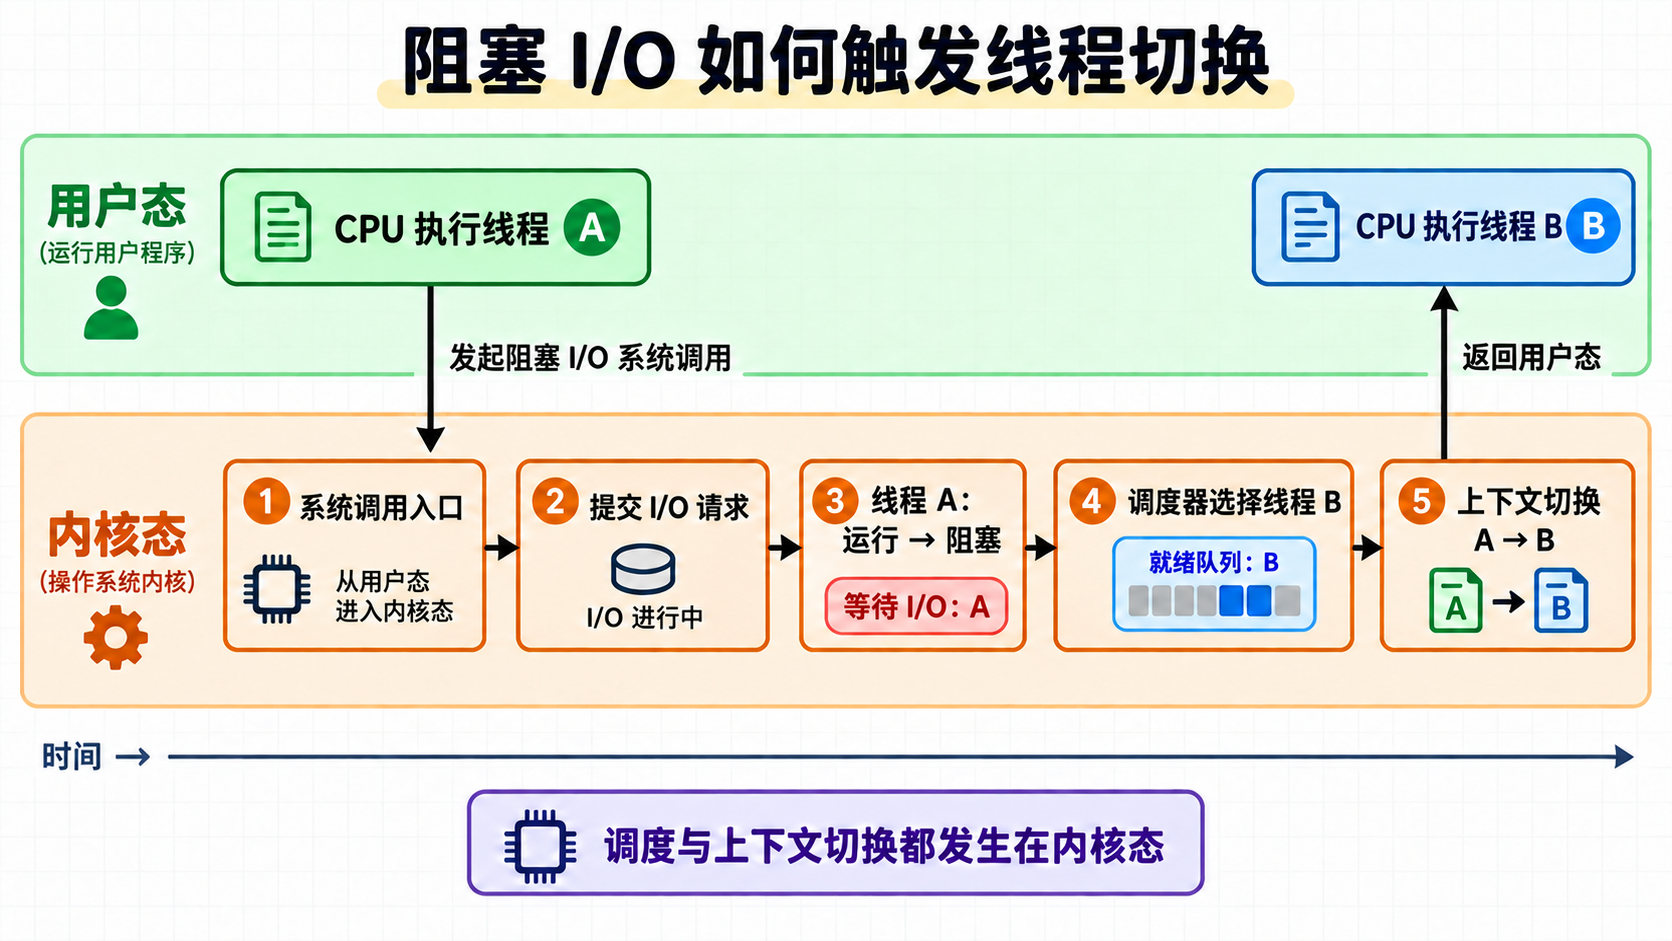
此时才真正发生了 A 到 B 的任务上下文切换。
用户态和内核态之间的切换,不等于任务上下文切换。只有 CPU 从一个线程切换到另一个线程运行,才发生了任务上下文切换。
面试总结
上下文就是一个任务能够继续执行所需要的现场,包括程序计数器、栈指针和必要的寄存器状态等。
上下文切换时,操作系统保存当前线程的执行状态,选择另一个线程,恢复其状态并继续运行。
同一个进程中的线程通常共享虚拟地址空间,因此线程切换主要涉及执行状态的切换。
如果切换的是不同进程中的线程,通常还需要切换虚拟地址空间,并可能降低 TLB 和 CPU Cache 的利用率,所以跨进程切换通常比同进程线程切换开销更大。
另外,上下文切换的成本不仅包括保存、恢复状态的直接开销,还包括 Cache Miss、TLB Miss 等带来的间接开销。
最后要注意:进入内核态并不等于发生了上下文切换。
11. 什么是进程间通信?常见方式有哪些?
假设一个进程负责接收图片,另一个进程负责压缩图片。接收进程拿到图片后,需要把数据交给压缩进程,或者至少通知它“新任务到了”。
困难在于:两个进程通常拥有各自的地址空间。 接收进程中的一个内存地址,不能直接交给压缩进程当作自己的地址使用。
让进程交换数据、发送通知或协调执行顺序的机制,统称为进程间通信(IPC)。不同方式解决的问题不完全一样:有的适合传一串数据,有的适合传一条条任务,有的让进程共同访问一块内存,还有的主要负责通知和同步。
管道:把一个进程的输出交给另一个进程
在命令 ls | less 中,ls 写出的内容会进入管道,less 再从管道读取。管道由操作系统维护,提供读端和写端,适合把一方产生的数据持续交给另一方处理。这里的 | 就是匿名管道
Linux/POSIX 中常见两种管道:
- 匿名管道没有文件系统中的名字。创建者拿到读、写两端的文件描述符,再通过创建子进程等方式,让通信双方取得对应端点,因此常用于父子进程或 Shell 启动的命令之间。
- 命名管道(FIFO)有文件系统中的路径。没有亲缘关系的本机进程,只要有权限,也可以通过这个路径打开它。
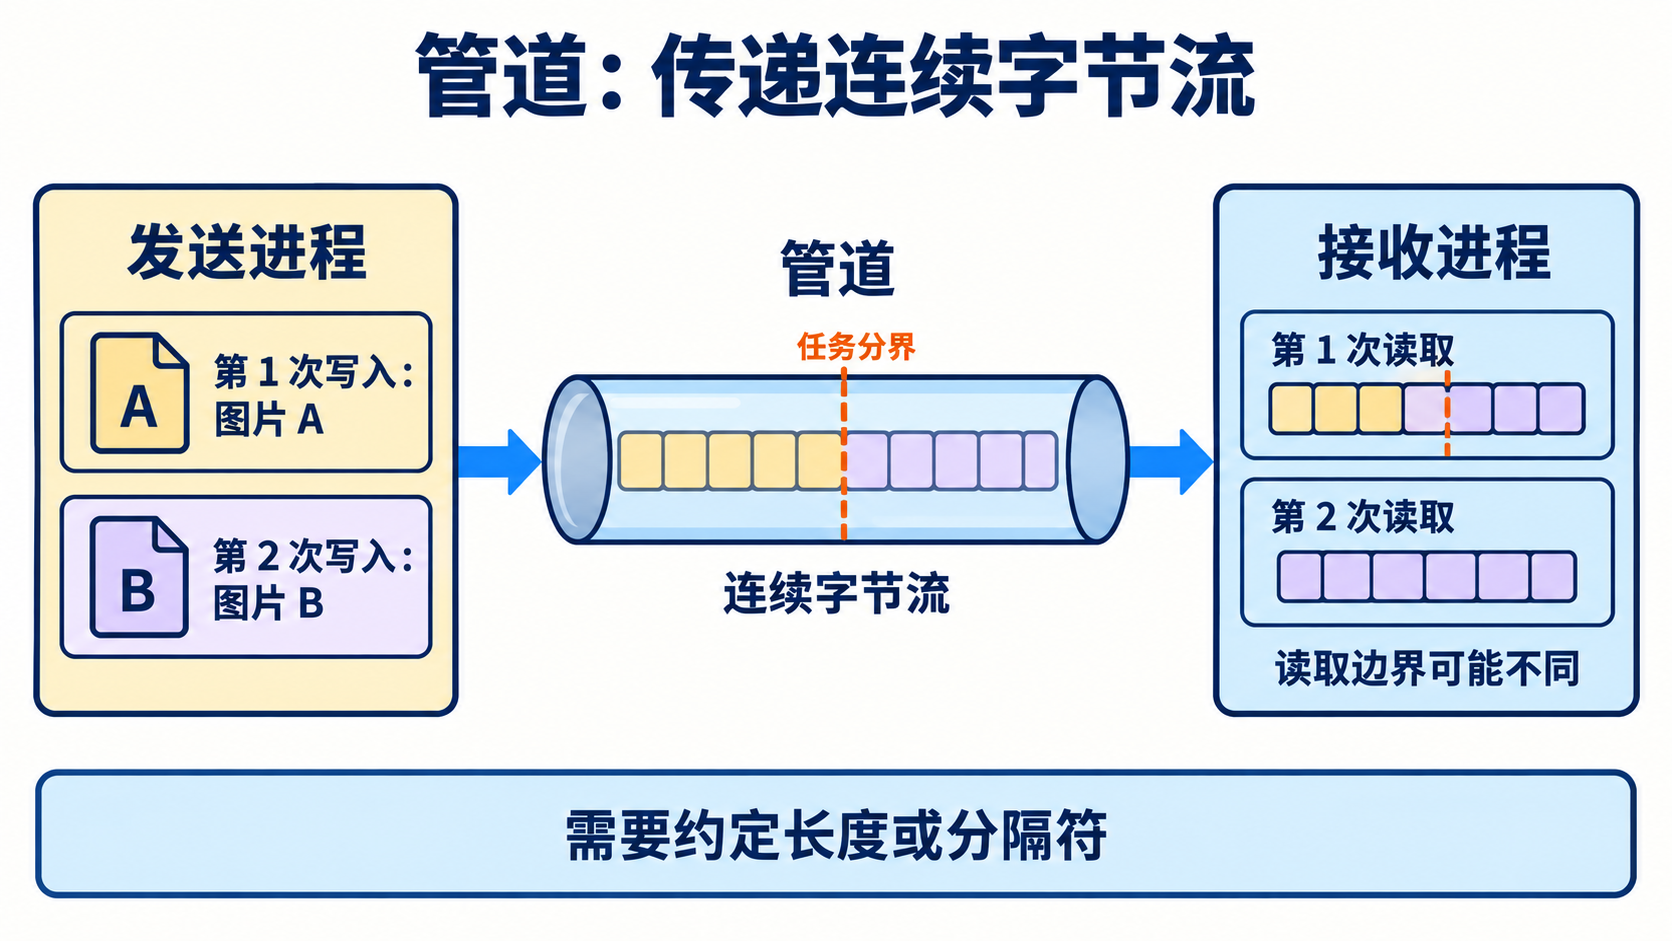
两者提供的都是字节流:写入 ABC、再写入 DE,读取方不一定恰好分两次得到 ABC 和 DE。如果业务需要识别每条消息,就要自行约定长度或分隔符。管道缓冲区容量有限,但可以一边写、一边读,不能把容量限制误认为总共只能传这么多数据。
popen() 则是启动子进程并通过管道连接它的便利接口,通常不需要把它另列为一种“高级管道”。Linux/POSIX 的 FIFO 用于本机进程通信,不能因为它有文件名就认为它能直接跨网络传输。Linux 管道与 FIFO 手册
匿名管道
匿名管道就是pipe,pipe只能在父子进程间通信,而且数据只能单向流动(半双工通信)。
使用方式:
- 父进程创建管道,会得到两个文件描述符,分别指向管道的两端;
- 父进程创建子进程,从而子进程也有两个文件描述符指向同一管道;
- 父进程可写数据到管道,子进程就可从管道中读出数据,从而实现进程间通信,下面的示例代码中通过pipe实现了每秒钟父进程向子进程都发送消息的功能。
#include <stdio.h>
#include <string.h>
#include <unistd.h>
int main() {
    int _pipe[2];
    int ret = pipe(_pipe);
    if (ret < 0) {
        perror("pipe\n");
    }
    pid_t id = fork();
    if (id < 0) {
        perror("fork\n");
    } else if (id == 0) {  // 子进程
        close(_pipe[1]);
        int j = 0;
        char _mesg[100];
        while (j < 100) {
            memset(_mesg, '\0', sizeof(_mesg));
            read(_pipe[0], _mesg, sizeof(_mesg));
            printf("%s\n", _mesg);
            j++;
        }
    } else {  // 父进程
        close(_pipe[0]);
        int i = 0;
        char *mesg = NULL;
        while (i < 100) {
            mesg = "父进程来写消息了";
            write(_pipe[1], mesg, strlen(mesg) + 1);
            sleep(1);
            ++i;
        }
    }
    return 0;

}
我们平时也经常使用关于管道的命令行:
ls | less
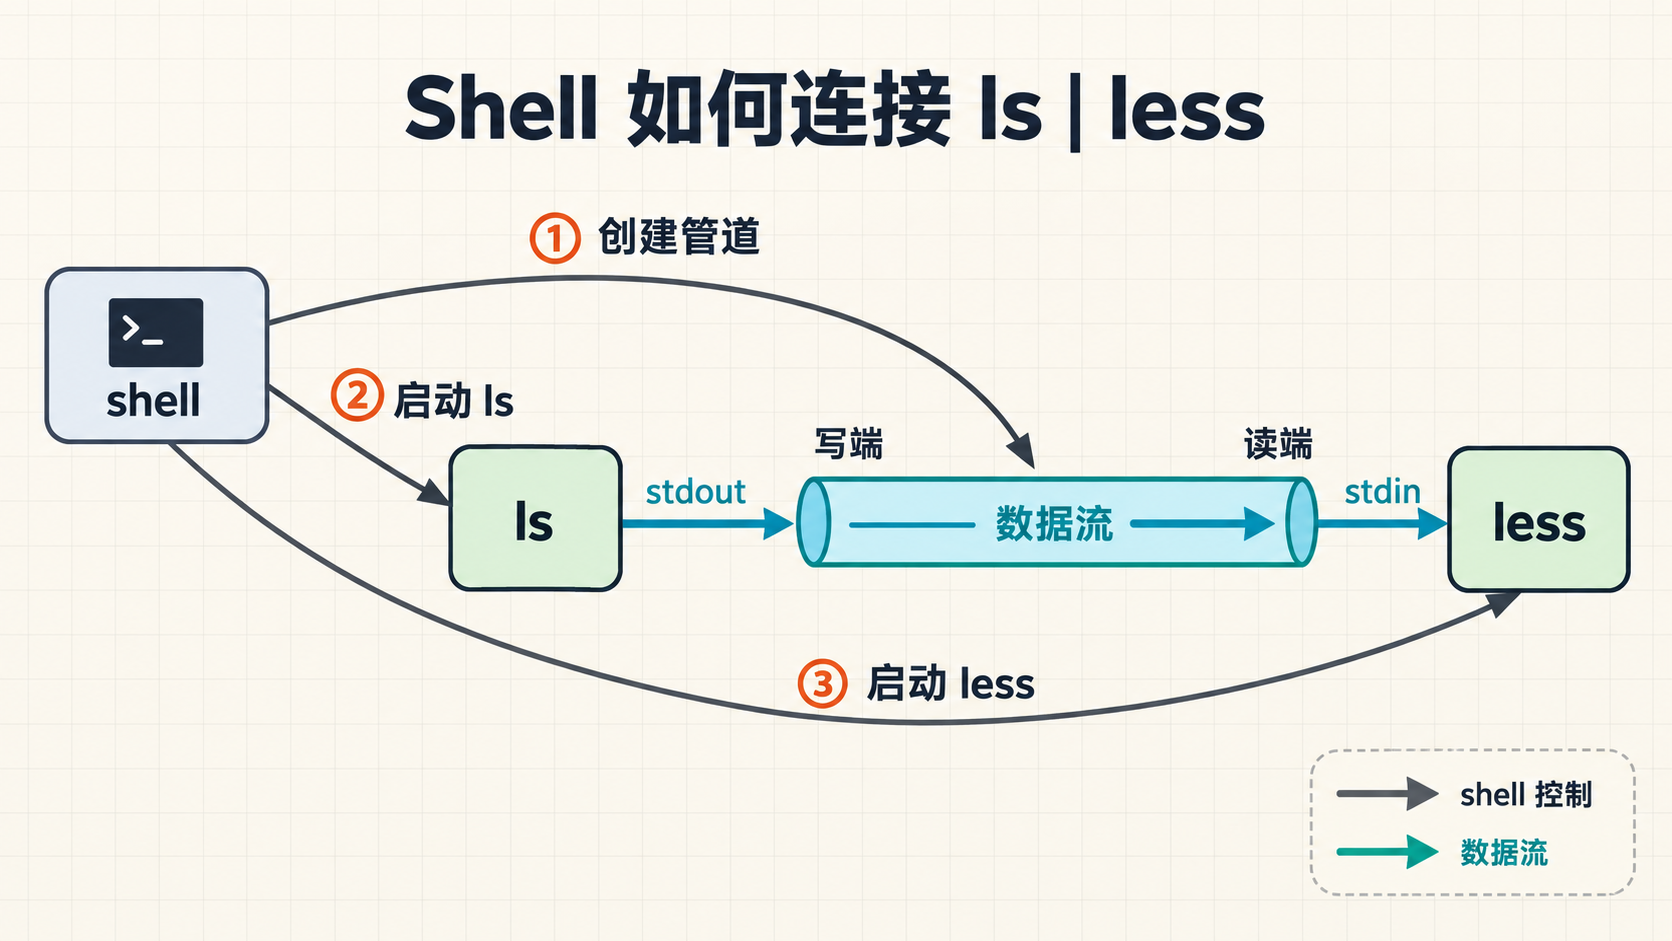
- 创建管道
- 为ls创建一个进程,设置stdout为管理写端
- 为less创建一个进程,设置stdin为管道读端
高级管道
其实也算匿名管道了。
通过popen将另一个程序当作一个新的进程在当前进程中启动,它算作当前进程的子进程,高级管道只能用在有亲缘关系的进程间通信,这种亲缘关系通常指父子进程,下面的GetCmdResult函数可以获取某个Linux命令执行的结果,实现方式就是通过popen。
#include <array>
#include <cstdio>
#include <iostream>
#include <memory>
#include <stdexcept>
#include <string>

std::string GetCmdResult(const std::string& cmd, std::size_t max_size = 10240) {
    const std::string full_cmd = cmd + " 2>&1";

    std::unique_ptr<FILE, decltype(&pclose)> pipe(
        popen(full_cmd.c_str(), "r"),
        pclose
    );

    if (!pipe) {
        throw std::runtime_error("popen failed");
    }

    std::array<char, 256> buffer{};
    std::string result;
    result.reserve(max_size);

    while (fgets(buffer.data(),
                 static_cast<int>(buffer.size()),
                 pipe.get()) != nullptr) {

        const std::size_t len = std::char_traits<char>::length(buffer.data());

        if (result.size() + len > max_size) {
            result.append(buffer.data(), max_size - result.size());
            break;
        }

        result.append(buffer.data(), len);
    }

    return result;
}

int main() {
    try {
        const std::string result = GetCmdResult("ls -l");

        std::cout << "Command result:\n";
        std::cout << result;

    } catch (const std::exception& e) {
        std::cerr << "Error: " << e.what() << '\n';
        return 1;
    }

    return 0;
}
命名管道
有名字,可以双向传输,可以在非亲缘关系的进程间传输。
匿名管道有个缺点就是通信的进程一定要有亲缘关系,而命名管道就不需要这种限制。
命名管道其实就是一种特殊类型的文件,所谓的命名其实就是文件名,文件对各个进程都可见,通过命名管道创建好特殊文件后,就可以实现进程间通信。
可以通过mkfifo创建一个特殊的类型的文件,参数读者看名字应该就了解,一个是文件名,一个是文件的读写权限:
#include <fcntl.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <unistd.h>

#include <cstring>
#include <iostream>
#include <string>

int main() {
    const char* fifo_path = "/tmp/my_fifo";

    // 1. 创建命名管道
    if (mkfifo(fifo_path, 0666) == -1) {
        // 如果管道已经存在,不算错误
        if (errno != EEXIST) {
            perror("mkfifo");
            return 1;
        }
    }

    pid_t pid = fork();

    if (pid < 0) {
        perror("fork");
        unlink(fifo_path);
        return 1;
    }

    if (pid == 0) {
        // 子进程:读数据
        int fd = open(fifo_path, O_RDONLY);
        if (fd == -1) {
            perror("open read");
            return 1;
        }

        char buffer[1024]{};

        ssize_t n = read(fd, buffer, sizeof(buffer) - 1);
        if (n == -1) {
            perror("read");
            close(fd);
            return 1;
        }

        buffer[n] = '\0';

        std::cout << "子进程收到数据: " << buffer << std::endl;

        close(fd);
    } else {
        // 父进程:写数据
        int fd = open(fifo_path, O_WRONLY);
        if (fd == -1) {
            perror("open write");
            unlink(fifo_path);
            return 1;
        }

        std::string message = "Hello FIFO";

        ssize_t n = write(fd, message.data(), message.size());
        if (n == -1) {
            perror("write");
        }

        std::cout << "父进程发送数据: " << message << std::endl;

        close(fd);

        // 等待子进程结束
        waitpid(pid, nullptr, 0);

        // 删除命名管道文件
        unlink(fifo_path);
    }

    return 0;
}
当返回值为0时,表示该命名管道创建成功,至于如何通信,其实就是个读写文件的问题!
管道的优点:方便,可以传输大量数据。
管道的缺点:效率相对于共享内存来说较低。
消息队列:按一条条完整消息传递任务
假设图片处理进程连续发送两项任务:
任务 1:压缩图片 A
任务 2:压缩图片 B
接收进程必须知道哪里是第一项任务的结尾、哪里是第二项任务的开头。如果双方使用管道,管道只提供连续的字节流:发送方分两次写入,接收方不一定恰好分两次读出。程序需要自行约定每条任务的长度或分隔符。
消息队列解决的是“怎样按条传递数据”的问题。发送方将每项任务作为一条消息提交;接收方每次从队列中取出一条消息。系统保留消息之间的边界,因此接收方能区分“压缩图片 A”和“压缩图片 B”,不必从连续字节中自行找出分界线。
可以把基本过程理解为:
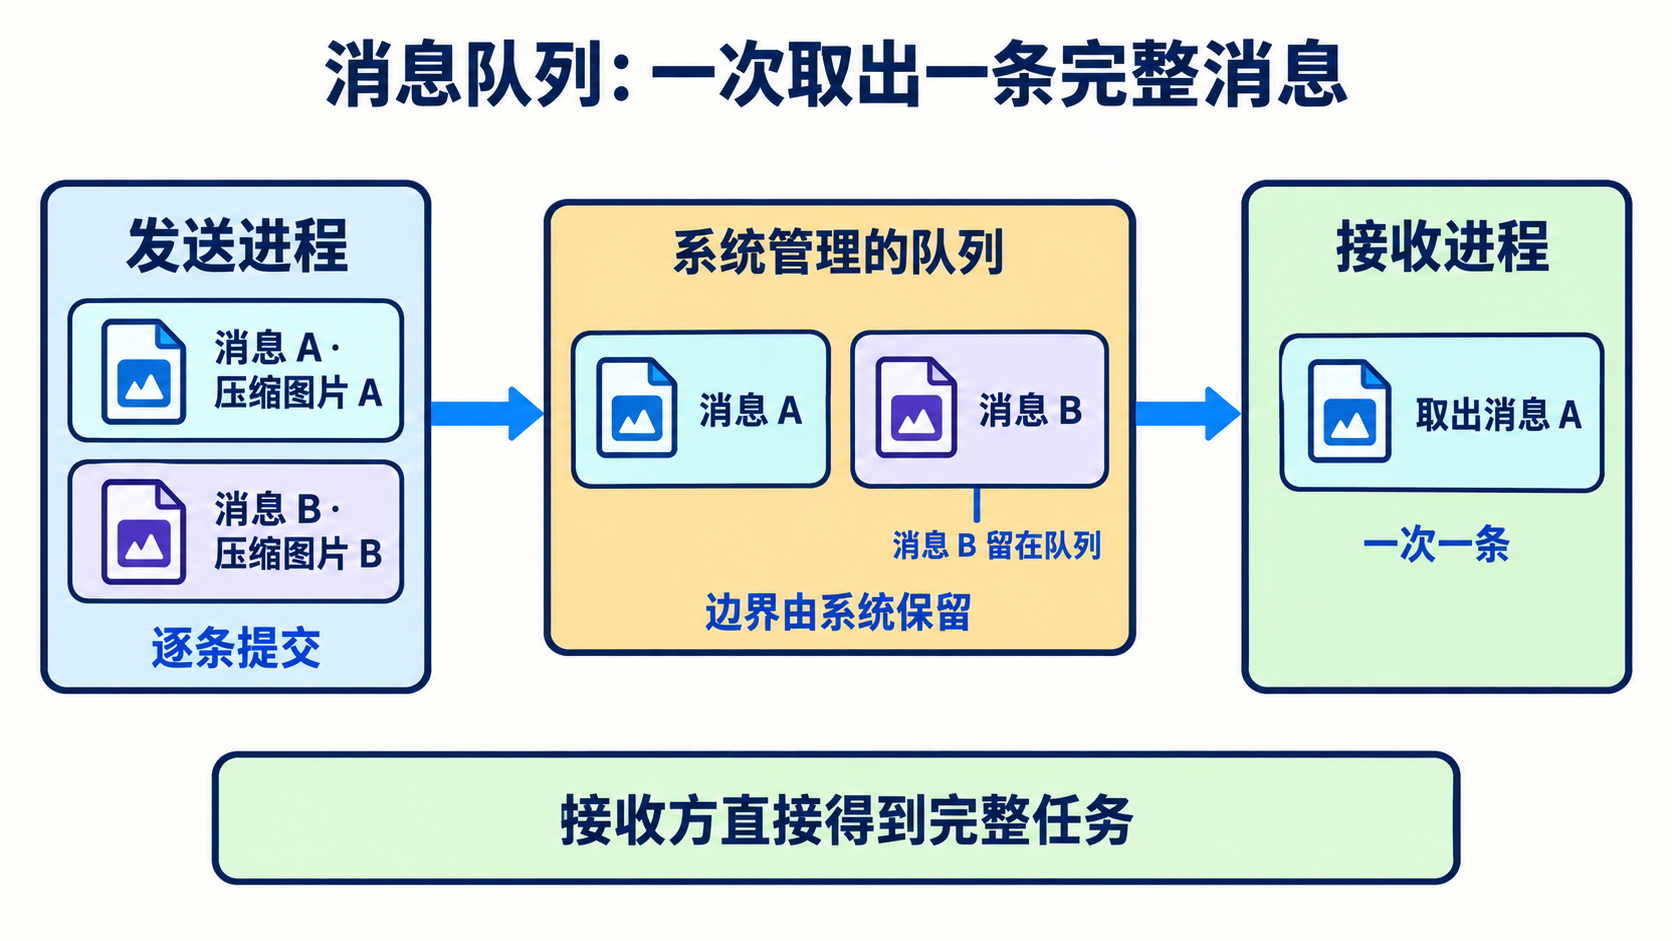
如果有多个接收进程共同从一个队列取任务,某条消息被其中一个接收方取走后,其他接收方通常不会再从该队列取到同一条消息。这使它适合在本机进程之间分配小型任务或传递控制信息。
在Linux中消息队列相关的函数调用如下:
// 创建和访问一个消息队列
int msgget(key_t, key, int msgflg);
// 用来把消息添加到消息队列中
int msgsend(int msgid, const void *msg_ptr, size_t msg_sz, int msgflg);
// msg_ptr是结构体数据的指针,结构第一个字段要有个类型:struct Msg {
    long int message_type;
    // 想要传输的数据
};
// 从消息队列中获取消息
int msgrcv(int msgid, void *msg_ptr, size_t msg_st, long int msgtype, int msgflg);
// 用来控制消息队列,不同的command参数有不同的控制方式
int msgctl(int msgid, int command, struct msgid_ds *buf);
示例代码如下:
#include <errno.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/msg.h>

#include <chrono>
#include <iostream>
#include <thread>

using namespace std;

#define BUFFER_SIZ 20

typedef struct {
    long int msg_type;
    char text[BUFFER_SIZ];
} MsgWrapper;

void Receive() {
    MsgWrapper data;
    long int msgtype = 2;
    int msgid = msgget((key_t)1024, 0666 | IPC_CREAT);
    if (msgid == -1) {
        cout << "msgget error \n";
        return;
    }
    while (true) {
        if (msgrcv(msgid, (void *)&data, BUFFER_SIZ, msgtype, 0) == -1) {
            cout << "error " << errno << endl;
        }
        cout << "read data " << data.text << endl;
        if (strlen(data.text) > 6) {  // 发送超过6个字符的数据,结束
            break;
        }
    }
    if (msgctl(msgid, IPC_RMID, 0) == -1) {
        cout << "msgctl error \n";
    }
    cout << "Receive ok \n";
}

void Send() {
    MsgWrapper data;
    long int msgtype = 2;
    int msgid = msgget((key_t)1024, 0666 | IPC_CREAT);
    if (msgid == -1) {
        cout << "msgget error \n";
        return;
    }
    data.msg_type = msgtype;
    for (int i = 0; i < 10; ++i) {
        memset(data.text, 0, BUFFER_SIZ);
        char a = 'a' + i;
        memset(data.text, a, 1);
        if (msgsnd(msgid, (void *)&data, BUFFER_SIZ, 0) == -1) {
            cout << "msgsnd error \n";
            return;
        }
        std::this_thread::sleep_for(std::chrono::seconds(1));
    }
    memcpy(data.text, "1234567", 7);
    if (msgsnd(msgid, (void *)&data, BUFFER_SIZ, 0) == -1) {
        cout << "msgsnd error \n";
        return;
    }
}

int main() {
    std::thread r(Receive);
    r.detach();
    std::thread s(Send);
    s.detach();
    std::this_thread::sleep_for(std::chrono::seconds(20));
    return 0;
}

输出:root@iZuf64idor3ej648ciairaZ:~# ./a.out
read data a
read data b
read data c
read data d
read data e
read data f
read data g
read data h
read data i
read data j
read data 1234567
Receive ok
代码中为了演示方便使用消息队列进行的线程间通信,该代码同样用于进程间通信,消息队列的实现依赖于内核的支持,上述代码可能在某些系统(WSL)上不能运行,在正常的Ubuntu上可以正常运行。
消息队列和管道该怎么选?
两者都能传数据,区别主要在于是否需要系统帮忙保留消息边界:
- 传输命令输出、连续文本等内容,可以考虑管道。需要区分一条条记录时,由应用自行定义格式。
- 传输“创建任务”“取消任务”这类独立指令,可以考虑消息队列。发送和接收都以消息为单位。
消息队列也有代价:队列能容纳的消息数量、单条消息大小都受限制;队列为空或已满时,操作还需要按阻塞或非阻塞方式处理。它不会自动保证“任务一定处理成功”或“业务效果恰好发生一次”,这些仍需应用自己设计。
共享内存:让两个进程访问同一份数据
假设一个进程接收图片,另一个进程负责压缩。接收进程拿到图片后,可以通过管道等方式把图片发送给压缩进程。但如果图片较大,而且双方需要反复交换数据,每次都走发送、接收流程,可能产生较多数据复制开销。
共享内存提供另一种办法:让两个进程各自在自己的地址空间中,访问同一块底层内存。 接收进程把图片放进去,压缩进程就能从自己的映射中读取这份数据。
通常情况下,进程 A 的内存地址不能直接交给进程 B 使用。即使双方都访问地址 0x1000,它们看到的也可能是完全不同的数据。
使用共享内存时,操作系统为双方建立映射关系。可以这样理解:
接收进程中的某个地址 ─┐
                     ├─→ 同一块底层内存
压缩进程中的某个地址 ─┘
两个进程使用的地址不必相同,但最终访问的是同一份数据。因此,不能把接收进程中的普通指针直接发给压缩进程使用;对方需要通过自己的映射找到数据。Linux POSIX 共享内存手册

为什么共享了内存,还需要同步?
共享内存只解决了“双方怎样访问同一份数据”,没有规定“什么时候可以访问”。
假设共享区域一次只能放一张图片:
- 接收进程开始写入图片,暂时只写完一半。
- 压缩进程此时读取,就可能拿到不完整的图片。
- 接收进程写完后,需要通知压缩进程:现在可以读。
- 压缩进程读完后,也需要通知接收进程:现在可以放下一张,不能在我读取时覆盖。
因此,双方通常还要使用适合跨进程的信号量、互斥锁等同步机制,协调“可写、写完、可读、读完”的顺序。
共享内存负责放数据,同步机制负责确定何时安全地读写。
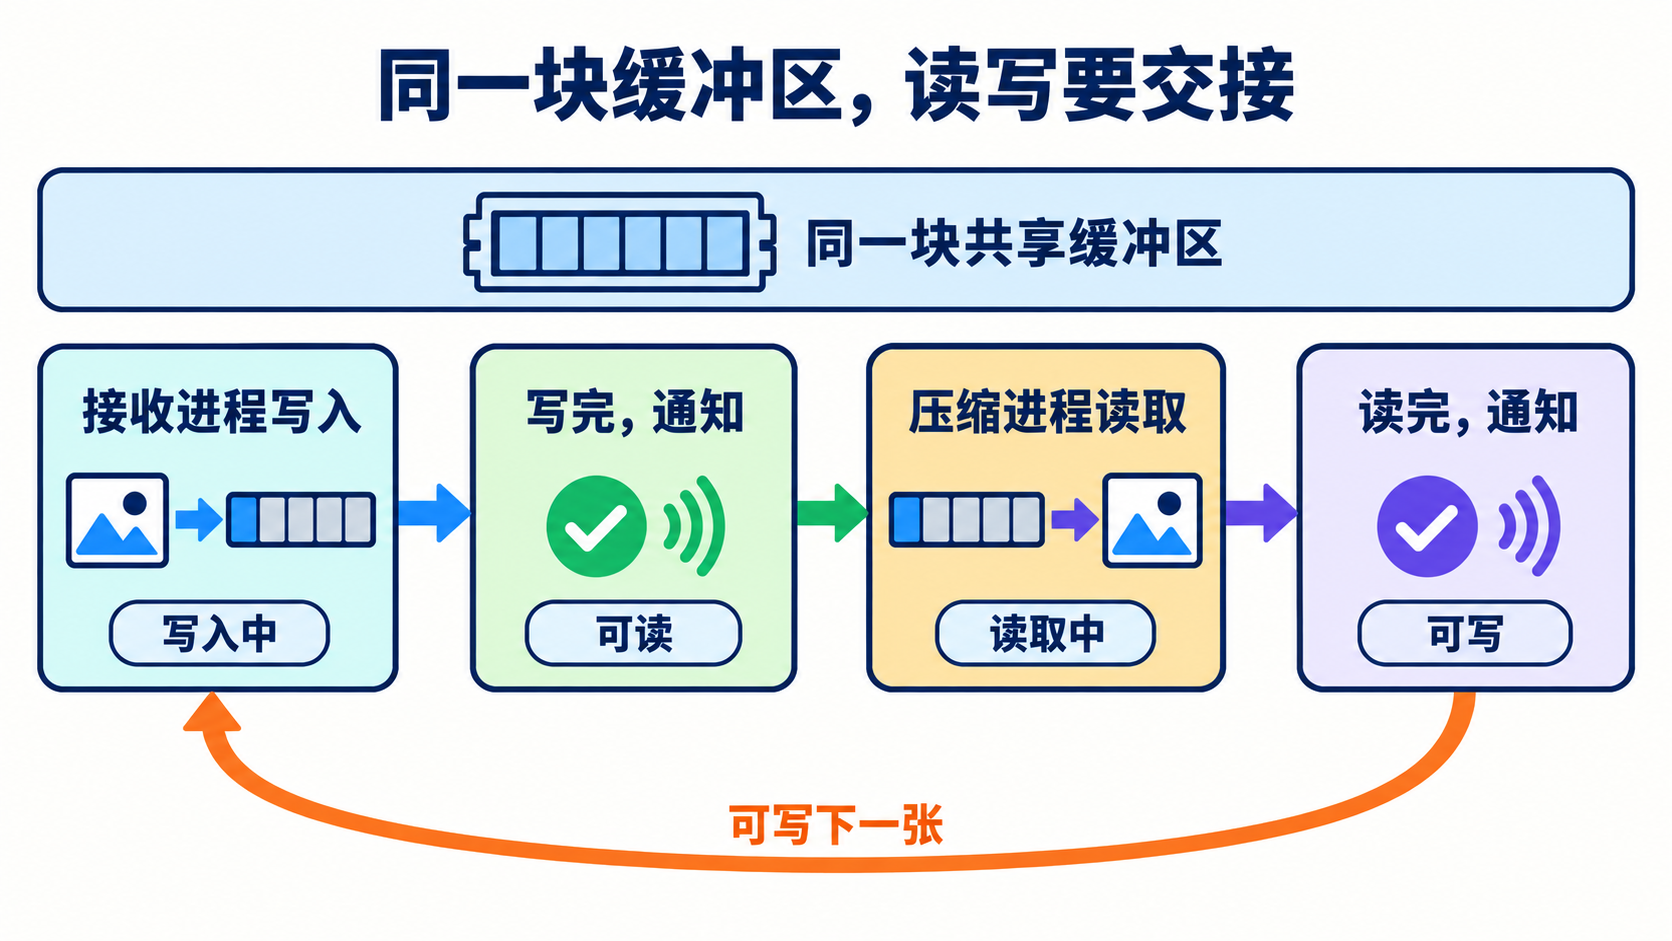
建立共享区域和映射时,仍需要操作系统参与。映射完成后,进程可以像访问内存一样读写共享数据,不必为每次交换内容都调用发送、接收接口,因此特别适合同一台机器上频繁交换较大数据的场景。
但共享内存不意味着整个图片处理过程“零拷贝”,也不保证所有场景都比其他通信方式快。它把数据组织、访问权限、读写同步和缓冲区复用等问题留给了使用它的程序。
信号量
假设一个服务只有两个可用的处理槽位,却有三个进程同时想提交任务。前两个可以开始,第三个必须等到有槽位空出来。
信号量就是用来协调这类情况的同步机制。
可以把它的值理解为“目前还剩多少个可用许可”:初始值设为 2,表示最多允许两个进程同时使用资源。进程不能像修改普通变量那样自行读取、减一,而要通过信号量提供的操作取得或归还许可,避免两个进程同时拿到最后一个名额。
P 和 V 操作如何工作?
教材通常把两个操作称为 P 和 V;在 POSIX 信号量接口中,分别可以用 sem_wait() 和 sem_post() 理解:
- P:申请一个许可。 如果当前值大于 0,就原子地减 1,然后继续执行;如果值为 0,调用者通常等待。
- V:增加一个许可。 原子地把值加 1;如果有人正在等待,这个许可可以使等待者获得继续执行的机会。
以前面的两个槽位为例:
| 发生的事 | 可用许可数 |
|---|---|
| 初始有两个空槽 | 2 |
| 进程 A 执行 P,取得一个槽位 | 1 |
| 进程 B 执行 P,取得另一个槽位 | 0 |
| 进程 C 执行 P,没有空槽,等待 | 0 |
| A 用完后执行 V,C 随后可取得释放的许可 | C 取得后为 0 |
关键在于 P 和 V 对计数的修改是原子的。当只剩一个许可时,不会有两个进程都成功取得它。原文将 V 写成“有人等待就只唤醒,否则才加一”不够准确:以 POSIX 信号量为例,sem_post() 执行的是增加计数,并使等待者有机会完成取许可操作。Linux POSIX 信号量手册
信号量除了限制数量,还能做什么?
信号量也可以用来约定先后顺序。例如共享内存里的一张图片必须先写完才能读取:
- 将“图片已写好”的信号量初始值设为 0,读取进程执行 P 后等待。
- 写入进程写完图片,执行 V。
- 读取进程取得许可后,再开始读取图片。
此时信号量传递的是“现在可以读了”这一条件,图片内容仍放在共享内存中。信号量负责协调,不负责传输业务数据。
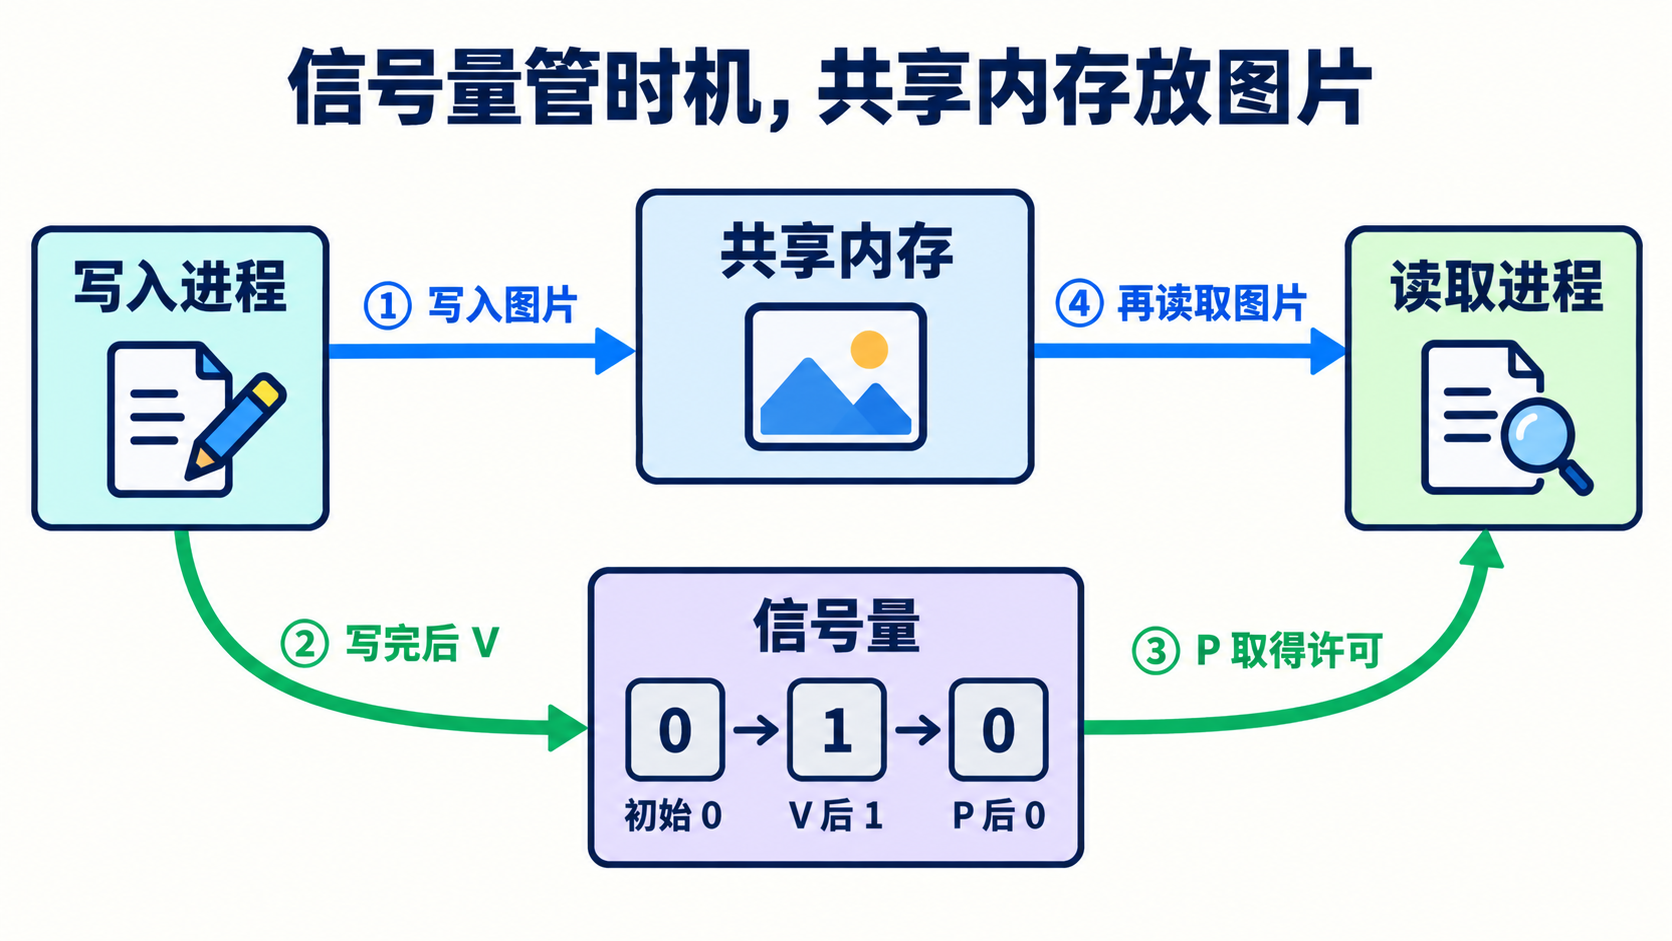
初始值为 1 时,信号量还可以让同一时刻最多一个执行者进入某段操作,称为二值信号量。它能用于互斥,但不应与互斥锁完全画等号:互斥锁通常强调由持锁者解锁,信号量更侧重许可计数与任务间的同步。
简单总结
信号量是用计数来协调进程或线程执行的同步机制,常用来限制资源同时使用的数量,或规定任务执行的先后顺序。P 操作申请许可:有许可则原子地减一,没有则等待;V 操作增加许可,并可能让等待者继续。它解决的是“谁现在可以做”,共享内存等机制解决的是“数据放在哪里”。
信号
什么是信号?Linux 如何处理信号?
假设一个程序正在运行,用户按下 Ctrl+C,希望它停止。终端不需要向程序传一段长数据,只需要告诉它:发生了中断请求。
Linux 中的信号(Signal)就是这种事件通知机制。信号可以由终端、其他进程或内核产生,用来通知进程或线程发生了某类事件。例如,终端上的 Ctrl+C 通常使前台进程组收到 SIGINT;程序访问非法内存时,内核可能产生 SIGSEGV。Linux 终端接口手册、Linux 信号手册
从发出信号到处理信号,经历了什么?
可以按三个阶段理解:
- 产生:用户按键、其他进程调用发送信号的接口,或内核检测到事件。
- 等待递送:信号已经产生,但还没有交给目标执行相应动作时,称为未决信号。
- 递送与处理:内核在合适时机递送信号,目标按预先确定的方式响应。
响应方式通常有三种:执行该信号的默认动作,忽略它,或运行程序注册的信号处理函数。默认动作因信号而异,可能是终止、暂停、继续运行等。程序通常使用 sigaction() 设置信号处理方式。
例如,服务收到 SIGTERM 后,可以在处理函数中记录“需要退出”,再由正常执行流程完成清理;如果没有自定义处理,SIGTERM 的默认动作是终止进程。不过,并非所有信号都能这样处理:SIGKILL 和 SIGSTOP 不能被捕获、忽略或屏蔽。Linux 信号手册
“阻塞信号”是什么意思?
这里的阻塞信号,是指暂时屏蔽某类信号的递送,和“进程等待磁盘数据而进入阻塞态”不是同一件事。
如果一个线程暂时屏蔽了某个信号,信号产生后可以保持未决;解除屏蔽后,才有机会被递送。因此,不能简单说“进程当前没在 CPU 上运行,内核就一定等它重新运行后才发送”。真正要看的是信号是否已经产生、是否被屏蔽,以及内核何时递送。
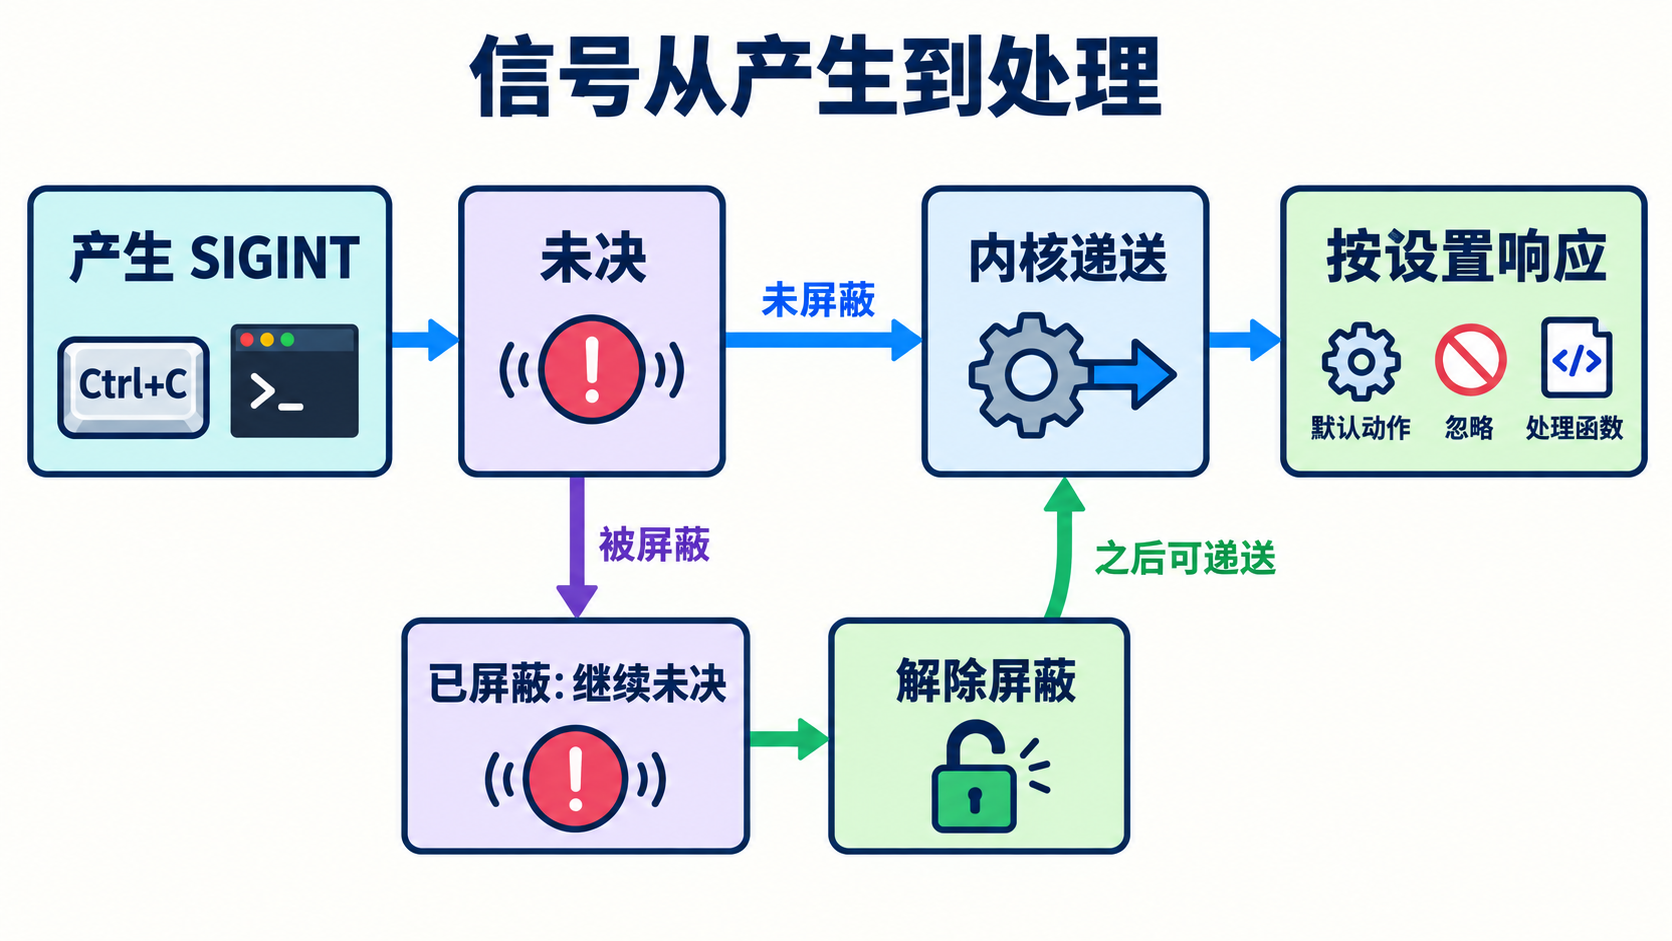
还要注意:普通信号不是一条条可靠排队的业务消息。同一种普通信号在屏蔽期间反复产生,通常只保留一次未决状态。Linux 的实时信号可以排队,sigqueue() 等接口还可以附带有限数据,但信号总体上仍更适合事件通知,不适合传输大量业务内容。Linux 信号排队规则
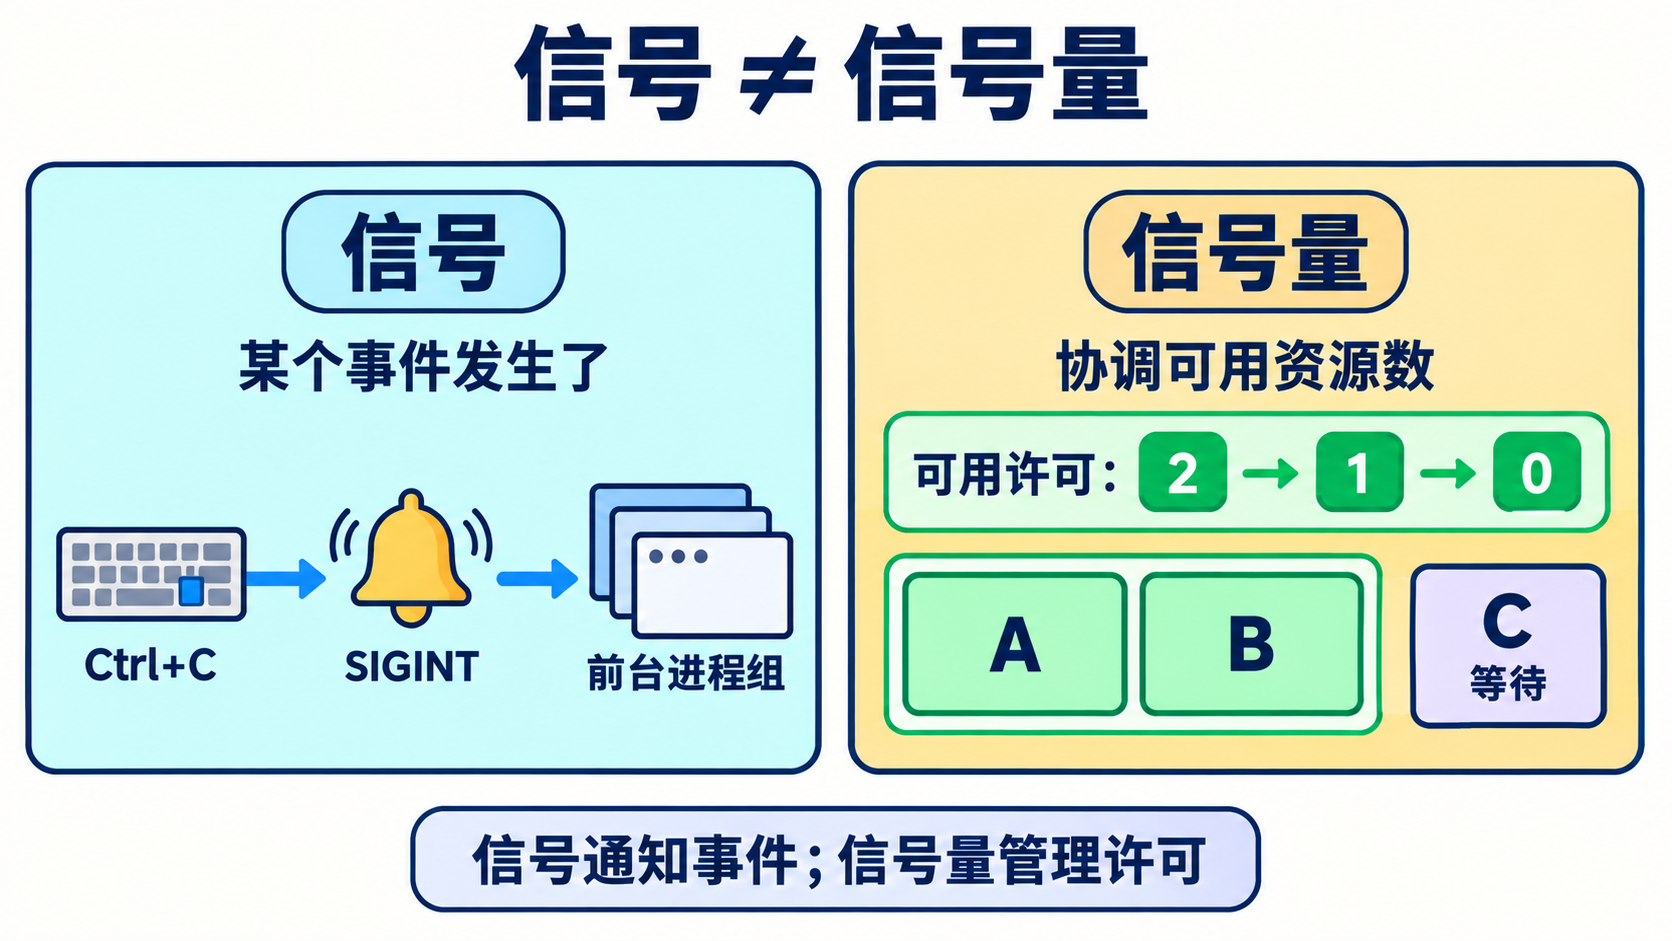
信号和信号量有什么区别?
两者名字相近,解决的问题不同:
- 信号告诉目标“某个事件发生了”,例如请求终止或子进程退出。
- 信号量用计数协调“现在有几个资源可用、谁需要等待”,例如限制同时使用共享缓冲区的进程数量。
总结
信号是操作系统提供的事件通知机制,可以由终端、进程或内核产生。信号产生后,若尚未递送就处于未决状态;被屏蔽的信号通常要等解除屏蔽后才能递送。目标收到信号时,可以按默认动作处理、忽略,或在允许的情况下执行自定义处理函数。
信号主要用于通知,不适合传输大量数据;普通信号重复产生还可能合并,不能把它当作可靠的消息队列。它与用于资源计数和同步的信号量是两种不同机制。
信号也是进程间通信的一种方式,信号可以在任何时候发送给某一个进程,如果进程当前并未处于执行状态,内核将信号保存,直到进程恢复到执行态再发送给进程,进程可以对信号设置预处理方式,如果对信号设置了阻塞处理,则信号的传递会被延迟直到阻塞被取消,如果进程结束,那信号就被丢弃。我们常用的CTRL+C和kill等就是信号的一种,也达到了进程间通信的目的,进程也可以对信号设置signal捕获函数自定义处理逻辑。
这种方式有很大的缺点:只有通知的作用,通知了一下消息的类型,但不能传输要交换的任何数据。
Linux系统中常见的信号有:
- SIGHUP:该信号在用户终端结束时发出,通常在中断的控制进程结束时,所有进程组都将收到该信号,该信号的默认操作是终止进程;
- SIGINT:程序终止信号,通常的CTRL+C产生该信号来通知终止进程;
- SIGQUIT:类似于程序错误信号,通常的CTRL+\产生该信号通知进程退出时产生core文件;
- SIGILL:执行了非法指令,通常数据段或者堆栈溢出可能产生该信号;
- SIGTRAP:供调试器使用,由断电指令或其它陷阱指令产生;
- SIGABRT:使程序非正常结束,调用abort函数会产生该信号;
- SIGBUS:非法地址,通常是地址对齐问题导致,比如访问一个4字节长的整数,但其地址不是4的倍数;
- SIGSEGV:合理地址的非法访问,访问了未分配的内存或者没有权限的内存区域;
- SIGPIPE:管道破裂信号,socket通信时经常会遇到,进程写入了一个无读者的管道;
- SIGALRM:时钟定时信号,由alarm函数设置的时间终止时产生;
- SIGFPE:出现浮点错误(比如除0操作);
- SIGKILL:杀死进程(不能被捕捉和忽略);
Socket
Socket:让两个进程直接收发数据
前面介绍的管道、消息队列和共享内存,主要用于同一台机器上的进程。如果图片接收服务在一台机器,压缩服务在另一台机器,它们该怎么通信?
这时可以使用 Socket。Socket 是操作系统提供的通信端点:接收服务通过自己的 Socket 发送图片数据,压缩服务通过另一端的 Socket 接收。程序只需按相应接口收发数据,网络传输由操作系统配合网络设备完成。

Socket 也不只用于跨机器:
- 同一台机器上的进程可以使用 Unix Domain Socket。
- 不同机器上的进程可以使用 TCP 等网络 Socket。
两种方式解决的都是“让进程建立通信并交换数据”,区别在于通信范围和所用协议。Linux Unix Domain Socket 手册
还要注意数据的组织方式。TCP 提供的是连续的字节流:发送方调用一次发送,接收方不一定恰好用一次接收取得同样大小的数据。如果业务需要区分“图片 A”和“图片 B”,就要自己约定长度或其他消息边界。不能把一个 Socket直接理解为一条完整消息。Linux TCP 手册
server.cpp
#include <arpa/inet.h>
#include <cstring>
#include <iostream>
#include <sys/socket.h>
#include <unistd.h>

int main() {
    // 1. 创建 Socket
    int server_fd = socket(AF_INET, SOCK_STREAM, 0);
    if (server_fd == -1) {
        perror("socket");
        return 1;
    }

    // 允许端口快速复用
    int opt = 1;
    setsockopt(server_fd, SOL_SOCKET, SO_REUSEADDR, &opt, sizeof(opt));

    // 2. 配置服务器地址
    sockaddr_in server_addr{};
    server_addr.sin_family = AF_INET;
    server_addr.sin_port = htons(8888);
    server_addr.sin_addr.s_addr = htonl(INADDR_ANY);

    // 3. 绑定 IP 和端口
    if (bind(server_fd,
             reinterpret_cast<sockaddr*>(&server_addr),
             sizeof(server_addr)) == -1) {
        perror("bind");
        close(server_fd);
        return 1;
    }

    // 4. 监听连接
    if (listen(server_fd, 5) == -1) {
        perror("listen");
        close(server_fd);
        return 1;
    }

    std::cout << "服务器启动,监听端口 8888...\n";

    // 5. 等待客户端连接
    sockaddr_in client_addr{};
    socklen_t client_len = sizeof(client_addr);

    int client_fd = accept(
        server_fd,
        reinterpret_cast<sockaddr*>(&client_addr),
        &client_len
    );

    if (client_fd == -1) {
        perror("accept");
        close(server_fd);
        return 1;
    }

    std::cout << "客户端已连接:"
              << inet_ntoa(client_addr.sin_addr)
              << "\n";

    // 6. 接收客户端数据
    char buffer[1024]{};

    ssize_t n = recv(
        client_fd,
        buffer,
        sizeof(buffer) - 1,
        0
    );

    if (n > 0) {
        buffer[n] = '\0';

        std::cout << "收到客户端消息:"
                  << buffer
                  << "\n";

        // 7. 回复客户端
        const char* reply = "Hello, client!";

        send(
            client_fd,
            reply,
            strlen(reply),
            0
        );
    }

    // 8. 关闭 Socket
    close(client_fd);
    close(server_fd);

    return 0;
}
client.cpp
#include <arpa/inet.h>
#include <cstring>
#include <iostream>
#include <sys/socket.h>
#include <unistd.h>

int main() {
    // 1. 创建 Socket
    int sock_fd = socket(AF_INET, SOCK_STREAM, 0);
    if (sock_fd == -1) {
        perror("socket");
        return 1;
    }

    // 2. 配置服务器地址
    sockaddr_in server_addr{};
    server_addr.sin_family = AF_INET;
    server_addr.sin_port = htons(8888);

    // 127.0.0.1 表示本机
    if (inet_pton(
            AF_INET,
            "127.0.0.1",
            &server_addr.sin_addr) <= 0) {

        perror("inet_pton");
        close(sock_fd);
        return 1;
    }

    // 3. 连接服务器
    if (connect(
            sock_fd,
            reinterpret_cast<sockaddr*>(&server_addr),
            sizeof(server_addr)) == -1) {

        perror("connect");
        close(sock_fd);
        return 1;
    }

    std::cout << "连接服务器成功\n";

    // 4. 向服务器发送数据
    const char* message = "Hello, server!";

    send(
        sock_fd,
        message,
        strlen(message),
        0
    );

    // 5. 接收服务器回复
    char buffer[1024]{};

    ssize_t n = recv(
        sock_fd,
        buffer,
        sizeof(buffer) - 1,
        0
    );

    if (n > 0) {
        buffer[n] = '\0';

        std::cout << "服务器回复:"
                  << buffer
                  << "\n";
    }

    // 6. 关闭 Socket
    close(sock_fd);

    return 0;
}
文件
如果压缩服务不需要立刻处理图片,接收服务还可以先把图片和任务信息写入文件;压缩服务稍后再打开文件读取。
或者程序退出前,我们会将配置落盘,重新启动时再重新夹杂着配置文件,也是使用文件进行进程间通讯
文件方式的关键特点是:数据可以留存,两个进程不必同时在线。 但文件本身不会自动告诉压缩服务“新任务来了”。
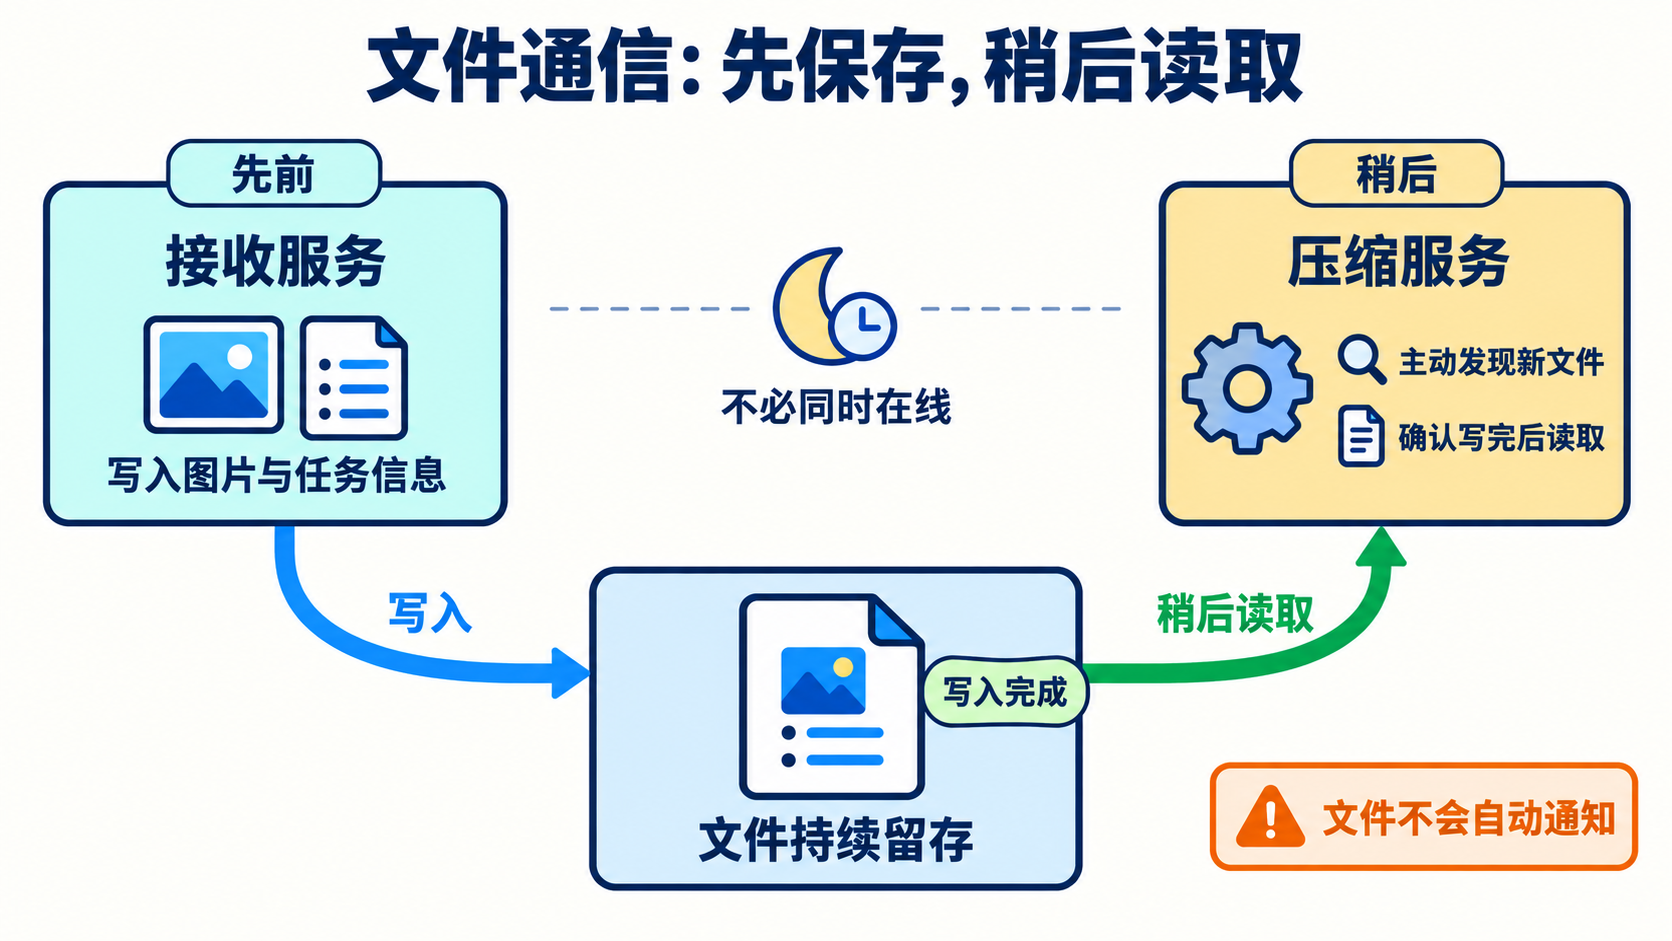
双方需要约定如何发现新文件,以及如何判断文件已经写完,否则压缩服务可能读到尚未写完整的内容。多个进程同时修改同一文件时,也需要协调。
“写入文件”还不等于数据已经可靠落到存储设备上;如果业务要求抵御突然断电等故障,需要考虑同步写入及相应的持久化流程。Linux fsync 手册
多种通信方式应该怎么选?
先判断要传的是连续数据、独立任务,还是只需通知;再看双方是否在同一台机器、是否必须同时运行:
- 一方持续写入、另一方顺序读取字节,尤其是有继承关系的进程:考虑管道。
- 要收发一条条有明确边界的小型任务:考虑消息队列。
- 本机进程频繁处理同一份较大数据:考虑共享内存,并另外设计同步方式。
- 只需告知某个事件发生:考虑信号;需要控制资源数量或执行顺序:考虑信号量。
- 需要本机进程之间持续收发,或需要跨机器通信:考虑相应类型的 Socket。
- 数据需要留存,接收方可以稍后再处理:考虑文件。
这些方式没有统一的性能排名。比如共享内存减少了反复传递大块数据的开销,却把“何时可读、何时可覆盖”的协调工作交给了程序;文件方便留存数据,却需要处理任务发现和写入完成的问题。
面试总结
进程间通信是让通常相互隔离的进程交换数据、通知事件或协调执行。常见方式各有侧重:管道传输字节流,消息队列保留消息边界,共享内存让本机进程访问同一份数据,信号用于事件通知,信号量用于同步,Socket 支持本机或跨机器通信,文件则适合留存数据供稍后读取。
选择时主要看数据形式和大小、通信范围、实时性及留存需求。无论选哪一种,都要进一步考虑消息边界、并发访问和失败后的处理,不能只凭“哪种最快”决定。
12. 同一进程中的线程如何通信?
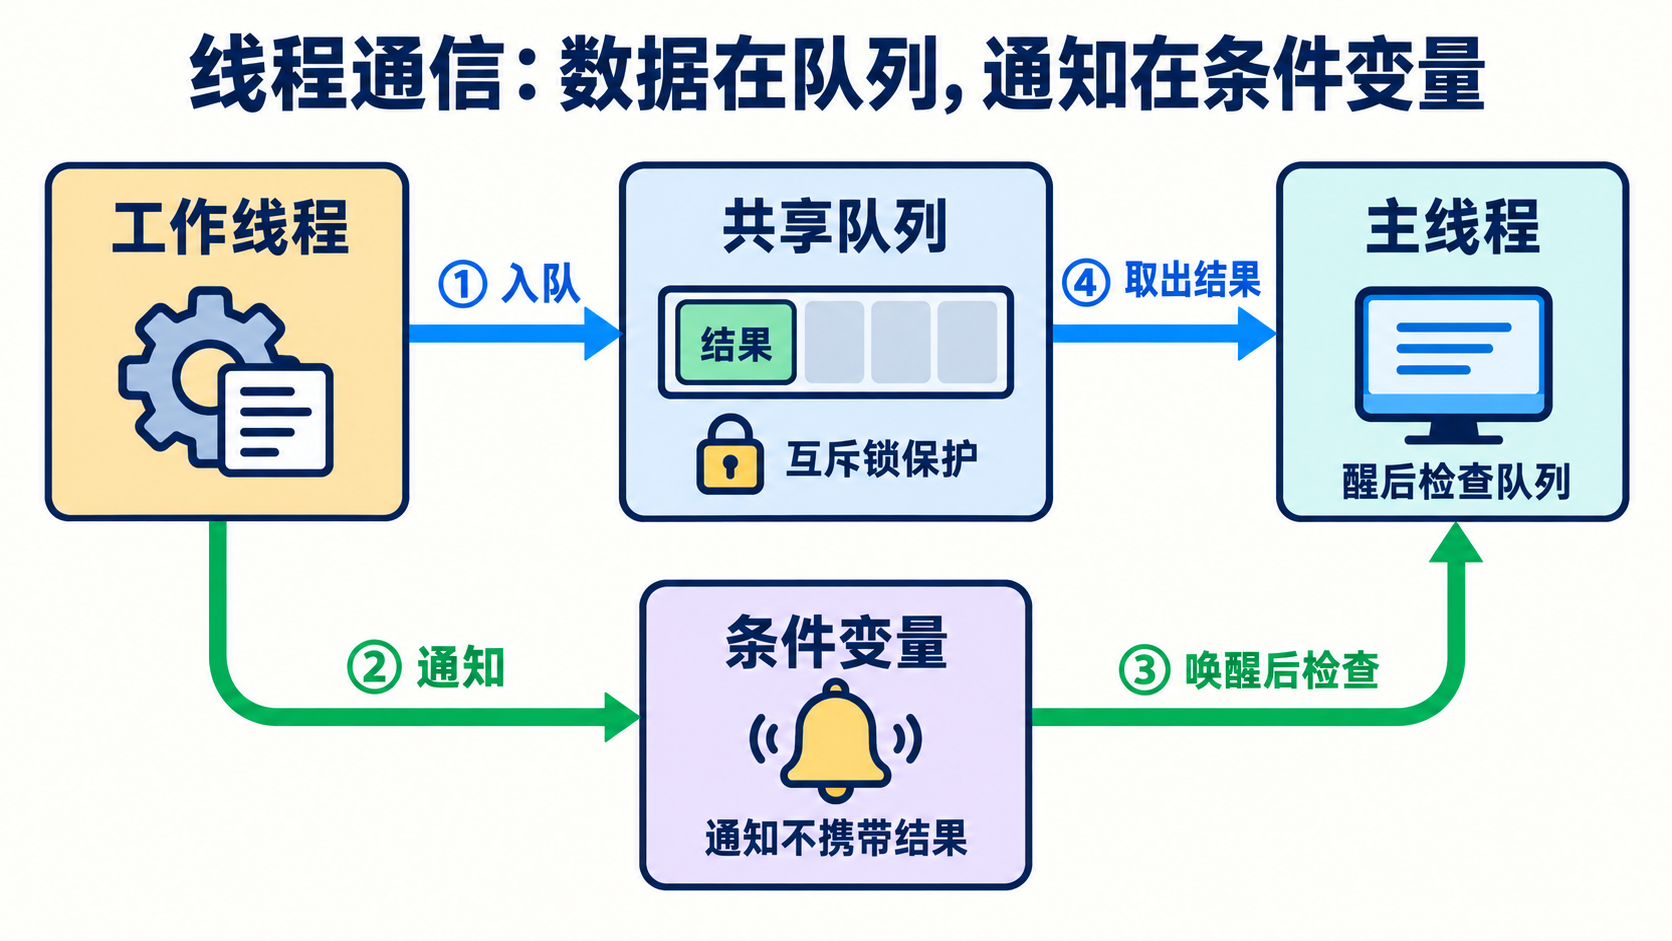
同一进程中的线程可以访问同一块内存。比如,工作线程算出结果后,把结果放进共享队列,主线程再从队列取出显示。这就是最直接的线程通信方式。
但共享队列只解决了“结果放在哪里”
还留下两个问题:两个线程同时操作队列会不会出错?队列为空时,主线程怎样等待新结果? 前者需要互斥锁,后者可以用条件变量。
一个结果怎样从工作线程交给主线程?
假设队列一开始是空的:
- 主线程先取得互斥锁,检查队列。发现没有结果,就调用条件等待。
- 条件等待会协调完成“释放锁并进入等待”。主线程不再占着锁,工作线程才有机会修改队列。
- 工作线程取得锁,把结果放入队列,通知等待的线程,然后释放锁。
- 主线程被唤醒后,重新取得锁,再检查队列;确认有结果,才取出处理。
这里,队列保存数据,锁保护队列,条件变量负责等待和通知。通知本身不携带计算结果,结果仍在队列里。
为什么“检查为空”和“开始等待”需要协调?如果主线程先释放锁,却还没真正开始等待,工作线程恰好放入结果并发出通知,主线程随后才睡下,就可能错过这次通知。条件等待提供的释放锁与进入等待的协调语义,正是为了避免这个空档。
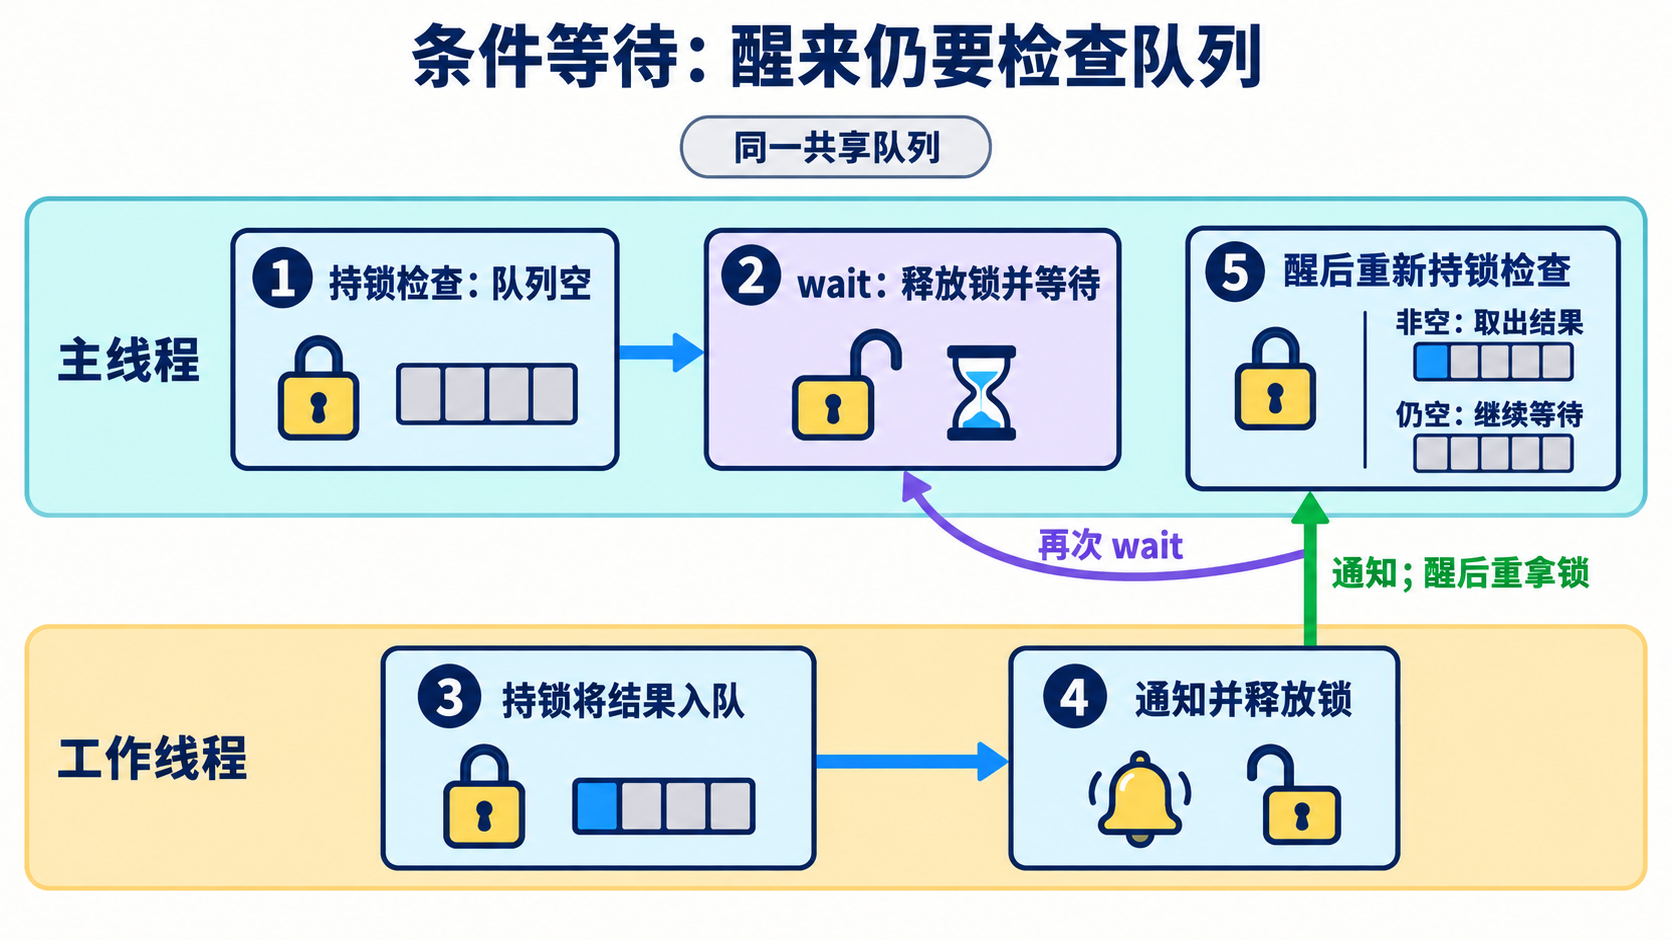
收到通知,为什么还要检查队列?
通知的意思是“条件可能已经满足”,不是“你一定能取到结果”。例如,两个主线程都在等任务,其中一个可能先取走了队列里唯一的结果;条件等待也允许出现虚假唤醒。
因此,等待方应当持锁检查队列,并在队列仍为空时继续等待。醒来后重新检查的对象是队列是否有结果,而不是“刚才有没有收到通知”。
共享内存也不自动保证线程能安全地观察彼此的修改。正确使用锁或原子操作,才能建立所需的访问顺序;在 C/C++ 中,普通 volatile 不能代替线程同步。
#include <condition_variable>
#include <iostream>
#include <mutex>
#include <queue>
#include <thread>
#include <chrono>

std::queue<int> result_queue;
std::mutex queue_mutex;
std::condition_variable queue_cv;

void Worker() {
    // 模拟耗时计算
    std::this_thread::sleep_for(std::chrono::seconds(2));

    int result = 100;

    {
        // 1. 工作线程加锁
        std::lock_guard<std::mutex> lock(queue_mutex);

        // 2. 将计算结果放入共享队列
        result_queue.push(result);

        std::cout << "工作线程:计算完成,结果放入队列\n";
    }

    // 3. 通知等待结果的线程
    queue_cv.notify_one();
}

int main() {
    // 创建工作线程
    std::thread worker(Worker);

    std::cout << "主线程:等待计算结果...\n";

    std::unique_lock<std::mutex> lock(queue_mutex);

    // 4. 如果队列为空,则释放锁并进入等待
    // 被唤醒后会重新获得锁,并再次检查条件
    queue_cv.wait(lock, [] {
        return !result_queue.empty();
    });

    // 5. 此时已经确认队列中存在结果
    int result = result_queue.front();
    result_queue.pop();

    // 不再需要访问共享队列,可以提前释放锁
    lock.unlock();

    std::cout << "主线程:收到结果 " << result << '\n';

    worker.join();

    return 0;
}
面试总结
同一进程的线程主要通过共享变量或队列交换数据,再用同步机制保证交接正确。以共享队列为例:互斥锁防止并发修改队列,条件变量让消费者在队列为空时等待、生产者加入数据后通知。等待者醒来必须重新持锁检查条件,因为通知不等于数据仍在,也可能发生虚假唤醒。
13. 操作系统什么时候进行进程调度?如何调度?
假设一台计算机上有两个任务:A 正在读取文件,B 已经准备好计算。文件数据还没到时,让 A 继续占用 CPU 也无法推进工作。
操作系统需要让 B 运行;等文件数据到了,再决定何时让 A 继续。
决定哪个可运行任务使用 CPU,就是调度要解决的问题。
题目常说“进程调度”,但 CPU 实际切换的是可调度的执行任务;在现代系统中,它也可能是同一进程里的不同线程。
什么时候会考虑重新选择任务?
可以先分成两类:
- 当前任务不能或不再需要继续运行:例如 A 等待文件数据、主动让出 CPU,或者执行完毕。此时系统需要选择另一个可运行任务;如果没有,CPU 可以进入空闲状态。
- 当前任务还能运行,但情况发生了变化:例如有新的任务进入就绪状态、等待中的高优先级任务被唤醒,或者当前任务已经运行了一段时间。此时操作系统会重新比较各个可运行任务,决定是让当前任务继续运行,还是暂停它并切换到其他任务。因此,“发生了唤醒事件”和“马上切换任务”不是一回事。不同调度策略对抢占、运行时间的处理也不同,不能把“时间片用完就切换”当成所有系统的统一规则。
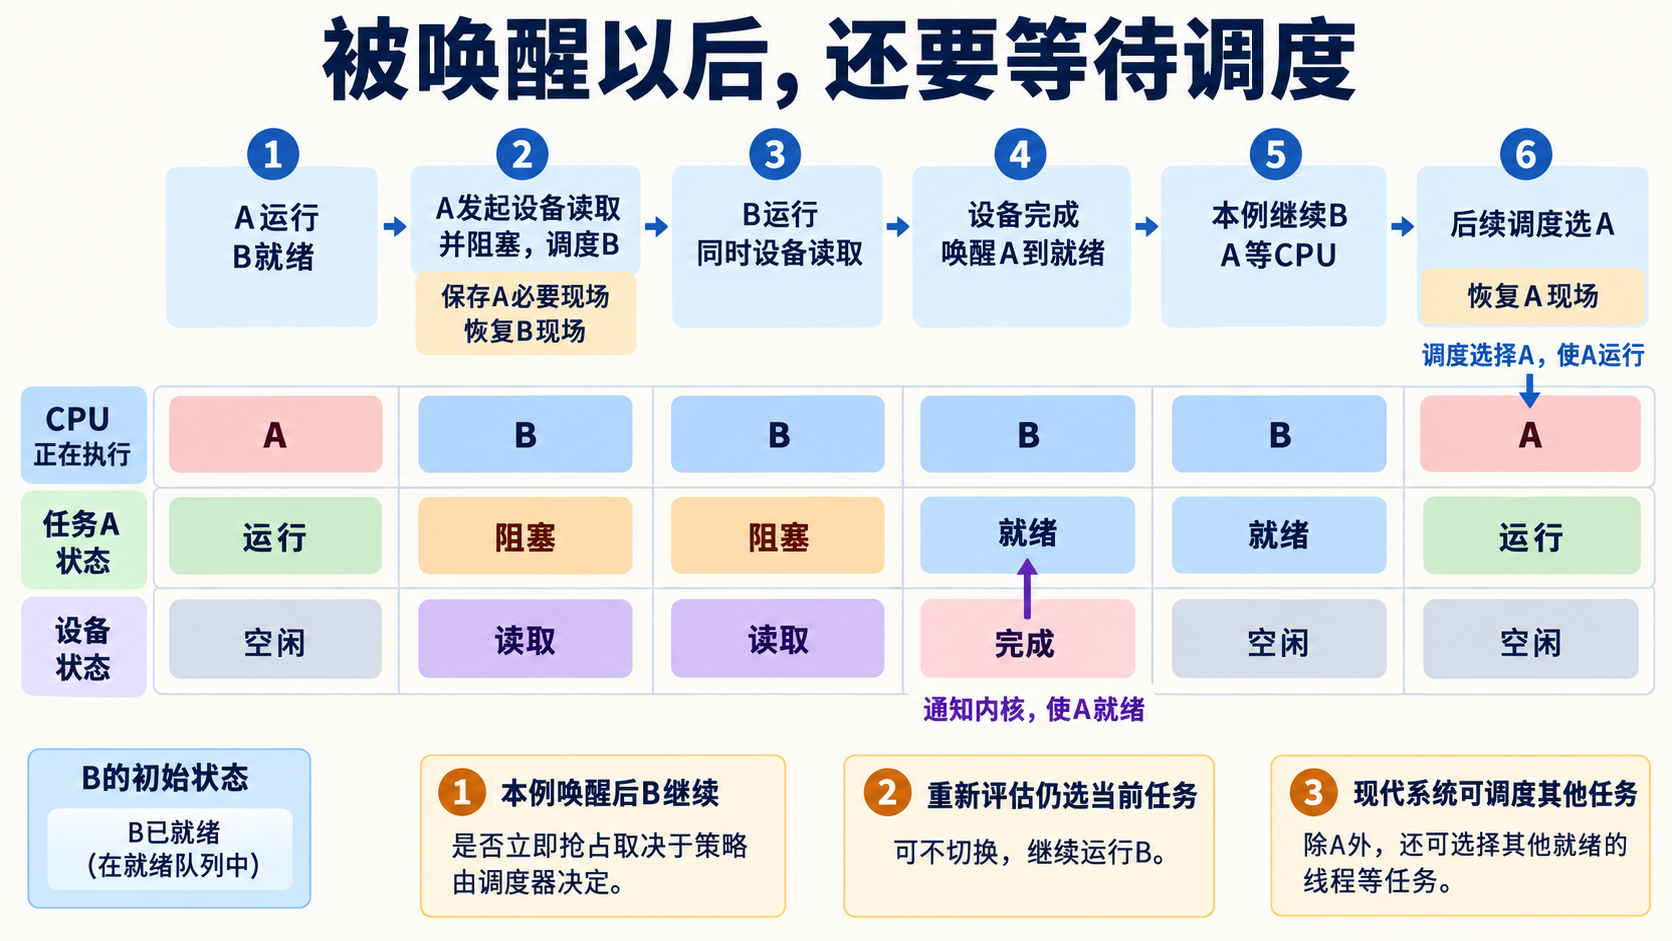
A 等待文件时,系统具体做了什么(如何调度)?
假设只有一个 CPU 执行资源,A 正在运行,B 已经就绪:
- A 发起读取,发现必须等待设备,于是进入等待状态。此时 A 还不能继续执行。
- 调度器从可运行任务中选择 B,保存 A 必要的执行现场,恢复 B 的现场,让 B 接着运行。
- 设备完成读取后,系统唤醒 A。唤醒只是让 A 重新具备运行资格,不会让它跳过调度直接占用 CPU。
- 接下来是否立即暂停 B、改运行 A,取决于调度策略;如果 B 继续运行,A 就等待下一次执行机会。
这个过程也说明了“调度”和“切换”的区别:调度器可以重新评估候选任务,若最终仍选中当前任务,此时就不需要切换到另一个任务。
Linux 的调度机制也分别处理任务进入可运行状态、唤醒后是否抢占,以及选择下一个任务。Linux 内核调度文档
多核系统还多一个问题:不仅要选“谁运行”,还要考虑“在哪个 CPU 上运行”,兼顾负载分布和缓存局部性。但初学时先掌握单 CPU 上的状态变化,就能理解调度的主线。
面试总结
操作系统调度负责选择下一个使用 CPU 的可运行任务。当前任务阻塞、退出或主动让出时,需要重新选择;新任务创建、任务唤醒或运行条件变化时,也可能触发重新评估。系统维护任务的运行状态,按策略作出选择;如果换人运行,再保存和恢复执行现场。需要注意:任务被唤醒不等于立即运行,考虑调度也不等于一定发生任务切换。
14. 调度算法有哪些评价指标?
操作系统需要决定哪个就绪任务先使用 CPU。但“先运行谁更好”没有统一答案:批量处理任务希望尽快完成更多工作,编辑器希望用户操作后尽快有反应,实时任务则可能必须在截止时间前完成。因此,评价调度算法要先明确目标,再看它对任务和整个系统造成了什么结果。
一个任务的“快”,至少有三种含义
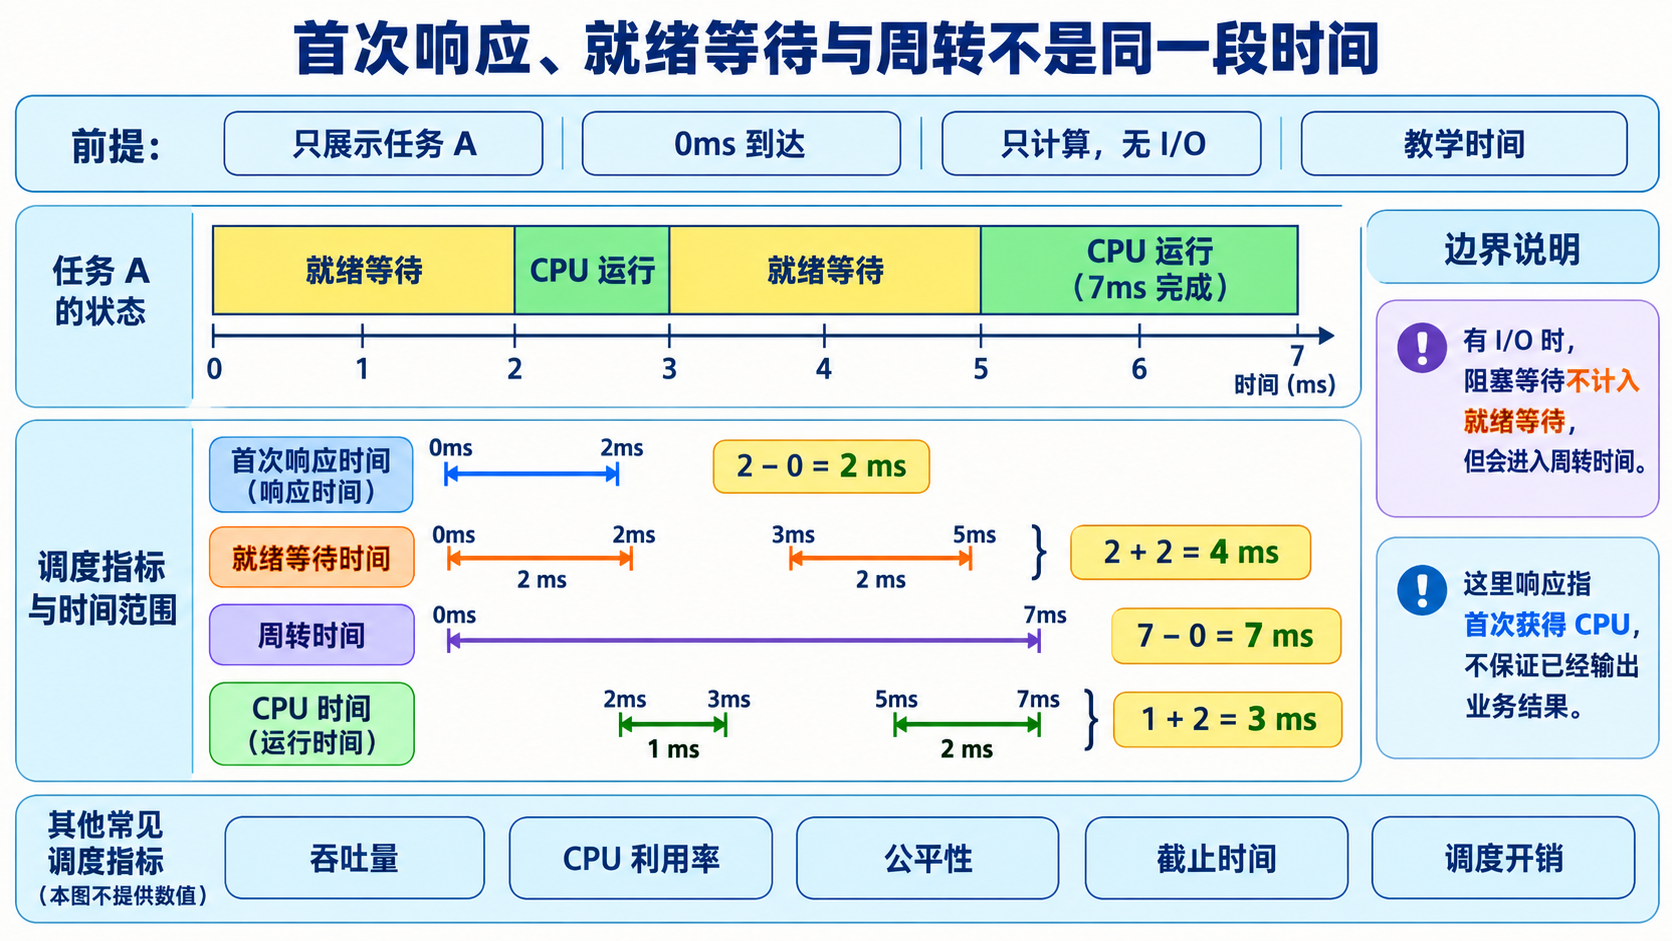
假设某任务只做计算,不等待 I/O,执行过程如下:
0ms 到达
0~2ms:就绪,等待 CPU
2~3ms:运行
3~5ms:被抢占,再次等待 CPU
5~7ms:运行并完成
这条时间线能区分三个容易混淆的指标:
- 响应时间是 2ms:从任务到达,到第一次获得 CPU,即
2 - 0。它衡量任务多久开始受到服务。 - 就绪等待时间是 4ms:两次“已经能运行、却没得到 CPU”的时间相加,即
2 + 2。 - 周转时间是 7ms:从任务到达,到全部完成,即
7 - 0。
任务真正占用 CPU 的时间只有 3ms。它在 2ms 时就开始运行,却直到 7ms 才完成,所以“首次响应快”不等于“最终完成快”。
如果任务中途去等磁盘,那段时间属于阻塞等待,不计入就绪等待时间;但它仍发生在到达与完成之间,因此会增加周转时间。这里的“响应时间”采用调度教材常用的“到首次运行”定义,也不等于用户一定已经看到了界面更新或收到了网络回复。《Operating Systems: Three Easy Pieces》调度章节
整个系统还要看什么?
单个任务的时间之外,常用指标还有:
- 吞吐量:单位时间完成多少任务,反映系统产出。
- CPU 利用率:CPU 有多少时间处于忙碌状态。忙等同样会让 CPU 很忙,所以利用率高不必然代表有效产出高。
- 公平性:任务能否获得合理的执行机会,是否有任务长期得不到运行。
- 截止时间:有时结果“最终完成”还不够,必须在规定时间前完成,实时系统尤其关注这一点。
- 调度开销:选择任务、保存和恢复执行现场也消耗时间;切换太频繁会挤占真正做工作的时间。
这些指标可能相互冲突。比如,优先让短任务完成,可能降低平均周转时间,却让后面的长任务等得更久;频繁轮换任务可能改善首次响应,却增加切换开销。因此,不能只用一个平均数判断算法优劣,还要看任务类型、等待较久的任务,以及系统最重视的目标。《Operating Systems: Three Easy Pieces》调度策略比较
面试总结
评价调度算法,常看响应时间、就绪等待时间、周转时间、吞吐量、CPU 利用率、公平性、截止时间和调度开销。响应时间关注多久首次运行,周转时间关注多久最终完成,就绪等待时间只累计任务能运行却在等 CPU 的时间。批处理、交互和实时系统关注的目标不同,这些指标也可能互相制约,因此不存在对所有工作负载都最好的调度算法。
15. 抢占式和非抢占式调度有什么区别?常见调度算法有哪些?
区别在于:当前任务仍然可以运行时,操作系统能否把 CPU 提前交给另一个任务。 抢占式调度允许这样做;非抢占式调度通常等当前任务阻塞、主动让出或结束以后,再选择其他任务。
例如,A 正在计算,B 刚刚进入就绪队列。B 到达不代表 A 必须停下:非抢占式策略可以让 A 继续完成本次计算;抢占式策略则可以根据剩余运行时间、优先级或时间片,决定是否暂停 A。被抢占的 A 仍然具备运行条件,因此通常回到就绪状态,而不是变成等待 I/O 的阻塞状态。
这里讨论的是任务是否被换下。非抢占式调度不等于 CPU 不处理硬件中断,也不等于系统只有一个程序;处理一次中断后,仍可以返回原任务继续执行。
同一批任务,为什么会有不同运行顺序?
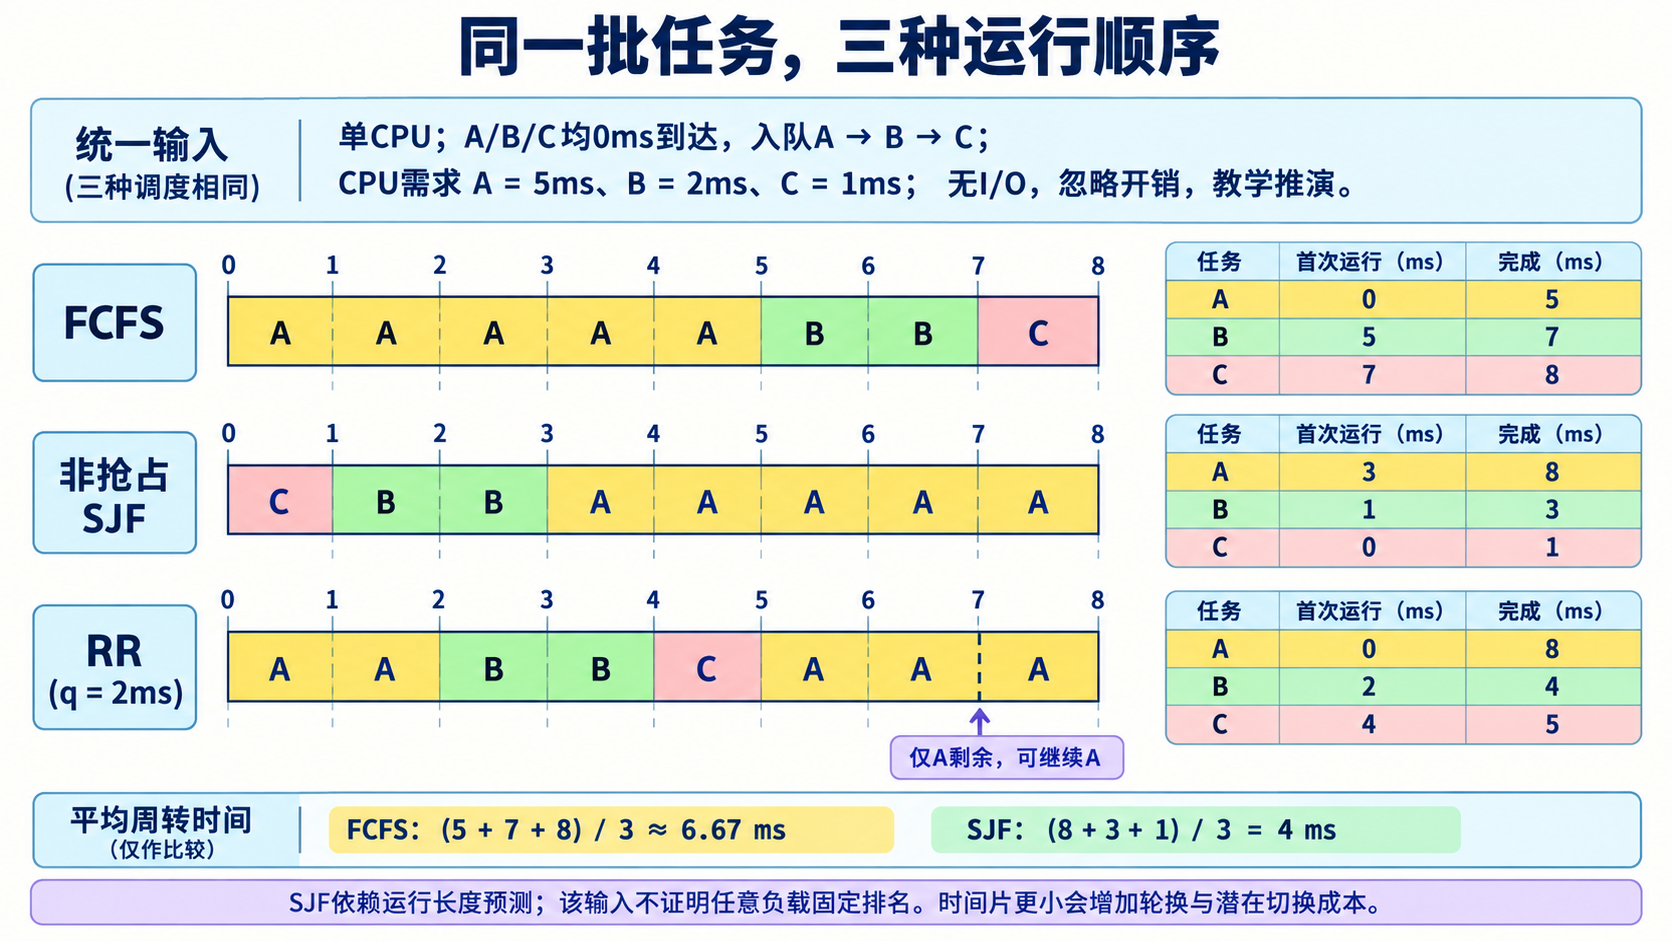
先固定一个容易检查的例子:单个 CPU,A、B、C 都在 0ms 到达,入队顺序为 A→B→C,分别需要 5、2、1ms 的 CPU 时间。没有 I/O,忽略调度与切换开销,以下均为教学推演。
| 策略 | CPU 运行顺序 | A/B/C 首次运行时刻 | A/B/C 完成时刻 |
|---|---|---|---|
| FCFS,先来先服务 | A:0~5;B:5~7;C:7~8 | 0 / 5 / 7 | 5 / 7 / 8 |
| 非抢占式 SJF,最短作业优先 | C:0~1;B:1~3;A:3~8 | 3 / 1 / 0 | 8 / 3 / 1 |
| RR,时间片为 2ms | A:0~2;B:2~4;C:4~5;A:5~7;A:7~8 | 0 / 2 / 4 | 8 / 4 / 5 |
FCFS 按到达顺序处理,长任务 A 在前面时,短任务也要等。SJF 先处理短任务,本例平均周转时间从 FCFS 的 (5+7+8)/3≈6.67ms 降为 (8+3+1)/3=4ms。
RR 不让 A 一口气用完 5ms,而是先给每个就绪任务一段运行机会。最后 A 连续获得两个时间片,是因为 B、C 已经结束;7ms 时重新评估后仍可继续选 A,不必凭空安排一次切换到其他任务。RR 的时间片越小,轮换越频繁,但切换成本也越值得关注;时间片很大时,行为会接近 FCFS。
这些结果只说明同一输入在不同规则下怎样变化。SJF 通常需要估计下一段 CPU 运行时间,无法提前准确知道所有任务长度;在长短任务持续到达的系统里,短任务优先还可能让长任务长期等待。OSTEP:CPU 调度
最短任务优先,一定会抢占吗?
不一定。SJF 通常指在选择任务时,优先选择预计下一段 CPU 运行时间较短的任务;它的抢占式变体常称为 SRTF,最短剩余时间优先,比较的是当前还需要运行多久。
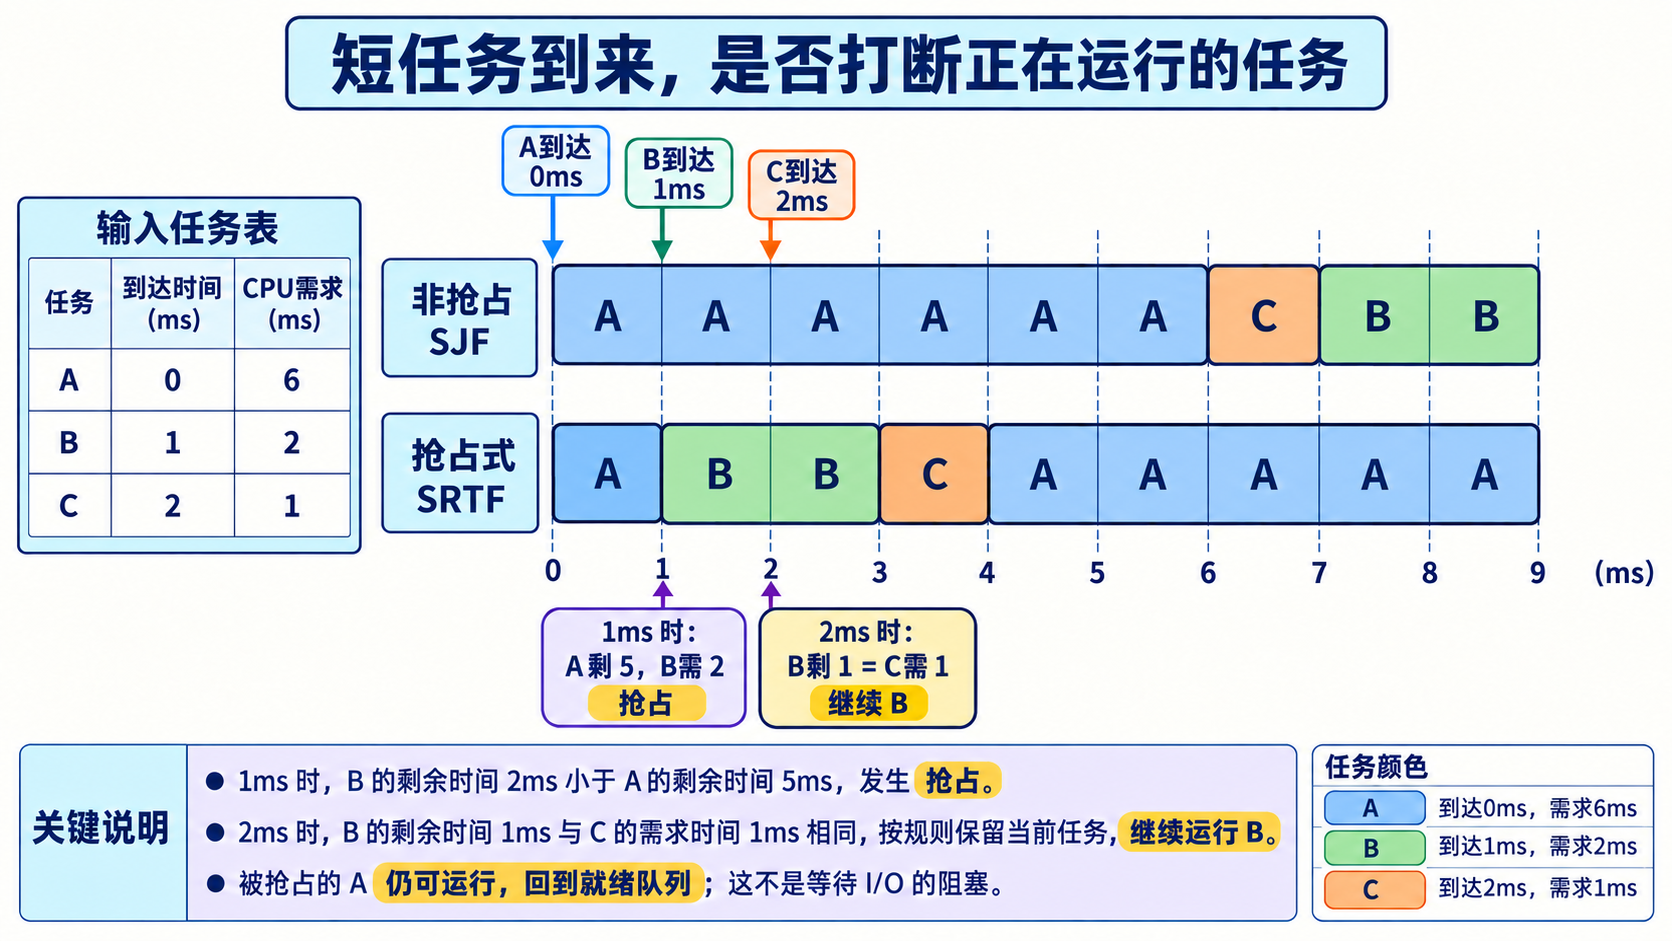
另设一组输入:A 在 0ms 到达,需要 6ms;B 在 1ms 到达,需要 2ms;C 在 2ms 到达,需要 1ms。只有一个 CPU,没有 I/O,忽略开销;SRTF 剩余时间相同时保留当前任务。
- 非抢占式 SJF:0ms 只有 A,先让 A 运行到 6ms;再选 C:6~7ms,最后 B:7~9ms。
- SRTF:A 运行 0~1ms 后还剩 5ms,B 只需 2ms,于是换 B。2ms 时 B 剩 1ms,与新到达的 C 相同,按本例规则继续 B。最终为 A:0~1、B:1~3、C:3~4、A:4~9ms。
B 到达后能否打断 A,正是两种策略的区别。抢占不是随意停程序:系统保存必要执行状态,以后恢复 A,接着完成剩余计算。
优先级和多级反馈队列又在比较什么?
优先级调度按任务的优先级选择,既可以设计成抢占式,也可以设计成非抢占式。优先级如何确定、数值越大还是越小代表更高,都要看具体系统。持续有高优先级任务运行时,低优先级任务可能饥饿;逐步提高等待较久任务的优先级,是一种缓解办法,常称为老化。
多级反馈队列(MLFQ)维护不同优先级的队列,并根据任务的运行表现调整归属。例如新任务先获得较高优先级,持续消耗 CPU 的任务逐步降到较低队列;不同队列还可以使用不同时间片。这样可以照顾交互任务,同时让长计算任务推进。为避免低层任务一直轮不到,还需要优先级提升等安排。升降规则、累计时间和提升周期是策略的一部分,不能把某组具体规则当成所有系统的固定实现。OSTEP:多级反馈队列
用一次队列变化理解“反馈”
另设独立教学模型:单 CPU、允许抢占、没有 I/O,忽略开销。三个队列优先级为 Q2>Q1>Q0,同层按 RR 轮换,时间片分别为 2、4、8ms。新任务进入 Q2;任务在 Q2 累计使用 2ms 后降到 Q1,在 Q1 累计使用 4ms 后降到 Q0,最低层不再降级。高层有就绪任务时,可以抢占低层任务。
长任务 U 在 0ms 到达,需要 10ms;短任务 V 在 7ms 到达,需要 1ms:
| 时间 | 运行任务与队列 | 为什么发生变化 |
|---|---|---|
| 0~2ms | U,Q2 | 用完 Q2 的 2ms 配额,降到 Q1 |
| 2~6ms | U,Q1 | 用完 Q1 的 4ms 配额,降到 Q0 |
| 6~7ms | U,Q0 | 高层暂时没有任务,U 继续运行 |
| 7~8ms | V,Q2 | 新任务在高层就绪,抢占低层的 U;V 随后完成 |
| 8~11ms | U,Q0 | V 完成,U 接着运行剩余 3ms,最终完成 |
U 合计获得 2+4+1+3=10ms CPU,V 获得 1ms。U 被降级不是被判定为“不重要”,而是其持续用 CPU 的表现让调度器调整了队列;V 也不是天然短任务,调度器只是先给新任务一次高优先级运行机会。
这里的时间片决定一次运行后何时重新选择,累计配额决定何时降级,两者不必相等;本例前两层恰好取相同值。累计用量跨主动让出保留,不能通过频繁让出 CPU 无限重置配额。另设每 20ms 将任务统一提升到 Q2,以重新提供高层机会;本例 11ms 已结束,所以没有展示提升。队列数、配额和提升周期都是本例规则,不是 Linux 的固定实现。
面试回答
抢占式调度允许在当前任务仍可运行时把 CPU 交给其他任务;非抢占式通常等待当前任务阻塞、让出或结束。常见策略包括按到达顺序的 FCFS、按运行长度的 SJF/SRTF、按时间片轮换的 RR,以及优先级和多级反馈队列。策略选择影响响应、周转、公平性和切换开销,没有适用于所有负载的最佳算法;教材算法也不能直接等同于某个操作系统的完整调度实现。
16. 常见实时调度算法有哪些?
实时调度关注的是:任务不仅要算对,还要在要求的时间内完成。 “实时”并不是一味追求最快,而是让完成时间满足约束。例如控制任务超过截止时间后,迟到的结果可能已经无法用于当前控制过程。
硬实时系统把错过截止时间视为不能接受的时序失败;软实时系统通常允许偶尔迟到,但服务质量会下降。采用某个算法,不等于已经证明所有截止时间都能满足,还需要分析任务需求和系统开销。
先区分周期、执行时间和截止时间
一个周期性任务会反复产生需要执行的工作实例,每个实例称为一个作业。常用参数有:
- 周期 T:相邻作业释放的间隔。例如每 4ms 产生一次工作。
- 执行时间 C:一个作业需要的 CPU 时间;要论证硬实时保证,通常使用可信的最坏执行时间上界。
- 相对截止时间 D:从作业释放到要求完成之间允许经过多久。
- 绝对截止时间 d:该作业具体要在哪个时刻前完成,
d=释放时刻+D。
假设 A 的 C=1ms、T=D=4ms,从 0ms 开始释放。那么 A 的作业在 0、4、8ms 释放,绝对截止时间分别为 4、8、12ms。每次只运行 1ms,并不表示每次释放后必须立刻运行;它可以等待,但必须赶在对应截止时间前完成。
固定优先级:RM 与 DM
RM(Rate Monotonic,速率单调)按周期分配固定优先级:周期越短,优先级越高。DM(Deadline Monotonic,截止时间单调)则按相对截止时间分配:相对截止时间越短,优先级越高。任务的优先级固定,不代表每个作业的开始时刻也固定。
当所有任务 D=T 时,两种排序一致;D 与 T 不同,就可能不同。例如任务 X 的 T=10、D=3,Y 的 T=5、D=5:RM 把 Y 排在前面,DM 把 X 排在前面。这里先比较规则,不凭这两个参数就断言整组任务可调度,还要知道执行时间等条件。Audsley 等:截止时间单调调度
用刚才的 A,再加入 B:C=2ms、T=D=5ms。两者从 0ms 释放,单 CPU、允许抢占、相互独立、没有锁等待,忽略切换开销。RM 中 A 的周期较短,优先级高于 B,前 10ms 的运行可以推演为:
0~1:A第1次     1~3:B第1次     3~4:空闲
4~5:A第2次     5~7:B第2次     7~8:空闲
8~9:A第3次     9~10:空闲
这些作业分别在其截止时间前结束。这里只核对展示窗口中的实例;一张有限时间线,不是对任意未来运行的实时性证明。

动态优先级:EDF 与 LLF
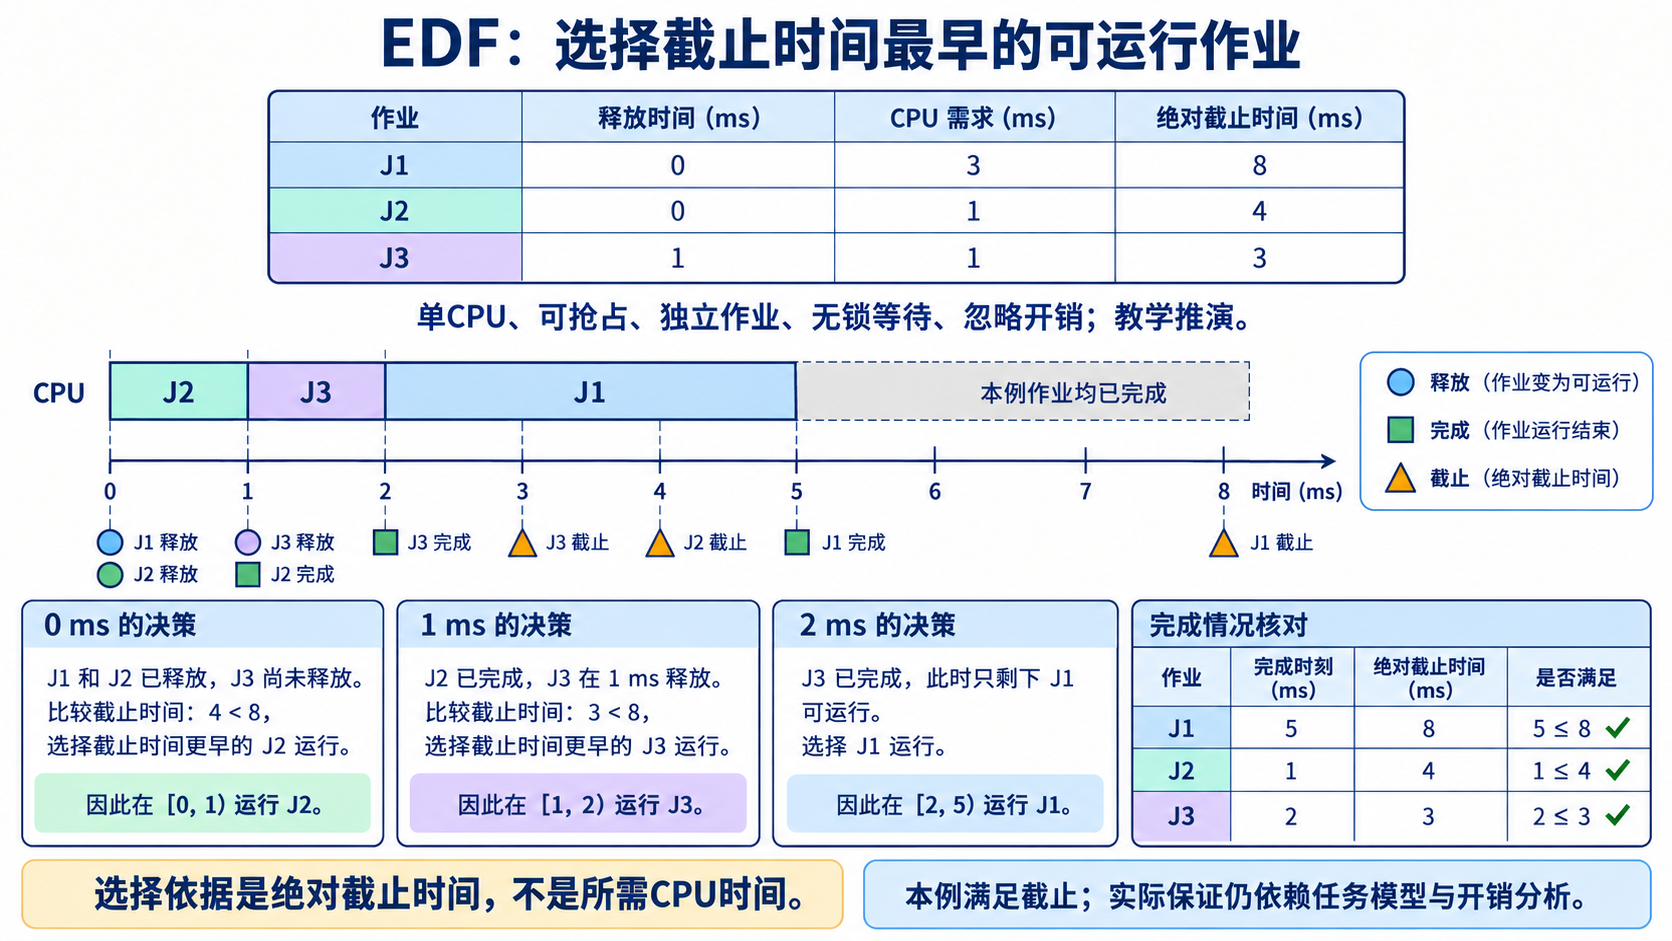
EDF(Earliest Deadline First,最早截止时间优先)在可运行作业中,优先选择绝对截止时间最早的那个。随着新作业释放,优先顺序可能变化,因此是动态优先级。
例如,0ms 释放 J1:需 3ms,截止 8ms;同时释放 J2:需 1ms,截止 4ms。EDF 先执行 J2:0~1ms。1ms 又释放 J3:需 1ms,截止 3ms,于是执行 J3:1~2ms,再执行 J1:2~5ms。完成时刻 1、2、5ms 分别不晚于各自截止时间 4、3、8ms。
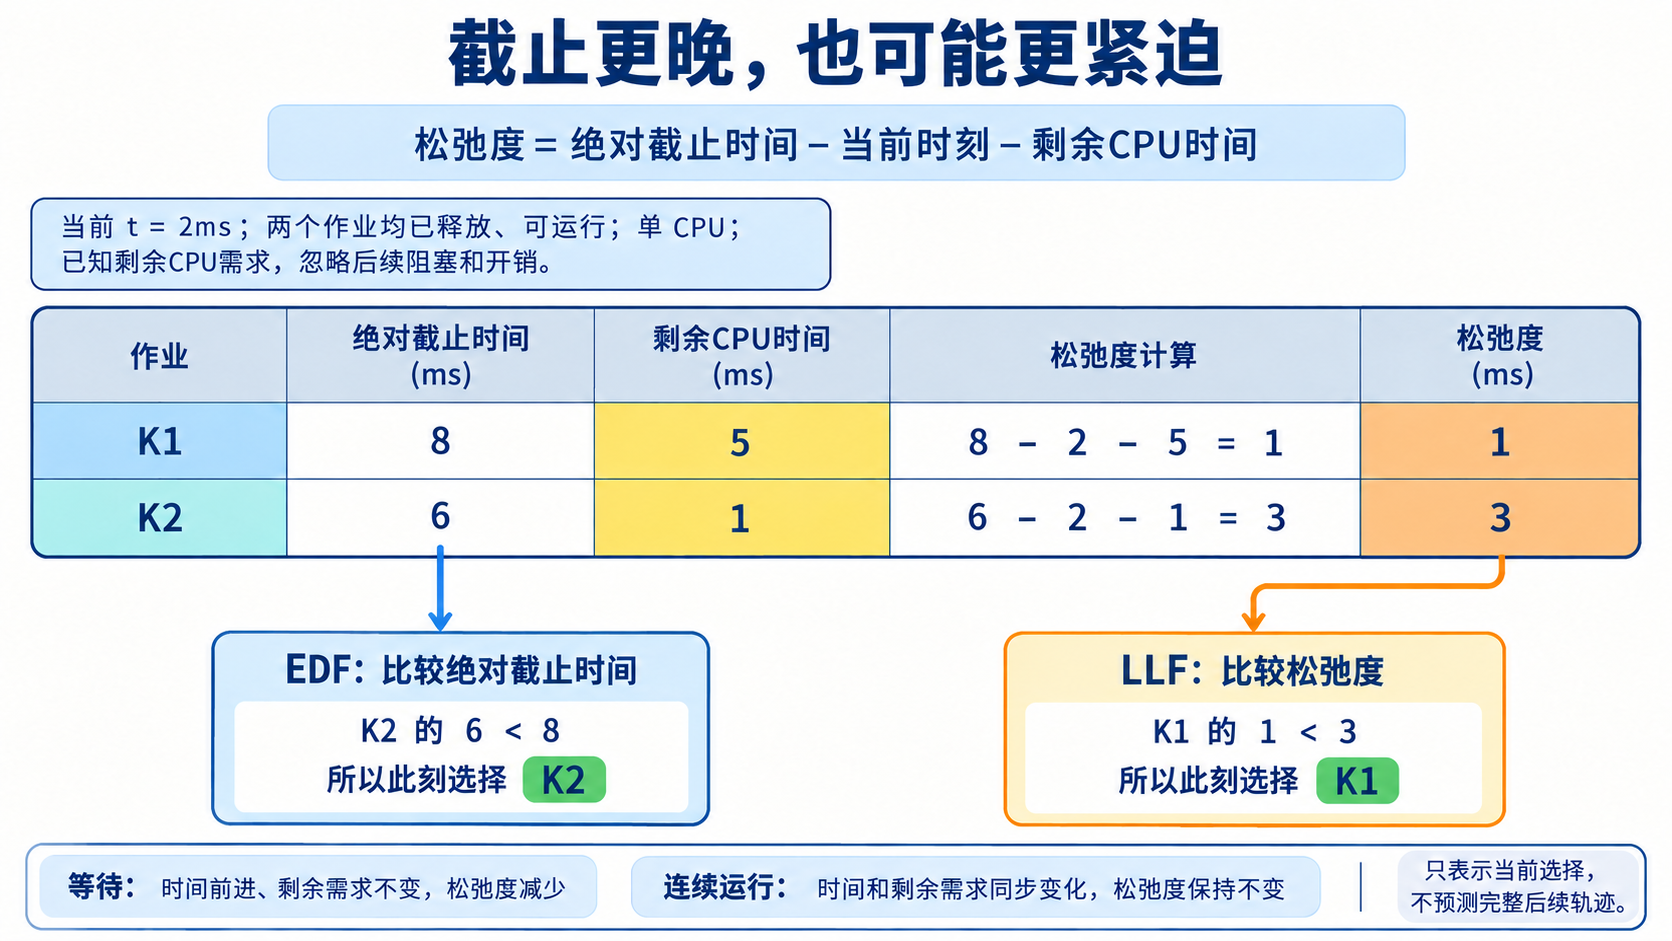
LLF(Least Laxity First,最小松弛度优先)还会把“剩余计算量”考虑进去。某个作业的松弛度为:
松弛度 = 绝对截止时间 - 当前时刻 - 剩余执行时间
在 2ms 时,若 K1 的截止时间是 8ms、还需 5ms,则松弛度为 1ms;K2 截止 6ms、还需 1ms,松弛度为 3ms。EDF 看截止时间,会优先 K2;LLF 看剩余余量,会优先 K1。这个例子只比较当前选择,不表示后续一直保持同一顺序。在这个理想模型中,等待会使松弛度减少;连续运行时,时刻与剩余执行时间以相同速率变化,松弛度保持不变。等待者因此可能赶上当前运行者,频繁重新比较可能增加切换成本。CMU:实时调度讲义
松弛度可以理解为“即使接下来连续运行,也还允许耽搁多久”。在已知剩余 CPU 需求、无额外阻塞和开销的单 CPU 模型下,尚未完成的作业松弛度为 0,意味着已经没有可再等待的余量,不等于已经错过截止时间;若松弛度为负,则即使立即连续运行,也无法按给定剩余需求在截止时间前完成。实际系统还要考虑执行时间估计误差与阻塞,不能只看这个减法就承诺实时保证。
为什么“总需求不到一个 CPU”仍然可能迟到?
在特定的单 CPU、独立、可抢占、截止时间等于周期的理想任务模型下,EDF 可以用总利用率 Σ(C/T)≤1 判断可调度性。前面的 A、B 总利用率为 1/4+2/5=0.65。但这个条件不能直接推广到任意截止时间、多核、资源依赖或真实开销。
例如,高优先级控制任务即使只需很少 CPU 时间,也可能被低优先级任务持有的锁挡住,迟迟无法开始。实际还要计入锁阻塞、中断、执行时间上界和调度开销。Linux 的 SCHED_DEADLINE 也结合 EDF、预算管理和准入控制,不是只把任务按业务截止时间排一遍。Linux:Deadline 调度及理论条件
面试回答
实时调度以满足截止时间为目标。RM 按周期、DM 按相对截止时间分配固定优先级;EDF 按当前作业的绝对截止时间、LLF 按剩余松弛度动态选择。分析时要区分周期、CPU 执行时间和截止时间,并明确处理器数量、抢占、任务依赖及开销条件。选用了实时算法并不自动构成实时保证,还需要可调度性分析和可信的执行时间、阻塞时间上界。
17. 什么是同步、互斥、临界资源和临界区?
多个任务共同使用数据时,要同时解决两个问题:能不能一起修改,以及谁必须先完成。 互斥主要限制同一时刻的访问,同步还关注任务之间的先后关系。
为什么一次“加一”也可能需要保护?
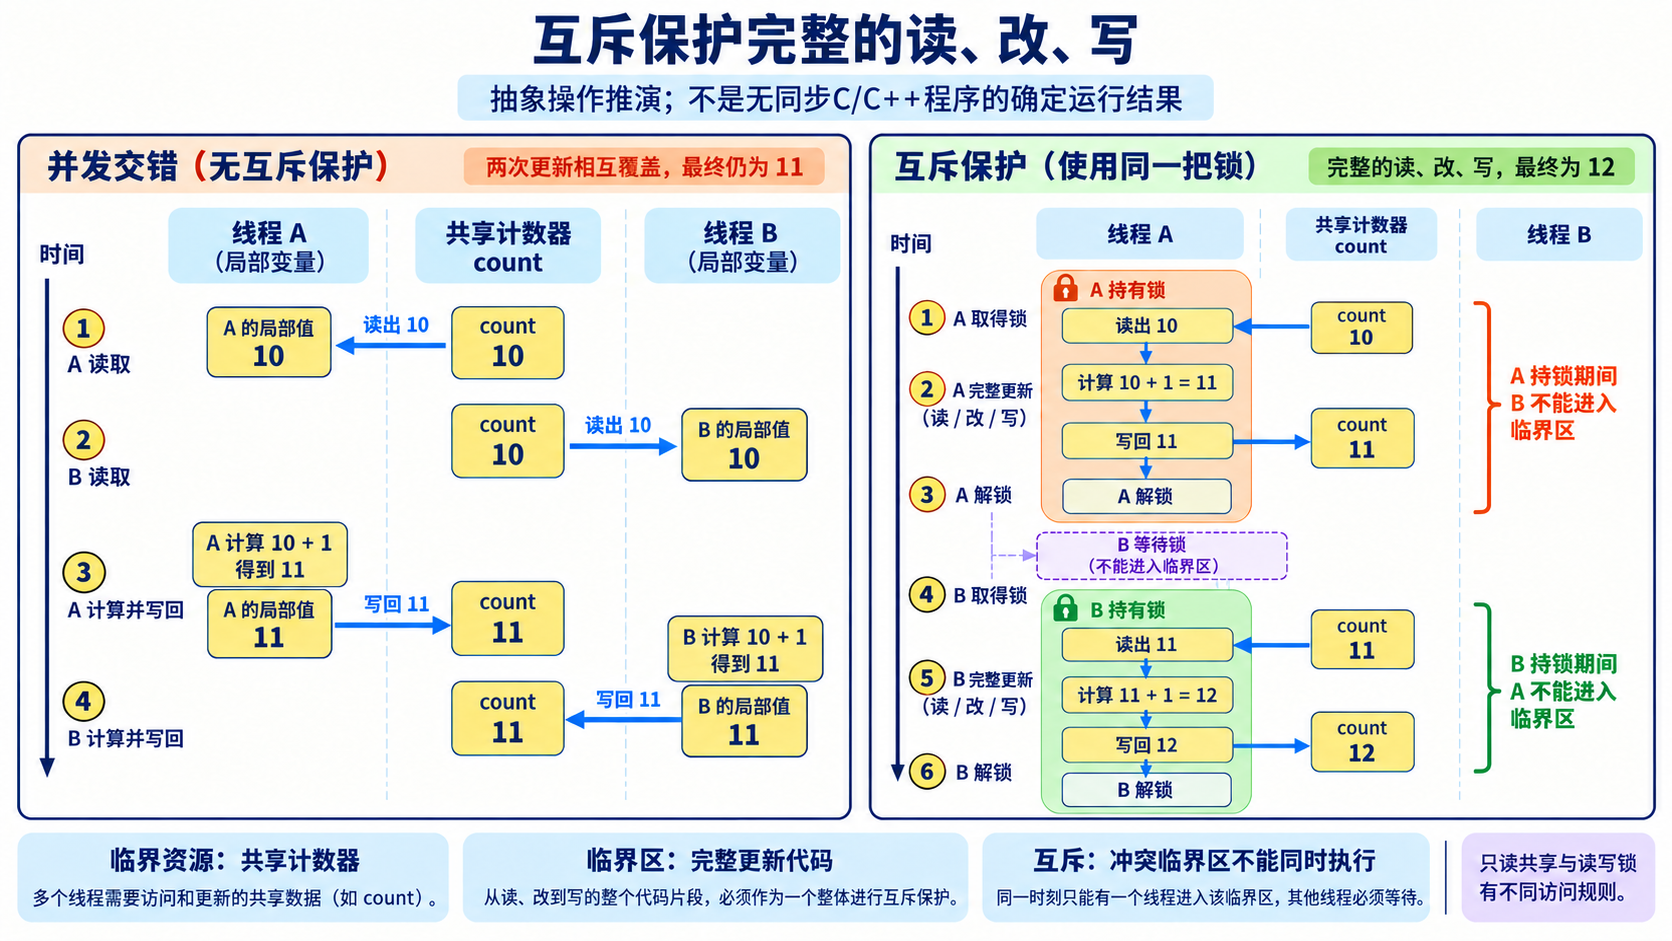
假设一个抽象共享计数器初始为 10,A、B 都要加一。如果把操作拆成“读取、计算、写回”,一种交错是:
| 顺序 | A 的动作 | B 的动作 | 共享值 |
|---|---|---|---|
| 1 | 读取 10 | — | 10 |
| 2 | — | 读取 10 | 10 |
| 3 | 计算 11,写回 | — | 11 |
| 4 | — | 计算 11,写回 | 11 |
两次更新中有一次被覆盖了。这里用抽象操作说明问题,不是把无同步的 C/C++ 数据竞争程序当成能够确定复现这个结果的合法程序;在 C/C++ 内存模型中,满足数据竞争定义的执行会导致未定义行为。C++ 标准草案:数据竞争
若 A、B 都用同一把互斥锁包住完整的读、改、写过程,就不能在这一过程中互相插入。A 完成 10→11 后,B 才执行 11→12,最终得到 12。不能只锁住“写回”而放任前面的读取在锁外发生,否则两者仍可能各自拿到旧值。
在这个例子里:
- 临界资源是需要限制并发访问的共享计数器;更一般地,也可以是设备或需要共同维护的资源状态。
- 临界区是访问这个资源、必须受到协调保护的代码片段,这里是完整的读、改、写。
- 互斥是保证冲突的临界区不会同时执行的约束;锁是实现这种约束的一种机制。
不是所有共享数据都必须排他访问。只读数据可以并发读取;读写锁也能允许多个读者进入,但要求写入独占。关键是判断访问会不会破坏同一份数据必须满足的规则。OSTEP:锁
都加了锁,为什么仍然可能读不到结果?
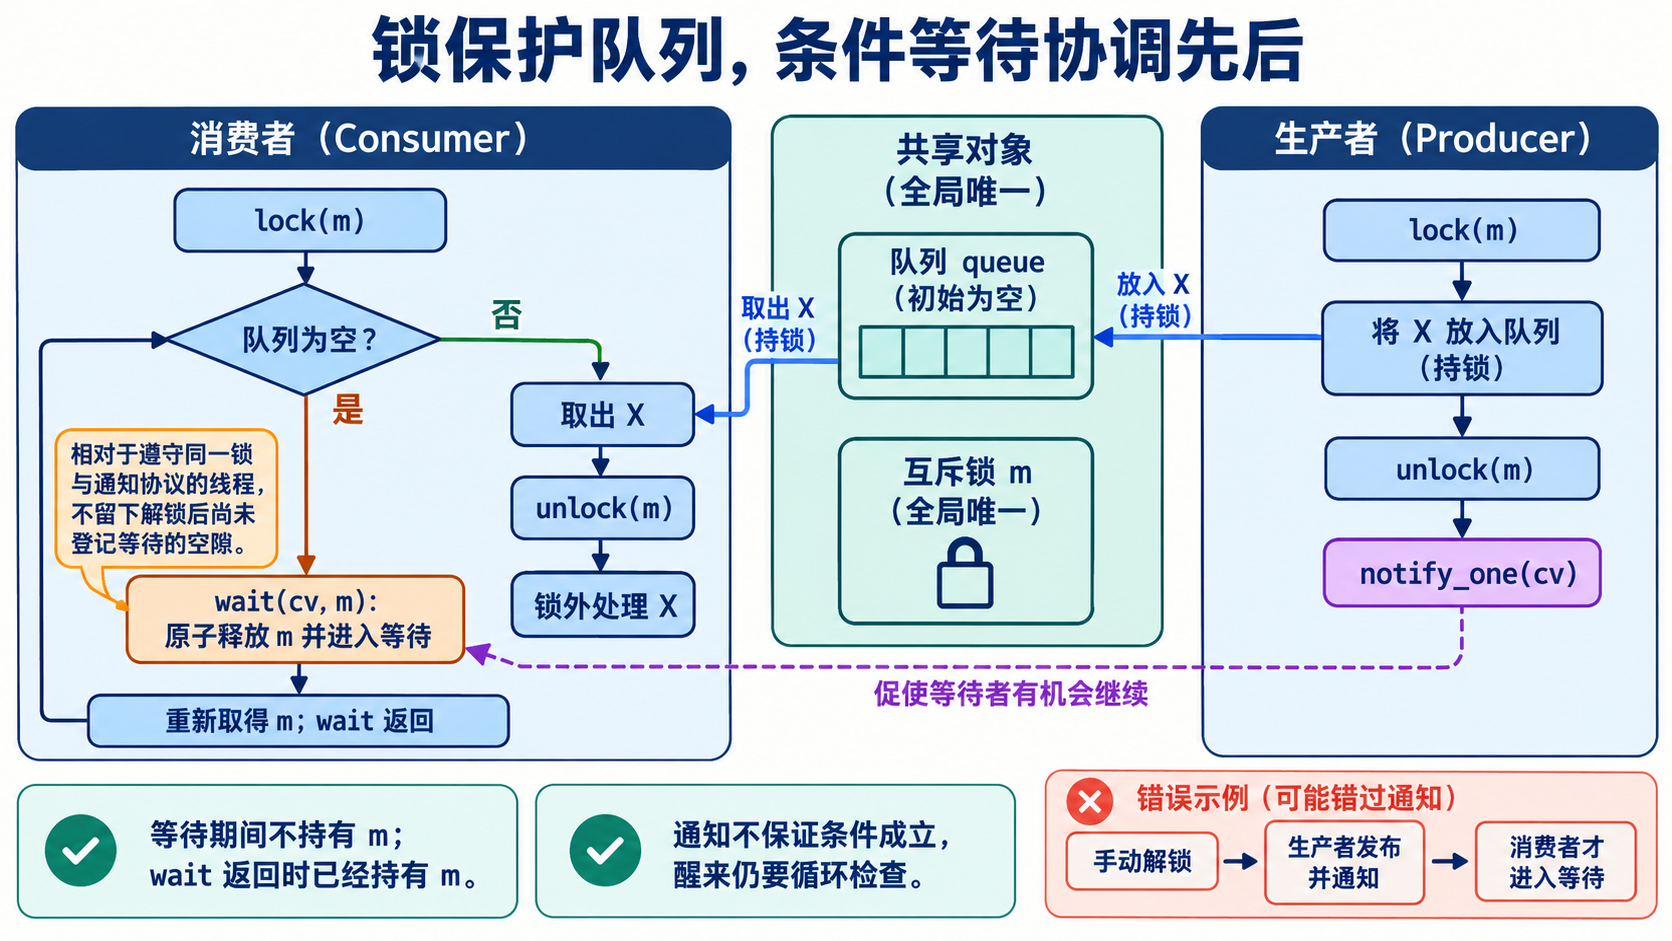
再看生产者把结果放入队列、消费者取出结果。如果消费者先获得锁,发现队列为空,锁只能保证这次检查没有被并发修改,并不会凭空产生结果。
因此还要建立执行关系:先发布结果,后消费结果。 以条件变量为例,消费者先持有队列锁并检查条件;发现没有结果时,调用条件等待操作,原子地释放锁并进入等待。生产者取得同一把锁、放入结果,然后按协议通知。消费者的等待调用返回时,已经重新取得锁,还要再次确认队列非空,才能取出。否则消费者若拿着锁一直等待“队列非空”,生产者就无法取得锁放入结果。
为什么不能自己先解锁,再去睡眠? 假设消费者检查为空后手动解锁,却还没进入等待;生产者这时放入 X 并通知,随后消费者才开始等“下一次通知”。条件变量不保存过去的通知,所以队列里虽然已有 X,消费者仍可能一直等待。正确条件等待把“释放锁与进入等待”作为配套原子操作,不给遵守同一锁与通知协议的生产者留下这个空隙。这里的原子性针对相关锁与等待协议,不是关闭所有中断,更不是让整个程序不能被抢占。POSIX:条件等待的原子语义
这里,“队列操作不能互相破坏”是互斥要求,“结果准备好以后才能读取”是同步要求。广义的同步也包括互斥;面试中将二者并列时,通常是在区分访问排他性与执行先后关系,不是说它们互不相关。
临界区一定要把整个任务包进去吗?
不需要。一般只保护维护共享规则所必需的操作。例如消费者持锁取出队列元素以后,可以在锁外处理独立的结果,减少生产者和其他消费者等待。但“缩小范围”不能拆散必须一起完成的检查与修改,也不能放出仍需要保护的共享对象后继续随意修改它。
面试回答
临界资源是需要协调访问的共享资源,临界区是访问它的受保护代码片段。互斥防止有冲突的临界区同时执行,同步还建立任务之间必要的先后关系。例如共享计数器的完整更新需要互斥,生产者发布结果以后消费者才能使用则需要同步。加锁既要覆盖完整的共享规则,又应避免把无关的耗时工作放进临界区。
18. 进程和线程常用哪些同步机制?
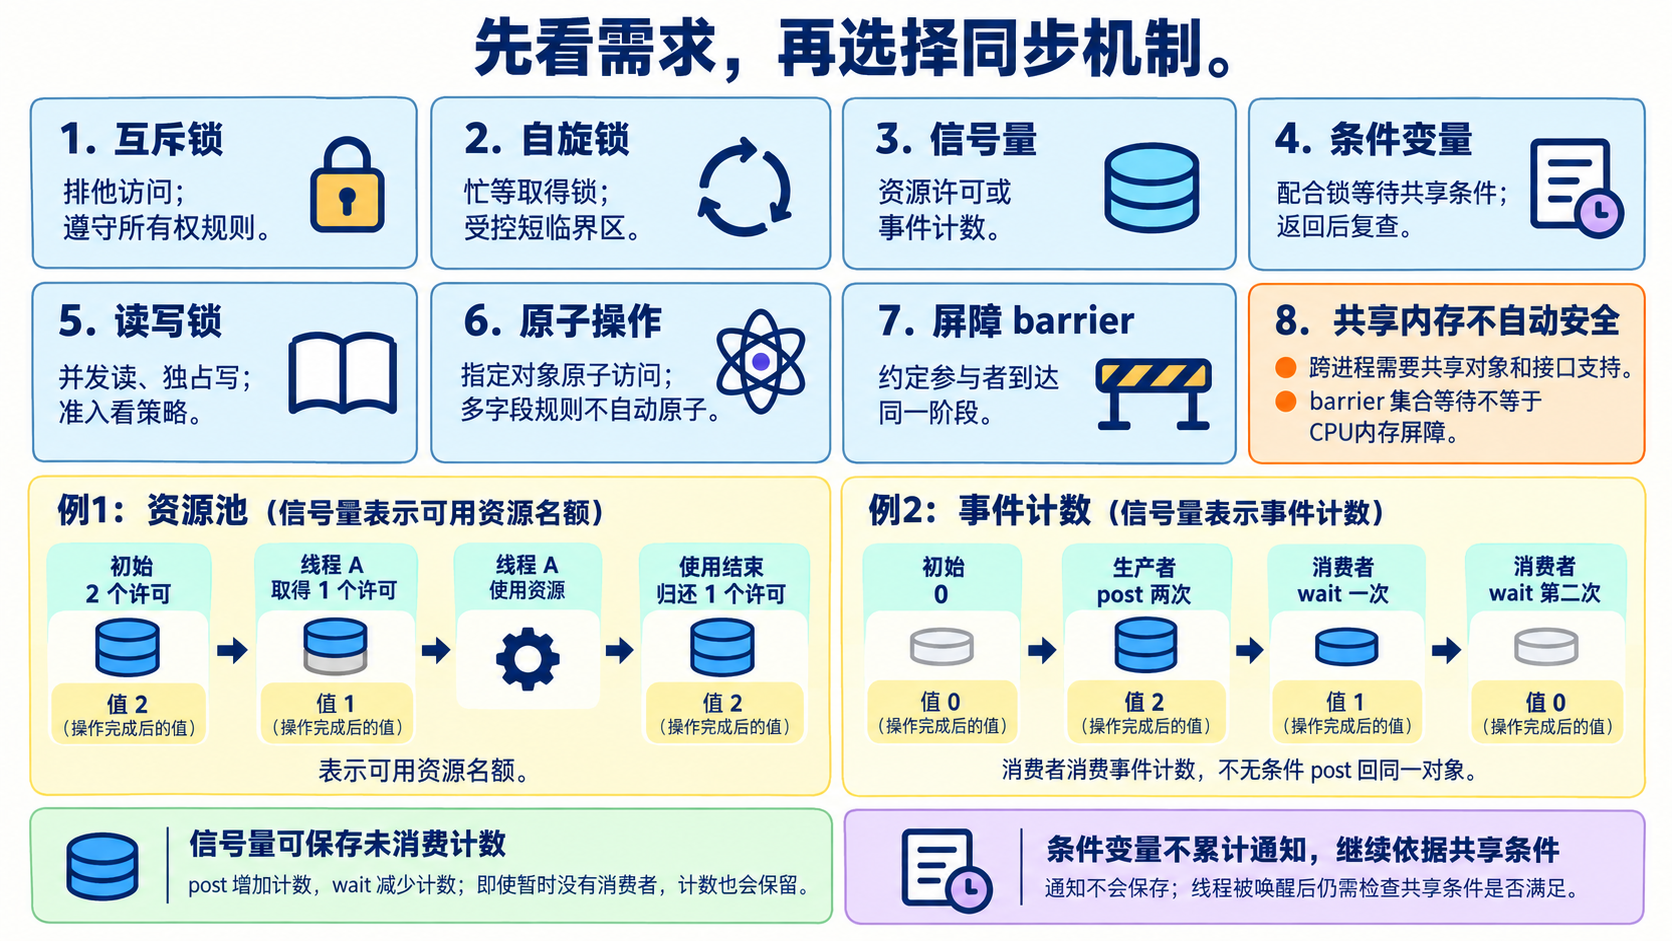
同步机制的选择,要从“在等什么、要保护什么”出发。保护一个共享队列、限制两个并发槽位、等待结果发布、等待所有工作线程到齐,是四种不同需求。 不能因为这些机制都让任务等待,就认为它们可以直接互换。
常见机制分别做什么?
| 机制 | 主要用途 | 需要注意的条件 |
|---|---|---|
| 互斥锁 | 保护需要排他的共享操作 | 按所有权规则解锁;竞争时可能阻塞或先短暂自旋,具体看实现 |
| 自旋锁 | 通过反复检查等待取得锁 | 等待者消耗 CPU;适合受控的短临界区,不适合持锁做长时间阻塞工作 |
| 信号量 | 管理许可数量,或表达完成事件数量 | 资源许可按协议取得与归还,事件计数由发布者增加、等待者消耗;通常没有互斥锁式的持有者身份 |
| 条件变量 | 等待受锁保护的某个条件成立 | 配合互斥锁和共享条件使用,醒来后重新检查 |
| 读写锁 | 允许并发读,写入独占 | 需要明确读写准入和公平策略 |
| 原子操作 | 不可分割地更新指定对象,并按规则建立访问顺序 | 单个字段原子,不代表多个字段的业务规则自动原子;内存序也需正确选择 |
| 屏障(barrier) | 等待一组参与者到达同一个阶段 | 所需参与者未到达时不能越过;这里指集合等待,不是 CPU 内存屏障 |
例如一个独立统计计数可以考虑原子增量;“余额减少并且订单状态变化”的共同规则却不能靠两个互不关联的原子字段自动成立。更复杂的无锁结构还涉及重试、对象生命期和内存回收,并不是把所有变量改成原子就完成了设计。
信号量怎样把“可用名额”交给等待者?
以 POSIX 风格的计数信号量为例,初值 2 表示有两个许可。A 成功等待并取得一个,剩 1;B 再取得一个,剩 0;C 此时等待。A 归还许可后,C 才有机会取得它。取得和归还对计数的修改是原子的,不需要应用先读一个普通计数再自行减一。POSIX 信号量概览
教材常把申请与归还称为 P/V。不同教材可能使用负数编码等待者数量;这里采用 POSIX 语义理解,无许可时等待,不把“等待者人数”直接画成负的可用许可数。二值信号量虽然能约束一次一个参与者,但并不因此具有互斥锁全部的所有权和优先级协议。
资源池与事件计数,计数含义不同
刚才的两个许可可以代表两个连接槽位:使用者先取得名额,使用结束后归还。此时要维护可用资源数量,避免忘记归还或重复归还。
另一种用法是记录“有多少完成事件尚未被消费”。另设一个独立事件信号量,初值为 0;假设没有其他线程插入,生产者完成两项工作后分别 post,计数变为 2;消费者成功 wait 两次,计数回到 0。即使发布先于等待,计数仍能保存尚未消费的事件。消费者不能无条件向这个信号量 post 回去,否则会把已消费的事件重新计入,后续等待可能在没有新事件时成功。
所以,P/V 或 wait/post 描述的是计数操作,不一概表示同一线程向同一信号量借出再归还。计数本身也不携带工作结果,应用仍需按协议保存、访问结果。条件变量不累计通知,必须依据共享条件决定是否等待;这一点与事件信号量不同。
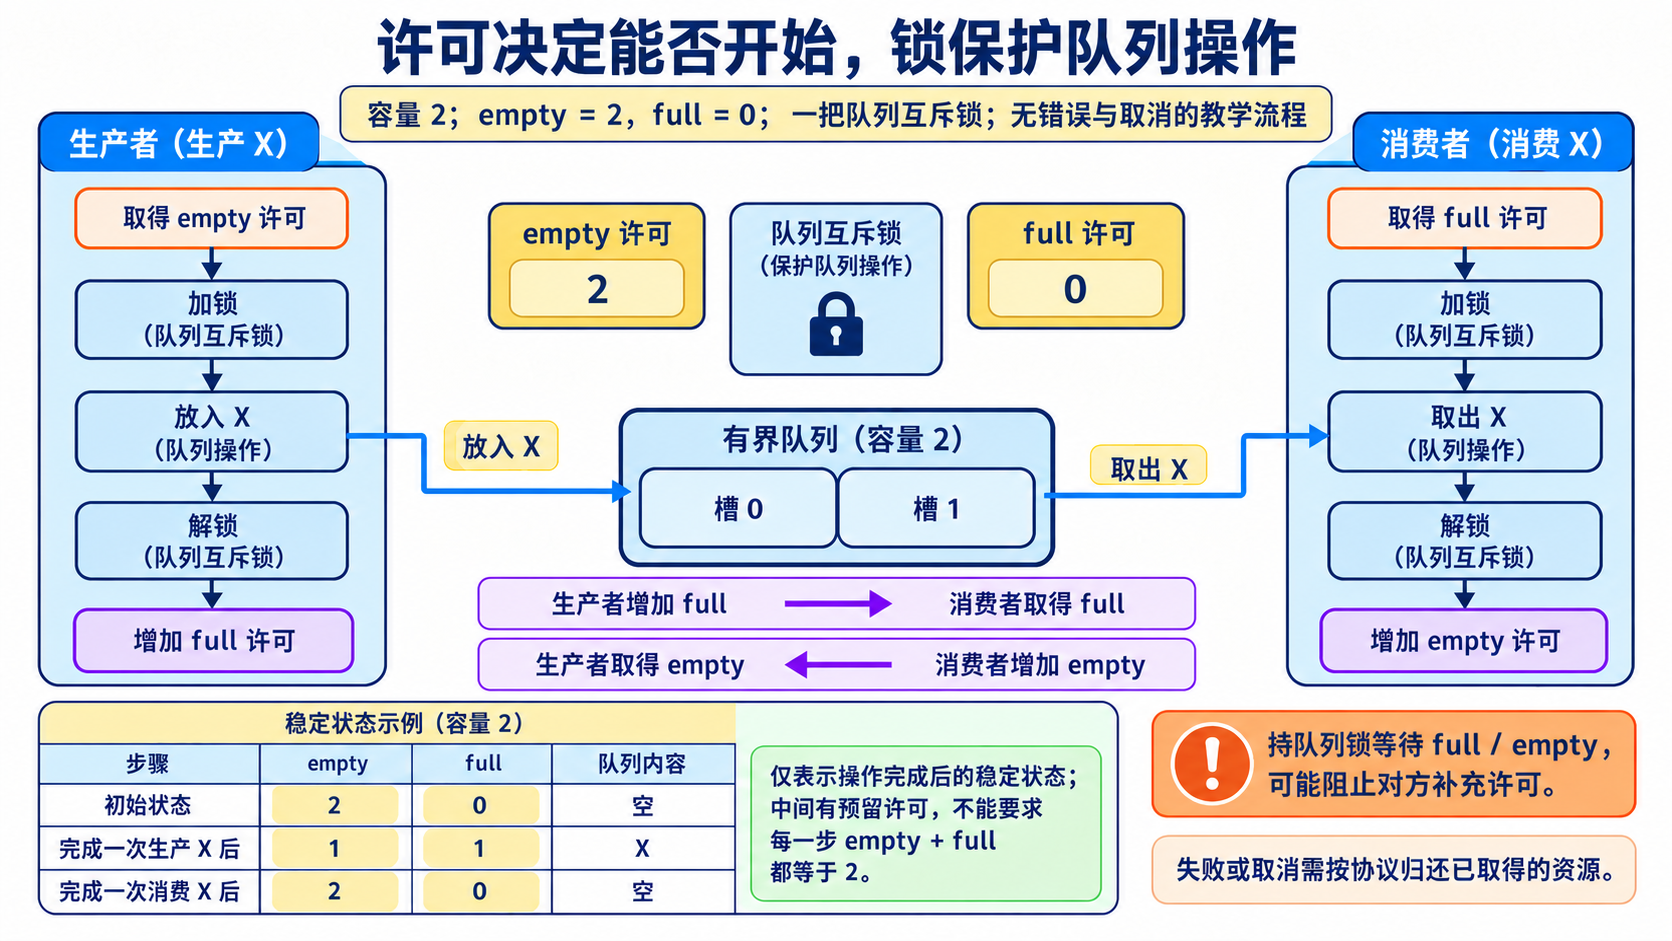
一个容量为 2 的有界队列,可以用 empty=2 表示空槽、full=0 表示可取元素,再用互斥锁保护队列结构。无错误、无取消的教学流程为:
生产者:取得empty许可 → 加锁 → 放入X → 解锁 → 增加full许可
消费者:取得full许可  → 加锁 → 取出X → 解锁 → 增加empty许可
这里生产者执行 wait(empty) 后发布的是 full,消费者执行 wait(full) 后补充的是 empty:两个信号量跟踪不同状态,不是每次取得后都向同一个对象归还。
只观察这次生产与消费分别完成后的稳定状态:
| 状态 | empty | full | 队列 |
|---|---|---|---|
| 初始 | 2 | 0 | 空 |
| 完整生产一个 X 后 | 1 | 1 | X |
| 完整消费 X 后 | 2 | 0 | 空 |
空槽与元素许可解决“能否开始”,锁解决“同时修改队列会不会破坏结构”。不要先拿队列锁再等待许可:例如队列为空时,消费者拿着锁等 full,生产者又需要这把锁才能放入元素,就可能互相卡住。
在取得许可、尚未发布或归还许可的中间阶段,存在已预留但未完成的操作,因此不能要求 empty+full 在每一条指令后都等于容量。真实代码还要处理取得许可后取消、失败或抛出异常时如何归还资源。OSTEP:信号量与有界缓冲
条件变量为什么必须重新检查条件?
条件变量不保存队列元素,也不积累“通知次数”供未来调用者逐个消费。共享队列是否非空,才是决定能否继续的条件。等待者应先持有保护队列的锁,条件不满足时执行条件等待;等待操作原子地释放锁并进入等待,返回时已经重新取得锁,再检查条件。原子性针对相应锁与条件通知协议,不能用“手动解锁后再休眠”代替。
收到通知以后,条件仍可能不满足:其他消费者可能已经取走唯一的元素,也可能出现虚假唤醒。因此应采用“条件不满足就继续等待”的循环,或带条件判断的等待接口。通知先到、等待者后来的场景,也要靠已保存的共享状态判断是否还需要等待,而不是把通知当成永久保存的消息。POSIX:条件等待语义
下面是教学伪代码,不是完整的可运行程序;假设队列无容量限制,省略错误、取消和退出协议,生产者与消费者共享同一个 m、cv 和队列:
consumer:
  lock(m)
  while queue.empty():
    wait(cv, m)  // Atomically release m and wait; return holding m.
  item = queue.pop()
  unlock(m)
  process(item)

producer:
  lock(m)
  queue.push(item)
  unlock(m)
  notify_one(cv)
如果生产者先发布,消费者随后持锁检查时已经发现队列非空,就不需要等待通知。如果消费者已经等待,通知使它有机会继续;即使被唤醒,也要先重新取得 m,再由 while 判断能否取出。通知不携带 item,也不保证消费者立刻获得 CPU。本例在解锁后通知,不表示所有正确用法都只能把通知放在这里。
第 12 题的结果队列就是这样的交接。生产者按协议修改共享状态,通知等待者;消费者醒来重新持锁检查。正确同步还建立对共享修改的可见性与顺序,不能只靠休眠几毫秒或 C/C++ 的普通 volatile。
这些机制能直接跨进程使用吗?
不能一概而论。同一进程的线程可以访问同一个同步对象;不同进程则需要共享可访问的对象,并使用接口支持的进程共享配置。例如 POSIX 未命名信号量用于跨进程时,需要相应配置并放在共享内存中;命名信号量也可供多个进程使用。普通的进程私有互斥锁不能只因为“地址数值相同”就协调不同进程。
面试回答
互斥锁和自旋锁保护排他访问,信号量管理资源许可或事件计数,条件变量等待共享条件,读写锁区分读与写,原子操作保护指定对象的原子访问,屏障协调多个任务的阶段进度。资源池许可需要按协议归还,事件计数由发布者增加、等待者消耗,不能混为一谈。条件等待配合锁,原子释放锁并等待,返回后持锁复查。跨进程同步还必须使用共享可访问、支持进程共享的对象和配置。
19. 什么是优先级反转?如何解决?
优先级反转是高优先级任务因为等待低优先级任务持有的资源,间接受到较低优先级任务的影响。 最典型的情况是:低优先级任务要先运行并释放锁,高优先级任务才能继续,但中优先级任务不断把低优先级任务抢下去。
高优先级为什么反而要等?
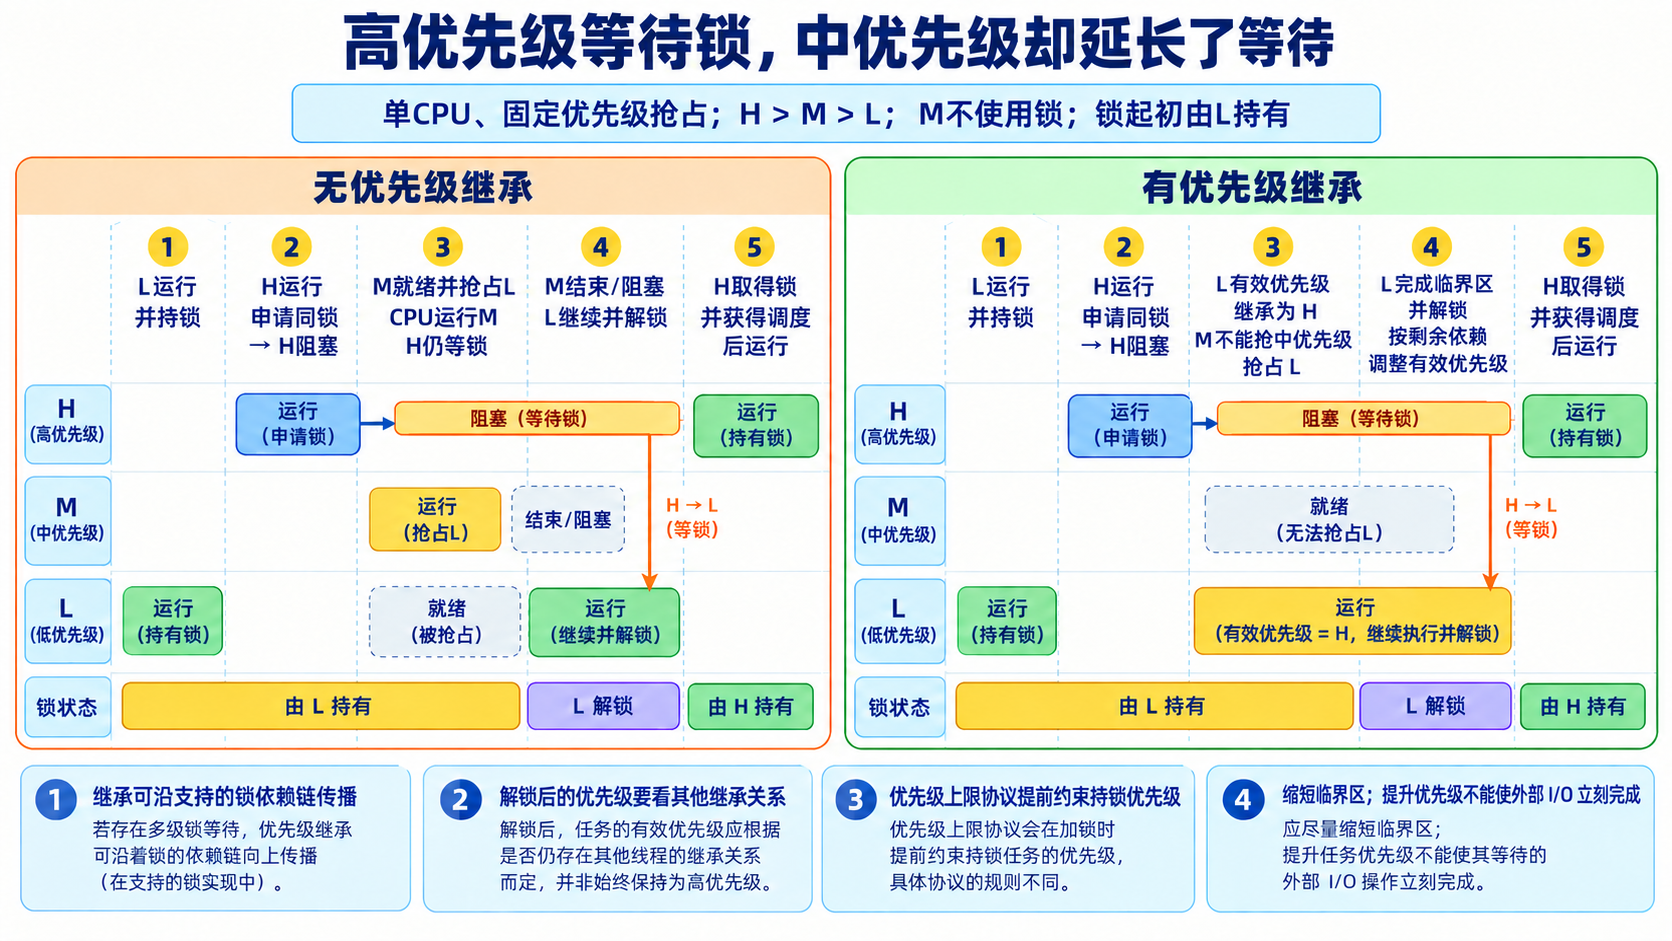
假设只有一个 CPU,采用固定优先级抢占调度,优先级 H>M>L。L 和 H 使用同一把互斥锁,M 不使用这把锁:
- L 先运行,取得锁,尚未完成临界区。
- H 进入就绪状态并运行,但申请锁时发现锁由 L 持有,于是等待。
- L 本来可以继续执行并解锁,这时 M 就绪。M 不使用这把锁,却因为优先级比 L 高而先运行。
- M 结束或阻塞以后,L 才继续完成临界区、释放锁。
- H 得到锁并获得调度以后,才能继续。
H 并不是按规则输给了 M:它已经被锁挡住,无法参与普通的可运行任务竞争。M 延长了 L 释放锁的时间,H 的等待也随之延长。如果 M 的工作不断到来,等待可能远超 L 剩余临界区的执行时间。Linux:RT-mutex 与优先级继承
优先级继承:让挡住高优先级任务的人先完成
支持优先级继承的锁发现 H 正在等待 L 时,会按规则提高 L 的有效优先级,使它能够尽快完成临界区。这次关系中,L 临时获得 H 的优先级,M 就不能再凭中优先级打断它。
过程变为:H 等待 → L 继承优先级并继续 → L 解锁 → 按剩余继承关系调整 L 的优先级 → H 取得锁并继续。H 并不会绕过互斥直接进入,锁仍由 L 持有直到正确释放。
如果 L 又在等待另一个任务持有的支持继承的锁,优先级可能沿依赖链传播。解锁后也不能机械地一律恢复基础优先级:还要检查 L 是否仍因其他锁上的高优先级等待者需要继承。
优先级上限:提前约束持锁阶段
优先级上限协议预先为锁设置与潜在使用者有关的上限。以 POSIX PTHREAD_PRIO_PROTECT 这样的立即提升机制为例,任务持有锁时,其有效优先级会按所持锁的上限等规则确定,而不是等高优先级任务已经阻塞后才开始提升。POSIX:互斥锁优先级协议
沿用单 CPU、固定优先级 H>M>L 的模型,假设接口与平台支持、锁已正确配置,潜在使用者为 H、L,锁的上限设为 H。L 一取得这把立即提升型上限锁,有效优先级就按规则提升到 H;即使此时 H 尚未等待,M 也不能凭中优先级抢占持锁的 L。L 解锁后,再根据剩余持锁与协议依赖重新计算有效优先级,不一定机械地直接恢复基础优先级。POSIX:继承与立即提升型上限的区别
对照来看,继承通常在高优先级任务等待时提升阻塞它的持有者;立即提升型上限在取得锁时就约束持锁任务的优先级。这里仅说明 M 不能凭较低优先级延长持锁阶段,不承诺同优先级 H 在某个精确时刻一定运行。
“优先级上限协议”并不是只有一种实现,经典上限协议还可能包含额外准入规则。不能把所有上限机制都简化成“随便把锁设成最高优先级”,也不能无条件宣称它消除了全部死锁。
还需要控制什么?
继承主要抑制无关中优先级任务扩大阻塞时间。L 自己的临界区仍然需要执行;如果 L 持锁做不可控的长时间 I/O,提升优先级也不能让设备立即完成。因此还应缩短临界区、避免持锁等待不可控事件,并分析锁依赖和阻塞上界。
普通锁未必默认开启继承或上限协议。具体接口、调度策略和平台是否支持,需要查证配置。优先级反转也不同于饥饿或死锁:这里可能仍能最终完成,只是高优先级任务被不合理地延迟。
面试回答
优先级反转的典型链条是高优先级 H 等待低优先级 L 持有的锁,中优先级 M 又抢占 L,延长 H 的等待。优先级继承临时提升实际阻塞者的有效优先级,让它尽快解锁;优先级上限协议则提前约束持锁任务的优先级及相应准入行为。但这些机制不消除临界区本身的执行成本,还要控制持锁时间和资源依赖,且锁与平台必须支持对应协议。
20. 什么是读写锁?为什么会发生读写饥饿?
读写锁允许多个读者同时访问受保护的数据,写者则必须独占。 它适合读操作之间不会相互破坏状态、写操作需要排他访问的场景。例如多个线程查询同一份配置时可以共享读锁,修改配置的线程则取得写锁。
这里的“读”是对受保护状态不作破坏性修改。名叫“查询”的函数如果还更新共享缓存或统计,就不能仅凭函数名判断可以放在读锁下。
读者和写者怎样相互等待?
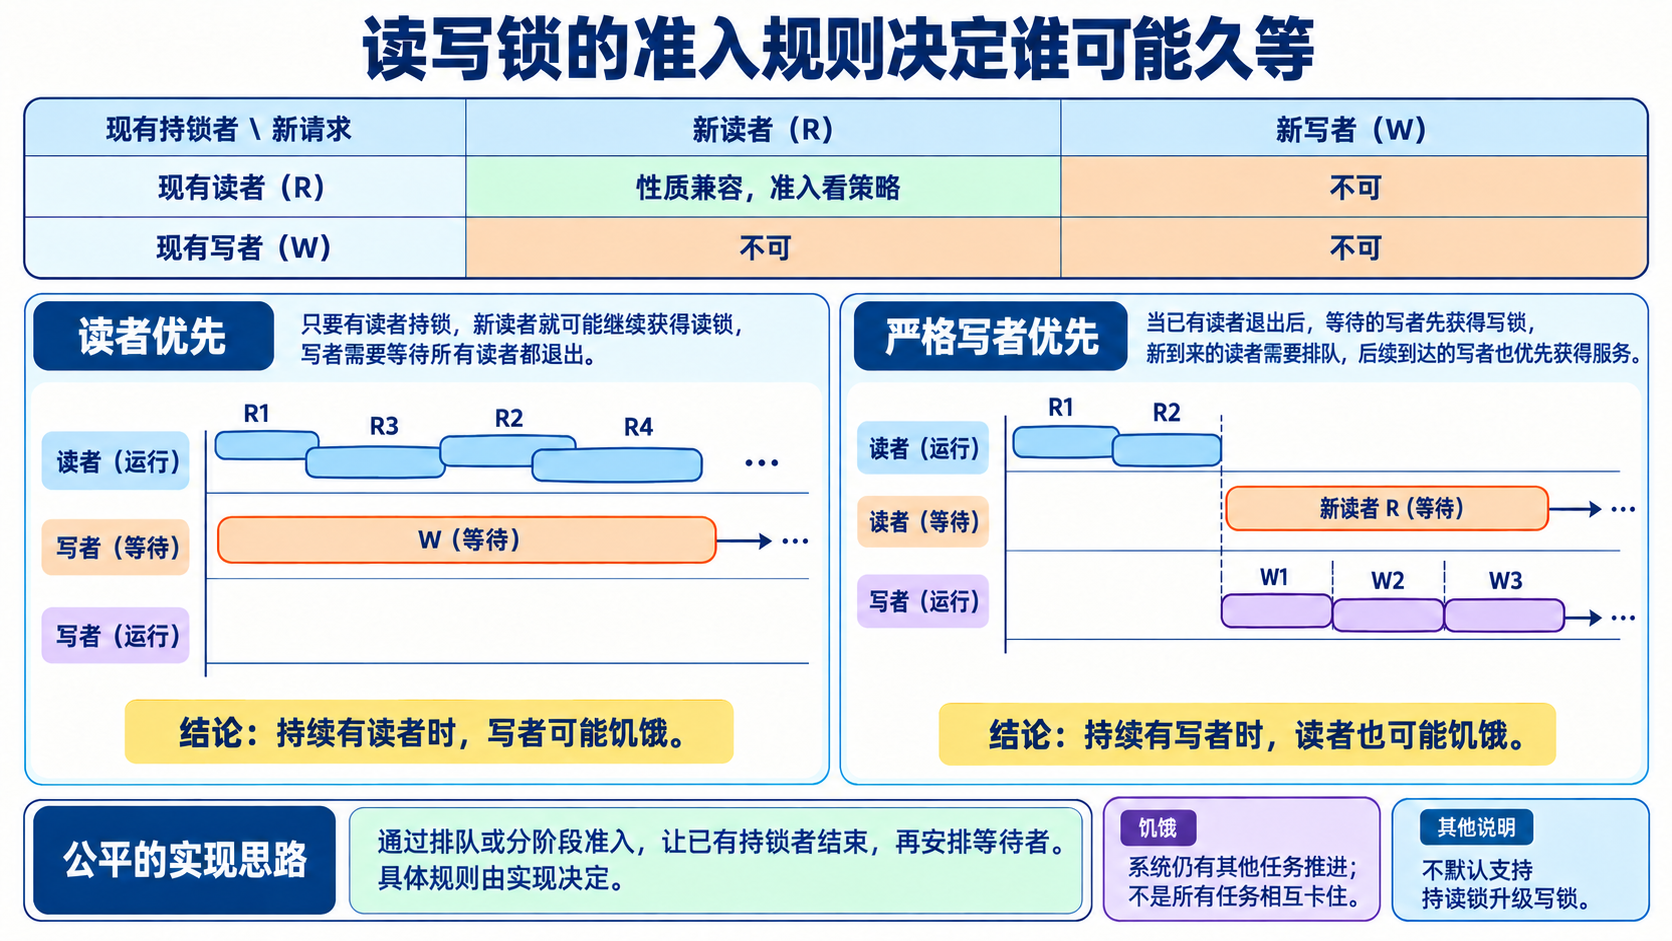
| 已有持锁者 | 新读者能否同时进入 | 新写者能否同时进入 |
|---|---|---|
| 只有读者 | 访问性质允许;是否放行还取决于等待队列策略 | 不能,需等读者退出 |
| 一个写者 | 不能 | 不能 |
假设 R1、R2 已经取得读锁,W 随后申请写锁。W 必须等已有读者退出。接下来新读者 R3 到来时,是让它继续加入,还是先让它等待 W?这就是公平策略要决定的问题。
读者优先为什么可能饿死写者?
一种读者优先策略允许新读者在已有读者仍活跃时继续进入,即使 W 已经排队。R1 退出前 R3 进入,R2 退出前 R4 又进入。如果这种交接不断持续,始终至少有一个读者,W 就一直拿不到独占机会。
每个读者都能结束,整个系统也有进展,但 W 长期无法推进,这叫写者饥饿。它不是所有人互相等待而无法前进的死锁。glibc 的特定读写锁类型确实需要考虑读者偏好带来的写者饥饿,不能把 POSIX 或 C++ 的所有读写锁都理解成统一的公平实现。Linux:读写锁类型与饥饿
反过来,如果采用严格写者优先,等待的写者会阻止新读者进入,而写者又持续到来,读者也可能长期等待。写者优先解决的是某种写者等待问题,不自动保证两方都公平。
怎样控制饥饿?
可以采用排队、分阶段服务或其他公平准入策略。例如一旦 W 排队,就暂停放行排在它后面的新读者,让已进入的读者结束,再安排 W;后续读者也应按策略获得机会。这里的“让当前读者退出”不意味着强行中断正在执行的读临界区。
公平通常会影响吞吐与延迟,具体实现也未必严格 FIFO。还需要持锁任务能够结束并被调度,才能论证等待者最终推进,不能只看到“公平”标签就承诺固定等待时间。
另外,不要默认支持持着读锁直接升级为写锁。如果两个读者都保留自己的读锁、等待其他读者退出再升级,可能形成死锁。需要使用接口明确支持的升级协议,或先释放读锁、取得写锁后重新检查数据;释放期间,状态可能已经变化。
一定比互斥锁快吗?
不一定。读写锁要维护读者状态和准入逻辑;如果临界区很短、写入频繁,管理和竞争成本可能抵消并发读的收益。选择时应看读写比例、读操作耗时与延迟要求,而不是只凭“读取多”就认定更快。
面试回答
读写锁允许多个读者共享访问,写者独占。已有读者活跃时若不断放行新读者,写者可能长期等不到空档;严格写者优先又可能让读者饥饿,因此需要明确准入与公平策略。饥饿不同于死锁,读锁升级也不能假设天然安全。读写锁是否合适,要结合实际访问性质、临界区长度和公平性要求判断。
21. 死锁为什么会发生?操作系统如何处理死锁?
死锁是一个任务集合中的成员互相等待,所需条件又只能由集合内其他无法继续的成员满足,从而无法推进。 常见例子是两个任务各拿着一把锁,都不释放,转而等待对方手里的锁。
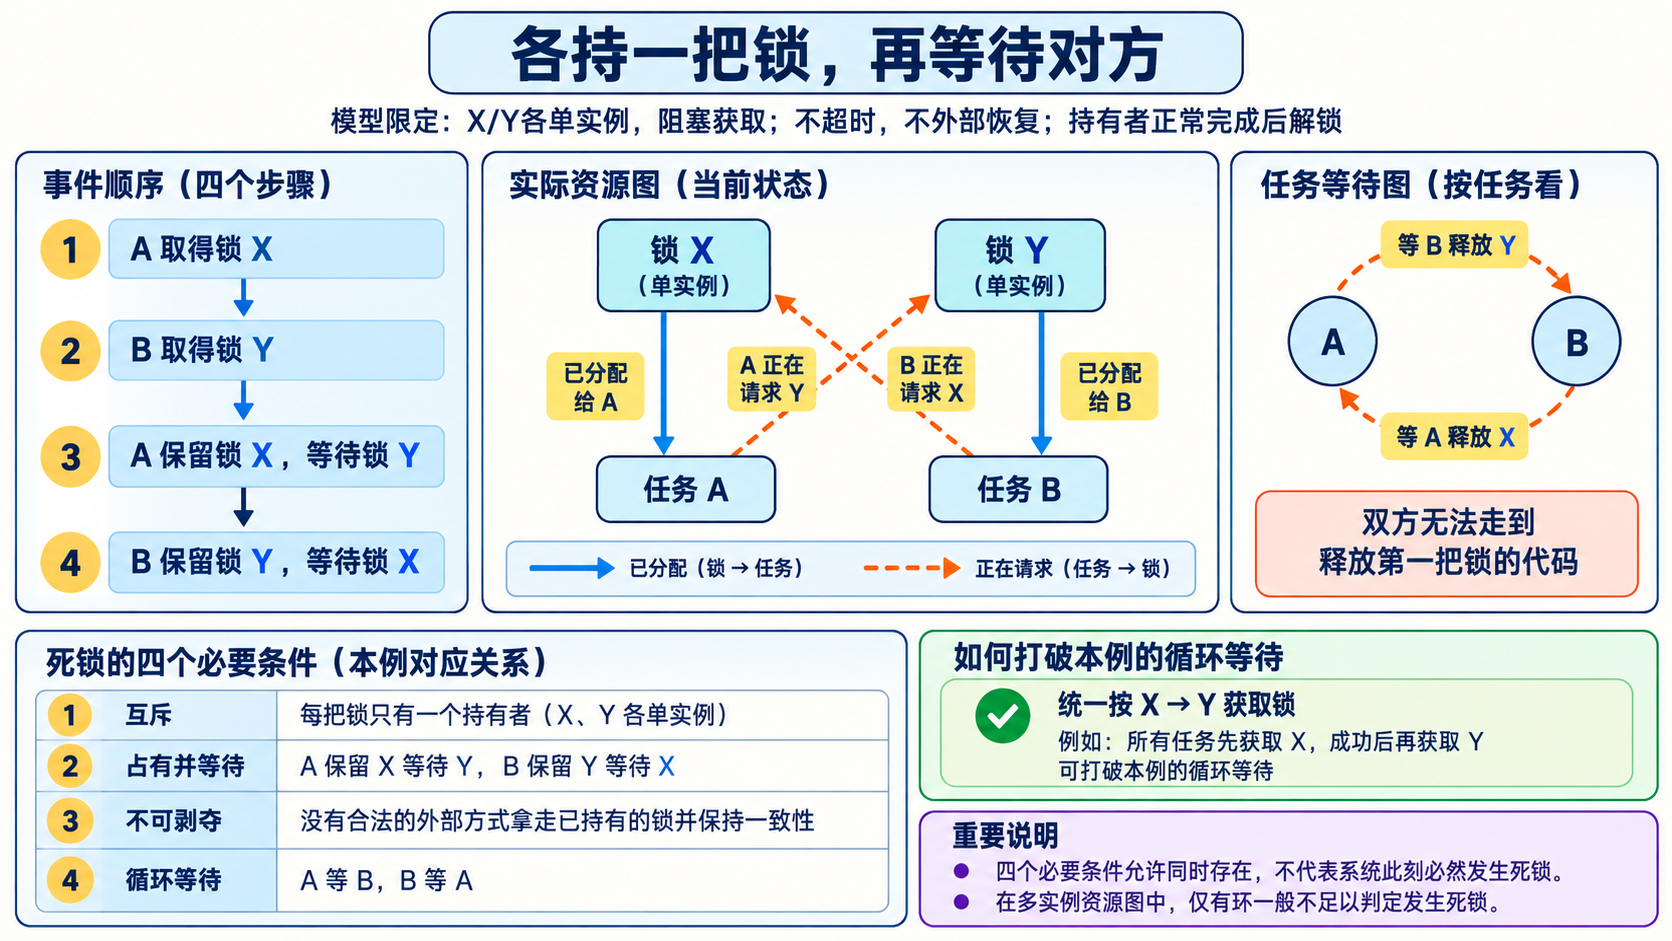
两把锁怎样把两个任务都卡住?
假设锁 X、Y 都只有一个可用持有者,A、B 用阻塞方式取得锁,只有持有者完成相应工作后才会解锁,没有超时或外部恢复:
- A 取得 X。
- B 取得 Y。
- A 保留 X,等待取得 Y。
- B 保留 Y,等待取得 X。
A 的等待依赖 B 释放 Y,B 的等待又依赖 A 释放 X。可是二者都停在取得第二把锁的位置,无法走到释放第一把锁的代码。即使增加 CPU 核心,也不能让这两个等待条件自动满足。
可以画成等待关系 A→B→A,箭头表示“正在等待对方持有的锁”,不表示 CPU 执行或数据流方向。
四个必要条件怎样对应这个例子?
在经典可重复使用资源模型中,死锁需要同时具备以下条件:
| 必要条件 | 本例对应的事实 |
|---|---|
| 互斥 | X、Y 同时只能分别由一个任务持有 |
| 占有并等待 | A、B 保留第一把锁,再等待第二把 |
| 不可强行剥夺 | 没有合法的外部机制直接拿走持有者的锁并维持一致性 |
| 循环等待 | A 等 B,B 等 A |
这些是必要条件,不是“某个系统允许这四种行为,所以它此刻一定死锁”。还要检查当前分配与实际等待关系。对于每种资源只有一个实例的经典分配图,环可用于判定死锁;有多个实例时,仅有图上的环一般不足以判定。OSTEP:并发错误与死锁
系统可以怎样处理?
预防是在规则上破坏某个必要条件。比如要求所有相关任务按 X→Y 的统一顺序取得锁:B 如果还没拿到 X,就不能先占着 Y 等 X,从而阻止这个反向获取形成的环。也可以要求一次取得所需资源,或在得不到下一资源时释放已有资源,但会带来利用率、重试和饥饿等代价。并不是所有临界资源都能取消互斥,也不是锁可以随意被别人强行解开。
避免是在分配前,根据需求信息检查“分出去以后,还能不能找到所有任务依次完成的路径”。典型方法是银行家算法,需要提前知道可信的最大资源需求,才有条件作这样的判断。
检测与恢复则允许先分配,之后检查实际等待关系。发现死锁后,可以按策略中止任务、回滚或收回能够安全重建的资源,再恢复推进。终止一个任务、释放相关资源仍要处理它留下的部分修改;对任意互斥锁做外部强制解锁,可能让数据处于损坏状态。
还有系统或应用会选择不做全面自动处理,把部分死锁交给超时、诊断与人工重启。这是成本和恢复要求的取舍,不代表普通操作系统会自动检测并解除所有用户态锁死锁。Linux 的 lockdep 主要帮助发现内核锁依赖问题,也不是任意应用的自动恢复器。Linux:lockdep 的职责与边界
银行家算法为什么要区分安全和不安全?
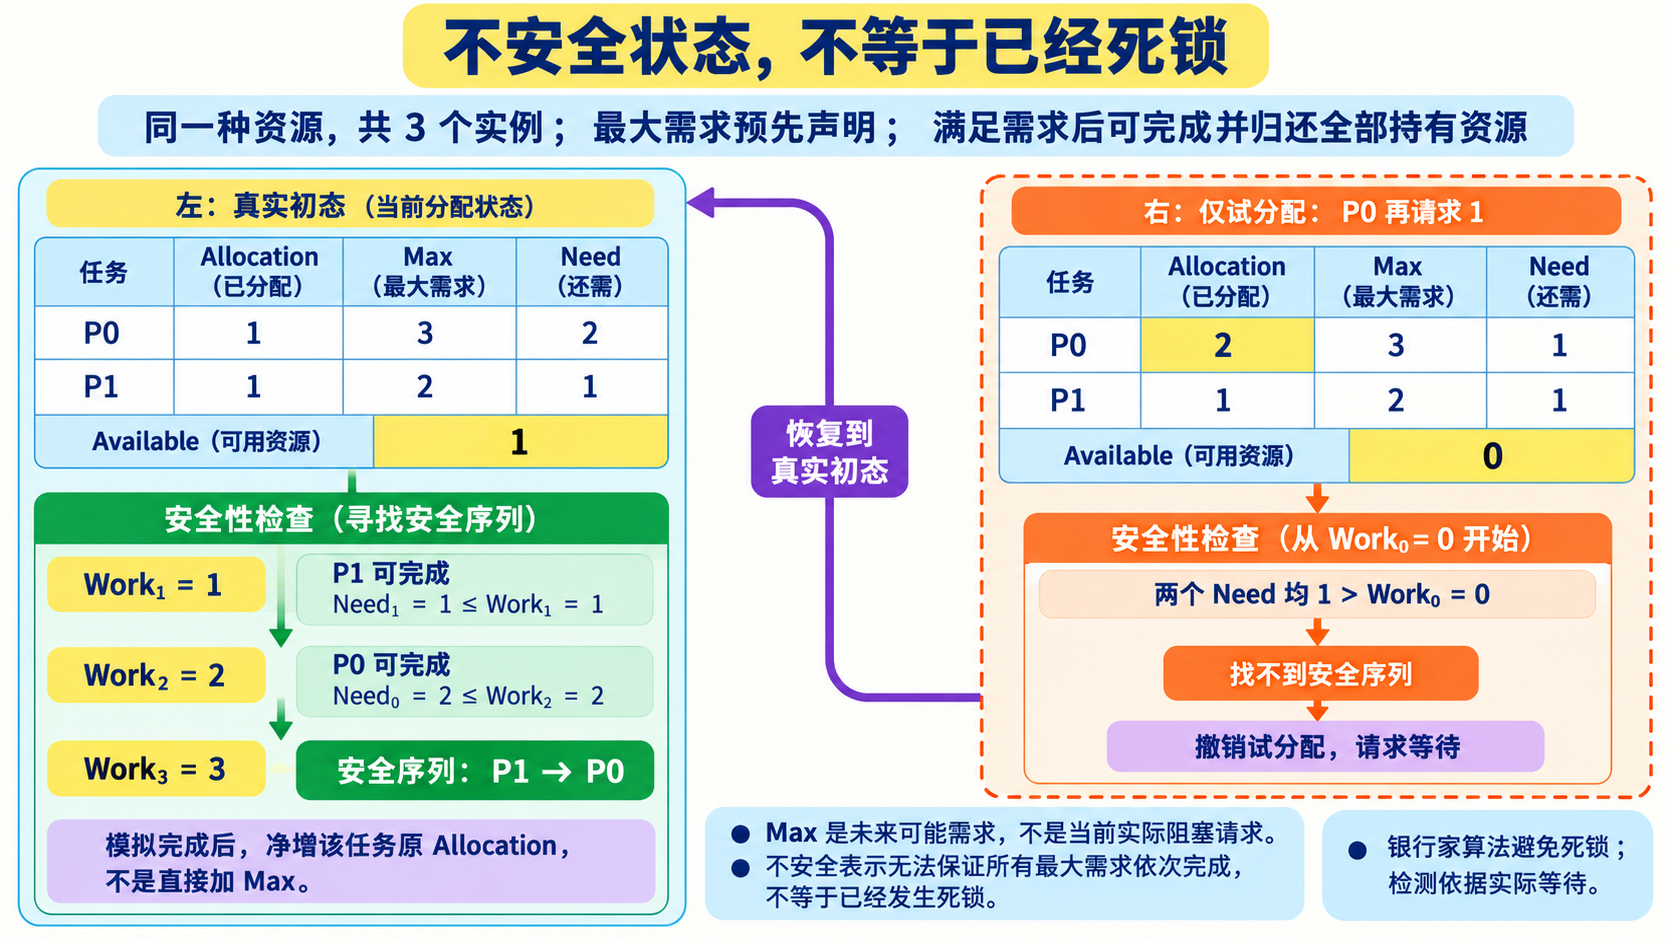
设系统只有一种资源,共 3 个可互换实例。任务会声明最大同时需求,获得足够资源后可以完成并归还全部持有资源;先忽略 CPU 等其他限制。
| 任务 | 已分配 Allocation | 最大需求 Max | 剩余需求 Need=Max−Allocation |
|---|---|---|---|
| P0 | 1 | 3 | 2 |
| P1 | 1 | 2 | 1 |
当前还剩 Available=3−1−1=1。虽然 P0 还需 2 个,P1 只需 1 个,因此可以先满足 P1。P1 完成后归还自己最终持有的 2 个,剩余可用数变为 2;再满足 P0,P0 完成后归还 3 个。存在安全序列 P1→P0,所以这个状态安全。
安全性检查常把可用资源记为 Work。模拟一个任务完成后,计算 Work+=它原先的Allocation:这里是 1→2→3。原因是临时借给它的剩余需求,会在完成时一起归还,净增加的是检查开始时已经被它占用的资源;不能既加 Max 又忘记减掉借出的 Need。
现在 P0 请求再取得 1 个。请求没有超过它剩余的 2 个需求,也没有超过当前 1 个可用实例,但仍不能直接认为可批准。先试分配:
| 任务 | 试分配后的 Allocation | Max | Need |
|---|---|---|---|
| P0 | 2 | 3 | 1 |
| P1 | 1 | 2 | 1 |
此时 Available=0,没有任何任务的 Need 能被满足,找不到安全序列。银行家算法因此撤销试分配,让这次请求等待;真实分配仍保持原来的安全状态。
试分配状态不安全,不等于已经发生死锁。 Max 是未来可能需求的声明,不代表两个任务此刻都已经阻塞等待剩余资源。算法无法保证未来所有合法需求都能完成,所以保守地不批准;死锁检测则依据已经发生的分配和等待。UIC:安全状态与银行家算法
超时能自动解决死锁吗?
超时让任务有机会离开等待,但需要有明确的失败处理:释放自己已取得的资源、撤销未完成修改,或把工作交给恢复流程。仅仅输出“超时了”然后继续持有资源,并不会解除依赖。反复释放后同步重试,也可能出现活锁;一直有其他任务推进而某个任务长期得不到资源,则是饥饿,都应与死锁区分。
面试回答
死锁是任务互相等待、所需资源或条件又无法被释放或满足,典型原因是互斥、占有并等待、不可剥夺和循环等待同时出现。处理方法包括通过统一获取顺序等规则预防,通过安全状态分析避免,或者检测后中止、回滚与恢复。银行家算法需要最大需求信息,不安全状态并不等于已经死锁。操作系统不会替任意应用自动解决所有死锁,程序仍要设计好锁顺序、等待协议和失败后的清理。
阅读导航
上一章:操作系统基础校招面试题
下一章:内存管理校招面试题|操作系统



