
Linux 与高性能 I/O 校招面试题|操作系统
Linux 与高性能 I/O 校招面试题|操作系统
1. 并发和并行有什么区别?
假设服务器接连收到请求 A 和 B。处理请求时,有时需要 CPU 计算,有时要等待文件或网络数据。
我们希望两位用户都能得到及时响应,但“同时处理两个请求”可能指两件不同的事:在一段时间内交替推进两个请求,或者在同一时刻真正执行两个请求的计算。
前者是并发,后者是并行。
先看一个现实中的例子
客服中心同时接到顾客 A 和顾客 B 的咨询。只有一名客服时,他先回答 A 的问题;A 去查自己的订单号时,客服转去回答 B;A 发来订单号后,客服再继续处理 A。两个咨询在同一段时间内都有进展,但这名客服在任一时刻只处理其中一个——这对应并发。
如果有两名客服,一人处理 A、一人处理 B,而且两人正在同一时刻分别回答问题,这就对应并行。关键不在于“来了两个顾客”,而在于“是否真的有人同时处理两件事”。
回到计算机,顾客的咨询相当于待处理的请求,客服相当于执行计算的 CPU 核心;等待顾客补充订单号,类似程序等待网络或文件数据。类比只帮助区分处理方式,计算机中的任务切换和分配由程序与操作系统协作完成。
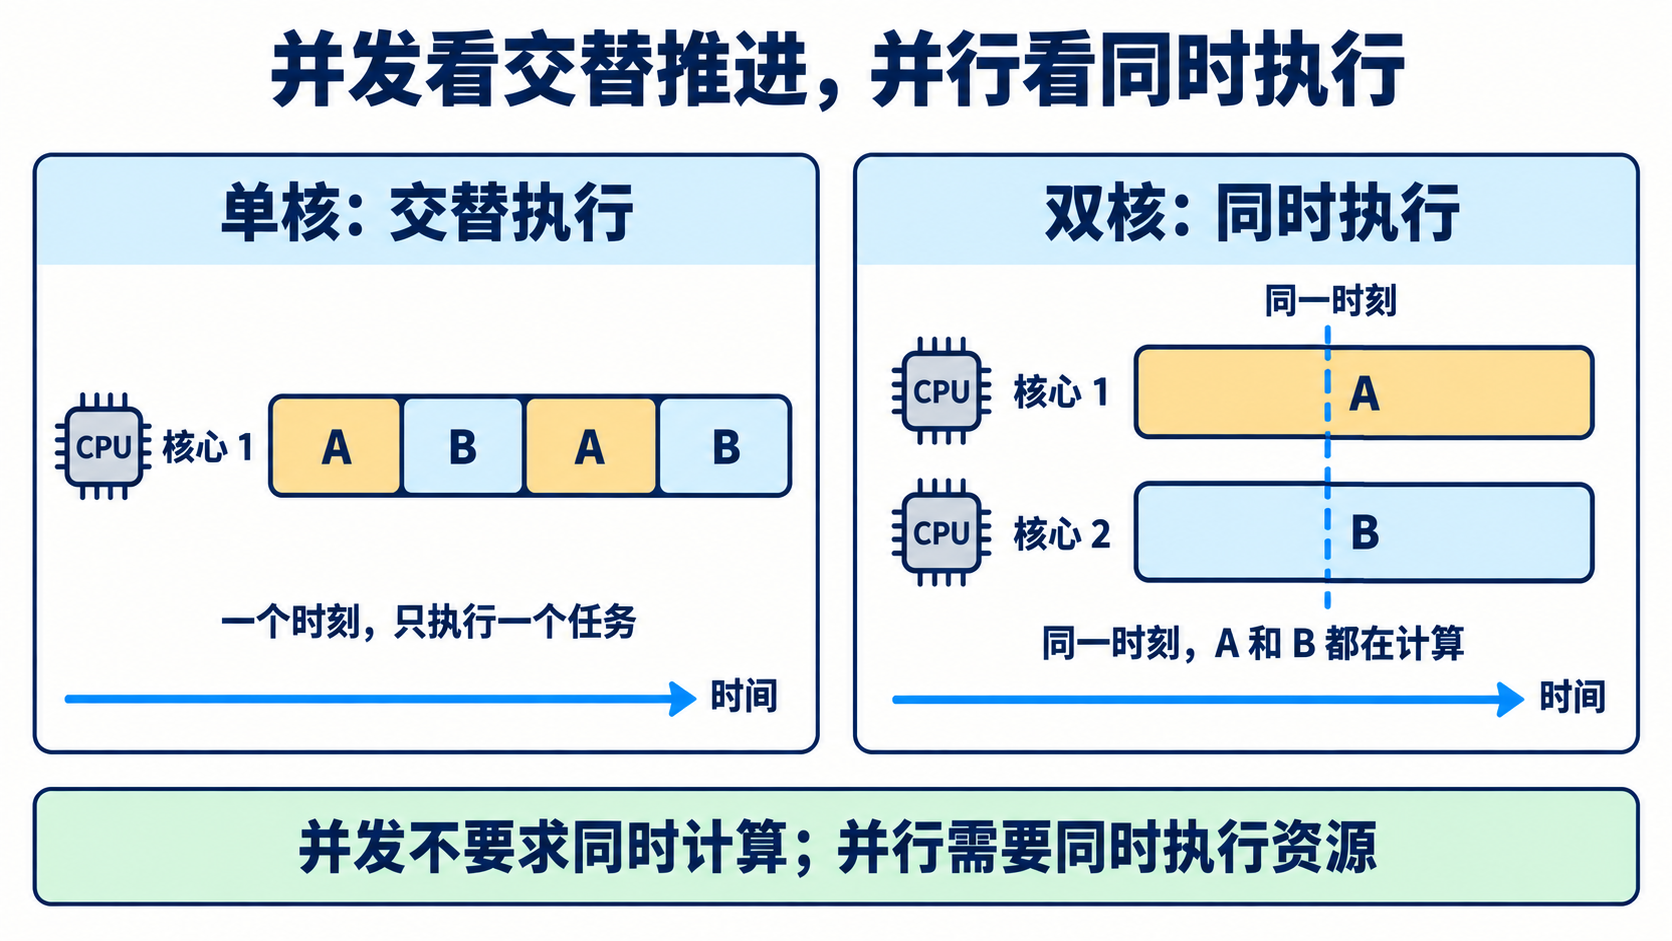
一个 CPU 核心也能并发
先假设服务器只有一个 CPU 核心,而且暂不考虑一个核心运行多个硬件线程的情况。服务器可以用不同线程处理请求 A 和 B;这里的线程,就是程序中一条能被调度执行的流程。核心先执行一小段 A,A 等待数据时转去执行 B;数据到达后,再择机继续执行 A。即使 A、B 都需要计算,系统也可以在两者之间切换:
时间向右推进:A 运行 → B 运行 → A 运行 → B 运行
从两项任务的开始到结束来看,它们都在这一时段内推进,因此具有并发性;但在这个假设下,同一个核心在某一时刻只执行其中一个线程的指令。并发描述的是怎样组织和推进多个任务,不要求它们的计算在同一瞬间发生。它也可以由不同进程,或由单线程事件循环组织。
这种安排解决了一个实际问题:A 等待 I/O 时,不必让 CPU 跟着空等,B 可以利用这段时间工作。于是并发可能改善响应速度和资源利用率,而不能简单说“并发不会提高性能”。
什么时候叫并行?
并行需要能够同时执行计算的硬件位置。这里用两个 CPU 核心来说明:一颗处理器芯片可以包含多个核心;每个核心都能执行分配给它的线程指令,因此两个核心可以在同一时刻分别做计算。《Operating Systems: Three Easy Pieces》多处理器调度章节
假设服务器有核心 1 和核心 2,请求 A、B 分别由工作线程 T_A、T_B 处理。两条线程都准备好计算时,调度器可以把 T_A 安排到核心 1,把 T_B 安排到核心 2

这就是并行。它强调同一时刻确实有多个计算在执行。对于可以拆分的 CPU 密集型工作,例如把一批图片分给两个工作线程处理,并行可能缩短完成时间。《Operating Systems: Three Easy Pieces》线程介绍
但“服务器有两个核心”不等于“两个请求一定并行”:如果程序始终只用一条线程执行计算,或其中一条线程正在等待数据、等待锁,就没有上述两个核心同时计算的过程。反过来,并行也不保证一定更快;拆分、同步、合并结果,以及争用内存等资源都要付出成本。
两者是什么关系?
并发关注任务能否在同一时间段内共同推进;并行关注某一时刻是否真的同时执行。单核上的交替处理可以并发而不并行;多核上的任务既可以并发推进,也可以并行执行。两者不是“只能二选一”的技术。Go 官方文章:Concurrency is not parallelism
面试总结
并发是组织多个任务,让它们在同一时间段内都有机会推进;即使只有一个 CPU 核心,也可以通过任务切换、利用 I/O 等待时间实现。并行则要求同一时刻确实有多个执行位置在工作,例如两个核心分别运行处理 A、B 的线程。并发有利于响应和资源利用,并行有机会加速可拆分的计算;是否更快仍取决于等待、同步和资源争用的成本。
2. 阻塞、非阻塞、同步和异步有什么区别?
假设服务器要从客户端连接中读取数据,但客户端还没有发来内容。服务器面临两个不同的问题:现在读不到数据时,调用它的线程要不要停下来等?以及数据准备好后,由谁真正完成读取,程序怎样得知结果?前一个问题对应阻塞与非阻塞,后一个问题对应同步与异步。它们不是两组相互排斥的选项。
下面都以网络 Socket 为例。Socket 可以先理解为程序收发网络数据时使用的接口;recv 是从它读取数据的调用。
阻塞与非阻塞:这次读取暂时做不了,线程怎么办?
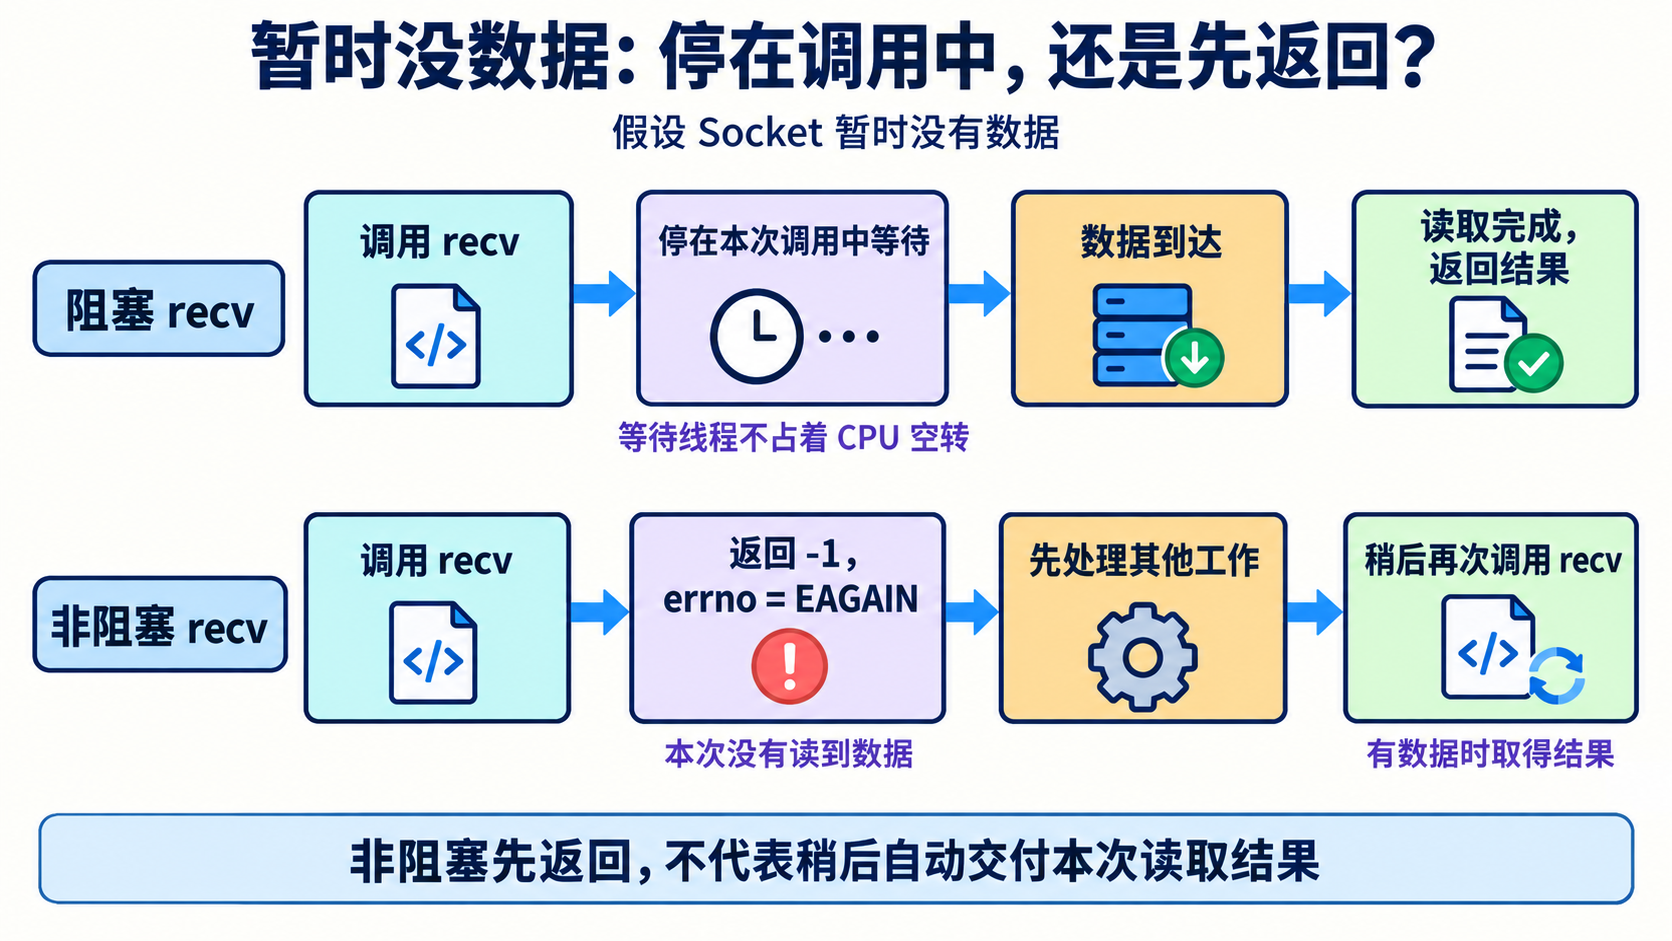
阻塞读取:线程调用 recv,如果暂时没有数据可读,通常会停在这次调用上等待。操作系统可以趁机运行其他线程,并不是整台机器都停住。有数据、连接关闭或发生错误时,调用会返回相应结果;设置了超时或受到信号中断等情况,也可能结束等待。阻塞不表示每次都要等待:如果数据已经可读,它可以很快返回。
非阻塞读取:把 Socket 设为非阻塞后,线程调用 recv 时若暂时没有数据,调用会立即返回错误,并以 EAGAIN 或 EWOULDBLOCK 告诉程序“现在还读不到”。线程可以先处理别的工作,之后再尝试读取,或借助 epoll 等机制等待可读通知。Linux recv(2) 手册
例如,客户端在 10:00 才发送数据,服务器在 9:59 就尝试读取:阻塞调用可能一直等到数据到达;非阻塞调用则先返回“暂时不可读”,让服务器在这一分钟里处理其他连接。非阻塞不是系统答应“稍后自动把本次读取结果送来”,程序仍需再次发起读取。
同步与异步:读取结果通过什么方式交给程序?
假设服务器要从连接 B 接收数据,并把数据放进程序准备的缓冲区。一次读取的结果,可能是“读到了 100 字节”,也可能是“暂时没有数据”或“读取出错”。同步与异步的区别,是程序怎样取得这个结果。
同步读取:程序调用 recv,由 recv 返回读取结果。 如果成功读到 100 字节,recv 返回 100,数据已经放入缓冲区,程序接着处理。如果连接暂时没有数据,阻塞的 recv 可以等数据到来;非阻塞的 recv 则返回 -1,错误码为 EAGAIN 或 EWOULDBLOCK。后者并没有留下一项“等数据到了自动继续”的读取任务,程序想取得后来到达的数据,需要再次调用 recv。
异步读取:是一种把“提交读取请求”和“取得读取结果”分成两个阶段的 I/O 方式。 程序提交请求后,可以先做其他事。系统处理已提交的请求;读取完成后,程序再取得结果,不需要重新发起同一项读取。
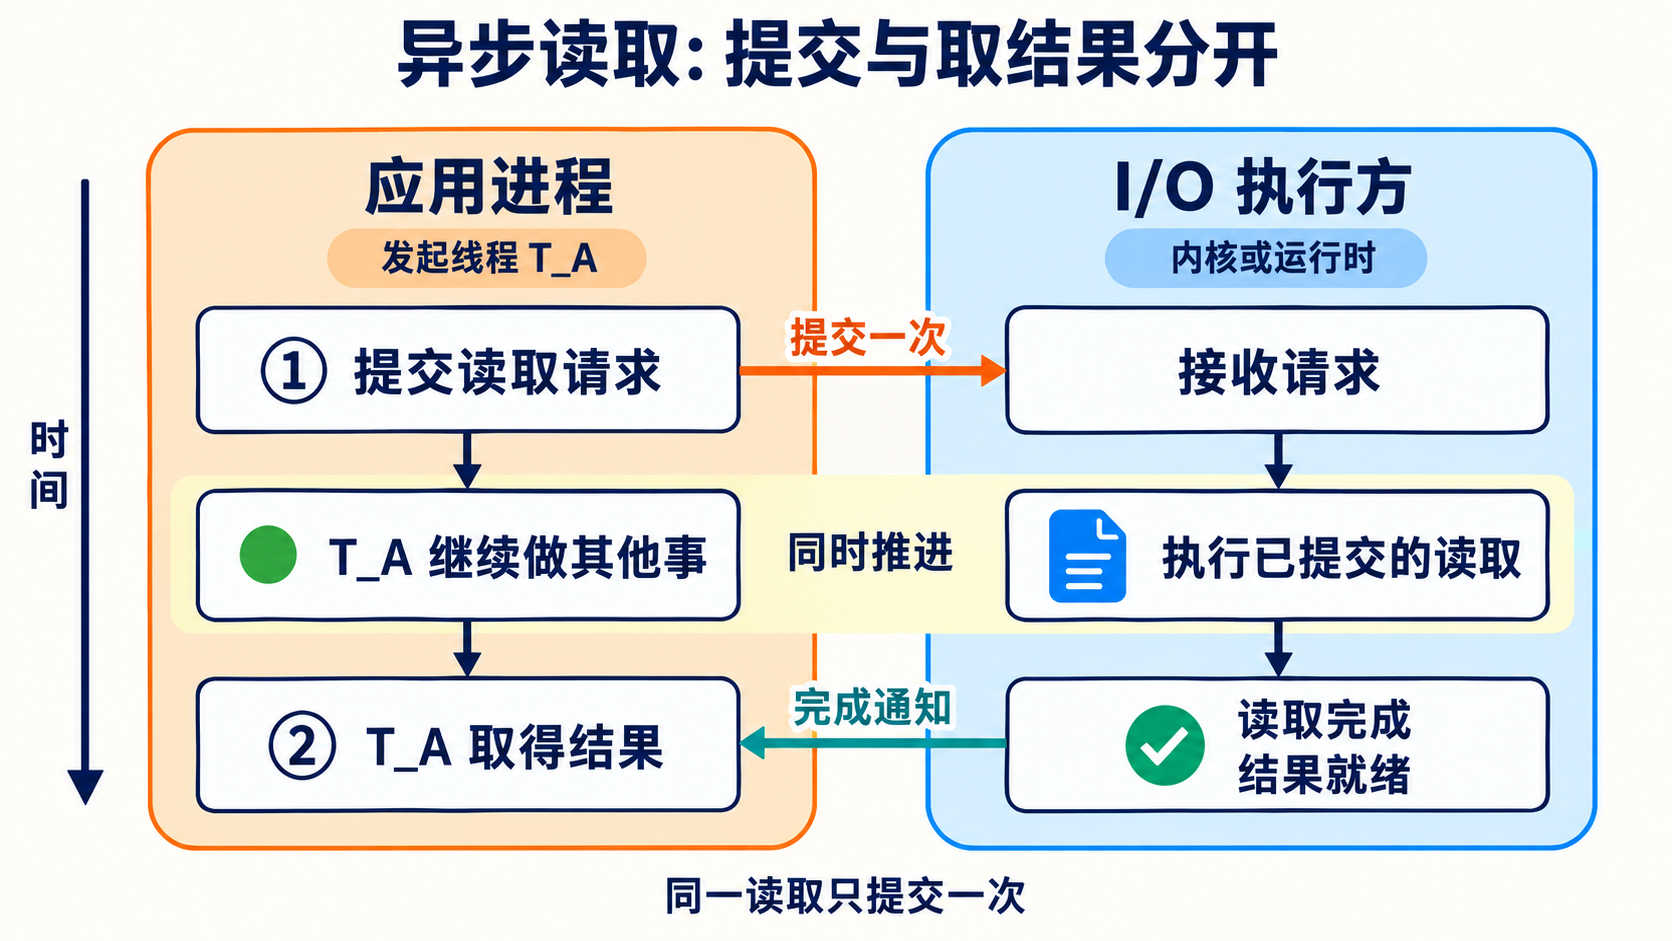
以 Linux 的 io_uring 为例:程序提交“从连接 B 读取数据,放进这块缓冲区”的请求。提交成功只表示系统接收了请求,不表示已经读到数据。 等读取完成,系统把实际读到的字节放进指定缓冲区,并在完成队列中记录结果。程序从完成队列取出结果,查看读到了多少字节或遇到什么错误;如果读取成功,就可以处理缓冲区中的数据,不需要再调用 recv 取同一份数据。
沿同一个时间线看得更清楚:假设程序在 9:59 开始处理连接 B,数据到 10:00 才到达。
- 阻塞的同步读取:9:59 调用
recv,它等待;10:00 数据到达,recv读入数据并返回结果。 - 非阻塞的同步读取:9:59 调用
recv,收到“暂时没有数据”的错误码;数据到达后,程序再次调用recv,才能取得数据。 - 异步读取:9:59 提交读取请求;数据到达后,系统完成已提交的操作,程序通过完成队列取得结果。
所以,判断同步还是异步,看程序取得数据时是否还要发起读取调用,还是此前提交的读取已经完成、现在只需领取完成结果。判断阻塞还是非阻塞,则看暂时没有数据时,调用线程会等待还是先返回。这两个问题需要分开看。Linux recv(2) 手册、io_uring(7) 手册
下面举一个现实中的例子,帮助大家理解
假设你在餐厅点了一份餐,但厨房还没有做好。餐厅可以用几种方式处理:
- 站在取餐窗口等,拿到餐才离开:像阻塞的同步读取。你在这次“取餐”过程中一直等,直到取得结果。(阻塞同步)
- 窗口说“还没好”,你先去做别的事,过会儿再来取:像非阻塞的同步读取。第一次尝试很快结束,但餐厅不会因为你来问过,就自动把餐交到你手里;你还要再次到窗口取。(非阻塞同步)
- 电子屏提示“可以取餐了”,你再去窗口取:像
epoll的就绪通知。提示只说明现在值得去尝试,餐还没有因为这条提示自动到你手里。(会在后面的题目中讲到) - 点餐时留下桌号,餐厅把餐送到桌上,再通知“已送达”:像异步读取。你先提出请求,之后收到的是这项交付已经完成的结果,不必再到窗口发起同一次取餐。(异步读取)
这个例子有个关键点:坐在座位上等,不会把“自己去取餐”变成“送餐到桌”。同样,程序是否等待,和读取由谁完成、得到的是“可读”还是“已完成”的通知,是不同问题。类比也有边界:真实的 recv 是操作系统按接口规则把字节放入程序缓冲区,不是应用线程亲手搬运网络数据;“自己取餐”只对应程序还需要主动调用读取接口。
为什么 epoll 不等于异步读取?
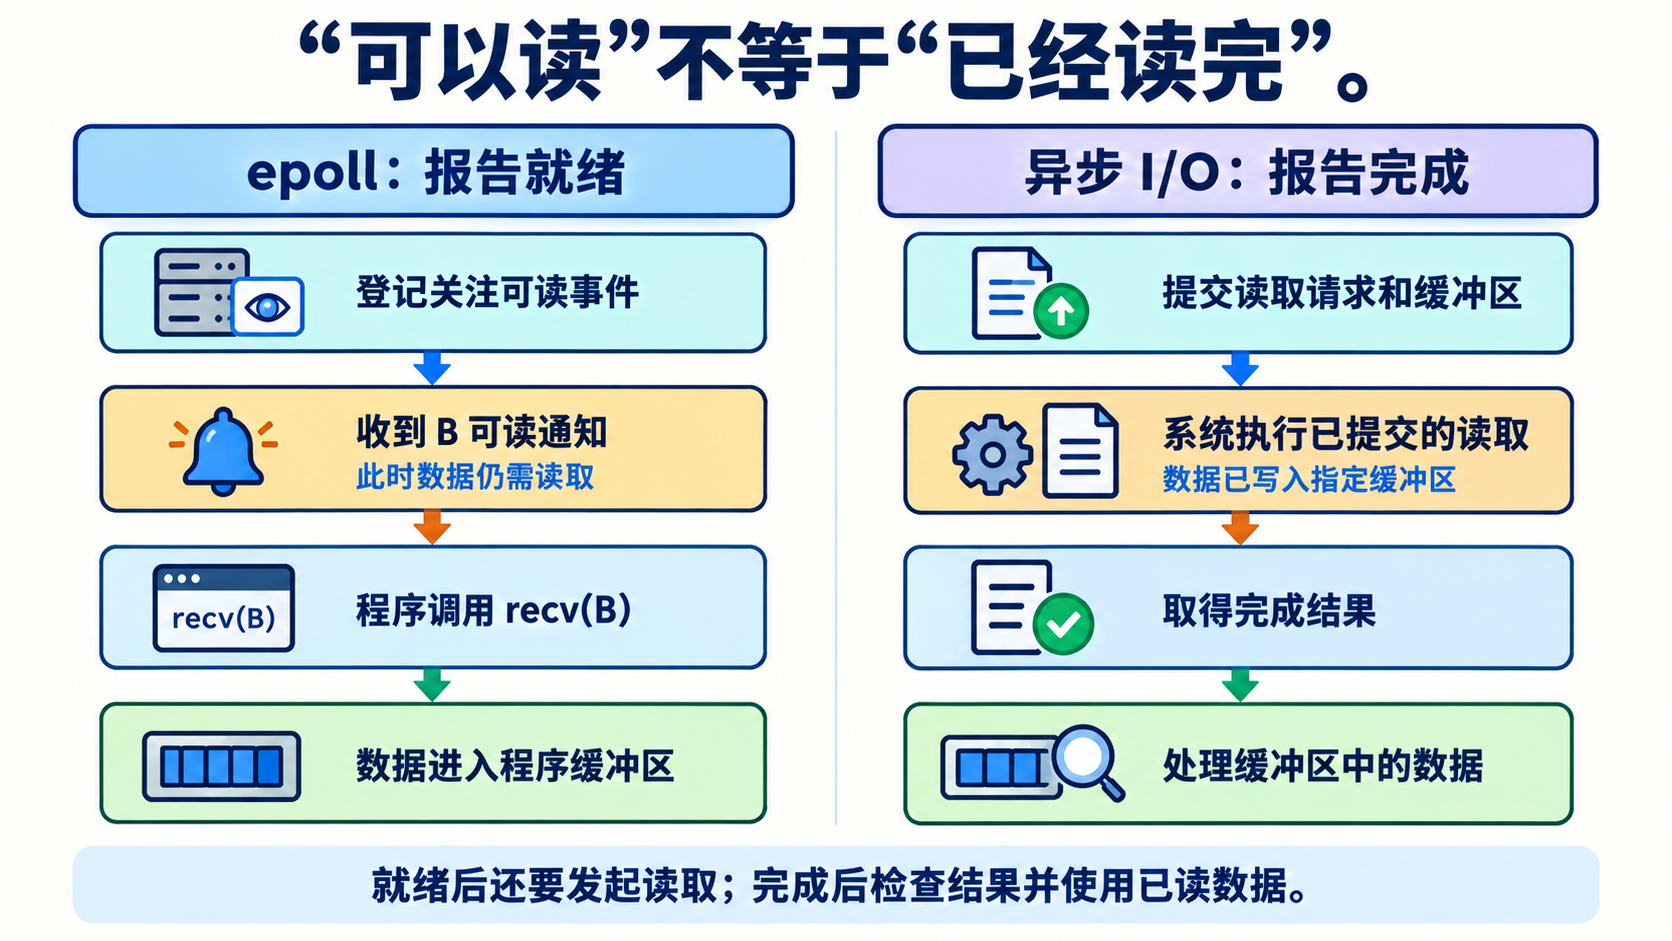
对应餐厅电子屏,epoll 可以告诉程序“这个连接现在可能可读”,这叫就绪通知。程序收到通知后,通常仍要自己调用 recv 把数据取出来。它没有替程序完成那次读取,所以“epoll 等待可读,再调用 recv”通常仍归入同步 I/O。相对地,异步读取关注的是已提交操作的完成通知。而且,epoll_wait 本身也可以等待事件;Socket 的非阻塞属性与事件等待调用是否等待,是两回事。Linux epoll(7) 手册
还有两个容易混淆的边界:TCP 是字节流,一次 recv 成功返回不保证填满申请的缓冲区;异步接口也不保证程序永远不等待——程序如果需要结果,可以主动等待完成。这里的四个术语描述的是 I/O 接口的行为,不能只凭代码中出现 async、回调或事件循环,就断定底层一定使用了内核异步 I/O。
面试总结
阻塞与非阻塞,区分的是暂时没有数据时,这次读取调用会等待还是先返回;同步与异步,区分的是程序通过读取调用取得结果,还是先提交操作、之后取得完成结果。非阻塞 recv 仍是同步 I/O;epoll 给出的是就绪通知,通常还需程序调用 recv。四个词不能简单记成“阻塞等于同步、非阻塞等于异步”。
3. Linux 中常见的 I/O 模型有哪些?
先理解 I/O 是什么。I/O 是 Input/Output 的缩写,也就是输入/输出。 从程序的角度看,把数据读进来属于输入,例如读取文件内容、接收网络消息;把数据写出去属于输出,例如保存文件、向其他程序发送网络消息。这里的输入、输出不只是键盘输入和屏幕显示,也包括程序与文件、网络等之间的数据交换。
服务器要读取客户端发来的消息,却不知道消息什么时候到。它可以一直等、隔一会儿试一次、同时关注许多连接,也可以让系统在数据到来或读取完成时通知自己。
经典 Unix 网络编程把这些处理方式概括为五种 I/O 模型:阻塞 I/O、非阻塞 I/O、I/O 多路复用、信号驱动 I/O 和异步 I/O。这套分类也适合用来理解 Linux 网络 I/O;下面以 Linux 读取 TCP Socket 为例,epoll、SIGIO 和 io_uring 都按 Linux 接口说明,不代表所有 Unix 系统都有相同接口。
先分清“可以读”和“已经读完”
一次普通的 Socket 读取,可以先理解为两个阶段:
- 等数据到来:客户端发来的字节到达服务器,进入内核管理的 Socket 接收缓冲区。此时连接可能变得“可读”,但程序还没有取得这些字节。
- 把数据交给程序:程序调用
recv,内核把可取得的字节放进程序提供的缓冲区,调用返回读取的字节数;连接关闭或发生错误时则有相应结果。
这有点像餐厅:餐做好了,相当于数据可读(第一个阶段);餐交到你手里,才相当于这次读取完成(第二个阶段)。
下面五种模型的主要区别,就是怎么等第一步,以及谁发起第二步。类比只用于区分“就绪”和“完成”,真实程序并不是亲手搬运 Socket 中的字节。
面对相同的读取需求,五种模型分别怎么做?
假设服务器需要读取客户端数据,但数据暂时还没有到达。
下面分别比较五种可选处理方式,不是说一条消息要依次经过五种模型。
1. 阻塞 I/O:停在读取调用上等。 假设服务器要读取一个客户端发来的消息,但客户端还没有发送。服务器线程调用 recv 后,会停在这个调用里等待;数据到达后,内核把字节放入程序提供的缓冲区,recv 才返回读取结果。好比你站在取餐窗口,餐还没做好就在那里等,拿到餐才离开。
这里“阻塞”的是调用读取的线程,不是 CPU:线程等待期间不需要反复检查数据是否到了,操作系统可以安排别的线程运行。至于服务器有很多连接时该怎样安排线程,是另一个设计问题;阻塞 I/O 本身并不要求每个连接都配一个线程。
2. 非阻塞 I/O:暂时读不到就立即返回。 仍看刚才那个客户端连接:如果 Socket 被设为非阻塞,服务器线程调用 recv 时还没有数据,recv 不会让这个线程停在调用里等待,而是返回 -1,并把错误码设为 EAGAIN 或 EWOULDBLOCK,表示“目前没有数据可读”。
调用 recv 的还是同一个线程。 它现在可以继续执行后面的代码,例如处理手头已有的其他工作;以后要取得新到的数据,还得再次调用 recv。好比你去取餐,窗口说“还没好”,你可以先离开,但餐做好后仍需再来取。如果线程什么也不做,只是在循环中不停调用 recv 问“好了没有”,就可能白白占用 CPU。Linux recv(2) 手册
3. I/O 多路复用:一个等待入口关注多个连接。 现在把场景扩大:服务器同时与甲、乙、丙三个客户端保持连接,只有乙发来数据。如果一个线程先对甲调用阻塞的 recv,它会一直等甲,无法及时处理乙。Linux 的 epoll 可以让这个线程先一起等待三个连接中谁可读:
- 服务器把三个 Socket 注册为关注对象,然后由一个线程调用
epoll_wait等待事件。三个连接都没数据时,这个线程可以休眠。 - 乙发来数据,内核把乙对应的 Socket 标记为可能可读,
epoll_wait返回它的就绪事件;甲、丙暂时没有就绪事件。 - 服务器对乙的 Socket 调用
recv,把当时可取得的字节读进程序缓冲区,再处理这些字节。之后继续等待,若甲后来可读,再处理甲。
好比一个人同时等三份餐,不用挨个窗口站着:他看取餐屏,乙的号码亮了才去乙的窗口取。屏幕只提醒哪份餐可能可以取,没有把餐交到手里;同理,epoll_wait 返回后还需要调用 recv。select、poll 也能等待多个连接,但管理方式不同。epoll_wait 自身可能阻塞,所以“多路复用”不是“线程从不等待”。Linux epoll(7) 手册
4. 信号驱动 I/O:数据可读时,系统主动发来提醒。 再回到读取一个客户端消息的场景。服务器可以为这个 Socket 配置 Linux 的 SIGIO 通知:
- 客户端还没发送数据时,服务器不必停在
recv或epoll_wait上,可以先处理别的工作。 - 数据到达后,内核发现这个 Socket 可能可读,向程序发送
SIGIO信号。程序收到提醒后,记录这个连接需要检查。 - 程序在合适的位置对该 Socket 调用
recv,此时才把数据读进自己的缓冲区。
这像你没有守着取餐屏,餐厅主动打电话说“餐可以来取了”;电话不是送餐,你仍要去窗口取。它与多路复用都提供就绪提醒,差别在于这里通过信号主动通知,而不是线程调用等待接口领取就绪事件。信号处理逻辑应保持简短;普通信号也不能当成“每条消息必有一次独立通知”的可靠消息队列。Linux open(2) 手册中的 O_ASYNC、信号处理安全说明
5. 异步 I/O:提交读取任务,之后领取完成结果。 对一个暂时没有数据的客户端连接,Linux 的 io_uring 可以这样工作:
- 客户端尚无数据时,服务器先提交一个“从这个连接接收数据,放进指定的程序缓冲区”的请求,然后继续处理其他工作。读取请求此时已经提交,不必等到可读时才由程序发起读取。
- 数据到达后,系统执行已提交的接收操作,把取得的字节放进指定缓冲区,并在完成队列中放入该操作的结果。
- 服务器取到完成结果,检查读到了多少字节或发生了什么错误,再处理缓冲区里的数据;不需要为这一项已完成的请求再调用一次
recv。
这像点餐时留下桌号,餐厅把餐送到桌上,再通知你“已送达”。就绪通知相当于“可以去取”,这里通知的是“送餐已经完成”。程序给异步读取使用的缓冲区必须在操作完成前保持有效;程序需要结果时也可以主动等待完成。io_uring 是 Linux 特有接口,不是所有 Unix 系统共有的 API。Linux io_uring(7) 手册、io_uring_prep_recv(3) 手册

最容易混淆的地方
在本题以 Linux Socket 读取为例的经典五种模型中,前四种属于同步 I/O。阻塞和非阻塞 I/O 都由线程调用 recv,只是暂时没有数据时,一个等待,一个先返回;多路复用先通过等待接口得知哪个连接可读,信号驱动先收到可读提醒,随后仍需调用 recv 取得数据。区别主要是怎样等到数据可读,而不是“有没有等待”或“有没有收到通知”。recv(2) 手册、epoll(7) 手册、O_ASYNC 说明
第五种异步 I/O 则是先提交读取请求,之后取得这项读取已经完成的结果;读取成功时,数据已进入指定缓冲区,不必为同一项请求再调用 recv。尤其不要只凭“收到了信号”判断同步或异步:信号既可以提醒 Socket 现在可读,也可以用于通知一项异步 I/O 已经完成。要看通知对应的是就绪,还是完成。io_uring(7) 手册、POSIX AIO 概览
面试总结
从 Linux Socket 编程看,常见的五种 I/O 模型是:阻塞 I/O 调用后等待结果;非阻塞 I/O 暂时无数据就返回,程序以后重试;多路复用先等多个连接的就绪事件,再读取;信号驱动在可读时用信号提醒,程序仍需读取;异步 I/O 则先提交读取,之后取得完成结果。关键是区分“数据已经可读”和“读取已经完成”:前四种通常仍由程序发起实际读取,不能把 epoll 或 SIGIO 的就绪通知误认为异步 I/O 完成。
4. 什么是 I/O 多路复用?
对于聊天服务器,接收用户发来的消息是输入,把回复发送给用户是输出。因此,服务器同时与许多用户聊天,就需要处理多个连接上的 I/O。下面先以“接收消息”为例,看看为什么需要 I/O 多路复用。
假设聊天服务器和用户 A、B、C 建立了连接,只有一个线程负责接收他们的消息。A 一直没有发送,B 却已经发来内容。如果线程先停在“等待 A 的消息”这一步,B 的数据即使已经到达,也只能暂存在操作系统管理的接收缓冲区里,迟迟得不到这个线程的处理。
我们真正希望的是:A、B、C 中只要有人发来数据,线程就能得知,并去读取那个连接。 I/O 多路复用提供的就是这种能力:程序一次关注多个连接,操作系统帮助它等待,并返回哪些连接已经具备读写条件。于是,同一个线程可以先处理 B,再处理后来有数据的 A 或 C,不必一直等某个指定用户。
这里的“多路”就是 A、B、C 这些连接;在这个例子中,“复用”体现为它们共同使用一个线程来等待和处理 I/O。更准确地说,I/O 多路复用是一种同时等待多个 I/O 对象就绪的机制,它使一个线程管理多个连接成为可能。select、poll 和 Linux 的 epoll 都提供这类能力。Linux select(2) 手册
生活中,一名客服也可以同时负责三个聊天会话。A 还在输入时,客服不必一直守着 A;聊天系统提示 B 有新消息,客服就打开 B 阅读并回复,之后再处理 C。三个顾客共用一名客服的服务时间。回到服务器,客服对应处理连接的线程,聊天系统的新消息提示对应操作系统提供的就绪信息。类比到这里为止,下面看程序实际怎样完成这个过程。
在 Linux 中,服务器进程通过 Socket 与 A、B、C 收发数据。进程用文件描述符(fd)引用这些 Socket;fd 是一个整数编号。前面负责接收消息的线程可以使用相应的 fd,在登记关注对象时明确指出要等哪几个连接。也就是说,进程持有这些连接和 fd,线程执行登记与等待操作;fd 不是这个线程独有的连接编号。socket(2) 手册、epoll_ctl(2) 手册
以 Linux 的 epoll 为例,先假设 A、B、C 已经连接到服务器,它们的 Socket 都设为非阻塞,暂时都没有数据。下面从创建到关闭,走完一个 epoll 实例的工作过程:
- 创建实例:
epoll_create1。 线程调用epoll_create1(0),内核创建一个用于管理关注对象和就绪事件的epoll实例,并返回它的文件描述符,记作epfd。较早的epoll_create也能创建实例;这里使用不需要填写旧版size参数的epoll_create1。 - 登记连接:
epoll_ctl。 线程对 A、B、C 的 fd 分别调用epoll_ctl(epfd, EPOLL_CTL_ADD, ...),将它们加入这个实例的关注集合,并指定EPOLLIN,表示关心可读事件。登记时还可以保存对应的 fd,供返回事件时识别是哪条连接。注册一次后,不必在每次等待前重复注册。 - 等待事件:
epoll_wait。 线程调用epoll_wait(epfd, ...),一次等待已登记连接中的就绪事件。若暂时都没有事件,线程可以休眠,CPU 去执行其他任务。调用返回时,它得到本次返回的事件数量和事件信息;一次可能返回多个事件。等待也可能因超时或信号中断而结束,不能把每次返回都理解为“有数据可读”。 - 找到 B,但尚未读到 B 的数据。 B 发来消息后,它的 Socket 可能变为可读。内核记录就绪状态,
epoll_wait返回相应事件;线程查看事件信息,认出需要处理的是 B。此时epoll只告诉线程“可以尝试读取 B”,没有代替它把消息取出。 - 实际读取:
recv。 线程对 B 的 Socket 调用recv,内核才把可取得的字节放入线程指定的缓冲区。返回正数表示取得的字节数;对这里的 TCP 连接,返回 0 表示对端已正常关闭发送方向;非阻塞读取若暂时无数据,则可能返回-1并给出EAGAIN或EWOULDBLOCK。一次成功读取也不保证刚好是一条完整聊天消息。 - 继续等待或调整关注项。 B 的连接仍在关注集合中,线程处理完已取得的数据后,可以再次调用
epoll_wait,以后 A、C 或 B 就绪都可能被报告。若服务器还需要关注某条连接是否可写,可以用epoll_ctl的EPOLL_CTL_MOD调整事件;不需要再关注可写时再改回去。本例采用默认的水平触发,边缘触发的读取规则留到后面的 LT/ET 题目说明。 - 连接结束时清理。 某条连接不再使用时,线程可用
epoll_ctl的EPOLL_CTL_DEL将其移出关注集合,再关闭该连接的 fd。服务器停止使用整个epoll实例时,还要关闭epfd,让内核释放相关资源。真实服务器也可以把负责接入新连接的监听 Socket 登记到epoll;它就绪时先接入新连接,再登记新连接的 fd。
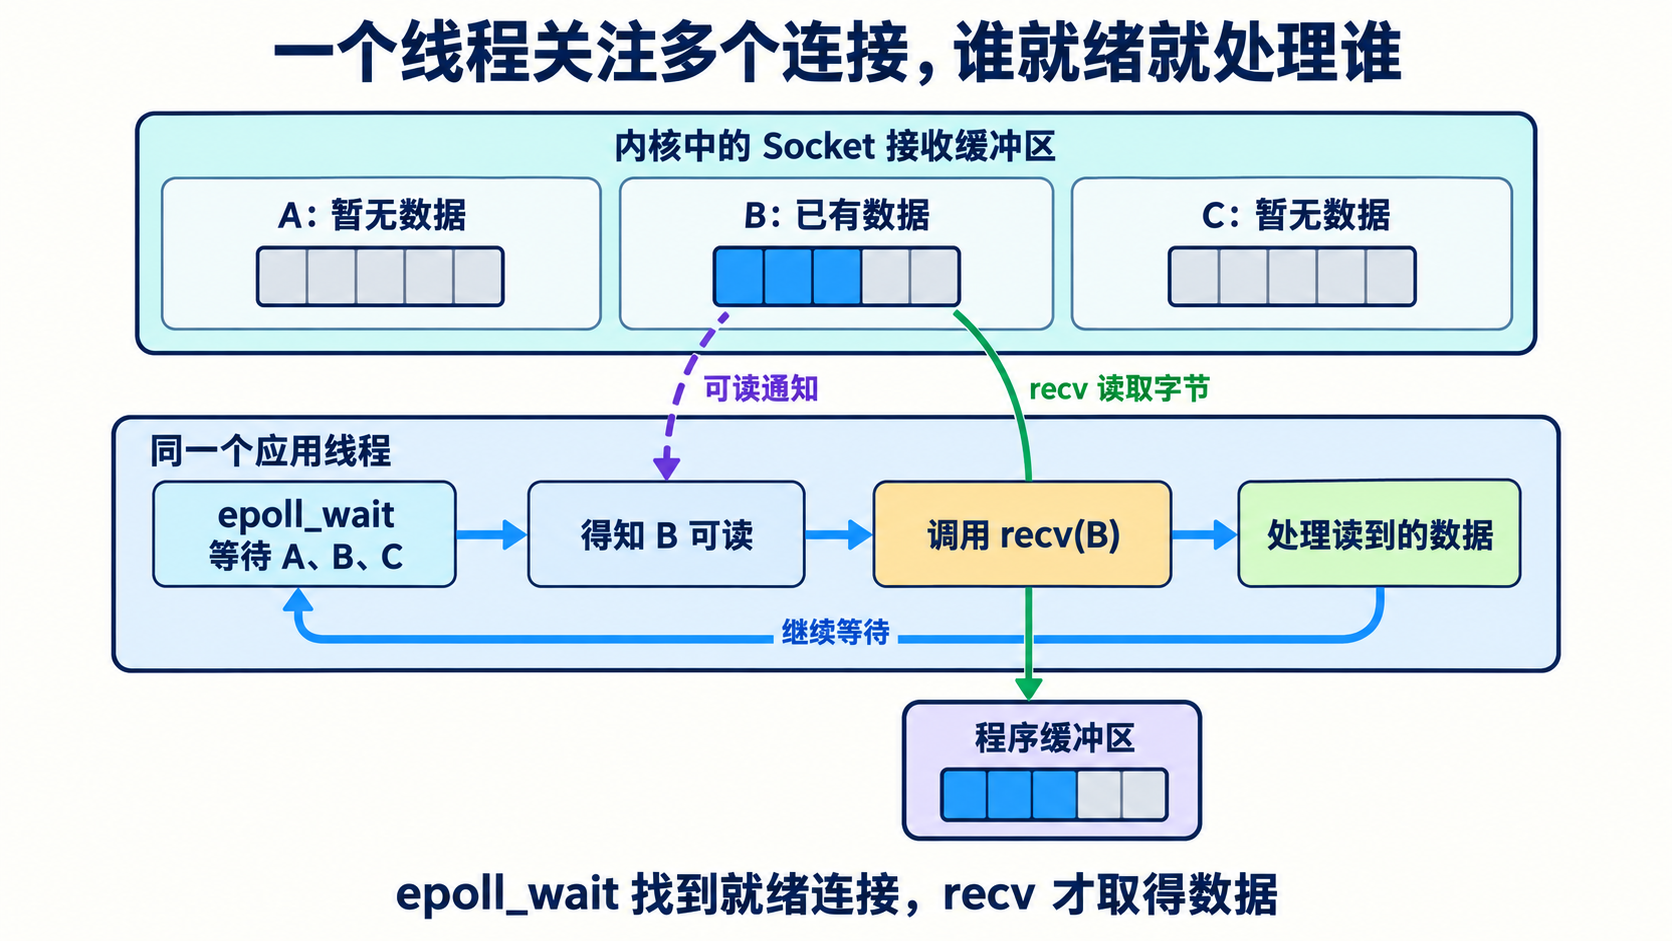
把主线连起来就是:epoll_create1 创建实例 → epoll_ctl 登记关注对象 → epoll_wait 等待并取得就绪事件 → recv 真正读取 → 按需调整或移除关注对象 → 关闭文件描述符。epoll 负责告诉线程哪些连接值得处理,不负责替它读取业务数据。
现在再看它的价值:如果有一万个连接,其中大部分用户都没有发送消息,服务器不必为每个用户安排一个专门等待的线程,也不必在应用代码里不停对所有连接尝试读取。它可以用少量线程一起等待这些连接,再处理就绪的那部分。连接仍然占用内存等资源,省下的主要是为每个连接单独等待所需的线程资源,以及反复尝试无数据读取的开销。
本例把 Socket 设为非阻塞,是为了避免线程处理一个就绪连接时,又停在该连接的读取调用里,耽误其他连接。处理一条消息也不应长时间占住这个线程,否则其他连接仍要排队。多路复用改善的是多个连接的等待与处理安排;本例中的单个线程仍然依次执行各项工作。
面试总结
I/O 多路复用是一种同时等待多个 I/O 对象就绪的机制。以 Linux epoll 为例,先用 epoll_create1 创建实例,再用 epoll_ctl 登记要关注的连接;线程调用 epoll_wait 得知哪些连接就绪后,仍需调用 recv 实际读取。连接结束时移除并关闭,实例不再使用时也要关闭。这样一个或少量线程就能管理许多经常等待数据的连接;epoll 报告的是就绪,不是读取已经完成。
5. select、poll 和 epoll 的原理与区别是什么?
假设你在编写一个聊天服务器。用户 A、B、C 都连接着服务器,但他们并不会同时发消息:A 可能一直在输入,B 已经发来一句话,C 暂时没有动静。
服务器只有一个线程负责接收这些连接的数据。如果它先调用阻塞式读取去等 A,就可能一直停在那里,无法及时处理 B。我们需要一种办法:先一起等待 A、B、C,得知哪个连接可以读取后,再去读取那个连接。
在 Linux 网络编程中,select 和 poll 是用于 I/O 多路复用的两个调用;epoll 则是由 epoll_create1、epoll_ctl 和 epoll_wait 等调用组成的一套 Linux 接口。三者都能帮助程序等待多个连接的读写就绪事件,使一个线程能够照看多个连接。理解它们,先看清“程序交给内核什么,内核返回什么”,差异就容易理解了。
常有人接着问:它们都能解决 C10K 吗?C10K 指一台服务器同时维持约一万个客户端连接,不是同时用一万个 CPU 执行请求。能否维持这些连接,和在其中少数连接活跃时能否高效找出它们,是两个问题。我们先把三个接口各走一遍,最后再回答。
先认识它们共同处理的对象
Socket、文件描述符和接收缓冲区分别是什么?
网络连接建立后,程序通过 Socket 收发数据。可以把 Socket 理解为操作系统提供的网络通信对象:它保存连接相关的状态,操作系统还会为它管理收发数据所需的缓冲空间。
程序怎样指出自己要操作哪个 Socket?通过一个整数编号,这就是文件描述符,简称 fd。比如:
| 用户连接 | 在这个服务器进程中的 FD |
|---|---|
| A | 4 |
| B | 7 |
| C | 9 |
程序读取 FD 7,就是请求从 B 对应的 Socket 读取。4、7、9 不是端口号,也不是用户 ID,只是本例中进程用来访问这些对象的编号。
B 的数据从网络到达后,通常先进入内核管理的接收缓冲区。这个缓冲区可以理解为“已经收到、等待应用取走的数据暂存处”。程序随后调用 recv,才能把可读取的字节放进自己的内存,进而解析聊天内容。
所以,“网络数据已经到达”和“应用已经读到数据”是两个不同阶段。
“B 可读”到底表示什么?
在本例中,B 发来的字节已进入内核的接收缓冲区。此时线程对 B 调用 recv,通常不用再等 B 发送新数据,就能取得已到达的字节。多路复用接口把这种状态报告为读就绪;说“B 可读”,指的也是这件事。本题后文提到“就绪”,除非特别说明,都指读就绪。Linux select(2) 手册
读就绪不等于已经读到数据。 等待接口只是告诉线程“现在可以尝试读取 B”,线程还要调用 recv。连接关闭时也可能报告读就绪,此时 recv 可返回 0,表示读到了数据流的末尾。
因此,“B 可读”不保证有一条新消息,更不保证一次读取恰好得到完整的聊天消息:TCP 提供字节流,一句话可能分几次收到,多句话也可能一起读到。
下面比较接口时,先限定连接未关闭、没有其他线程同时读取 B,只看“B 已有数据”这条路径。真实程序还需检查 recv 的返回值,并常将 Socket 设为非阻塞,以应对就绪后状态变化或读取出错的情况。
有了这些概念,程序要表达的需求就很具体了:
请帮我关注 fd 4、7、9;只要其中有连接可以读取,就告诉我具体是哪些。
一、select:用一组标记表达“关注谁”,再用这组标记返回“谁就绪”
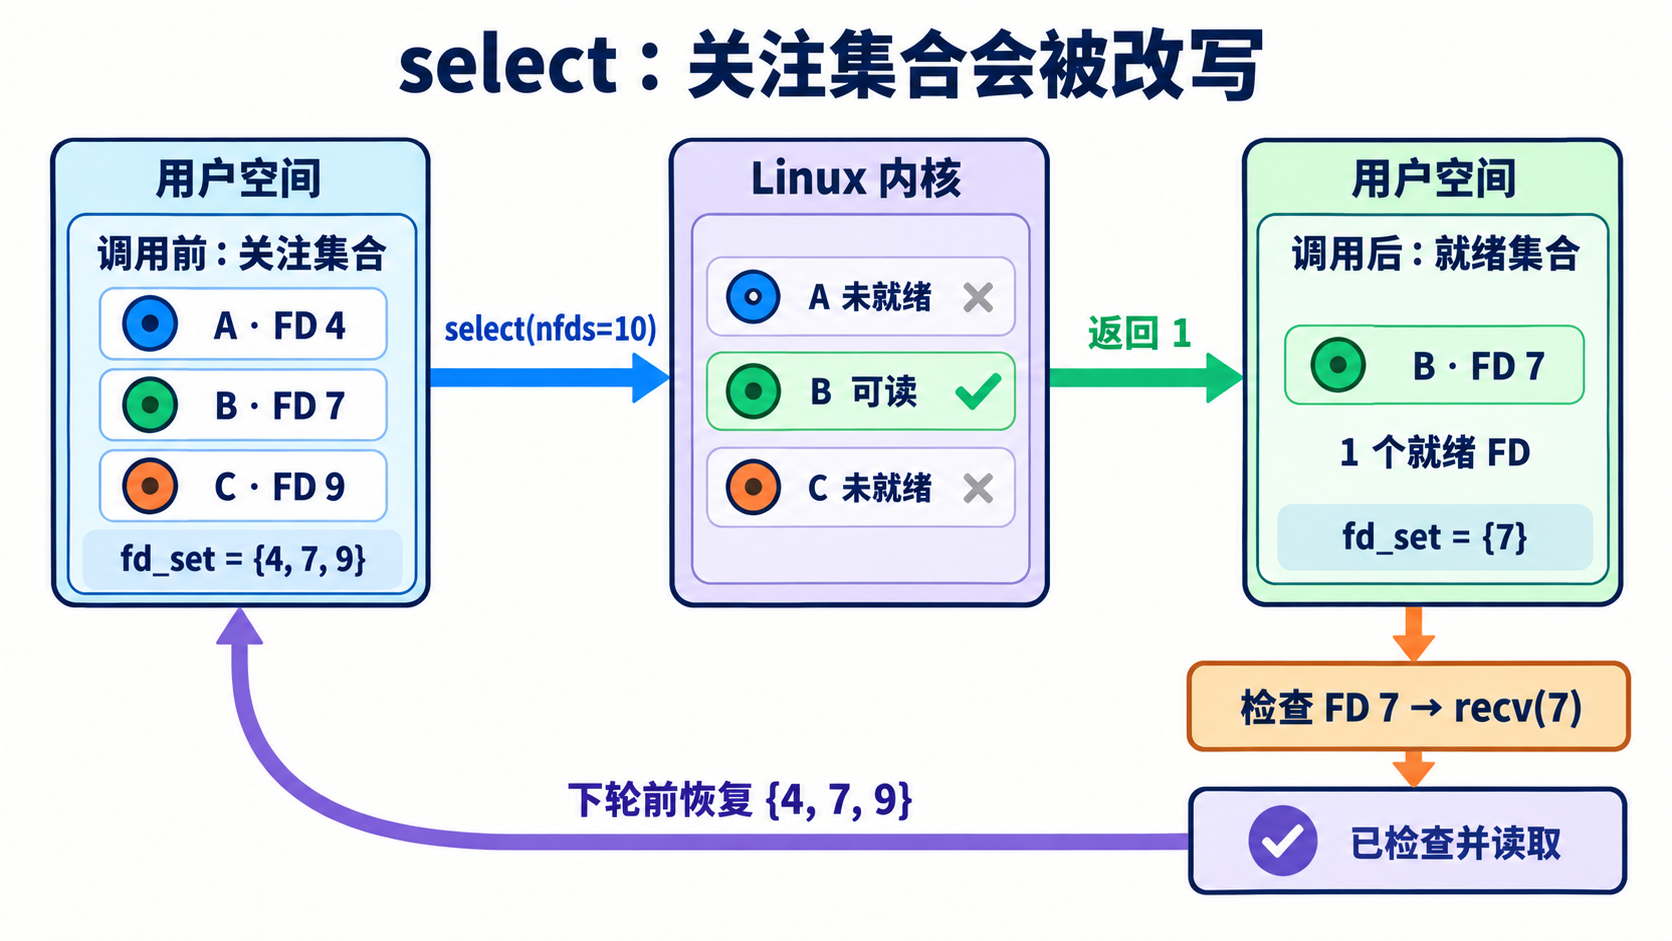
select 是一个等待函数。程序把要关注的 FD 集合和等待时限交给它;函数返回后,程序检查集合,找出可以处理的连接。
这里的“集合”先理解成一份名单即可。生活中,客服可以把负责的顾客编号交给前台,请前台等到有人留言后,在返回名单里标出谁留了言;客服再按标记打开对应会话。程序中的这份名单叫 fd_set。
1. 程序怎样表达关注 A、B、C?
Linux 常见的 fd_set 用一组二进制位表示名单。每个位置对应一个 FD:置为 1 表示选中,置为 0 表示没有选中。这种结构叫位集合,因为每个位置只需要表达“是或否”。
下面只展示 FD 0~9 的逻辑含义,不代表实际内存的字节排列:
FD 编号: 0 1 2 3 4 5 6 7 8 9
关注标记:0 0 0 0 1 0 0 1 0 1
                  A     B   C
调用前,4、7、9 位置上的 1 表示“我想关注这三个连接”,不表示它们已经有数据。
程序通常用 FD_ZERO 清空集合,再用 FD_SET 加入要关注的 FD,不需要自己计算每一位。除了读集合,select 还可以接收写集合和特殊异常条件集合;本文只传读集合,其他两类不关注。
它还有一个容易误解的参数 nfds,用于给出检查的编号范围:应设为所有关注 FD 中的最大值加 1。本例最大 FD 是 9,所以传 10,不是因为有三个连接就传 3。
2. 调用之后,线程在哪里等?
假设 A、B、C 最初都没有可读数据,而且程序允许等待。
进入内核后,系统检查被关注 Socket 的状态,并建立本次等待所需的通知关联。如果暂时没有就绪对象,调用线程可以休眠,把 CPU 留给其他任务。
稍后 B 的数据到达,相关通知使等待线程有机会被唤醒;内核再检查就绪情况,并准备返回结果。如果调用开始时 B 就已经可读,则不必先休眠再唤醒。
这里的“检查多个连接”不意味着线程在等待期间一直高速循环,也不是给 A、B、C 各创建一个线程。一次等待可以关联多个对象。Linux select/poll 等待实现
3. 返回值和返回集合各告诉程序什么?
假设返回时只有 B 可读,原来的读集合会变成:
FD 编号: 0 1 2 3 4 5 6 7 8 9
结果标记:0 0 0 0 0 0 0 1 0 0
                        B
这次,7 位置上的 1 表示“B 可读”。同一个集合,调用前用于表达关注对象,返回后用于表达就绪对象。
在本例只关注读事件的前提下,select 的返回值是 1,表示有一个就绪 FD;它不是说“FD 1 可读”。程序还要用 FD_ISSET 检查结果:
- FD 4 的标记为 0,先不读取 A。
- FD 7 的标记为 1,对 B 调用
recv。 - FD 9 的标记为 0,先不读取 C。
等待超时且没有事件时返回 0;调用失败时返回 -1,需要检查错误原因。
4. 处理完 B,怎样继续等待?
服务器仍要关注 A、B、C,而刚才的集合只保留了 B。因此,下次调用前要从原始名单恢复工作集合,或者重新构造它。否则,下次只把 B 交给 select,A、C 就不在那次等待的关注范围里了。
至此,一轮 select 的过程就闭合了:
准备关注集合 {4, 7, 9}
→ 调用 select 等待
→ 得到结果集合 {7}
→ 检查标记,读取 B
→ 恢复关注集合 {4, 7, 9}
→ 再次等待
从数据交付的角度再看一遍:在常见 Linux 调用路径中,应用把关注集合传给内核,内核取得这些标记并检查相应 FD,再把改写后的就绪集合交还应用;应用还要检查结果标记,找出具体连接。因此,每轮都有集合在用户空间与内核空间之间传递,也有对所关注范围的检查,成本会随规模增大,不是连接数增长时开销呈指数增长。
select 还受到集合表示方式的限制:Linux 常见的 glibc fd_set 受 FD_SETSIZE = 1024 限制,只能表示小于 1024 的有效 FD。即使只关注一个连接,只要它的 FD 是 1500,也不能安全放进这个集合。这是常见用户态接口的限制,不能说成 Linux 内核或所有平台的统一上限。Linux select(2) 手册
二、poll:把“按编号占位置”改成“每个连接占一行”
理解 select 后,可以自然追问:能不能不用固定大小的位集合,而是想关注几个连接,就在表里写几行?同时,把“我关心什么”和“这次发生什么”分开保存?
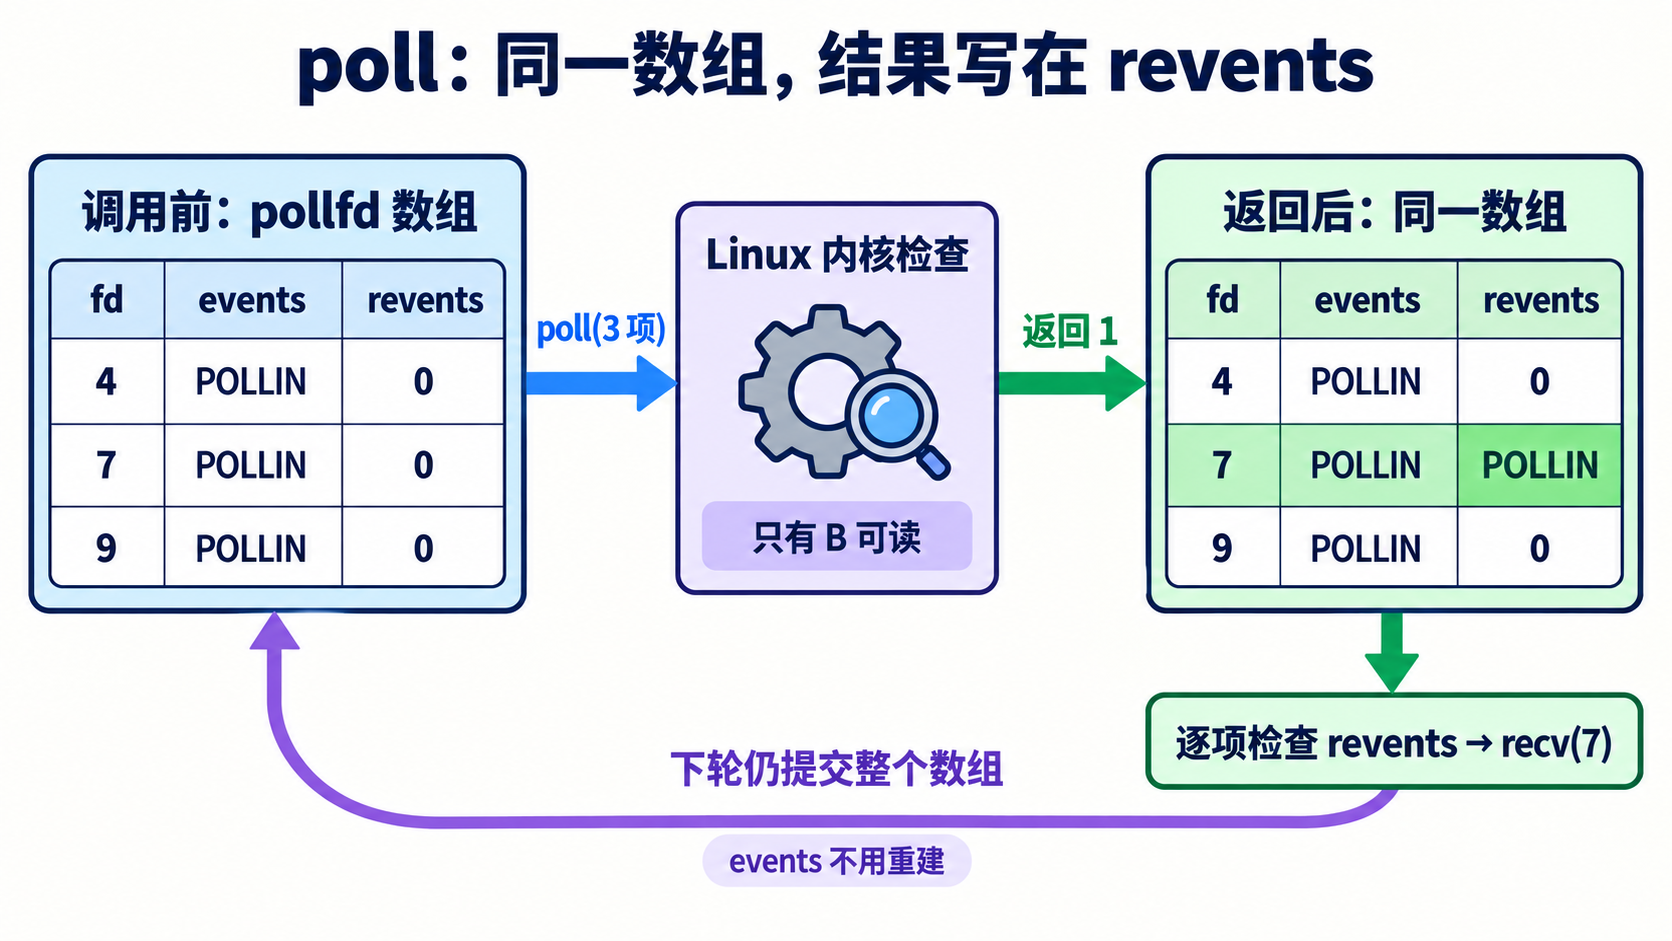
poll 就采用了这样的接口形式。它也是等待函数,但接收的不是 fd_set,而是一个 pollfd 数组。数组是一组按顺序排列的记录,每条记录保存一个关注对象的信息。
1. 数组中的三个字段分别做什么?
每条记录主要有三个字段:
fd:操作哪个对象,本例就是 4、7、9。events:程序希望关注什么。比如POLLIN表示关注可读条件。revents:内核返回的实际事件。0 表示这项本次没有返回事件。
调用前,可以把数组理解为:
| 数组下标 | fd:对象编号 | events:希望关注什么 | revents:本次结果 |
|---|---|---|---|
| 0 | 4 | POLLIN | 待内核填写 |
| 1 | 7 | POLLIN | 待内核填写 |
| 2 | 9 | POLLIN | 待内核填写 |
“数组下标”和“FD 编号”不要混淆:下标 1 只是表格的第二行,这一行保存的对象编号才是 FD 7。
因此,即使第三个连接的 FD 变成 1500,这张表仍可以只有三行,不必为了编号 1500 预留前面的所有位置。传给 poll 的数组项数在这里是 3,与 select 的“最大 FD 加 1”不同。
2. 从等待到读取,完整走一遍
程序将这三项交给 poll,并指定等待时限。内核按数组检查连接;如果都没有事件,线程可以休眠等待。B 的数据到达、调用返回后,表格变成:
| 数组下标 | fd | events | revents |
|---|---|---|---|
| 0 | 4 | POLLIN | 0 |
| 1 | 7 | POLLIN | POLLIN |
| 2 | 9 | POLLIN | 0 |
本例返回值为 1,表示一项记录的 revents 非零。它仍然没有直接用返回值告诉程序“FD 7 可读”,程序需要检查数组,找到第二行,再读取 FD 7。
与 select 不同,events 没有被就绪结果覆盖,关注 A、B、C 的信息还在。只要关注对象没有变化,下一轮可以继续把同一数组交给 poll,本轮的 revents 会由内核重新填写。Linux poll(2) 手册
3. poll 改进了什么,又留下了什么?
poll 用数组明确列出对象,避开了 fd_set 的固定编号表示限制;关注事件与返回事件分开,也让信息含义更清楚。
但这份数组仍保存在应用中。每次调用时,数组中的关注信息要从用户空间传给内核,内核检查各项状态,再把带有 revents 结果的数组交还应用;应用还要检查数组各项。继续使用同一个数组,并不意味着内核跨调用记住了长期关注关系。 poll 使用的是数组,不是链表;它摆脱的是 fd_set 的固定编号表示限制,并没有消除每轮传递和线性检查的成本。Linux poll(2) 手册
用客服名单类比,就是表格从“按编号打勾”变成“每人一行,有需求栏和结果栏”,但每一轮仍要交整张表,再查结果栏。连接很多时,即使只有一行有事件,也仍有整表传递和扫描的成本。这里的扫描是检查状态,不是逐个执行可能阻塞的 recv。Linux select/poll 实现
三、epoll:先长期登记关注关系,再单独领取就绪事件
现在服务器有一万个连接,其中大部分用户暂时不发消息。每次只有几个连接活跃,却反复提交一万项关注信息、再从返回结果里寻找少数事件,会产生大量重复工作。
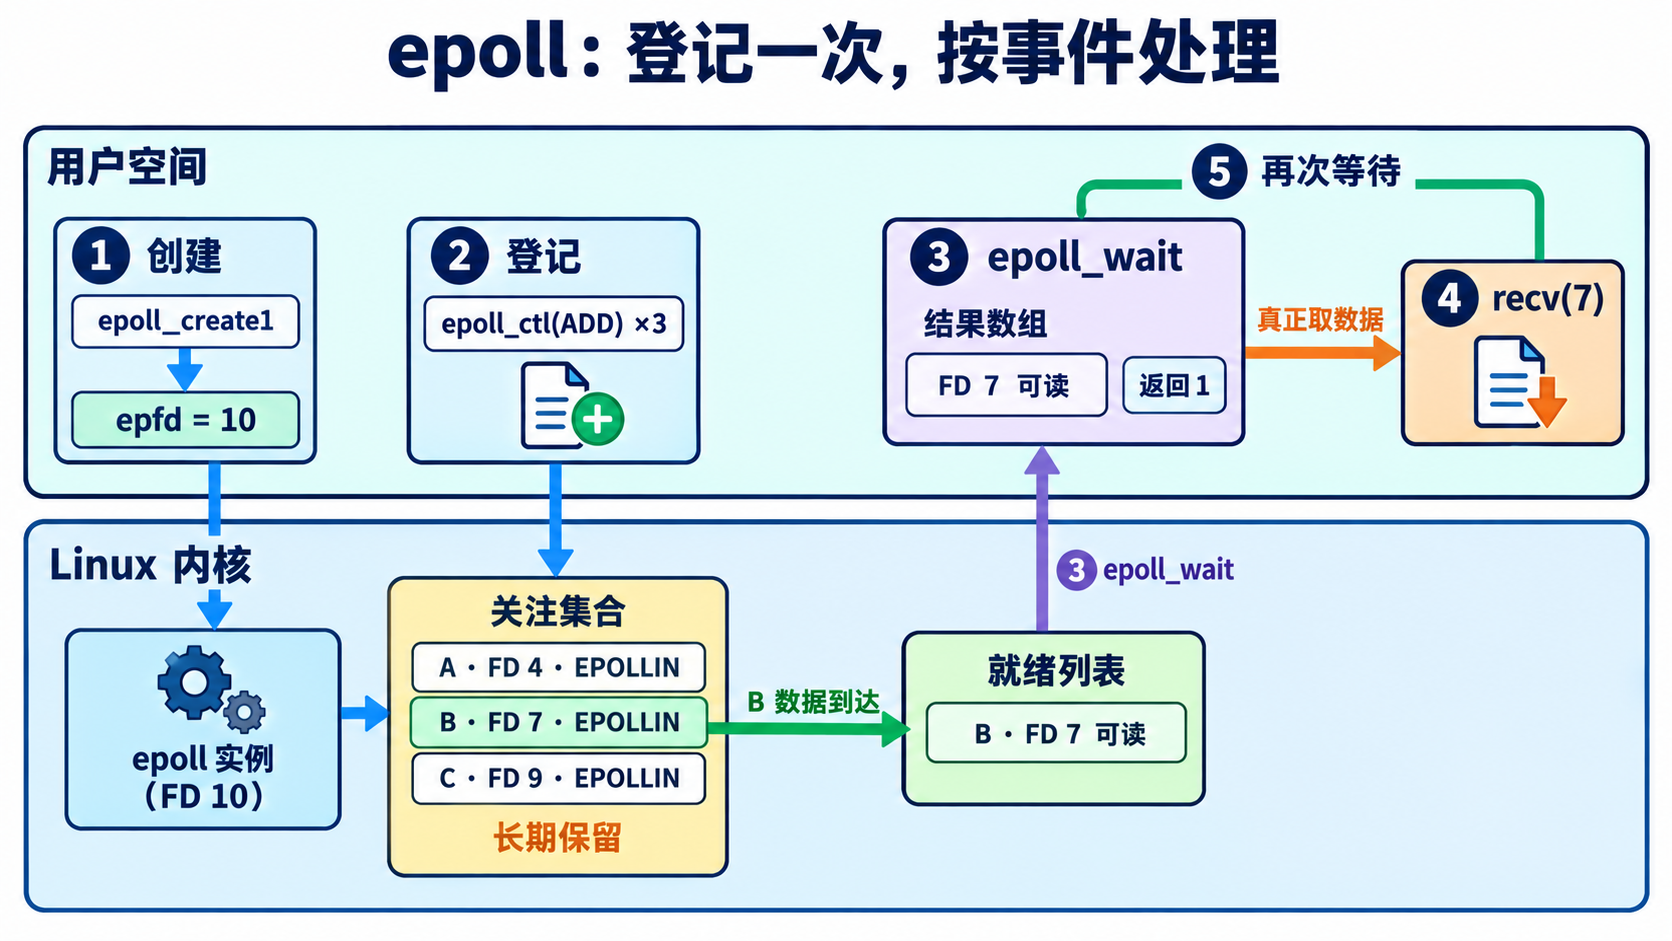
epoll 的设计思路是:关注哪些连接,由内核保存;哪些连接现在需要处理,另行记录。程序不必每轮等待都重新提交完整名单。
它是 Linux 提供的一组接口,不只是一个与 select 同样用法的函数。理解它,需要把“建立管理对象”“登记连接”“取得事件”分开。
1. epoll 实例是什么?为什么先要创建它?
先调用 epoll_create1。内核会创建一个 epoll 实例,程序得到访问它的 FD,通常命名为 epfd。
这个实例是用来管理事件的对象,不是另一条聊天连接。比如本例中:
- FD 4、7、9 分别指向 A、B、C 的 Socket。
- 假设返回的
epfd为 10,FD 10 指向管理这些 Socket 事件的 epoll 实例。
之后操作 FD 10,是在使用这份事件管理记录;读取 FD 7,才是在读取 B 的数据。Linux epoll_create(2) 手册
2. 怎样登记“我关心 B 是否可读”?
通过 epoll_ctl,程序指定管理实例、目标 FD 和关注事件。本例依次把 FD 4、7、9 加入 FD 10 对应的实例,并为它们登记 EPOLLIN,也就是可读事件。
这个接口有三类操作:
| 操作 | 含义 | 本例中的用途 |
|---|---|---|
| ADD | 新增关注对象 | 新用户 D 建立连接后,登记 D |
| MOD | 修改已有对象的关注设置 | 业务需要时调整读、写事件等设置 |
| DEL | 移除关注对象 | 不再由这个实例关注某连接 |
登记时还可以保存一份应用提供的标识,事件返回时会带回它。本例选择保存 Socket 的 FD,因此之后看到标识 7,就知道对应 B。实际程序也可以用它关联连接状态。
这些登记在等待调用之间保留,不会因为一次 epoll_wait 返回就消失。因此,正常读取 B 后,不需要仅仅为了下一轮继续等待而重新添加 B。这里采用默认报告方式,不启用一次性通知等特殊选项。Linux epoll_ctl(2) 手册
3. 关注集合与就绪列表为什么要分开?
从应用理解的角度,epoll 实例管理两类信息:
- 关注集合回答“程序关心哪些对象及哪些事件”。A、B、C 即使都没发消息,也在这里。
- 就绪列表记录需要进一步检查和报告的就绪对象。它服务于“这次有哪些事情可处理”。
假设起初三个连接都没数据,就绪列表为空。后来 B 的数据到达,Socket 的内核通知机制会通知相关的 epoll 处理逻辑,使 B 被记录到就绪列表中。内核交付事件时还会检查状态。
可以把这理解为:客服事先登记全部负责的会话,系统另外维护“当前有新情况的会话”列表。新消息发生在哪个会话,就更新那个会话的提醒,不必每次从整份客户名单重新寻找。
这里不需要 epoll 自己创建一个线程,全天反复扫描所有连接。它利用被关注对象已有的内核事件通知机制,维护就绪记录;所谓通知处理,也不是内核直接执行客服程序的业务代码。Linux epoll(7) 手册、Linux epoll 实现
如果想进一步知道“内核怎样保存这两类信息”,当前 Linux 实现会用红黑树组织已登记的关注对象,并用链表维护待交付的就绪对象。红黑树便于登记、查找和移除对象;Socket 状态变化时,相关通知使就绪对象进入待处理列表。这是 Linux 内核的实现细节,不是 epoll 接口对所有版本的数据结构承诺。 也不能由“登记使用红黑树”推断 epoll_wait 或整个程序具有固定的 O(1) 成本。Linux fs/eventpoll.c 源码
4. epoll_wait 究竟拿到什么?
程序调用 epoll_wait 时,主要提供:
- 要等待哪个 epoll 实例,也就是
epfd。 - 一块用于接收事件结果的数组。
- 数组最多能放多少个事件。
- 本次最多等多久。
注意:这个数组是接收结果用的,不是重新提交全部连接的关注名单。 A、B、C 的登记已经保存在实例里。
假设本次最多接收 10 个事件,返回时只有 B 可读,调用就返回 1,并在结果数组的第一个位置写入 B 的事件信息:
返回数量:1
有效结果:
  第 0 项:标识为 7,事件为可读
程序直接处理这一项,对 FD 7 调用 recv。不需要再检查 A、C 在整份关注名单里是否被标记。epoll_wait 并非只返回一个数字:数字表示本次写入了多少个有效事件,事件内容则放在程序提供的数组里。内核会把这些结果交付到用户空间,不是让应用与内核共享那条内部就绪链表。Linux epoll_wait(2) 手册
如果 A、C 也就绪,可以返回多个事件,程序遍历本次有效结果即可。数组容量是 10,不代表只能登记 10 个连接,只代表这次最多接收 10 个事件。就绪对象超过本次容量时,可以在后续调用中继续取得事件。Linux epoll_wait(2) 手册
5. 没有事件时,以及处理完事件后,会发生什么?
如果调用时没有可交付事件,且允许等待,线程可以在 epoll_wait 中休眠。B 后来变为可读,就可能唤醒等待线程。反过来,如果 B 在调用之前就已经就绪,程序也可以直接取得事件,不要求它一定在等待开始之后才发来数据。
处理完 B 后,程序再次调用 epoll_wait。关注集合仍然保留 A、B、C。若采用默认的水平触发方式(LT),B 还有未读数据时,后续调用还可以报告 B 可读;若暂时都没有事件,就继续等待。select、poll 每次查询当前就绪状态,效果类似 LT;epoll 还可选择 ET。ET 不能依赖未读完的数据反复带来通知,常与非阻塞 Socket 配合,持续读取直到返回 EAGAIN。具体过程留到下一题。Linux epoll(7) 手册
整个过程是:
创建 epoll 实例
→ 登记 A、B、C(关注关系保留)
→ epoll_wait 等待事件
→ 取得 B 可读的结果
→ recv 读取 B
→ 再次 epoll_wait
它与 poll 的关键区别,不是“一个需要等待、另一个不等待”,而是完整关注信息不必反复提交,返回结果也按本次事件组织。
四、连接很多时,这些差别为什么会影响性能?
先回答 C10K:在单个 select 调用中,常见的 glibc fd_set 无法表示编号达到 1024 的 FD,因此不能用“一次 select 等待一万个连接”作为普通 Linux 程序的方案。poll 和 epoll 没有这一固定表示限制,在提高进程 FD 上限、准备足够内存等条件下,都可以管理一万个连接。能管理不等于吞吐一定够用:如果大多数连接空闲,poll 每轮仍检查整个数组;epoll 无须每轮重新传入完整关注名单,通常更适合这种场景。若所有连接都活跃,应用照样要处理大量事件和业务。C10K 不是某个接口单独保证的性能指标。
现在再比较“关注 1000 个连接,本轮只有 3 个可读”的情况。为便于比较,假设所有 FD 都在 select 可表示的范围内。
select 和 poll 每轮都要传递关注信息,内核按相应范围或数组检查对象。应用随后还要检查返回集合或数组,找到那 3 个就绪连接。实际实现可以采用一些优化,但处理成本仍受到被检查范围或条目数量的影响。
epoll 已经保存了 1000 个连接的关注关系。本轮从就绪记录中取得事件后,应用主要遍历返回的那 3 项,不必重新提交 1000 个对象。这就是它在大量空闲连接场景中的主要收益。
但“就绪”仍只表示可以尝试读写,不等于读写已经完成;通知之后的状态也可能变化。Linux select(2) 手册还提醒:极少数情况下,Socket 被报告可读后,后续阻塞读取仍可能等待。事件循环通常把 Socket 设为非阻塞,遇到 EAGAIN 等状态就返回处理其他连接,避免一个连接把整个线程卡住。Linux select(2) 手册
不过,事件登记、通知处理、就绪检查和结果传递都需要成本。若 1000 个连接都很活跃,程序仍然要处理大量事件;若连接频繁增删,也要频繁维护关注关系。因此不能把 epoll 的全部操作统称为 O(1),更不能保证使用它就一定快于其他方案。
还要分清等待事件的成本与处理业务的成本:即使很快找到 B,如果处理 B 的请求需要计算五秒,单个处理线程在这五秒里仍可能无法服务其他连接。多路复用解决的是多个连接的等待和就绪发现,不会自动把业务处理变成并行计算。
五、用表格归纳,但不要只背表格
| 问题 | select | poll | epoll |
|---|---|---|---|
| 程序如何告诉内核关注谁? | 每次提交 FD 集合 | 每次提交 pollfd 数组 | 用 epoll_ctl 登记,内核保留关注关系 |
| 结果在哪里? | 原集合被修改为就绪集合 | 各项 revents 字段 | epoll_wait 的结果数组 |
| 应用怎样找到就绪连接? | 检查集合标记 | 检查数组各项 | 遍历本次返回的事件 |
| 下一轮等待前做什么? | 恢复关注集合 | 继续提交关注数组 | 没有关注变化时,直接再次等待 |
| 是否有 fd_set 的固定表示限制? | Linux/glibc 常见要求为 FD 小于 1024 | 没有这一限制 | 没有这一限制 |
| 支持平台 | POSIX 接口,较广泛支持 | POSIX 接口,较广泛支持 | Linux 特有接口 |
三者的核心差别可以压缩成一句话:select 每轮传位集合、返回时改写它;poll 每轮传数组、在各项填结果;epoll 先登记关注关系,等待时主要取本次就绪事件。前两者与“关注多少项”关系更紧,后者在大量连接而少量活跃时通常更有优势,但返回事件仍要交付给应用,之后仍要由应用读写。
poll 和 epoll 没有 fd_set 的这项限制,不代表连接数量无限;进程可打开文件数、内存和系统配置仍会限制规模。
三者都可以设置等待超时,也都需要处理错误。本文的顺序例子用于推演接口语义,没有作为网络程序运行测试;真实程序必须检查调用结果,不能把所有返回都当作“收到了一条完整消息”。
面试总结
select、poll 和 epoll 都可用于 I/O 多路复用,让线程一起等待多个对象的就绪事件,再对就绪对象发起实际读写。其中 select、poll 是调用,epoll 是 Linux 提供的一套接口。
select 用描述符集合表达关注对象,返回时集合被改为就绪结果,所以每轮要恢复集合;Linux 常见接口还有固定 FD 表示范围。poll 改用数组,分开保存关注事件和返回事件,避开了同样的固定集合限制,但仍要每次提交并检查数组。
epoll 把登记与等待分开:epoll_ctl 维护内核中的关注集合,内核事件通知维护就绪记录,epoll_wait 把本次事件写入应用提供的数组。它减少了大量连接下重复提交和全量检查的工作,适合连接多、活跃比例低的场景,但不保证所有情况下更快,也不会代替应用读取数据或处理业务。谈 C10K 时,还要考虑 FD、内存和业务处理能力;poll 也能监听很多连接,只是大量空闲连接下每轮扫描的成本较高。
6. LT 和 ET 有什么区别?
聊天服务器收到“某个连接可以读取”的通知后,会调用 recv 读取数据。如果这次没有读完,操作系统还会不会继续提醒它?
LT 和 ET 的主要区别,就在于如何报告就绪事件:LT 在条件仍然满足时可以继续报告;ET 不会仅因为上次的数据还没读完,就保证再次提醒。 这里的“可读”,先理解为连接中已有数据,程序可以尝试读取。
LT 是 Level Triggered,水平触发;ET 是 Edge Triggered,边缘触发。下面以 Linux 的 epoll 为例:它默认采用 LT,注册连接时设置 EPOLLET 可以启用 ET。这两种方式改变的是通知规则,实际取数据仍要由程序调用 recv 完成。
用水位报警理解 LT 和 ET
假设水箱有一条警戒线,可以设计两种报警方式:
- 水平触发(LT):只要水位还高于警戒线,就持续报警。
- 边缘触发(ET):水位从下方越过警戒线时响一次;之后即使一直高于警戒线,也不会仅因水位仍然超标而反复响。
比如水位超标后,你放掉一点水,但水位还在线上方:LT 继续报警,ET 不会为这个持续状态重复报警。
对应到网络读取,水位仍然超标,就像接收缓冲区里仍然有数据:LT 让程序还有机会通过后续通知发现这些数据;ET 则要求程序主动跟进,不能读一点就指望再来一次提醒。
这个比喻只用于理解“持续状态”和“变化”的区别。真实 Socket 后续收到新数据时,即使原来的数据尚未读完,也可能产生新的 ET 事件,不能把它理解成“连接一生只通知一次”或“必须彻底变空才可能再通知”。
同样剩下 60 字节,LT 和 ET 会怎样处理?
假设服务器只用一个线程处理这个连接,没有其他线程同时读取,也暂不考虑断开和错误:
- 连接 B 收到 100 字节,暂存在内核的接收缓冲区里,等待程序读取。
epoll_wait返回 B 的可读事件,程序得知 B 可以尝试读取。- 程序调用
recv,这次只取走 40 字节,还剩 60 字节。 - 此后没有新数据到达,程序再次调用
epoll_wait。
如果使用 LT,B 仍然可以被报告为可读。 因为那 60 字节还在,可读条件没有消失。程序获得事件后,可以继续读取剩余数据。这里的“持续提醒”是指后续调用等待接口时仍可得到事件,并不是操作系统一直主动调用程序的某个函数。
如果使用 ET,程序不能依赖再次获得 B 的可读事件。 先前的通知已经告诉程序“这个连接有数据需要处理”,剩下 60 字节本身不保证产生新提醒。如果程序就此等待,而其他连接也没有事件,等待可能迟迟不返回。
问题就在这里:数据已经到了,但程序没有继续读,却在等另一次不保证出现的通知。 Linux 手册正是用这种“只读一部分便重新等待”的情形说明 ET 的使用风险。Linux epoll(7) 手册

ET 收到提醒后,怎样知道当前数据已经读完?
既然不能把剩余数据寄托给下一次通知,一个常见且稳妥的做法就是:收到可读事件后继续读取,直到当前没有更多数据可以读取。
但程序通常不知道缓冲区里究竟还剩多少字节。即使刚才读到了 60 字节,也不能仅凭这次的返回值判断后面还有没有数据,因此需要再次尝试。
这又引出了一个问题:如果使用阻塞 Socket,数据已经取完后再次调用 recv,线程可能停下来等待 B 的下一批数据。服务器还要处理 A、C 等其他连接,不能被 B 一直占住。
因此,ET 通常配合非阻塞 Socket:
- 有数据时,
recv返回实际读到的字节数。 - 暂时没有数据时,
recv不会停在那里等,而是返回-1,并将错误码设为EAGAIN或EWOULDBLOCK。
这里的错误码可以理解为:“现在没有更多数据,稍后再试。” 它不表示连接一定坏了。
继续上面的例子,假设期间没有新数据到达:
- 收到 B 的可读事件,第一次读取取得 40 字节。
- 继续读取,取得剩余 60 字节。
- 再次尝试,非阻塞
recv返回EAGAIN。 - 程序知道 B 当前没有更多可立即读取的数据,可以转去处理其他连接,或者再次等待事件。
这样,“继续读取”避免遗漏已有数据,“非阻塞”避免线程等在某一个连接上,EAGAIN 则提供了一个明确的暂停点。Linux recv(2) 手册
还要分清三个结果:对 TCP 进行长度大于 0 的接收时,返回 0 通常表示对端已正常关闭发送方向,且待接收数据已读尽;其他错误需要按原因处理,例如被信号中断时可能需要重试。它们不能都当作 EAGAIN 处理。

“当前读完”不等于“一条消息完整了”
假设一条聊天消息共 100 字节,网络暂时只送来了前 40 字节。程序取走这 40 字节后,也可能得到 EAGAIN。
因此,EAGAIN 只说明此刻没有更多字节可读,不能说明一条聊天消息已经接收完整。程序还需要按消息长度、分隔符等协议规则判断边界,把未完整的数据留在自己的缓冲区中,等后续数据到来再继续处理。
同样,一次可读事件也不对应一条完整消息。LT 和 ET 解决的是“何时提醒程序尝试读写”,消息怎样拼接属于应用协议的问题。
实际开发中怎样选择?
LT 的处理方式更容易掌握。 一次没读完,只要连接仍然可读,后续等待仍可继续报告,便于程序分批处理。不过,如果收到事件后始终不读,等待接口可能不断返回同一个连接,造成无效循环。事件循环使用 LT 时,也常配合非阻塞 Socket。
ET 可以减少某些持续就绪状态下的重复报告,但需要程序管理好未完成的工作。 常见读取方式是非阻塞读取到 EAGAIN。如果为了照顾其他连接而限制每轮读取量,程序也可以提前暂停,但必须自行安排后续继续处理,不能直接忘掉未读数据、只等下一次 ET 通知。
LT、ET 也适用于写事件:可写表示现在有机会写入,不表示任意多的数据都能一次发完。ET 下通常持续发送,直到应用待发送数据用完,或非阻塞发送返回 EAGAIN;部分发送和后续续写都需要程序处理。
ET 并不保证比 LT 更快。 选择时应看事件处理方式、活跃连接数和业务负载,而不是把 ET 当成必须采用的“高级模式”。
面试总结
LT 和 ET 是 Linux epoll 的两种就绪事件报告方式。LT 是默认模式:只要连接仍满足就绪条件,后续等待仍可继续报告。ET 不会仅因为上次的数据没有读完,就保证重复提醒,因此程序不能读一部分后直接依赖下一次通知。
ET 通常配合非阻塞 Socket,收到可读事件后持续读取到 EAGAIN,确认当前没有更多数据可取,再等待后续事件。LT 更容易正确处理,ET 能减少某些重复通知,但两者没有无条件的性能高低;它们都不负责判断业务消息是否完整。
7. 除了 Linux 的 epoll,其他系统如何处理大量 I/O?
假设聊天服务器维护着几千个连接,大部分用户没有发送消息,只有少数连接正在传输数据。服务器需要及时处理有事可做的连接,又不希望为每个空闲连接都安排一个专门等待的线程。
Linux 的 epoll 是解决这个问题的一种机制。换到其他系统,也有相应的选择:macOS、FreeBSD 等系统提供 kqueue;Windows 高并发服务器常使用 IOCP,也就是 I/O 完成端口。
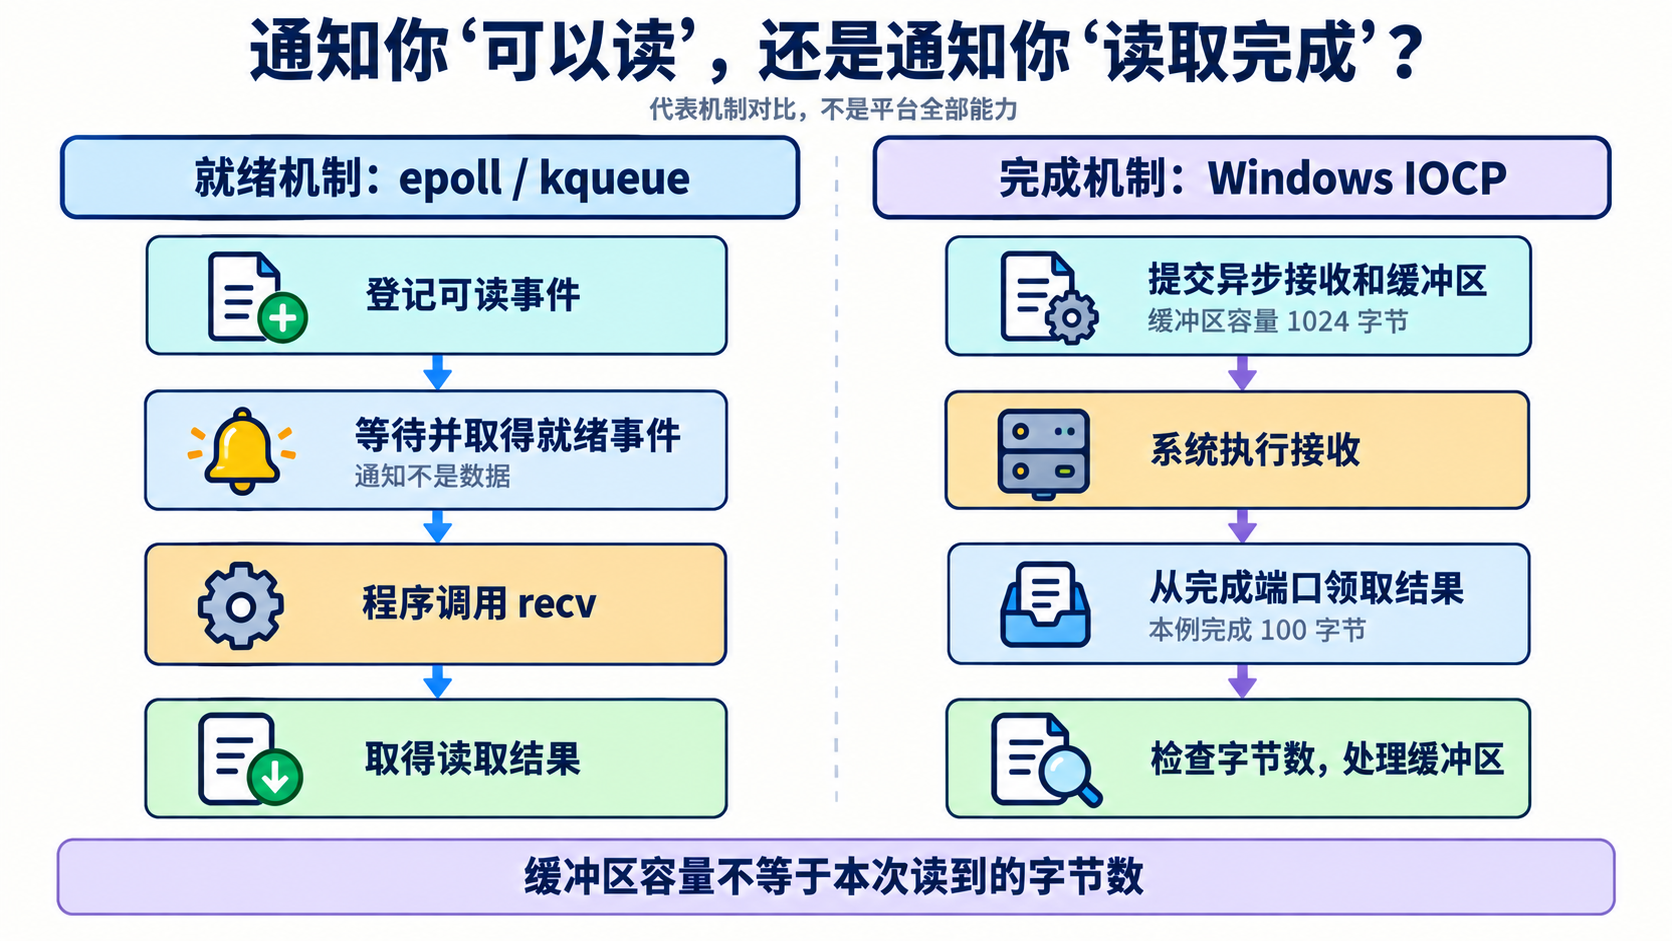
它们都能帮助程序集中处理许多连接,但不能只当作同一种接口换了名字。理解本题,关键在于看清:程序得到的是“可以尝试读取”的提醒,还是“此前提交的读取已经完成”的结果。
先用取餐理解两种通知
你替同事订了几份午餐,可以选择两种取餐方式:
- 看屏取餐:餐厅屏幕显示“B 餐可取”,你再去窗口拿。屏幕只提供提醒,餐还没有交到你手里。
- 送餐到桌:点餐时留下桌号,服务员把 B 餐送到桌上,再告知“已送达”。这次交付已经完成,你不需要再去窗口取同一份餐。
在下面的网络读取场景中,epoll 和 kqueue 类似第一种:先告诉程序连接可读,再由程序调用读取接口。IOCP 配合异步接收则类似第二种:程序先提交接收请求和缓冲区,完成后再领取结果。
这里“去窗口取餐”对应的是程序还要发起读取调用;真实数据仍由操作系统按接口规则交给程序,并不是应用自己从网卡搬运数据。
kqueue:把需要关注的事件集中登记
先看与 epoll 比较接近的 kqueue。它是一种内核事件通知机制:程序告诉内核要关注哪些对象、关注什么情况,之后通过一个入口取得事件。
假设服务器有 A、B、C 三个连接,目前都没有数据。使用 kqueue 的基本过程是:
- 创建事件队列。 调用
kqueue(),取得后续操作这个队列所需的标识。这里存放的是事件信息,不是三条连接的聊天内容。 - 登记关注条件。 通过
kevent()登记 A、B、C 的可读事件。例如,对 B 使用EVFILT_READ,表示关注 B 的读取条件。 - 等待事件。 没有工作可做时,再通过
kevent()等待;已登记的关注关系由内核维护,不需要每轮把全部连接重新登记。 - 处理可读连接。 B 收到数据后,等待调用返回 B 的事件。程序随后对 B 调用
recv,读取并处理数据,再继续等待。
kevent() 的两个参数概念也就容易理解了:变更列表告诉内核本次要增加、修改或删除哪些关注项;事件列表接收本次返回的事件。一个调用可以提交变更并取得事件,两份列表承担不同职责。Apple kqueue(2) 手册
假如 B 的事件已经返回,但程序没有调用 recv,聊天内容并不会自动进入程序准备的接收缓冲区。这就是就绪通知与读取完成的区别。事件也可能涉及连接结束或错误,处理程序仍要检查实际读取结果。
kqueue 还可以统一关注不属于 Socket 读写的事件。例如,FreeBSD 可以把“连接有数据”“定时器到期”“某个子进程退出”登记到同一队列,程序取得事件后,再按事件种类分别处理。
这里用到的 filter(过滤器) 可以理解为“用哪一类规则判断要不要通知”,不是过滤聊天消息中的文字。不同系统支持的过滤器和选项有所差别;EV_CLEAR 等选项也有自己的规则,不能直接把 Linux 的 EPOLLET 用法照搬过去。FreeBSD kqueue(2) 手册
IOCP:先提交 I/O,再集中领取完成结果
Windows 的 IOCP 全称是 I/O Completion Port,I/O 完成端口。这里的“端口”不是 TCP 的 80、443 那种网络端口,而是用于汇集操作完成信息的系统对象。
先想一个问题:如果许多连接都已提交异步读取,程序怎样知道“哪个操作完成了、该由谁处理”?
IOCP 提供一个共同的完成队列,并允许一组工作线程从中领取结果。连接可以很多,处理结果的线程不必与连接一一对应。 没有结果时,线程可以等待队列;有结果后,领取并处理相应工作。Microsoft:I/O Completion Ports
不过,只把连接关联到 IOCP,还没有发起读取。程序需要先提交实际操作。Windows 中常用的方式叫重叠 I/O(Overlapped I/O):程序发起一项操作后,可以在它完成之前继续其他工作。“重叠”指 I/O 与其他工作的时间可以重叠,不是把数据相互覆盖。Microsoft:Overlapped Input/Output
仍然用 A、B、C 三个连接说明。以下假设使用支持重叠 I/O 的 Socket,请求暂未立即完成,并通过 IOCP 接收完成通知:
- 先建立结果的接收入口。 创建 IOCP,把三个 Socket 与它关联,让相关操作的完成信息汇集到这里。
- 给每个连接提交接收请求。 以 B 为例,程序准备一块 1024 字节的缓冲区,再通过重叠方式调用
WSARecv,表达“从 B 接收数据,放到这里”。这不是单纯登记“有数据时告诉我”,而是已经提交了一项接收操作。 - 请求等待期间,线程可以处理其他工作。 B 暂时没数据,并不要求一个线程一直停在 B 的接收调用里。
- B 的接收操作成功完成。 假设这次实际收到 100 字节,这些字节已放入先前指定的缓冲区,系统产生相应完成信息。
- 工作线程领取结果。 线程通过
GetQueuedCompletionStatus等接口取得操作信息及实际接收字节数,检查成功或失败,然后处理缓冲区里的内容。
第 2 步和 kqueue 的区别最重要:kqueue 登记的是“关注 B 何时可读”;这里提交的是“执行一次接收,并把数据放到指定位置”。WSARecv 若返回 SOCKET_ERROR,而通过 WSAGetLastError() 取得的错误码为 WSA_IO_PENDING,表示请求已成功发起、尚待完成,不表示提交失败。Microsoft:WSARecv
第 5 步得到的也不是一段需要再去 Socket 取出的聊天内容,而是识别操作、检查结果所需的信息。成功读取的数据已经在对应缓冲区中,不用再为这项已完成的请求调用一次 recv。完成也可能是失败完成,程序需要检查状态,不能只看到有通知就认定成功。Microsoft:GetQueuedCompletionStatus
因此,程序必须让缓冲区和该操作使用的状态结构在操作完成前保持有效,不能提交后就释放或随意复用。1024 字节也只是本次缓冲区容量,成功完成不保证填满它,更不保证恰好收到一整条聊天消息;程序仍需根据实际字节数和消息协议继续处理。
它们怎样帮助服务器处理大量连接?
沿着前面的例子扩大到几千个连接,区别可以这样看:
| 网络接收场景 | Linux epoll | macOS/BSD kqueue | Windows IOCP 配合重叠接收 |
|---|---|---|---|
| 程序先做什么 | 登记关注哪些连接的可读事件 | 登记连接及相应事件过滤器 | 关联 Socket,并提交接收请求和缓冲区 |
| 取得的是什么 | 连接的就绪事件 | 连接的就绪事件 | 已提交操作的完成结果 |
| 之后怎样取得数据 | 再调用接收接口 | 再调用接收接口 | 成功接收的数据已在指定缓冲区中 |
| 怎样组织处理线程 | 一个或多个事件循环处理就绪连接 | 一个或多个事件循环处理返回事件 | 工作线程领取完成结果 |
前两种方式让线程集中处理就绪连接,后一种让线程集中处理完成操作。它们都能避免简单地让每个空闲连接占据一个专门等待的线程,但不能因此直接断言谁更快,或保证固定的连接数量。
它们也不是各个平台唯一可用的选择。例如 Linux 还提供前面介绍过的 io_uring。本题选择这些代表机制,是为了理解不同设计;实际容量仍受内存、业务计算、网络带宽及程序组织方式影响。
面试总结
除了 Linux 的 epoll,macOS、FreeBSD 等系统可以使用 kqueue,Windows 高并发服务器常使用 IOCP。
kqueue 能集中管理多类事件;在 Socket 读取场景中,它与 epoll 一样,通常先报告可读,再由程序调用接收接口。IOCP 则配合重叠 I/O,程序先提交接收请求和缓冲区,之后由工作线程领取完成结果;成功接收的数据已经在指定缓冲区中。
关键不是记住三个平台名称,而是区分就绪通知与完成通知。它们都能帮助少量线程处理大量连接,但使用方式和资源管理要求不同,不能简单把 IOCP 当成 Windows 版 epoll。
8. 什么是零拷贝?
假设用户正在从服务器下载一个视频。服务器要做的事情很简单:在服务器取出视频数据,再通过网络发送给用户。
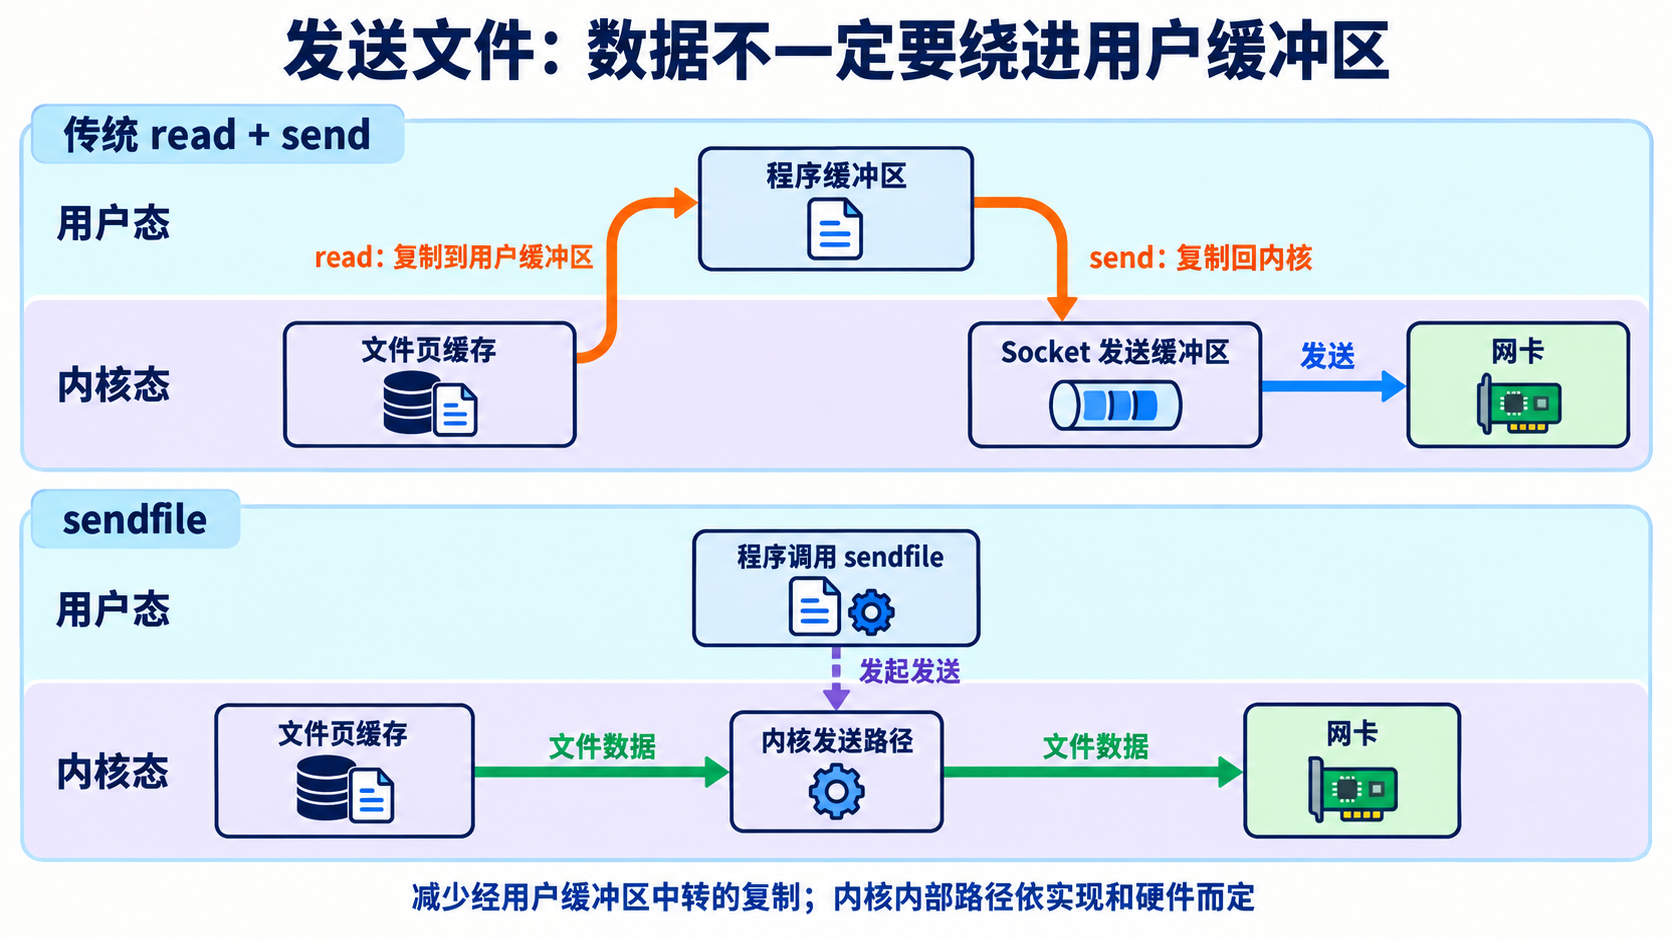
传统做法是,服务器先调用 read,把视频数据复制到应用程序的内存中;然后再调用 write 或 send,把这份数据交回内核,由内核通过网络发出去。
但在这个例子中,应用程序既不查看视频内容,也不修改视频内容,只是把数据从文件转交给网络。视频数据却仍然要先进入应用程序的内存,再回到内核,相当于多绕了一段路,也产生了额外的数据复制。
零拷贝就是用来减少这类无用中转的优化方法:让数据尽量直接在文件、内核和网络设备之间传递,减少 CPU 参与的数据复制。 这里的“零”不是说数据完全不需要移动,也不是说整个过程完全不需要 CPU。
为什么原样发送,也会复制来复制去?
先分清两块内存:
- 内核缓冲区由操作系统管理。例如页缓存保存最近使用的文件内容,Socket 发送路径也会使用缓冲与队列。
- 用户缓冲区是应用程序准备的内存。例如程序申请一块内存,用来接收
read读出的内容。
在普通缓冲文件读取和普通 Socket 发送的教学模型中,路径可以表示为:
文件内容进入内核页缓存
    ↓ read:复制到用户缓冲区
程序拿到文件内容
    ↓ write/send:复制到内核网络发送缓冲区
网络设备发送数据
页缓存未命中时,还要先从存储设备读取;若缓存已命中,就不需要为这一段再次读盘。设备与内存之间的搬运通常可由 DMA 协助完成,即 CPU 配置任务,由硬件搬运数据,而不是让 CPU 逐字节执行复制。
这条路径真正值得追问的是中间两步:如果应用根本不查看或修改内容,为什么还要把数据交给它,再让它原样交回来?
这就像仓库发货:你只负责安排运输,却要求仓库先把货送到你的办公室,再从办公室转送给客户。货确实送到了,但多了一段无用的中转。零拷贝的思路就是让你发出运输指令,货物尽量不经过这个中转点。
sendfile:告诉内核从哪个文件发到哪个连接
Linux 的 sendfile 允许程序指定输入文件、输出连接以及要传输的范围,让内核负责传输。应用不必先用 read 把这一段内容放进自己的缓冲区。
以上面的视频为例:
- 程序打开视频文件,并建立客户端连接。
- 程序调用
sendfile,指定把某一段文件内容发到这个连接。 - 内核取得相应文件数据,安排网络发送。
- 程序检查实际传输字节数,必要时继续处理尚未传完的部分。
它省掉了“页缓存 → 用户缓冲区 → 内核发送路径”的用户空间中转,还可能减少为每批数据分别调用读取和写入接口的开销。一次系统调用进入内核,不等于一定切换到另一个线程,所以不宜机械地把这里的收益写成固定减少几次线程切换。Linux sendfile(2) 手册
内核内部是否还要复制、网络设备能否直接读取已有页面,取决于具体路径和硬件能力。因此,不能把所有 sendfile 场景都画成固定“零次 CPU 复制”。
同样,调用成功也可能只传输一部分数据;返回的字节数不等于对端应用已经处理了这些字节。程序仍需处理剩余数据、暂时无法发送和错误。
mmap 和 splice 又省掉了什么?
它们经常与零拷贝一起出现,但解决问题的方式不同。
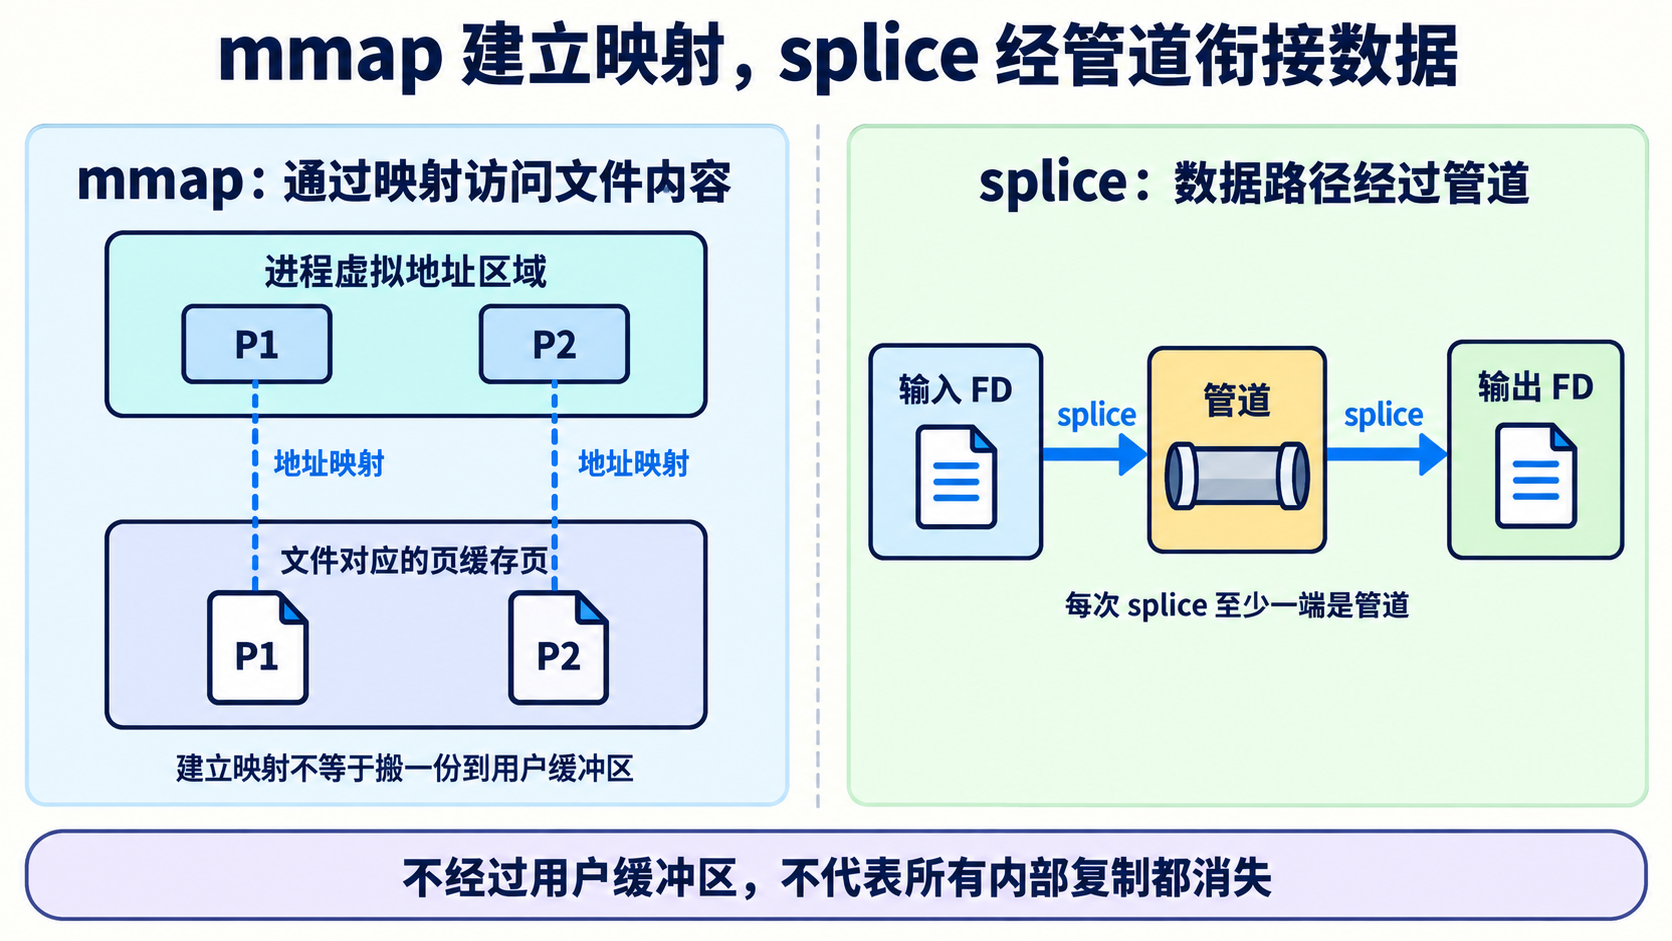
mmap:让文件内容以地址映射的方式供程序访问。 对普通文件映射而言,程序可以通过映射地址访问相应文件页,不必先由 read 复制到另一块用户缓冲区。如果页面尚未准备好,访问时仍可能发生缺页和文件读取。
但随后把映射地址传给普通 write 发送,并不保证网络发送那一段也没有 CPU 复制。映射避免的是某段复制,不代表整个传输流程自动零拷贝。 Linux mmap(2) 手册
splice:让数据在文件描述符之间传递,不经过用户缓冲区。 Linux 要求至少一端是管道。例如,在支持的路径上,可以把一个连接的数据先转入管道,再从管道转到另一个连接。程序负责安排传递,数据不必先读进应用内存;具体设备和文件系统是否支持,以及内核内部是否复制,仍有条件。Linux splice(2) 手册
理解这些接口,不必背“各自固定复制几次”。更可靠的办法是沿着数据路径问:哪一份数据原本被复制了?使用这个接口后,这段复制是否还需要?
什么场景适合?为什么不总用零拷贝?
原样发送静态文件、视频或转发较大数据时,减少复制比较有价值:可以降低 CPU 搬运数据的负担,减少内存带宽消耗。
如果应用要先压缩、修改或检查数据,原样传输的路径就未必适合直接使用。加密也需要结合用户态、内核或硬件的具体实现判断,不能笼统说“加密一定不能零拷贝”。
省去复制还可能带来新的管理要求。例如某些零拷贝发送会继续引用原来的内存,程序必须等到允许复用时才能修改它。Linux 的 MSG_ZEROCOPY 就需要处理缓冲区释放通知,而且存在页管理和通知成本,小数据不一定受益。Linux 内核:MSG_ZEROCOPY
因此,零拷贝是在减少特定成本,不是免除 I/O、内存管理或错误处理。
面试总结
零拷贝是减少数据传输中不必要 CPU 复制的优化思路。传统文件发送先把数据读到用户缓冲区,再交回内核;Linux 的 sendfile 可以省去这段中转,mmap 和 splice 也能在各自适用的路径上减少复制。
它适合原样发送或转发较大数据,但不保证物理上没有数据搬运,也不保证所有接口和硬件下复制次数相同。实际收益需要结合数据路径、传输规模和缓冲区管理成本判断。
9. 什么是大端序和小端序?
一个整数可能占用多个字节。当它放进连续的内存位置时,就有一个问题:先放数值的高位字节,还是先放低位字节? 这两种排列方式,分别叫大端序和小端序。
可以把它想成给一排编号递增的抽屉放数字卡片:每张卡片的内容不变,但必须约定从哪个方向开始摆、取出来后按什么顺序还原。双方约定不同,同一排卡片就可能被理解成不同的数字。
先分清“高位”和“低地址”
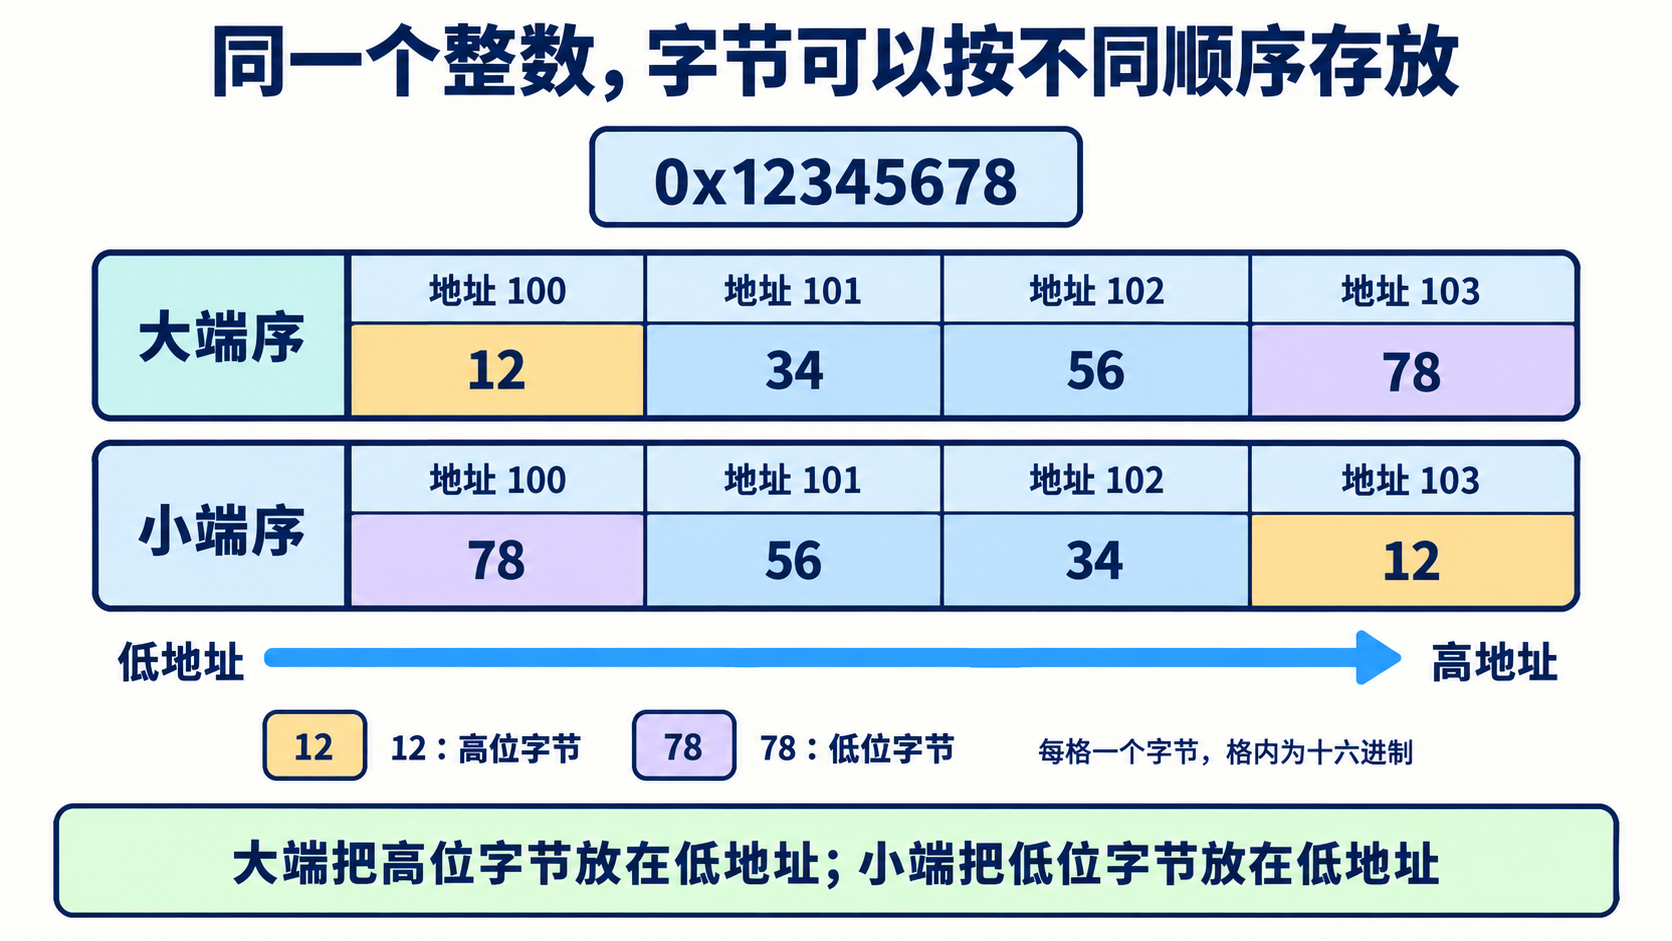
以四字节整数 0x12345678 为例。0x 表示后面的数用十六进制书写,每两位十六进制数可以表示一个字节,所以它可以拆成:
12    34    56    78
高位字节          低位字节
这里“高位”说的是数值中的位置,类似十进制 1234 中的千位比个位权重大。12 是高位字节,不是因为它比 78 的数值大。
“低地址”则是内存中的位置编号较小。例如地址 100 比地址 103 低。数值的高低位与内存地址的高低,是两个不同概念。
假设这个整数从地址 100 开始存放:
| 内存地址,按从低到高排列 | 100 | 101 | 102 | 103 |
|---|---|---|---|---|
| 大端序 | 12 | 34 | 56 | 78 |
| 小端序 | 78 | 56 | 34 | 12 |
所以记住一句话即可:大端把高位字节放在低地址,小端把低位字节放在低地址。
采用正确的读取规则时,两种布局表达的都是同一个整数 0x12345678。不同的是保存方式,不是这个数本身变了。
为什么通信时必须约定字节序?
假设程序要发送一个两字节的无符号整数 1,它的十六进制表示是 0x0001。
小端机器中的内存布局是 01 00。如果发送方把这两个内存字节直接发出去,接收方却按大端整数解释,就会得到 0x0100,也就是十进制 256。
两边收到的字节没有丢,也没有被修改,错误发生在解释字节的规则不一致。
因此,协议需要明确规定多字节字段怎样编码。传统 Internet 协议中的网络字节序采用大端,Linux/POSIX 常用以下函数在主机字节序与网络字节序之间转换:
htons、ntohs:处理 16 位整数。htonl、ntohl:处理 32 位整数。
名字中的 h 表示 host,n 表示 network,to 表示转换方向。注意这里的 l 对应 32 位接口,不能因为机器是 64 位就用它处理任意 64 位整数。Linux byteorder(3) 手册
例如,发送前把整数 1 转成协议要求的表示,其两个字节按 00 01 发送;接收后再转成本机表示,程序得到的数值仍然是 1。
哪些东西不能直接套用大小端?
单个字节没有字节排列问题。 大小端讨论的是一个多字节值中,各字节的排列,不是把每个字节内部的二进制位倒过来。
文本也不能按整数规则随意翻转。 文本字符 "1234" 与二进制整数 1234 是不同编码。如果按 ASCII/UTF-8 发送这些数字字符,应遵循文本编码,不把字符串整体倒过来。UTF-16 等采用多字节代码单元的编码,则有自己的字节序约定。
并非所有应用协议都必须采用大端。 网络传输可以承载任意字节,具体字段按协议规定解析;同理,保存二进制文件时也要约定格式。直接把 C/C++ 结构体整块发送还会涉及字段宽度和填充,单纯统一字节序并不足够。
面试总结
大端序和小端序是多字节数据的两种排列方式:大端把高位字节放在低地址,小端把低位字节放在低地址。正确解释时,数值相同;如果发送方与接收方使用不同规则,同一组字节就可能被读成不同的数。
网络协议和二进制文件应明确约定字节序。常见网络字节序是大端,可以用 htons、htonl 等处理相应宽度的整数,但不能把大小端理解为翻转字符串或单字节内部的位。
10. Linux 有哪些常见同步机制?
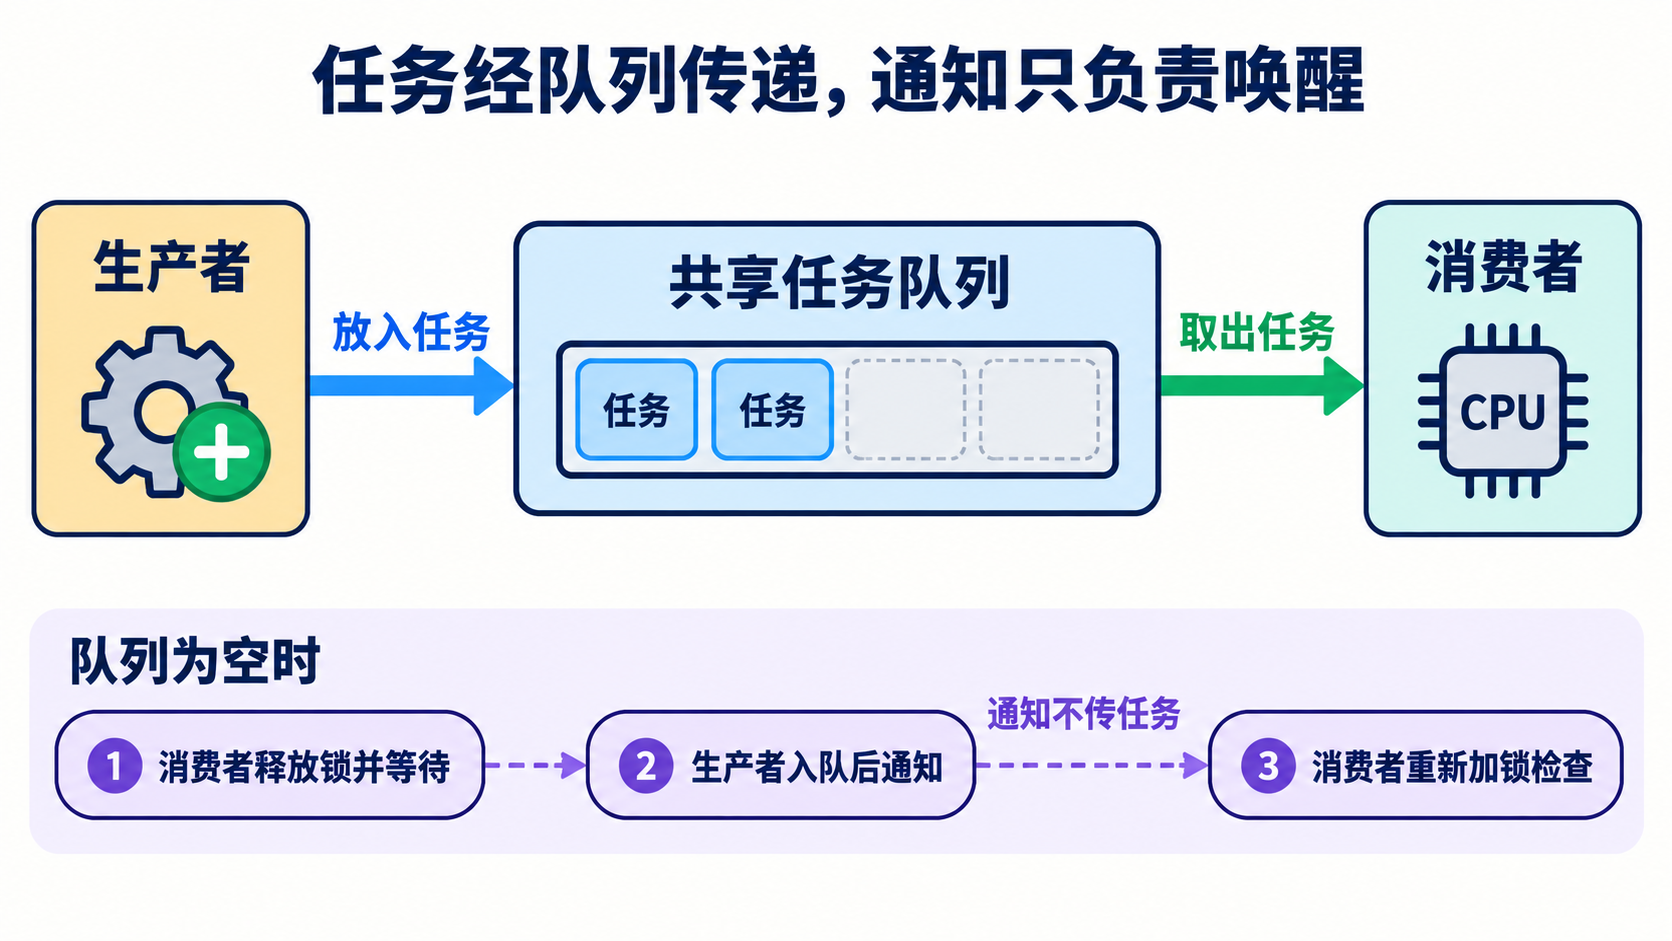
假设一个服务器有多个工作线程,共同从任务队列取工作。如果两个线程同时修改队列,可能破坏队列结构;如果队列为空,线程又需要等待新任务,而不是不停空转。
这其实是两个问题:怎样安全访问共享数据,以及怎样等到可以继续工作的时刻。 Linux 中的锁、信号量、条件等待等机制,就是为这些需求服务的。
可以用一间共用会议室建立直觉:门锁解决“此刻谁能独占使用”;预约通知解决“什么时候可以过来”;若有三间同类会议室,还要统计“剩几个可用名额”。它们都在协调使用者,但职责不同,不能只用一把锁解释所有同步问题。
先分清:写应用程序,还是写内核代码?
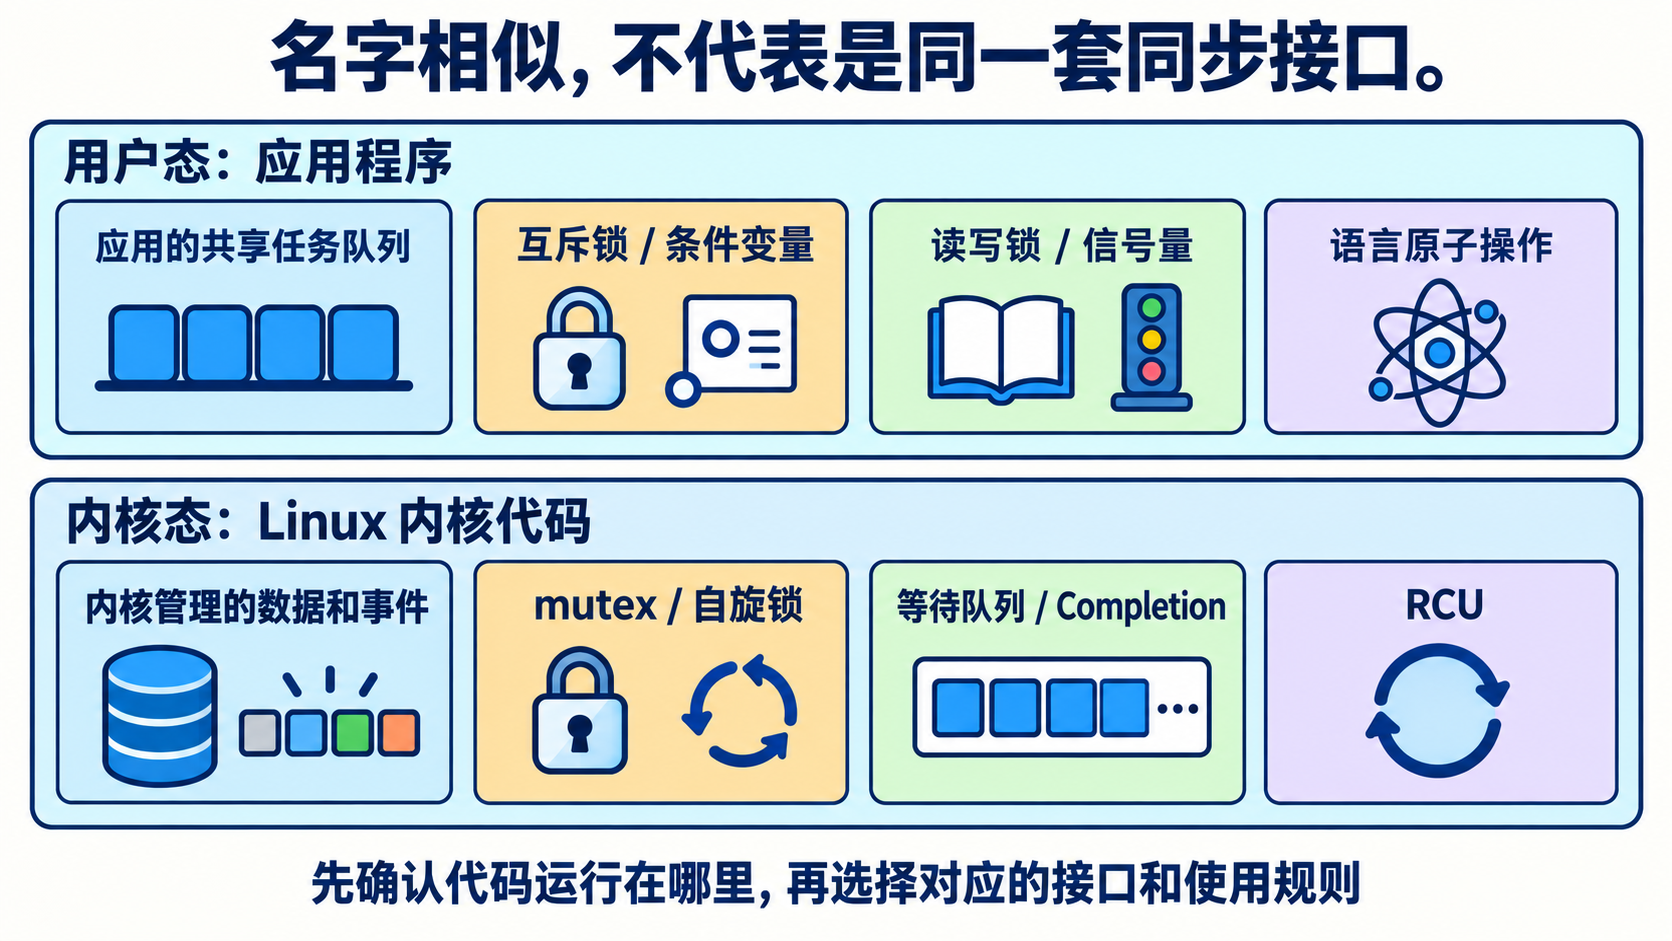
“Linux 同步机制”涉及两个层次:
- 用户态程序通常使用线程库提供的互斥锁、条件变量、读写锁、信号量,或者语言提供的原子操作。例如 C/C++ 程序使用
pthread_mutex或std::mutex。 - Linux 内核代码使用内核自己的
mutex、自旋锁、等待队列、Completion、RCU 等机制。
它们可能有相同的名称和思想,但不是一组可以混用的接口。应用程序不能直接拿内核的锁对象保护自己的业务队列。
先理解共同的同步需求,再看 Linux 怎样支持它们,会比直接背一串名称更容易。
互斥锁和自旋锁:都要独占,等待方式不同
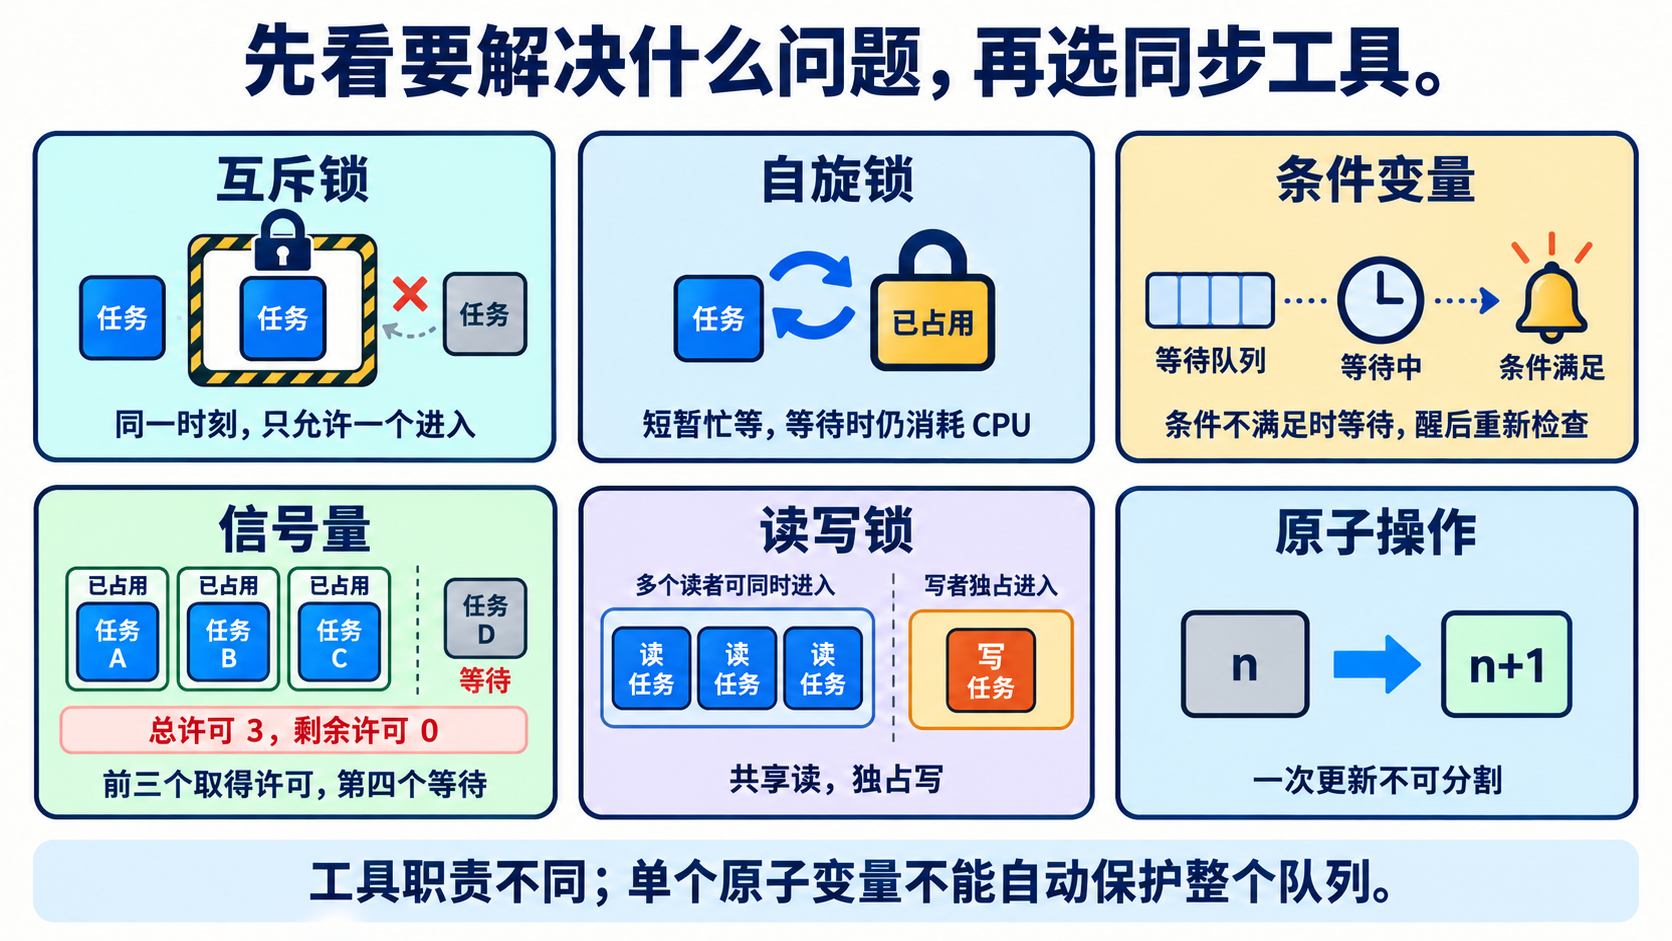
互斥锁用来保护一段只能由一个执行者进入的代码。例如,工作线程先取得队列锁,取走一个任务,更新队列,再释放锁;其他线程也遵守同一规则,修改就不会相互穿插。
如果暂时取不到锁,具有睡眠等待能力的互斥锁可以让等待者暂停运行,把 CPU 交给其他任务。具体实现也可能先短暂尝试,不应把每次加锁都理解为系统调用或线程休眠。
自旋锁也保护独占访问,但典型等待方式是反复检查锁是否可用。它避免某些睡眠与唤醒成本,却在等待期间消耗 CPU,适合预计很短、不能睡眠的临界区,而不适合拿到锁后长时间等磁盘。
在普通非 PREEMPT_RT 的 Linux 内核中,自旋锁持有期间不能调用可能睡眠的操作。硬中断处理也不能使用可能睡眠的锁;如果同一数据同时被线程上下文和中断访问,还要正确处理本地中断,不能随便套用普通加锁方式。
这里的上下文指代码当前在什么执行环境中,例如普通任务还是硬中断处理。实时内核 PREEMPT_RT 会改变 spinlock_t 的实现语义,raw_spinlock_t 仍保留严格自旋语义,所以不能把所有内核配置下的锁都一概而论。Linux 内核:锁类型与规则
条件变量、信号量和读写锁:分别处理不同需求
回到任务队列,互斥锁只能保证安全修改,不能回答“没任务时怎样等”。
条件变量用于等待一个业务条件。 工作线程持锁检查队列,若为空,就通过条件等待协调地释放锁并等待。生产者入队后发出通知,工作线程被唤醒、重新取得锁,再检查队列。
醒来还要检查,是因为任务可能已被其他消费者取走,也可能有虚假唤醒。因此应在循环中判断“队列非空”;通知不是任务本身,更不是取得任务的保证。POSIX 条件等待说明
计数信号量用于管理可用许可。 假设资源池有三个连接,许可数初始为 3。三个使用者依次取得许可,计数降到 0;第四个使用者需要等待。有人归还许可后,等待者才有机会继续。
互斥锁强调“谁持锁,谁释放”;信号量强调许可的取得与释放,并不要求二者总由同一线程完成。它适合资源计数和某些先后顺序协调,但不会自动保护资源池内部的全部数据结构。Linux POSIX 信号量概述
读写锁用于共享读、独占写。 多个线程只读取一份配置时,可以共同持有读锁;更新配置的线程需要写锁,避免别人看到修改中的状态。读多不代表一定更快,锁的管理成本、临界区长度和公平策略都会影响效果。
用户态常见的是 pthread_rwlock;内核还有自旋式 rwlock_t 和可睡眠的读写信号量 rw_semaphore,不能仅凭“读写”两个字就认为它们可以用在同一环境中。
原子操作与 Futex:简单修改和高效等待的基础
如果只是多个线程给完成任务数加一,使用合适的原子递增可以让这次更新作为不可分割的操作完成,避免普通“读旧值、计算、写回”交错产生覆盖。
但把队列长度改成原子变量,不代表整个队列就线程安全。队列指针、节点和长度之间的关系仍需一起维护;多个原子操作组合起来,也不自动成为一个整体。原子性与其他内存访问的顺序也要分清,不能假设所有原子接口都提供最强的内存顺序保证。Linux 内核:Atomic types
Linux 还提供 Futex,作为用户态同步设施的底层构件。常见线程库利用它,让无竞争的加锁在用户态通过原子操作完成;确实需要等待时,再请求内核挂起线程,之后由唤醒操作使其重新可运行。
以互斥锁为例:
- A 发现锁空闲,在用户态取得锁。
- B 发现锁被占用,按库的协议尝试或进入内核等待。
- A 释放锁,需要时唤醒等待者。
- B 恢复后继续检查和争取锁,不是被唤醒就天然拥有锁。
Futex 不是一个替程序管理业务条件的“万能锁”。普通应用通常使用成熟线程库,不必直接设计 Futex 协议。Linux futex(7) 手册

内核怎样等待事件,又怎样让读取更轻量?
等待队列用于组织等待某条件的任务。例如驱动尚未收到数据,就让读取任务等待;设备产生数据后,驱动更新状态并唤醒等待者。醒来仍要按相应协议检查条件,等待队列本身不替代共享数据的保护。
Completion 更适合表达“某项工作完成了”。例如内核任务发出一项设备请求,在需要结果时调用 wait_for_completion;完成处理路径调用 complete。若完成先发生,后来等待也能观察到完成状态,不必要求等待动作一定先执行。
Completion 是 Linux 内核同步对象,与上一题 Windows 的 IOCP 完成端口不是同一个接口。对象本身还必须活到相关操作结束,不能等待超时后就释放仍可能被完成处理使用的内存。Linux 内核:Completions
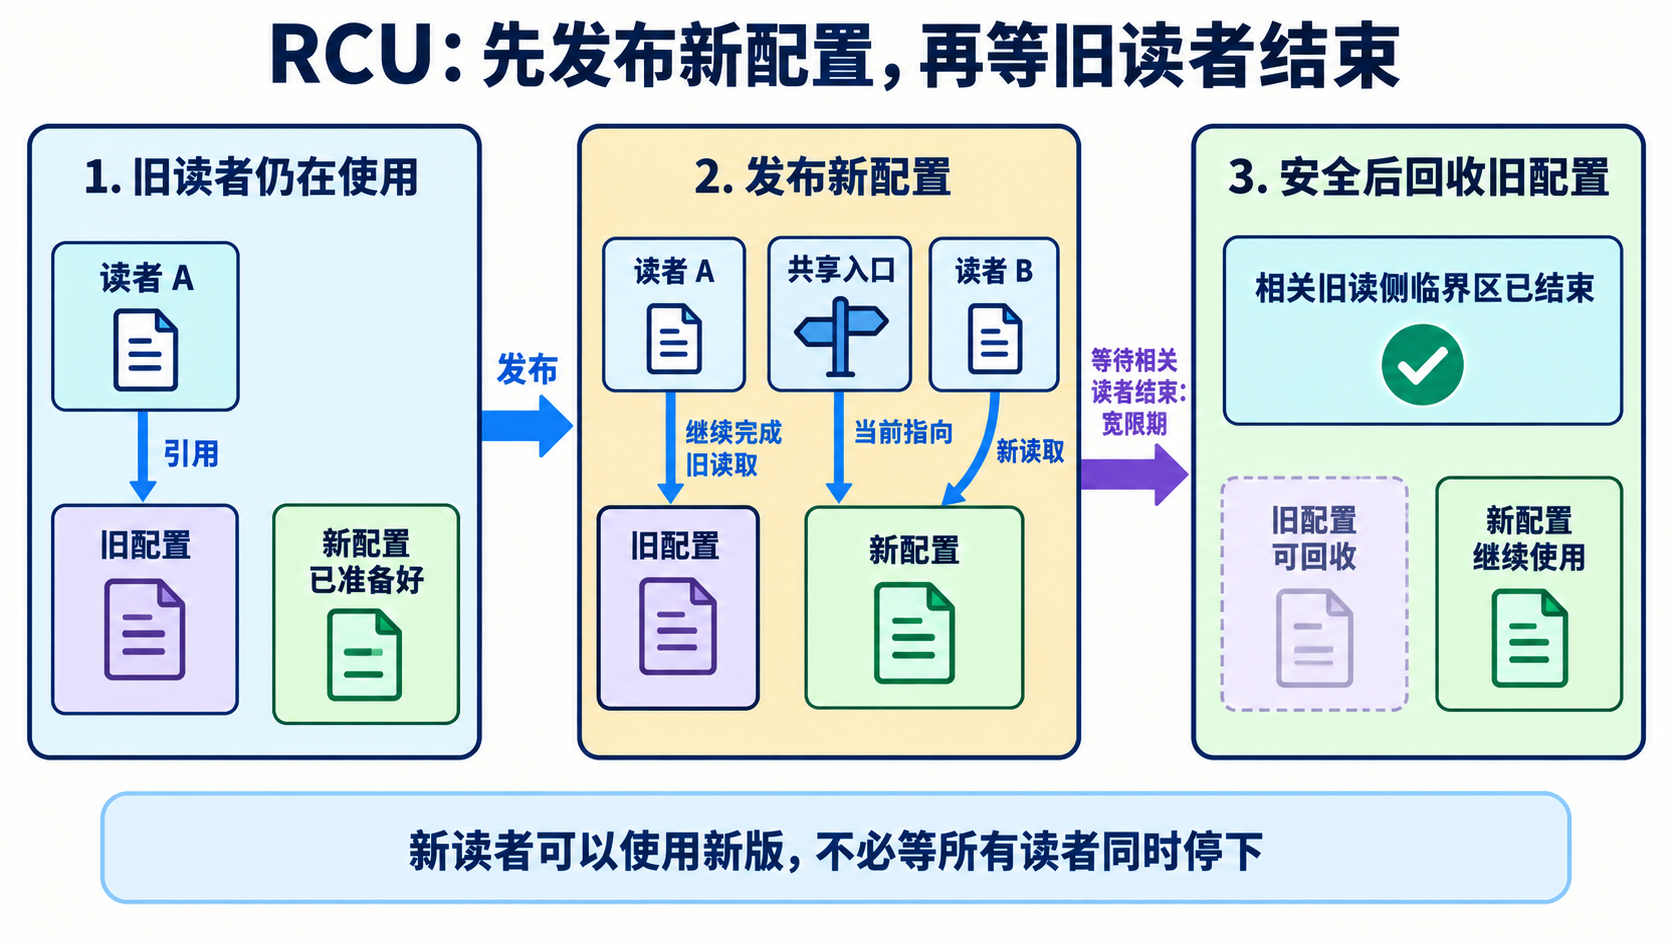
RCU(Read-Copy-Update)则面向许多读者、较少更新的共享对象。它的一个典型用法,可以用更换配置说明:
- 读者 A 正在使用旧配置。
- 更新者另外准备好新配置,通过 RCU 规定的发布方式替换共享指针。
- 后续读者可以取得新配置;A 仍可安全完成对旧配置的访问。
- 等到可能持有旧引用的相关读侧临界区都已结束,再回收旧对象。这段等待称为宽限期。
就像更新公共查阅资料时,先提供新版,让手里拿着旧版的人读完,再回收旧版。重点是发布新内容与回收旧内容分开进行。
RCU 不等于复制所有数据,也不自动解决多个更新者之间的冲突;写方协调、正确发布和对象生命周期仍需要设计。Linux 内核:What is RCU?
面试总结
Linux 常见同步机制包括互斥锁、自旋锁、读写锁、信号量、条件等待和原子操作。独占修改考虑互斥锁,管理资源数量考虑信号量,等待条件用条件变量等机制;短小且不能睡眠的内核临界区可能使用自旋锁。
还要区分用户态与内核:线程库可以借助 Futex 实现高效等待;内核用等待队列、Completion 组织事件等待,用 RCU 降低某些读多写少场景的读侧开销。选择时首先看同步需求和能否睡眠,而不是认定某一种机制总是最快。
11. 什么是虚拟化技术?虚拟机和容器有什么区别?
一台物理服务器上可能要同时运行开发环境、测试环境和正式服务。它们需要不同的软件配置,有的甚至需要不同的操作系统,但没必要为每套环境都单独购买一台机器。
虚拟化的基本思路是:在真实资源之上提供一层抽象,让多个运行环境按一定规则共享底层硬件。 本题重点讨论两种常见方式:为每个环境提供“虚拟计算机”的虚拟机,以及在同一内核上隔离应用运行环境的容器。
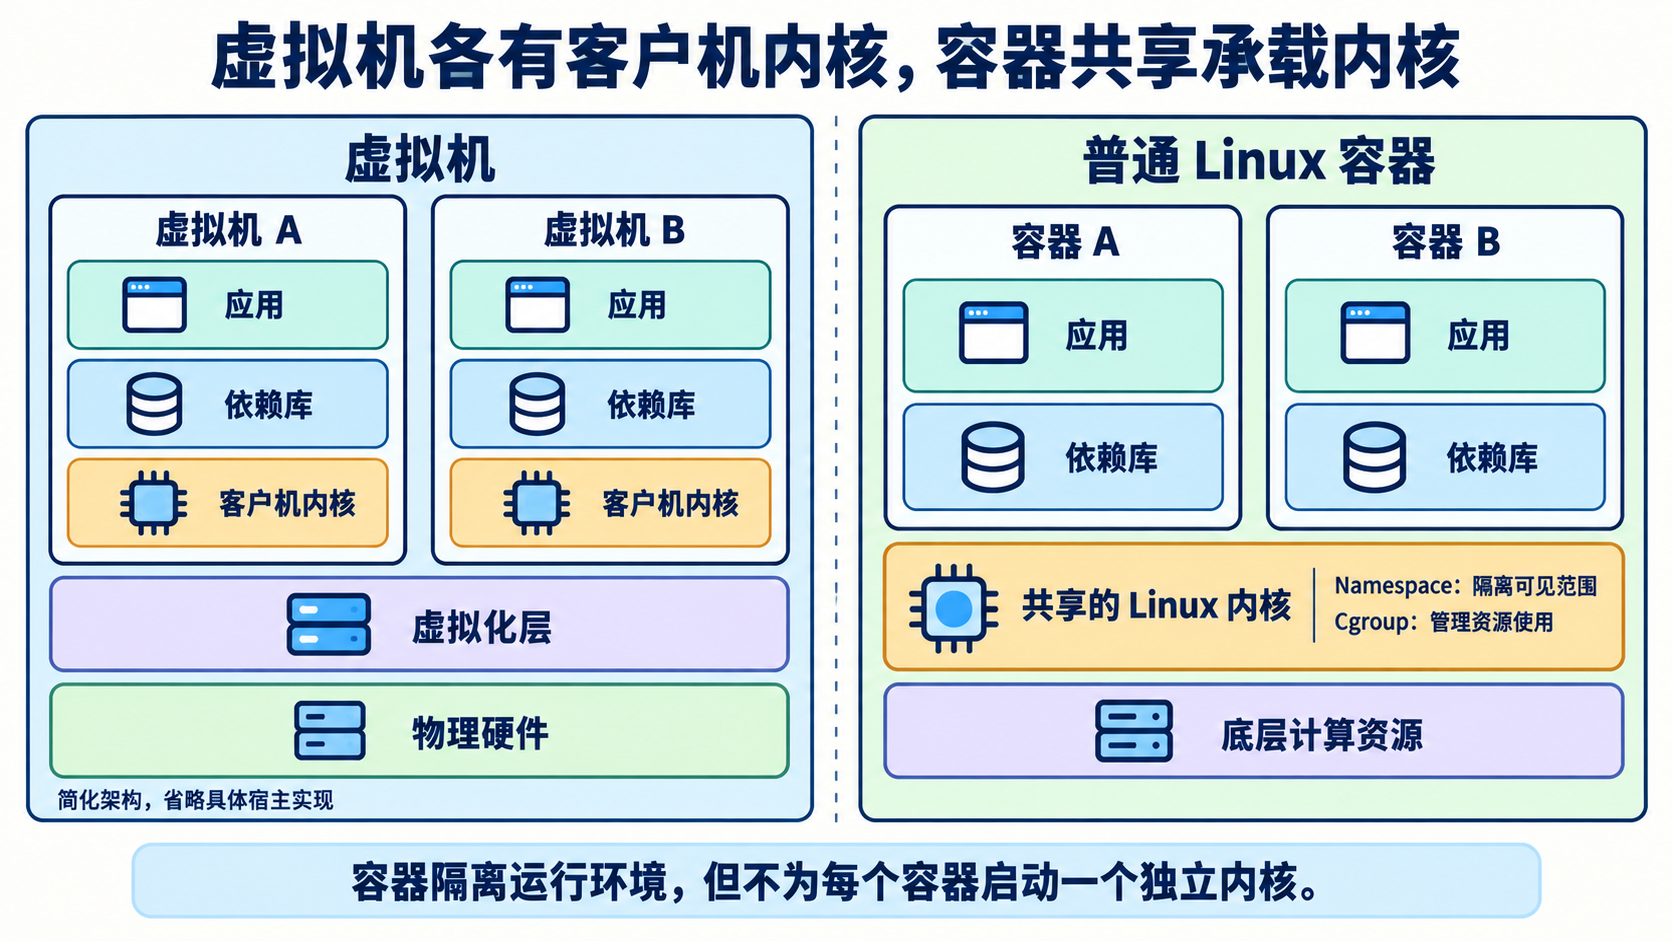
它们都能让环境彼此分开,但最关键的区别是:虚拟机可以运行自己的客户机内核;普通 Linux 容器共享承载它们的 Linux 内核。
虚拟机:给系统提供一台“可运行的虚拟计算机”
可以先想象一块办公场地被划成几套独立办公室,每套都有自己的内部管理。背后的土地和基础设施仍然共享,但使用者可以分别安排内部事务。
对应到虚拟机,程序看到的不只是一个独立目录,而是一套可以启动操作系统的环境:虚拟 CPU、内存、磁盘和网卡。每台虚拟机里面运行的操作系统称为客户机系统;承载虚拟机的物理机器称为宿主机。
管理这些虚拟资源的软件通常称为 Hypervisor,虚拟机监控器。它负责把客户机的运行需求安排到实际硬件上。Red Hat:What is a hypervisor?
例如一台服务器具有 8 个可供调度的逻辑 CPU 和 32GiB 内存,为讲清主线,假设不进行资源超额分配:
- 虚拟机 A 配置 2 个虚拟 CPU、8GiB 内存,运行一个 Linux 系统。
- 虚拟机 B 配置 2 个虚拟 CPU、8GiB 内存,运行另一个受支持的系统。
- 其余资源留给宿主及其他工作。
虚拟 CPU,也就是 vCPU,是客户机看到的执行资源。它没有凭空制造新的处理器,最终仍要由真实 CPU 执行。分配 2 个 vCPU,也不自动意味着永久独占两个物理核心。
CPU、内存和 I/O 是怎样“虚拟”的?
CPU 虚拟化让客户机可以执行代码,又不能任意接管宿主硬件。在常见硬件辅助虚拟化中,许多客户机指令可以直接在处理器上运行,需要特殊处理的操作再交给虚拟化层。不是所有指令都必须由软件逐条模拟。
内存虚拟化让客户机看到自己的内存布局。客户机中的程序先使用自己的虚拟地址,客户机内核进行映射,虚拟化机制再把客户机认为的物理内存对应到宿主实际内存。不同虚拟机不能因为使用相同的客户机地址,就随意访问对方的数据。
I/O 虚拟化让客户机通过虚拟磁盘、虚拟网卡完成读写。请求最终可能由宿主文件、存储设备或网络设备承担,也可以通过专门的虚拟化驱动或设备直通减少某些中间开销。
以 Linux 上常见的 KVM/QEMU 组合为例,KVM 提供创建虚拟机、管理 vCPU 等内核接口,QEMU 配合提供机器与设备模型。具体可以采用硬件加速或软件模拟,取决于配置和平台。Linux KVM API 文档、QEMU 系统模拟说明
这三部分共同提供的是可运行的机器环境,而不只是“把 CPU 时间分成几份”。
Hypervisor 的 Type 1 和 Type 2 是什么?
这是按虚拟化层的组织方式进行的常见分类:
- Type 1,裸机型:虚拟化层直接承担硬件上的客户机管理职责,典型如 VMware ESXi。
- Type 2,宿主型:依托已有操作系统运行虚拟机软件,典型如桌面上的 VirtualBox。
这有助于理解部署位置,但现实实现可能跨越用户态与内核态,不能仅凭“能看见一个宿主系统界面”就机械分类,更不能由类别直接推导出固定性能排名。初学阶段把握两者依托环境的区别即可。Red Hat:Hypervisor 类型
容器:隔离应用环境,不为每个应用再启动一个内核
如果两个服务都能运行在同一个 Linux 内核上,差别只是依赖库、配置和文件,那么每个服务都启动一整套客户机系统,可能增加不必要的开销。
容器选择另一条路:应用仍作为进程运行,由同一个 Linux 内核管理,但给不同进程安排不同的资源视图、文件环境和权限。
沿用办公场地的类比,虚拟机像分别设置内部管理的办公室;容器更像同一管理体系下划出的独立工作区。工作区有自己的物品和出入规则,但共同依赖同一个管理核心。这个比喻只解释管理层次,不能代替实际隔离机制。
Linux 容器主要依靠几类能力:
- Namespace(命名空间)划分可见范围。 例如进程命名空间让容器看到自己的进程编号,网络命名空间可提供独立的网络接口和端口空间,挂载命名空间让它看到不同的文件系统挂载布局。
- Cgroup(控制组)管理资源使用。 例如统计一组进程的内存用量,限制 CPU 时间或内存额度。资源限制需要实际配置,并不是启动容器后自动获得所期待的全部限制。
- 权限和安全机制约束可执行操作。 结合用户身份、能力限制等机制,避免隔离只停留在“看起来不同”。
简要地说:命名空间主要回答“能看到什么”,控制组主要回答“能使用多少资源”。两者相互补充,不能混为一个功能。Linux namespaces(7) 手册、Linux Control Group v2 文档
例如,服务 A 和 B 分别装有不同版本的用户态依赖库,可以在不同容器里运行而不互相覆盖文件;但它们发起系统调用时,服务它们的仍是共同的宿主 Linux 内核。容器镜像包含某个发行版的工具和库,不等于为这个容器启动了该发行版自己的内核。
实际应该怎样选择?
| 关心的问题 | 虚拟机 | 普通 Linux 容器 |
|---|---|---|
| 内核归谁管理 | 每台客户机运行自己的内核 | 共享承载它们的 Linux 内核 |
| 环境差异 | 可运行受平台支持的不同客户机系统 | 用户态环境可不同,但要兼容共享内核与平台 |
| 启动与基础开销 | 通常需要启动客户机系统并分配相关资源 | 通常以启动隔离进程为主,基础开销较小 |
| 适合的需求 | 不同内核、完整系统测试、较强系统边界 | 应用打包、快速部署、较高部署密度 |
想测试不同操作系统内核,或者需要独立重启客户机系统,可以考虑虚拟机;想把应用与依赖一起交付、减少环境差异,可以考虑容器。二者也常组合:先用虚拟机划分环境,再在虚拟机里运行多个容器。Docker:What is a container?
共享内核意味着容器之间存在共同依赖,但虚拟机也不是绝对安全边界,仍需关注漏洞、权限和配置。Linux 容器也不能仅凭镜像就直接换成 Windows 内核;如果桌面工具借助虚拟机运行 Linux 容器,容器共享的是那台虚拟机的 Linux 内核。
面试总结
虚拟化通过抽象和管理真实资源,让多个运行环境共享一台物理机器。虚拟机提供虚拟 CPU、内存和设备,可以运行独立的客户机内核;容器则主要隔离进程的运行环境,在普通 Linux 容器场景中共享承载它们的内核。
Linux 容器常用命名空间隔离视图、控制组管理资源,并结合权限限制。虚拟机适合需要独立系统或不同内核的场景,容器适合应用打包和快速部署,二者可以结合使用,不能只按“谁更轻”判断优劣。
12. 操作系统使用哪种排序算法?
操作系统没有统一使用的某一种排序算法。 内核要处理的数据很多:有的是一批固定记录,有的是不断到达的任务;有的放在数组里,有的连成链表。不同需求,会选择不同算法或数据结构。
因此,这道题更值得回答的是:内核为什么选择某种排序方式,以及哪些场景根本不需要每次重新排序。
先区分“排好一批数据”和“不断选出下一项”
老师按成绩排列一份已经收齐的名单,属于一次性排序:数据给定,希望得到完整的先后顺序。
医院分诊则不同:病人不断到来,也不断有人离开,需要持续决定“接下来处理谁”。每来一个人就把全部名单从头排一遍,未必是合适的方法。
操作系统也有这两类需求:
- 取得一批记录,需要把它们按编号排列,可以调用排序函数。
- 任务持续加入、退出,只需要反复取得最早到期或当前最合适的对象,可能使用树、堆、队列等结构维护选择所需的信息。
这里的堆是一种数据结构,不是程序分配动态内存时所说的“堆内存”。使用堆维护优先关系,也不等于每次都对全部数据执行一遍堆排序。
Linux 中可以看到哪些具体例子?
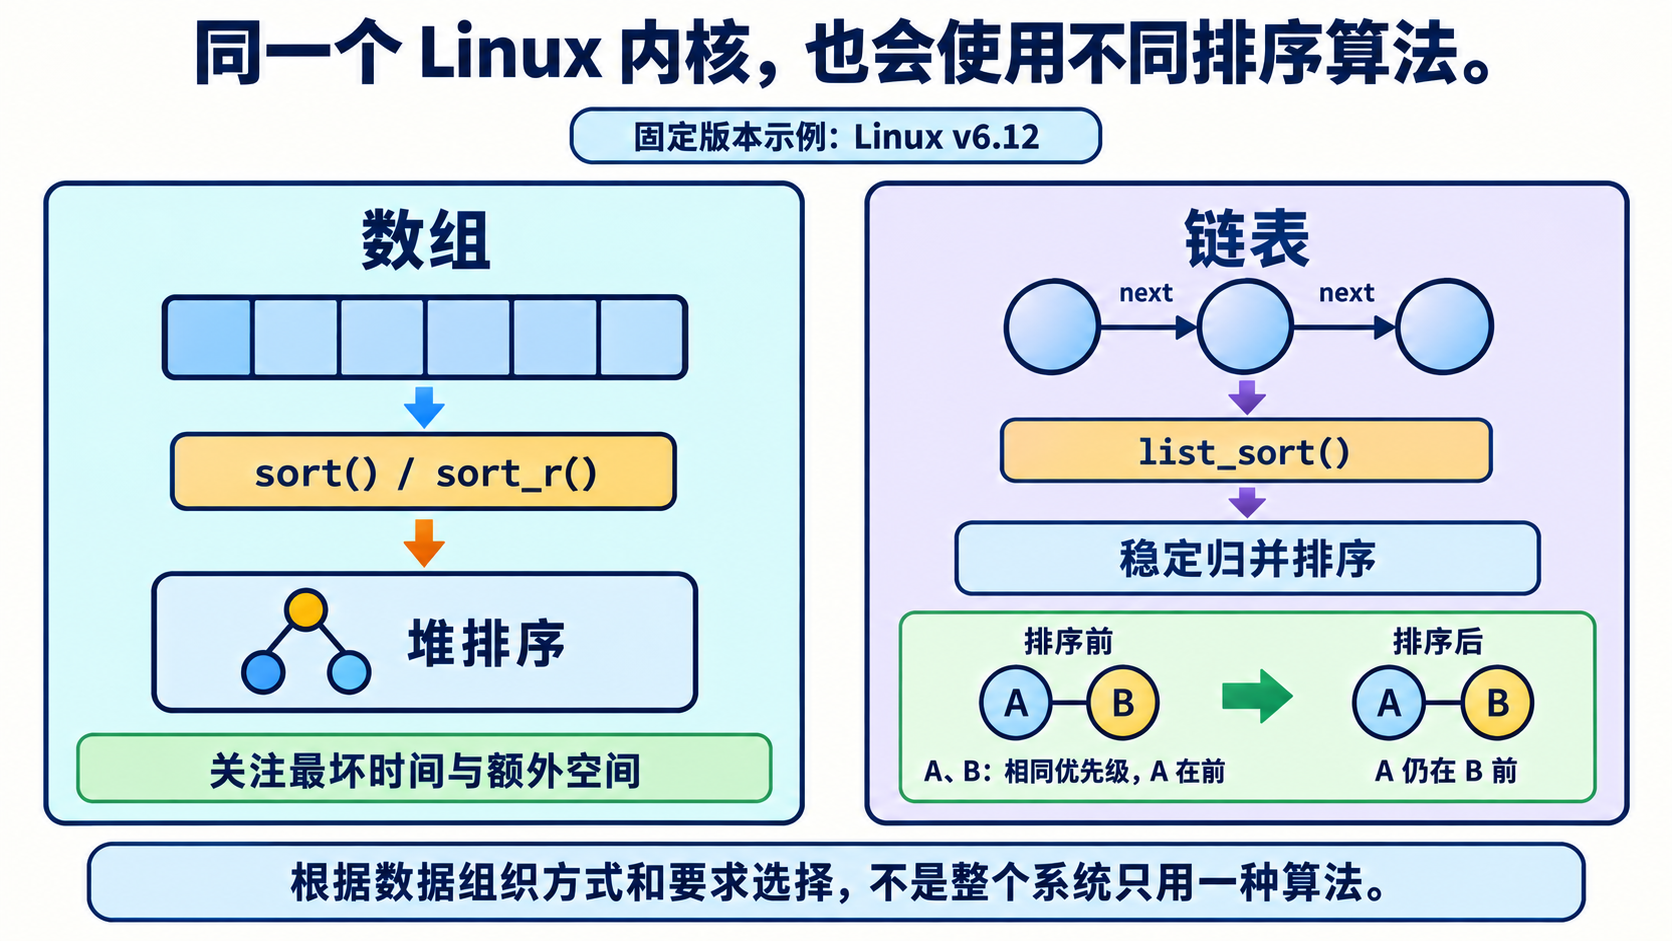
以 Linux v6.12 的源码作为固定版本示例:
数组排序 sort() / sort_r() 使用堆排序。 它能在平均和最坏情况下都保持 O(n log n) 的时间复杂度,其中 n 是元素数量,并适合原地处理数组。这里的“原地”是指不需要再准备一个与待排序数组同样大的辅助数组。
内核不仅关心平时快不快,也关心不利输入下是否可能耗费过多时间。不能因为普通快速排序平均表现好,就推导出所有内核排序都应使用它;不同实现还需要比较最坏情况、空间和常数开销。Linux v6.12:lib/sort.c
链表排序 list_sort() 使用稳定的归并排序。 链表适合顺着节点访问、通过调整链接合并有序片段,这与归并的处理方式相配合。
“稳定”是指比较结果相等的元素,排序后保留原来的相对顺序。例如 A、B 两个任务优先级相同,原来 A 在 B 前面,稳定排序仍保留这个先后关系。不过是否需要按到达顺序公平处理,还取决于业务规则,不能单凭“稳定”两个字推导出来。Linux v6.12:lib/list_sort.c
这两个例子已经说明:即使在同一个内核版本里,数组和链表也可以使用不同排序算法。 它们是具体函数的实现,不是整个操作系统唯一的算法。
为什么调度不一定需要“把所有任务排一遍”?
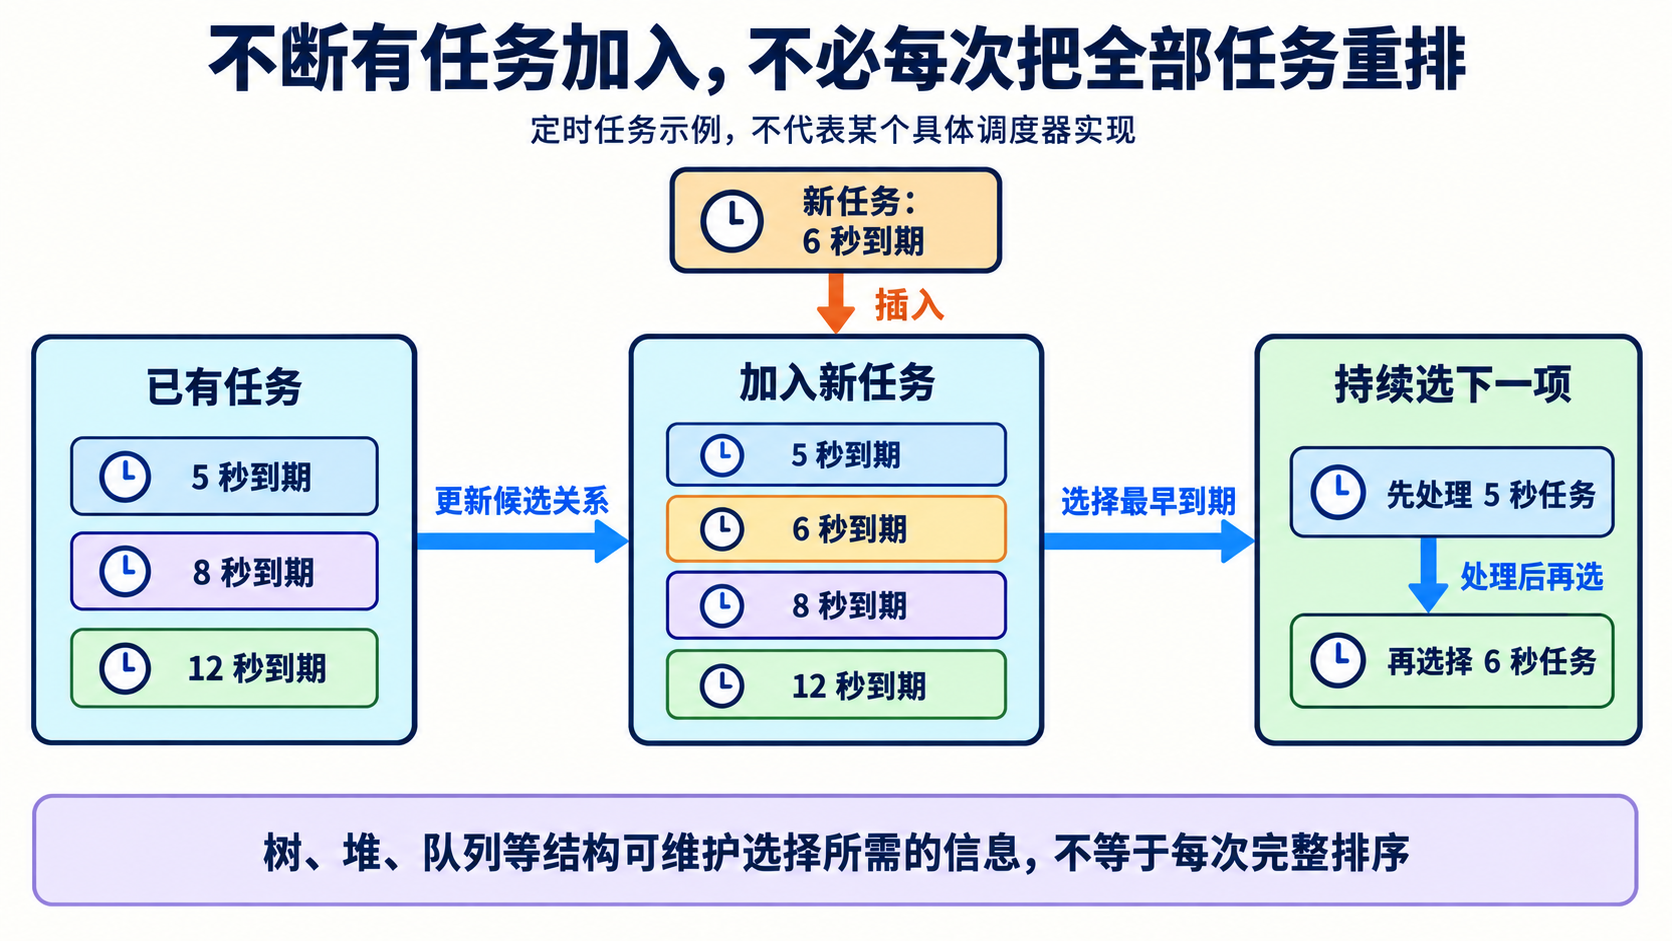
假设有三个定时任务,分别在第 5、8、12 秒到期。现在又加入一个第 6 秒到期的任务。
当前需求通常是:加入新任务后,仍能方便地找到最早到期的第 5 秒任务;处理它后,再找到第 6 秒任务。程序不一定需要随时输出完整排序结果,只需要有效支持插入、删除和取下一项。
树或堆可以用来维护这类关系;某些范围有限的优先级也可以通过队列组织。Linux 内核确实在多个子系统使用红黑树,但“维护有序结构”与“调用排序函数排列整个集合”是不同的工作。Linux 内核:Red-black Trees
上面只是说明选择思路,不表示所有定时器、CPU 调度器或 I/O 调度器都采用同一种结构。具体实现要看子系统、调度策略和内核版本,不能背成“进程调度用堆排序,网络栈用计数排序”。
面试总结
操作系统不会固定使用一种排序算法,而是根据数据组织方式、最坏时间复杂度、额外内存、稳定性及动态更新需求选择。
例如 Linux v6.12 的通用数组排序使用堆排序,链表排序使用稳定归并排序。对于不断加入和删除的任务,内核也可能通过树、堆或队列维护顺序,不必每次重新排序。因此,回答时应结合具体函数或子系统,不能给整个操作系统指定唯一算法。
阅读导航



